research-survey 워크스페이스 만들기 (3/3): 만든 LLM이 채점하지 않도록 한다 - 교차 벤더 검수 루프와 재발 방지

2026.07.28
## 한 줄 요약
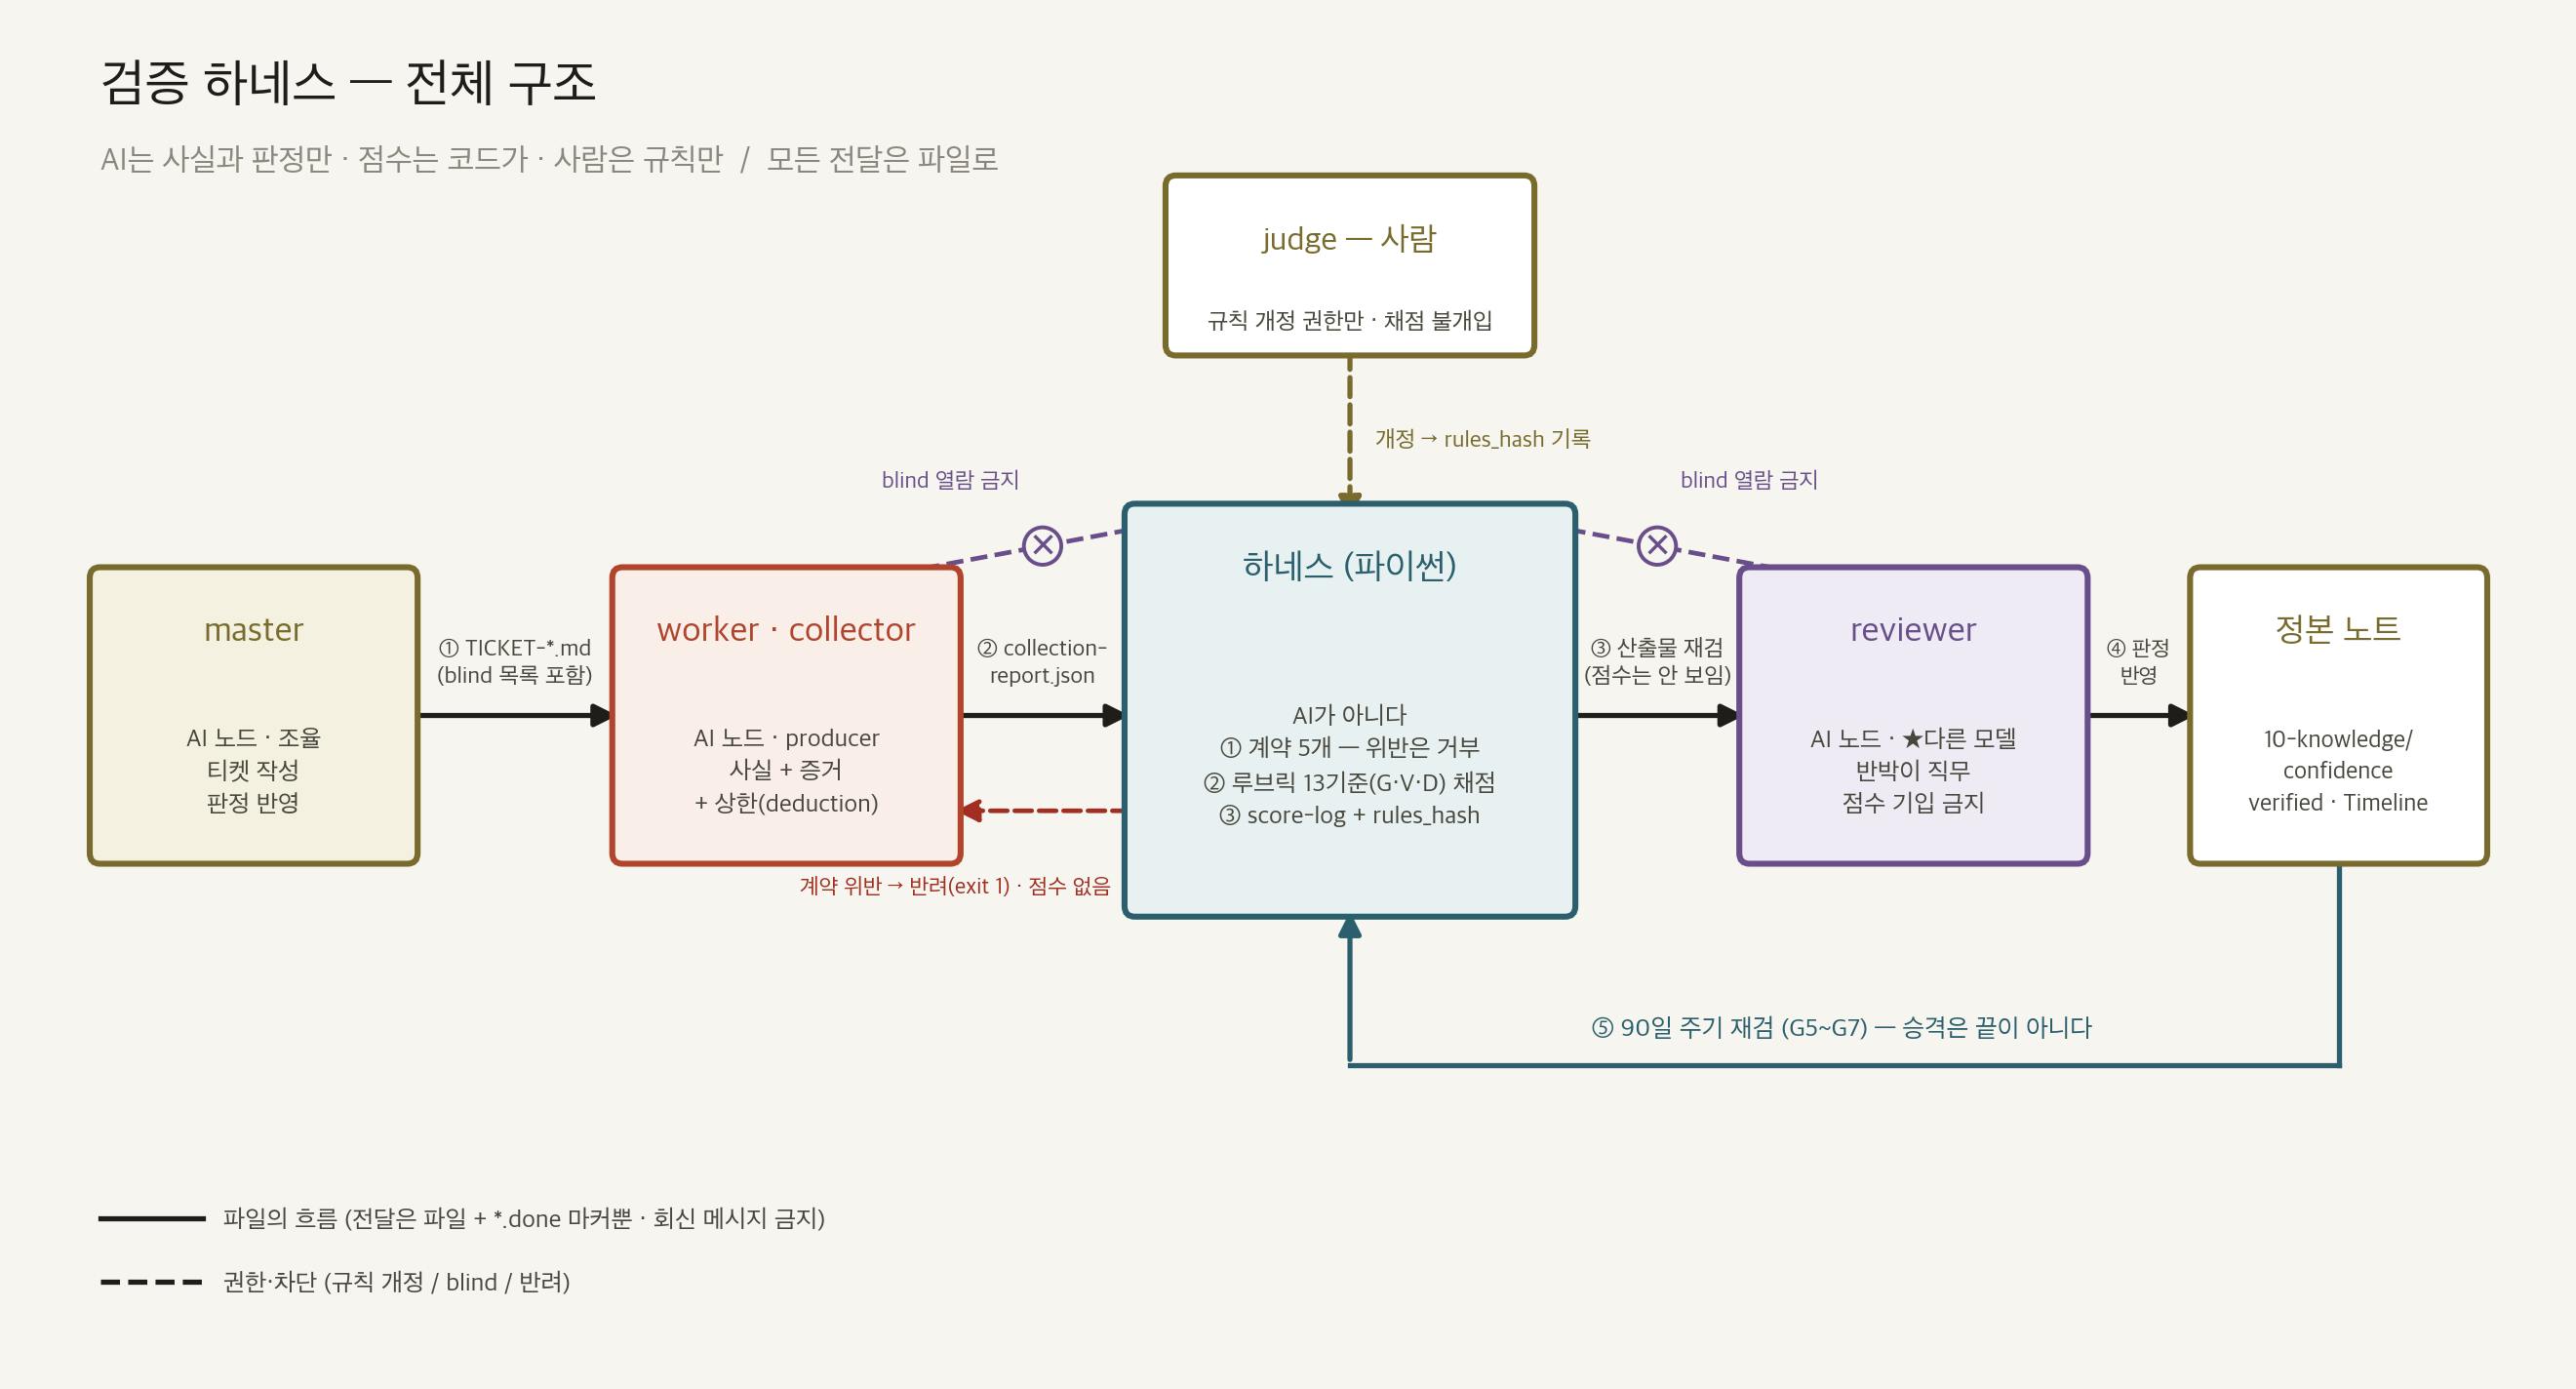
이 프로젝트에서 발견된 심각한 결함은 대부분 **"만든 쪽이 아닌 다른 쪽"** 이 잡았습니다.
그 경험을 ① 개발 프로세스로 고정하고 ② 누구나 재현하는 **실습 랩으로 상품화**하고
③ 같은 실수가 반복될 때마다 **CHANGELOG 상단에 규칙으로 박제**한 이야기입니다.
---
## 1. producer ≠ evaluator — 원칙에서 프로세스로
이 프로젝트의 핵심 원칙 5개 중 두 번째가 producer ≠ evaluator입니다.
```
① 증거 기반 완료 ② producer ≠ evaluator ③ 환각0 (출처만이 사실)
④ 축적 (살아남는 아티팩트) ⑤ 결정론 환원 (카운트·게이트는 스크립트 출력으로만)
```
문제는 이걸 **문서에 적어두는 것과 실제로 지키는 것이 다르다**는 점입니다. 그래서 릴리스마다
**리뷰 라운드(R1, R2, ...)** 를 강제하고, 그 결과를 CHANGELOG에 귀속과 함께 남겼습니다.
```
### Fixed (R1 — reviewer-codex REVISE major 1 + minor 2)
### Fixed (P1 R2 — reviewer-codex REVISE major 3, 적대 probe 재현·전건 수용)
### Fixed (R5 — 3자 평가자(master·inspector·reviewer) 지적 4건 해소)
### Fixed (R7 — 평가자 4축 확정 결함 7건 해소)
```
**누가 무엇을 지적했는지**를 절 제목에 씁니다. 이게 나중에 "어느 벤더가 어떤 종류의 결함에
강한가"를 판단하는 데이터가 됩니다.
라운드 규모: 릴리스 게이트 v0.2.x~v0.5.0 5회 실측, **리뷰 라운드 12회 이상**. 최종 Unreleased
구간에서만 R1·R4~R8 6개 라운드가 더 돌았습니다.
---
## 2. 실증 — 한 벤더가 놓친 것을 다른 벤더가 잡았다
발표에 쓸 수 있는 사례로 3건을 정리했습니다(`GUIDELINE.md §5`). 전부 **이 플러그인 개발
과정 자체**에서 나온 실사례입니다.
| # | 결함 | 놓친 쪽 → 잡은 쪽 | 성격 |
|---|---|---|---|
| 1 | 채점 하네스 gold 무결성 우회(빈 근거=통과) + 발명 정수 미탐 | Claude 리뷰어 ACCEPT → **codex(gpt-5.5)가 적대 재현으로 2건 적발** (v0.5.0 R1) | 검수기 자체의 구멍 |
| 2 | 승격 게이트가 workspace 밖 파일도 정본에 씀 | 같은 라운드 Claude ACCEPT → **codex 적대 재현으로 적발** (v0.3.0 R1) | 게이트 우회 |
| 3 | npm .CMD 심이 개행 프롬프트를 첫 줄에서 절단 | 최초 "모델 성향" 오진 → **Claude 리뷰어가 판별 실험 2회로 원인 입증** (v0.6.0 R1) | 위장 무결 |
**방향이 양방향**이라는 게 중요합니다. 사례 1·2는 gpt가 Claude의 미탐을 잡았고, 사례 3은
Claude가 gpt 레그의 결함을 잡았습니다. "어느 모델이 더 낫다"가 아니라
**단일 벤더 구성에는 상관 사각지대가 실재한다**는 게 결론입니다.
### 전사(前史) — 벤더가 아니라 방법론이 잡았다
정확한 귀속을 위해 하나를 더 기록해뒀습니다. 1편에서 다룬 PowerShell "$c:" 파싱 오류
(v0.2.1)는 네이티브 codex가 아직 없던 시기에, **같은 벤더(Claude) 안의 교차 렌즈 리뷰어**가
2라운드 미탐을 "실행 실측"으로 깬 사례입니다.
> 즉 **벤더가 잡은 게 아니라 방법론이 잡았습니다.** 이 사건이 "문서의 코드 블록은 실행해서
> 검증한다"는 교훈과, 네이티브 교차 벤더 구성을 복원하는 계기가 됐습니다.
---
## 3. 사례 3 상세 — "위장 무결"이라는 실패 유형
세 번째 사례는 따로 볼 가치가 있습니다. 새로운 실패 유형을 보여주기 때문입니다.
### 증상
team_compare 첫 E2E에서 codex를 producer로 돌렸더니, 요약을 만드는 대신
**"초록을 달라"고 응답**했습니다. 처음 진단은 "모델 응답 성향 차이"였습니다.
그럴듯합니다 — 모델마다 프롬프트 해석이 다르니까요.
### 진짜 원인
Claude 리뷰어가 판별 실험을 2회 돌려서 밝혀냈습니다.
> **Windows의 npm .CMD 심(shim)이 개행이 포함된 argv를 첫 개행에서 절단하고 있었습니다.**
producer는 프롬프트의 **첫 줄만** 받았습니다. 첫 줄에는 논문 제목만 있었으니
"초록을 달라"는 게 지극히 정상적인 반응이었습니다. 모델 탓이 아니라 **전달 레이어 버그**였습니다.
### 수정
```python
# before: 프롬프트를 argv로 전달 → .CMD 심이 첫 개행에서 절단
# after : stdin으로 전달
subprocess.run([...], input=prompt) # codex exec · claude -p 모두 수용
```
심 라우팅도 분리했습니다(`_wrap_shim`).
```
.ps1 → powershell -File (powershell -File은 .ps1만 받음)
.cmd / .bat → cmd /c (여기에 .CMD를 넣으면 실패 — R1 재실행에서 실측 후 교정)
.exe → 그대로
```
첫 수정에서 .CMD도 powershell -File로 보냈다가 실패했고, **재실행 실측으로 다시 고쳤습니다.**
### 그리고 더 무서운 것 — 위장 무결(silent failure)
여기서 연동 결함이 하나 더 나왔습니다.
reviewer 쪽이 프롬프트를 못 받아서 응답을 안 하면, _parse_review가 그걸
**"지적 0건 = 무결"** 로 집계하고 있었습니다.
```
검수가 실행되지 않음 → 결과 리포트: "지적 0건" → 읽는 사람: "깨끗하네"
```
**검수를 안 한 것과 검수해서 깨끗한 것이 구분되지 않았습니다.**
checked / unchecked를 분리했습니다 — {"flagged": [...]} JSON을 **실제로 받았을 때만**
checked=True. 비JSON이거나 flagged 키가 없으면 **unchecked(검수 불능)** 로 리포트에 표기.
> **교훈**: 0건은 두 가지 의미입니다 — "찾아봤는데 없다"와 "안 찾아봤다".
> 이 둘을 구분하지 않는 리포트는 **거짓말을 하는 리포트**입니다.
### 리뷰어가 스키마도 뚫었다
v0.6.0 P1 R2에서 codex가 적대 probe로 이 게이트를 우회했습니다.
```json
{"flagged": null} → [] 로 취급되어 checked 위장
{"flagged": "ABC"} → 문자별 리스트로 "허위 지적 3건"
```
flagged 키 존재만 보던 것을, **root가 object이고 flagged가 list이며 모든 원소가
비어있지 않은 string일 때만** checked=True로 엄격화했습니다.
self-test 7타입(null·string·number·object·혼합·빈문자열·비object root) + 유효 대조군.
---
## 4. 경험을 상품화 — team_compare.py 실습 랩
"교차 벤더 리뷰가 효과 있더라"는 경험담으로 끝내지 않고, **누구나 재현하는 실험**으로
만들었습니다(v0.6.0 P1, 581줄).
### 구조
```
같은 논문을 팀별로:
producer(LLM A) 헤드리스 요약 → reviewer(LLM B) 검수
↓
판정·집계는 ★결정론 채점기만★
(verify_summaries의 resolve_source · check_evidence_grounding 재사용)
↓
Evidence 수치·직접인용 substring 실재율 · coverage FAIL · 매설 검출률(--seeded)
↓
팀별 분리 작업영역: 40-drafts/<team_id>/
비교 리포트: 80-reports/team-compare-report.{md,json}
```
**판정을 LLM이 하지 않습니다.** LLM끼리 서로 채점하게 하면 "LLM-as-a-judge"의 편향이
그대로 실험 결과가 됩니다. 채점은 2편에서 만든 결정론 채점기가 하고, LLM은 producer와
reviewer 역할만 맡습니다.
팀 정의는 00-system/teams.sample.json에 스키마로:
```json
{ "team_id": "codex-produces",
"producer": { "cli": "codex", "cmd_template": "...", "model": "..." },
"reviewer": { "cli": "claude", "cmd_template": "...", "model": "..." } }
```
실측 가용한 조합만 넣었습니다(codex↔claude 역조합 2팀). 미설치 CLI는 주석 예시로.
### 비용 가드
실제 LLM CLI를 여러 번 부르는 도구라 **기본이 dry-run**입니다.
```
기본 : 실 LLM 호출 0 · 호출 수 미리보기만
--yes : 그때만 실행
```
/research-survey team-compare 라우팅도 같은 규약입니다 — dry-run으로 호출 수·비용을 먼저
보이고, AskUserQuestion으로 진행 여부를 물은 뒤에만 --yes.
### 실주행 버그 4종 회피
실제로 돌려보니 Windows 환경에서 문제가 줄줄이 나왔습니다. 전부 코드에 회피를 넣었습니다.
```
① Windows .ps1 npm shim → shutil.which 해소 후 powershell 라우팅
② 프롬프트 argv 리스트(shell=False) → 인용 붕괴 회피
③ stdin=DEVNULL → hang 방지
④ codex --skip-git-repo-check → trusted-dir 회피
```
self-test는 CLI 호출 0(fake runner 주입) — 테스트가 돈을 쓰면 안 됩니다.
### 지표 범위를 정직하게 한정
v0.6.0 P1 R2에서 codex가 또 하나를 지적했습니다.
처음에는 지표 이름이 **"인용 실재율"** 이었습니다. 그런데 실제로 검사하는 건 Evidence 절의
수치와 직접인용 문구의 substring 실재뿐입니다. 질적 주장("이 방법이 더 우수하다")은
검사하지 않습니다.
**실재하는 인용 1개 + 허위 qualitative Summary** 조합이 **100%로 과신**될 수 있었습니다.
```
라벨 변경: "인용 실재율" → "Evidence 수치·직접인용 substring 실재율"
low-evidence 플래그: 검증 가능 성분(needle) 수 < 임계(기본 3) 이면 경고 표기
TEAM_COMPARE.md에 "지표 범위·한계" 절 신설
— 질적 주장은 검증 안 함 · reviewer 검수/본문 정독 병행 해석
```
self-test: qualitative 반례가 low-evidence로 잡히고 리포트에 경고가 뜨는지 확인.
> **교훈**: **지표 이름이 실제 측정 범위보다 넓으면, 그 자체가 과신을 만듭니다.**
> 이름을 좁히는 게 지표를 개선하는 것보다 먼저입니다.
### 경로 위생
같은 라운드 major 하나 더 — team_id와 paper id가 경로에 그대로 들어가고 있었습니다.
```
team_id = "../../outside-team" → workspace 밖에 파일 생성
paper id = "../../../outside-paper" → 동일
```
codex의 containment probe가 재현했습니다.
```python
safeid() # 영숫자 시작 + 영숫자·._- 만 · ".." · 구분자 · 절대경로 거부
ensurewithin() # resolve 후 허용 root 하위인지 is_relative_to 로 fail-closed
```
arXiv id의 점(`2303.08896`)은 허용해야 하니 그 예외를 두고, 중복 team_id도 실행 전에
거부합니다. self-test: 이탈 2케이스 · 중복 · 정상 id.
---
## 5. 구조 개편도 리스크 평가부터 — RESTRUCTURE_PLAN
v0.6.0 P0에서 리포 구조를 정리했습니다. 여기서도 방식이 특이합니다 —
**바로 고치지 않고 개편안 문서를 먼저 쓰고 승인을 받았습니다.**
### 현황 진단(실측)
```
루트 파일 8개 : README 2종 · CHANGELOG(24K) · AGENTS/CLAUDE ·
INSTALL_MARKETPLACE(2.5K, 이동 후보) · PRIVATE_REPO_SETUP(2.2K, 용도 소멸)
scripts 7종 : 전부 skills/research-survey-run/scripts/ 에 평평하게
```
### ★ 핵심 제약을 먼저 찾았다
```python
sys.path.insert(0, str(Path(__file__).resolve().parent))
from wiki_index import REQUIRED_KEYS, load_notes # wiki_query
from verify_summaries import resolve_source, check_evidence_grounding # wiki_grade
```
스크립트들이 **같은 디렉터리에 있다는 가정**으로 형제 모듈을 import합니다.
그리고 **`wiki_grade`(wiki군)가 verify_summaries(verify군)를 import**합니다 —
기능군으로 폴더를 쪼개면 이 교차 import가 깨집니다.
### 두 옵션을 비교
| | 옵션 1 (논리 구획) | 옵션 2 (물리 분리) |
|---|---|---|
| scripts | 제자리 유지 + docstring 그룹 헤더 | scripts/{wiki,corpus,verify}/ + _bootstrap.py |
| 코드 변경 | 없음(주석만) | 각 스크립트 sys.path 3군 등록 교체 |
| 문서 참조 갱신 | 0 | 5개 문서 20여 줄 |
| 리스크 | 최저 | 중간 |
| 이점 | 무파손 증명이 단순 | 트리에서 기능군이 한눈에 |
**옵션 1 채택.** 근거: (a) import 결합이 강해 물리 분리는 순이익 대비 파손 리스크가 크다
(b) 오너 목적의 핵심(문서 산개·PRIVATE_REPO 용도 소멸)은 옵션 1로 완결된다
(c) 가독성 목적은 docstring 헤더 + 그룹 표로 달성된다
(d) 7종은 성장 폭주 상태가 아니다.
옵션 2는 **버리지 않고 §6 "차기 메이저 재검토"로 보존**했습니다 — 선행 조건(교차 import
처리 · 문서 참조 전수 갱신)까지 적어서.
### 집행에서 지킨 것
```
비가역 삭제 0 : PRIVATE_REPO_SETUP은 삭제가 아니라 docs/archive/ 로 이동 + 배너 1줄
이력 보존 : git mv 사용
링크 전수 스캔 : 실참조는 CHANGELOG(이력·불변)뿐 · 라이브 링크 0 확인
무파손 증명 : self-test 6종 exit 0 (헤더 주석이 sys.path 형제 import를 안 깨뜨림을 실증)
+ 데모 코어 E2E + grade E2E(적중 12/12·거부 5/5) + plugin validate exit 0
롤백 : 이동 2건만 되돌리면 원복 (커밋 분리)
```
> **교훈**: "정리"는 리팩터링입니다. 리팩터링 전에 **무엇이 깨질 수 있는지 실측**하고,
> **무파손을 어떻게 증명할지** 먼저 정합니다.
---
## 6. 사람이 쓰기 좋게 — 상태 머신 · 자기소개 · 커리큘럼
도구가 갖춰지고 나니 다음 병목은 **사용자 경험**이었습니다.
### 6-1. run_state.py — 중단·재개 (v0.7.0)
한 사이클이 6단계인데, 중간에 세션이 끊기면 어디까지 했는지 알 수 없었습니다.
```
extract → shortlist → summarize → verify → organize → delta
↓
_meta/run-state.json 에 기록
(단계 enum · 완료 플래그 · 재개 포인터)
```
init / mark / show CLI. 미지 단계·미지 상태는 fail-closed.
**그리고 여기서도 리뷰어가 구멍을 찾았습니다**(v0.7.0 R1, codex 재현).
load()가 디스크 상태를 **검증 없이 신뢰**하고, mark()가 **디스크에 적힌 stage 이름을
허용 목록으로 삼았습니다.** 그래서 상태 파일을 변조하면:
```json
{ "stage": "evil", "status": "banana" } → show/mark 가 승인하고 재작성
```
_validate()가 **코드 상수 STAGES·`STATUSES` 기준으로** 검사하도록 고쳤습니다 —
① stage 집합·순서 일치(누락·unknown·중복·순서 뒤섞임) ② status enum ③ stale resume.
위반 시 SystemExit '상태 파일 스키마 위반: ...'. init_state의 stages 파라미터도 제거
(고정 스키마). self-test 5케이스.
> **교훈**: **디스크에서 읽은 값을 스키마의 근거로 쓰면 안 됩니다.**
> 스키마는 코드에 있어야 합니다. 파일은 검증 대상이지 기준이 아닙니다.
### 6-2. 워크스페이스 자기소개 어댑터 (v0.7.1)
1편에서 만든 루트 어댑터는 **clone 모드에서만** 작동합니다. init으로 생성된 사용자
워크스페이스에는 그런 게 없어서, 열어도 아무 말이 없었습니다.
템플릿 워크스페이스에 AGENTS.md를 넣고 CLAUDE.md 최상단에 @AGENTS.md import 한 줄을
추가했습니다(12섹션 본문·번호는 **무손상** — import는 섹션 밖).
톤을 다르게 잡았습니다 — 루트 어댑터가 "튜토리얼 진행자"라면, 이건
**"이 사용자의 연구 워크스페이스를 이어 운영하는 담당"** 입니다.
```
작업 지시 없이 열렸을 때:
① PROJECT_STATUS.md · _meta/run-state.json · taxonomy 카테고리를 실측
② 상태별 다음 액션 제안 (시작 전 / 진행 중 / 정본 쌓임)
★ 진행 이력이 없으면 "아직 서베이 시작 전"으로 정직 안내
— 가짜 진행률·산출물을 지어내지 않는다
```
**여기서 같은 계열 결함이 또 나왔습니다**(v0.7.1 R1 major, codex).
세션 시작 안내가 ${CLAUDE_PLUGIN_ROOT} 치환과 bare 스크립트명(`wiki_index` 등)으로
명령을 안내하고 있었는데, **사용자 워크스페이스에서는 그 치환이 풀리지 않고 PATH에도
없어서 전부 실행 불가**였습니다.
```
① 진행 파악 = 상태 파일 직접 Read (명령 불요)
② 다음 액션 = 등록 커맨드(/research-survey run · help) 또는 "플러그인 스킬이 실행" 경유
```
부수적으로 나온 정직성 규칙 하나: PROJECT_STATUS.md(사람이 쓴 요약)와
run-state.json(도구가 쓴 기록)이 어긋나면 **임의로 한쪽을 우선하지 말고 둘 다 그대로
보고**한다.
### 6-3. 4주 커리큘럼 (v0.8.0)
처음 시작한 사람이 단계별로 따라올 경로를 만들었습니다. 스터디 정본의 4주 커리큘럼을
**이미 구현된 실기능에만 매핑**했습니다 — 새 개념 발명 0, 명령·파일·수치는 RUNBOOK·DEMO·
TEAM_COMPARE·GUIDELINE에서 실측 인용.
| 주차 | 주제 | 매핑된 실기능 |
|---|---|---|
| week01 | 일단 돌아가게 | demo → init → corpus_fetch 자기 주제 → classify |
| week02 | 지식 창고 + 검수 기준 | 2분할 노트 · wiki_promote 게이트(B8/E1/A3) · source-coverage · gold·매설 · wiki_grade |
| week03 | 하네스 견고화 + Loop | 결정론 게이트 체계 · run_state 중단재개 · --audit 30일 stale·MOC 제안·Open Questions · 재채점 재현 |
| week04 | 멀티에이전트 심의 | team_compare 교차 벤더 랩 · 실증 사례 · GUIDELINE.md 발표 |
**안내 전용**입니다 — 수강생 작업을 대신 하지 않습니다. 그리고 수강생 진행을
**파일로 실측**(PROJECT_STATUS · run-state · corpus · notes)해서 맞는 주차부터 안내합니다.
가짜 진행률 없음.
배치도 고민했습니다. 가이드를 워크스페이스에 복사하면 drift가 생기니, **플러그인
references 단일 출처에 두고 복사하지 않습니다.** 대신 템플릿 AGENTS.md의 '다음 액션'에
/research-survey curriculum 진입점만 추가했습니다(v0.7.1 교훈 — 실행 가능 경로만).
### 6-4. TUTORIAL_SESSION.md — 붙여넣기 자료
세션 진행자가 **claude를 켠 뒤 그대로 붙여넣는** 자료입니다.
```
Kickoff 블록 : [K1] 첫 입력으로 맨몸 답 확보 → [K2] RUNBOOK 정독 → 튜토리얼 개시
8단계 phase 블록 : 다이얼 → 추출 → 선별 → 요약·맨몸대조 → 검증 → 인사이트 → 가설 → 정리·지속
각 블록에 목적 · 붙여넣기 프롬프트 · 기대 출력/확인 포인트 · 막힐 때 질문
자기 주제 전환 블록
트러블슈팅 : python 미탐지 · corpus 없음 · 플러그인 모드 어댑터 미로딩
진행자 노트 : Scale Modes 매핑(demo=Lite / tutorial=Standard / init+run=Full) · phase별 토론 질문
```
**plugin/clone 두 모드 무관 작동** — 붙여넣기는 어댑터 로딩과 독립입니다.
---
## 7. 같은 실수가 4번 반복됐다 — 규칙으로 박제하기
이 프로젝트에서 가장 배울 게 많은 부분입니다.
### 7-1. "실행되지 않는 명령을 문서에 쓴다" — 4회 재발
| 회차 | 어디서 | 무엇 |
|---|---|---|
| 1 | v0.4.1 RUNBOOK | python3 (Windows에 없음) |
| 2 | v0.7.1 AGENTS.md | ${CLAUDE_PLUGIN_ROOT} 치환 + bare 스크립트명 |
| 3 | v0.8.0 week 가이드 | bare corpus_fetch.py · 유니코드 말줄임표 섞인 명령 |
| 4 | Unreleased R4 | route는 맞았는데 **전달 형태**가 틀림 — 슬래시 명령이 자연어 문장 안에 매몰돼 커맨드로 인식 안 됨 |
3회째에 CHANGELOG **상단에 상시 기여 규칙**으로 박았습니다.
> **기여 규칙(문서 명령) — 재발 차단**: 가이드류·워크스페이스 문서의 실행 명령은
> **등록 slash route(`/research-survey …`) 또는 "플러그인 스킬이 실행" 표현으로만** 쓴다.
> 사용자 워크스페이스 PATH에 없는 내부 스크립트를 bare 이름·직접 경로로 실행하라고
> 지시하지 않는다. 신규 가이드 작성 시 fenced 명령을 **임시 워크스페이스에서 route/
> executable로 resolve되는지 확인**할 것.
그리고 4회째가 **변종**으로 나왔습니다 — route 자체는 규칙을 지켰는데, 붙여넣기 블록 안에서
슬래시 명령이 문장에 섞여 있어 커맨드로 인식되지 않았습니다. 블록을 둘로 쪼갰습니다
(① 라우트 단독 블록 ② 진행 지시 블록).
> **교훈**: 규칙을 만들어도 **변종은 계속 나옵니다.** 규칙은 "내용"에 걸었는데 결함은
> "형태"에서 났습니다. 재발 차단 규칙에는 **어느 축에 거는 규칙인지**를 명시해야 합니다.
### 7-2. 맨몸 대조를 무효화하는 우회로 — R4 major 2건
Unreleased R4에서 리뷰어가 잡은 두 건이 특히 좋습니다.
**① 진입 순서가 대조를 조용히 무효화했다**
1장의 진입 모드 표에 마켓플레이스 행이 "설치·재시작 → /research-survey tutorial"로
적혀 있었습니다. 그런데 그 라우트가 RUNBOOK 정본을 로드하면, **그 세션은 더 이상 맨몸이
아닙니다.** 2장이 요구하는 [K1] 맨몸 답 선확보를 건너뛰도록 유도하고 있었습니다.
```
수정: 설치·재시작 → [K1] 첫 입력 → [K2-플러그인] 라우트
+ Kickoff 서두에 "플러그인 모드에서도 라우트를 K1보다 먼저 치지 말 것"
+ 트러블슈팅 ③의 같은 계열 잔여 모순도 정정
```
**② fallback이 우회로였다**
Phase 4(맨몸 대조) 프롬프트에 이렇게 적혀 있었습니다.
> "아까 첫 입력에서 받아둔 맨몸 답 **(또는 새로 도구 없이 만든 요약)**"
괄호 안이 문제입니다. 이미 RUNBOOK과 원문을 읽어 **오염된 진행 세션이 그 자리에서
"맨몸 요약"을 지어내도 되는 우회로**였습니다. 트러블슈팅 ⑤가 명시적으로 금지하는 바로
그 행위를, 본문 프롬프트가 허용하고 있었습니다 — 자기모순.
```
수정: 동일세션 fallback 제거 → fail-closed
K1 답이 없으면 Phase 4를 그 자리에서 중단
별도 clean session · 별도 도구(ollama · claude --tools "" · 웹 챗)로 맨몸 답 확보 후 재개
맨몸 답 없이 (b)만 보여주지 않는다
```
**③ "독립 실측"이 실제로 독립이 아니었다**
Phase 5의 검증 항목이 "만든 좌석이 아닌 **다른 관점에서** 재확인"이라고 적혀 있었습니다.
같은 세션이 관점만 바꿔 연기해도 충족됩니다. **producer≠evaluator가 문구로만 남고 실행은
자기채점**이었습니다.
```
수정: 만든 좌석 밖에서 실제로 한 번 더 실행
(별도 clean session · 별도 서브에이전트 · 별도 LLM CLI 중 하나)
+ 실행 증거 기록 (좌석 종류 · 실행 명령 · 시각 · evaluator 판정 원문)
셋 다 불가하면 "독립 검증 미실시"로 표기하고 PASS로 적지 않는다
용어표에도 "같은 세션이 다른 관점을 연기하는 것은 독립이 아니다" 명시
```
> **교훈 3개**:
> 1. **순서가 안전핀을 무효화**할 수 있습니다. 규칙만 맞고 순서가 틀리면 규칙이 안 지켜집니다.
> 2. **fallback은 우회로가 되기 쉽습니다.** "안 되면 이렇게 해도 됨"이 "그냥 이렇게 하자"가 됩니다.
> 3. **미실행을 통과로 위장하는 경로**를 명시적으로 봉쇄해야 합니다("미실시"라는 판정 어휘를 만들 것).
---
## 8. 최종 라운드 — 측정값을 인용하는 규칙 (R5~R8)
마지막 네 라운드는 코드가 아니라 **CHANGELOG 자체의 정확성**을 다뤘습니다. 이 부분이
이 프로젝트에서 가장 특이한 산출물입니다.
### 발단
R4 절에 이렇게 적혀 있었습니다.
> "실측: 변경 파일 **2개뿐**(`TUTORIAL_SESSION.md` +32/−8, init SKILL.md +6/−3)"
실제 커밋은 **3파일**이었습니다(`CHANGELOG.md` +33/−0 포함). 승인된 변경 범위에 CHANGELOG가
들어 있었으니 위반은 아니고, **기술이 부정확**했던 겁니다.
### 층 ① — 닫힌 형태만 인용한다
처음 만든 규칙은 "기준 커밋 해시를 명시한다"였습니다. 그런데 이걸로 부족했습니다.
```
git diff --numstat <hash> ← 열린 형태 (두 번째 끝이 없어 작업트리와 비교)
```
이건 해시를 적었지만 **뒤에 커밋이 쌓이면 같은 명령이 다른 값**을 냅니다. 실증:
```
같은 R4 범위를 가리키는데
닫힌: git show --numstat adb6eb5 → 33/0 · 32/8 · 6/3 (항상 같음)
열린: git diff --numstat bfd10d6 → 98/0 · 40/12 · 6/3 (HEAD가 50dca5a일 때)
```
규칙을 재작성했습니다.
```
✅ git show --numstat <hash>
✅ git diff --numstat <hashA>..<hashB>
❌ 작업트리를 읽는 명령 · HEAD · 브랜치명 등 움직이는 참조
```
**이유는 한 줄입니다** — 작업트리·HEAD는 다음 커밋에서 값이 달라지므로,
**인용된 명령이 인용된 값을 재현하지 못합니다.**
### 층 ② — 자기 커밋의 통계는 적지 않는다
구현과 CHANGELOG가 같은 커밋이면, 그 커밋의 numstat을 본문에 쓸 수 없습니다.
**자기참조 역설**입니다 — 해시를 본문에 쓰면 tree가 바뀌어 해시가 또 달라집니다.
```
해법: 그 커밋이 닫힌 뒤 다음 CHANGELOG 커밋에서 그 해시를 참조해 소급 기록
통계 없이도 범위는 적을 수 있다 — "수정 개소 4곳 · CHANGELOG.md 단일 파일"처럼 서술로
```
### 층 ③ — 인용된 명령은 그 환경에서 실행 가능해야 한다
층①·②를 지켜도, 인용한 명령이 실행되지 않으면 검증자는 값을 재현할 수 없습니다.
처음에는 계수(grep)를 rg로 인용했습니다. 그런데 실측해보니:
```
같은 머신 · PowerShell 7.6.3 → rg 해소 실패
같은 머신 · Git Bash 5.3.15 → PATH가 아닌 셸 함수 shim으로 ripgrep 14.1.1 (which rg 는 실패)
다른 검증자 → ripgrep 15.2.0
```
**"있다/없다"가 아니라 "재현자마다 다르다"가 문제**입니다. git 내장으로 교체했습니다.
```
git grep -c -E '<패턴>' <hash> -- <path>
① 외부 바이너리 의존 없음
② rev를 인자로 받아 커밋 고정이 명령 자체에 내장 (파이프·리다이렉트 불요)
③ 작업트리를 읽을 여지가 구조적으로 없음
```
여기에 **한정 단서 2개**를 붙였습니다. 없으면 다음 사람이 과잉 교정하거나 규칙을 무시합니다.
> **(ㄱ)** 층③은 "실행 가능해야 한다"는 요구이지 **"모든 단계를 하나의 명령으로 기계화하라"**는
> 요구가 아니다. 이식성 없는 도구를 끌어들이며 완전 기계화하면 층③이 경계하는 상태를
> 스스로 만든다(`sed -n '97,132p'` vs Select-Object -Skip 96 -First 36 = 플랫폼 의존).
> 최적점은 **(닫힌 git 명령) + (플랫폼 중립적 범위 지정)** 조합이다.
>
> **(ㄴ)** 층③은 **"값의 근거로 인용된 측정 명령"에만** 적용된다. 산문에 언급된 도구·
> 조건부 권고·fallback이 딸린 선택적 도구는 대상이 아니다.
### 앵커 규칙 — 세려는 대상이 확정된 시점
"기존 R1 절이 몇 곳인가"를 세는데, 앵커를 어디로 잡느냐에 따라 값이 갈렸습니다.
```
앵커 50dca5a (R5가 자기 절을 추가한 뒤) → 8 → "신설분 제외" 손계산 필요
앵커 adb6eb5 (추가 이전) → 7 → 값이 직접 나옴
```
**"기존 N곳"처럼 자기 추가분을 뺀 값을 말할 때는 추가 이전 커밋을 앵커로 씁니다.**
그러면 제외 연산이 끼어들지 않고, 그 손계산이 틀릴 자리도 없어집니다.
### 계수 단위 명시
git grep -c는 매치 **줄 수**를 셉니다. 줄당 다중 매치 패턴에는 부적합합니다.
그래서 **계수를 인용할 때는 세는 단위를 문장에 명시**하도록 했습니다.
이건 도구가 아니라 **인용 행위**에 거는 규칙입니다 — 도구를 바꿔도 "무엇을 세는가"는
남는 문제이기 때문입니다.
### 규칙을 만든 커밋이 그 규칙을 어겼다
R6는 커밋 2건으로 마감됐습니다. 첫 커밋(`d23e321`)이 인용한 rg -n '…' CHANGELOG.md
(작업트리 계수)와 50dca5a 앵커가 **바로 그 커밋이 만든 규칙이 금지하는 형태**였습니다.
정정 커밋(`0576217`)에서 같은 4개소를 교체했습니다.
이걸 **지우지 않고 기록으로 남겼습니다.** R7에서 계수 인용을 git 내장으로 전부 교체할 때도,
R6 절의 이 역사 기술 1곳은 **보존**했습니다 — 고치면 "규칙을 만든 커밋이 그 규칙을 어겼다"는
실증이 사라지기 때문입니다.
### 개수는 provenance를 증명하지 못한다 (R8)
R7이 커밋별 합과 누적 diff가 다른 이유를 설명하면서 이렇게 썼습니다.
```
커밋별 합: +108/−29 누적: +90/−11 검산: 108−18=90 · 29−18=11
→ "18줄이 전부 첫 커밋 신규분"이 numstat 산술로 강제된다
```
**틀렸습니다.** 그 귀류는 **상쇄 재삽입**(정정 커밋이 base 줄을 되살려 삭제 수를 상쇄하는
경우)을 배제하지 못합니다. 그리고 "삽입 방향에서 독립적으로 같은 결론"이라는 문장도
거짓입니다 — 삽입·삭제 두 방향은 **같은 회계 항등식**이라 같은 반례에 함께 성립합니다.
**patch 대조로 교체했습니다.**
```
git diff 50dca5a 0576217 -- CHANGELOG.md 의 삭제 줄
git show d23e321 -- CHANGELOG.md 의 삭제 줄
→ 개수(11)뿐 아니라 ★내용까지 동일★
정정 커밋이 base 줄을 지웠다면 → 그 줄이 누적 삭제 집합에만 나타남
base 줄을 되살렸다면 → d23e321 삭제 집합에만 남음
어느 쪽이든 두 집합이 갈라지므로, 집합 일치가 두 경우를 함께 배제한다
```
값(+90/−11)과 검산은 옳았으므로 그대로 두고, **증명 주장만** 교체했습니다.
### 이 문서의 마지막 교훈
R8 절이 이렇게 끝납니다.
> 이 문서에서 **"값은 옳은데 근거가 틀렸다"가 네 번째**다
> (R1 관례 '6곳' · 규칙 2 동기 '2건' · R5 '3건' · 이번 두 건).
> 결론이 맞으면 근거 검증을 멈추게 되는데, **근거는 다음 라운드의 입력이 되므로
> 틀린 근거는 조용히 상속된다.**
> **개수·산술은 provenance를 증명하지 못하고, 단일 관측은 환경을 주장하지 못한다.**
---
## 9. 전체를 관통하는 것
3편에 걸친 이야기를 한 문장으로 줄이면 이렇습니다.
> **"검증했다"는 말을 믿지 않는 구조를 만드는 것.**
- 1편: 폴더 이름을 **계약**으로 만들어서, 지키지 않으면 코드가 깨지게 했습니다.
- 2편: 검증을 **exit code**로 만들어서, 말로 통과할 수 없게 했습니다.
그리고 그 검증기를 **gold + 매설**로 채점해서, 검증기의 구멍까지 수치로 냈습니다.
- 3편: 검수를 **다른 좌석**에 맡겨서, 만든 사람이 채점하지 못하게 했습니다.
그리고 반복된 실수를 **규칙으로 박제**해서, 다음 사람이 같은 자리에서 넘어지지 않게 했습니다.
각 층에서 잡힌 결함의 성격이 달랐다는 게 핵심입니다.
| 층 | 잡히는 결함 |
|---|---|
| 폴더·문서 계약 | 구조 이탈 · 12섹션 누락 · 경로 참조 깨짐 |
| 결정론 게이트 | 형식 위반(필수키·출처·Timeline) · 내용 부재(발명 수치·오인용) |
| 채점 하네스 | **게이트 자체의 루프홀** (빈 evidence 통과 · 정수 미탐) · 과차단 |
| 교차 벤더 리뷰 | 경계 미검증 · 위장 무결 · 스키마 우회 · 논리 모순 |
| 기여 규칙(박제) | **같은 계열의 재발** · 근거의 재현 불가능성 |
아래로 갈수록 **위 층이 구조적으로 못 잡는 것**을 잡습니다. 어느 하나만으로는 안 됩니다.
---
## 10. 발표에 쓸 때 — 정직성 규약
GUIDELINE.md에 발표자료 생성 규칙을 못 박아 뒀습니다. 이것도 하나의 결과물입니다.
```
수치 사용 절대 규칙: 발표에 들어가는 모든 수치·사례는 §4 실증 수치표에 명기된 것만 쓴다
(전건 실측 · 출처 병기)
여기 없는 수치가 필요하면 지어내지 말고 "측정 예정"으로 말한다
톤 : 과장 금지 — "여러 AI가 서로 감시·반박하며 걸러내고, 최종 판단은 사람이 한다"
형식 : LaTeX 수식 금지 · 모델 조롱 톤 금지("모델 탓이 아니라 구조 한계")
검증 : 생성 후 모든 수치를 §4·§5 표와 대조 · 출처 없는 주장 0 확인
라이브 실패 대비: 사전 캡처 준비 → "지금은 미리 돌려둔 결과로 보겠습니다"라고
정직하게 전환 (라이브 실패를 숨기지 않는다)
```
정체성 한 줄에도 **정직한 경계 2가지**를 붙였습니다.
> "연구를 대신 해주는 도구가 아니라, 검증 가능한 연구 하네스를 찍어내고 그 하네스의
> 품질까지 측정하는 **메타하네스**"
>
> — 단, ① 승격 강제는 hook(runtime-enforced)이 아니라 wiki_promote.py **스크립트의
> 결정론 게이트**로 구현된다(이 플러그인은 hook 0건) ② 채점 결과 → 규칙 자동 재조정
> 루프는 **미구현**(사람 승인 경유) — 향후 방향.
자기 시스템을 소개하면서 **"이건 아직 안 됩니다"를 같은 문장에 쓰는 것** — 이 프로젝트가
스스로에게 요구한 기준이기도 합니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


공유해 주셔서 감사합니다~