100편의 글 앞에서 그냥 '글 정리해줘' 시키기 전에 생각해 봐야할 것

2026.10.06
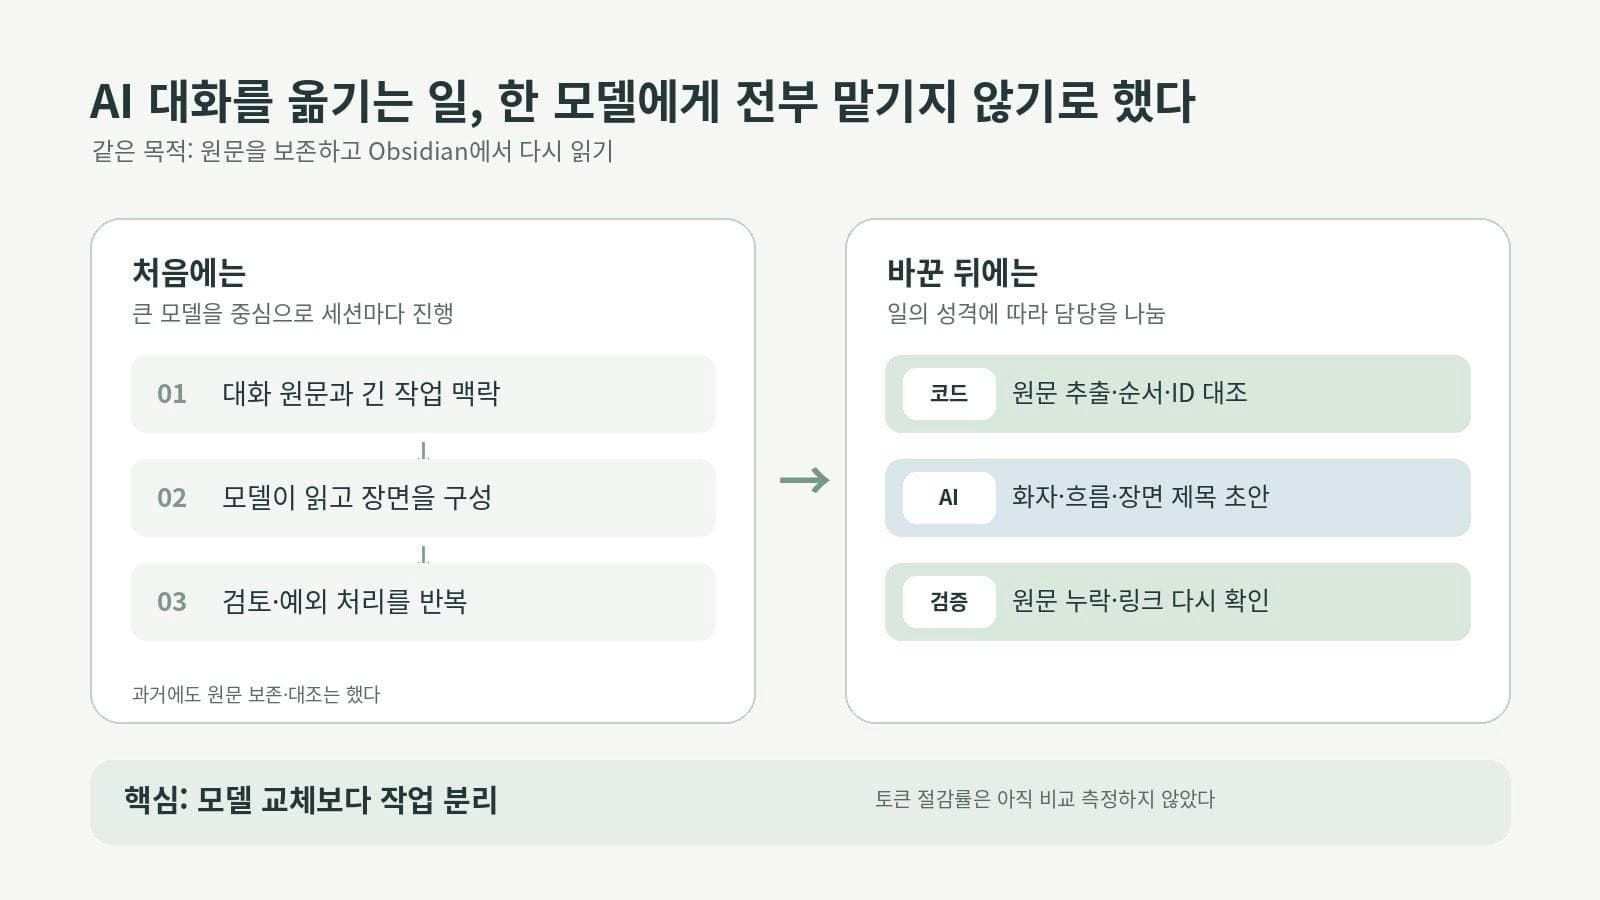
AI와 나눈 대화가 쌓일수록 아까운 순간들이 생겼다. 프로젝트의 출발점이 언제였는지 궁금할 때가 있었고, 어떤 날은 비슷한 농담을 나눈 날이 언제였는지 찾아보고 싶을 때가 있었다. 그런데 시간이 지나면 제목만 보고 그 내용을 다시 찾기 어려웠다. 그래서 원문을 보존하고, 옵시디언에서 읽기 좋은 목차와 장면으로 찾아볼 수 있는 체계를 만들기 시작했다. (봇과 나는 이를 '도서관'이라고 부르고 있다.)
마침 기한이 임박한 chat gpt 사용 한도 재설정권이 있어서 가장 좋은 모델인 astra로 과거 대화를 정리하는 일을 맡겼다. 그 결과 100세션을 조금 덜 못미치는 정도에서 내가 구독하는 100달러 요금제의 주간 사용한도 약 90%를 다 써버렸고 결국 사용한도를 재설정했다.
그제서야 토큰을 아껴야겠다는 필요성을 느꼈고, 단순히 더 싼 모델을 선택해서 정리하라고 시키기보다 기록으로 바꾸는 과정마다 더 효율적인 방법을 써야겠다고 생각했다.
‘대화를 정리한다’는 한 가지 일이 아니다
과거의 대화를 옵시디언에 정리하는 작업은 세 종류의 일이 섞여 있었다.
보존하기: 누가 어떤 순서로 말했는지 원문 그대로 가져오기.
이해하기: 대화가 어디서 전환되는지, 실제로 누가 말했는지, 어떤 제목이 읽기 좋은지 판단하기.
확인하기: 옮긴 글에서 원문이 빠지거나 달라지지 않았는지 대조하기.
이 중에서 AI가 꼭 필요한 부분은 주로 ‘이해하기’였다. 원문 ID를 대조하고, 파일을 만들고, 링크가 연결되는지 확인하는 일까지 매번 모델의 대화 속에서 풀어낼 필요는 없었다.
그래서 똑똑한 모델에게 맡길 일을 줄였다
새 방식에서는 원문을 읽기 전용으로 다루고, 발언 추출·순서 확인·파일 생성·원문 대조는 공통 코드가 맡도록 나눴다. AI에는 짧은 고정 지침과 이번에 판단할 대화 부분만 보낸다. AI는 화자와 장면의 흐름, 읽기용 제목 초안을 제안한다. 그 결과가 맞는지는 별도의 검사로 확인한다.
같은 원문과 같은 규칙으로 끝난 작업은 다시 모델에 보내지 않도록 했다. 오류가 생겨도 무작정 재호출하거나 다른 모델로 넘기지 않고, 무엇이 틀렸는지 먼저 확인한다. 토큰을 아끼려고 원문 검증을 생략한 게 아니다. 모델이 하지 않아도 되는 검증을 모델 밖으로 옮긴 것이다.
실제로 짧은 대화 한 세션을 이 방식으로 옵시디언에 옮겨 보았다. 정책상 보이는 발화 8개를 두 장면으로 나누고, 세션 목차에서 찾아 읽을 수 있게 연결했다. 시험 과정에서는 AI가 실제 화자를 빠뜨리거나 약속한 출력 형식을 어긴 적도 있었다. 그 결과를 그대로 받아들이지 않고 오류를 고친 뒤, 원문과 새 기록을 별도로 대조했다.
과거 대화를 정리하려는 사람이라면
대화 몇 개를 한 번 돌아보는 일이라면 AI에게 직접 읽고 요약해 달라고 해도 된다. 대신 요약을 원문으로 착각하지 않고, 중요한 문장은 다시 확인하면 된다.
반면 수십, 수백 개를 계속 보관하려면 처음부터 “전부 정리해줘”라고 맡기기 전에 작업을 나눠 보는 편이 좋을 것 같다. 원문은 어디에 그대로 남길지, AI가 실제로 판단해야 하는 부분은 무엇인지, 누락과 변형은 어떻게 확인할지부터 정하는 것이다. 기술을 잘 몰라도 우선 AI에게 이렇게 물을 수 있다.
“내 과거 대화를 옮기기 전에 작업을 원문 보존·내용 이해·결과 확인으로 나눠줘. 단순히 복사하거나 대조할 일과 AI가 읽고 판단할 일을 구분해줘. 먼저 작은 대화 하나로 시험하고, 원문을 요약문으로 대체하지는 마.”
참고: 이 방법으로 이전보다 ‘몇 % 절약했다’고 말할 수는 없다
예전 방식으로 처리한 세션과 새 방식의 파일럿을 같은 조건에서 비교해 토큰 사용량을 측정하지는 않았다. 약 100세션 뒤 사용 한도 약 90%에 도달했다는 것은 내 당시 경험이고, 방법을 바꾼 뒤 50세션정도 더 정리하였는데, 정리하는 내용도 제각각이고, 다른 작업과 같이 해서 얼마나 토큰을 아꼈는지는 정확히 파악할 수 없었다.(이 사례글을 쓰기 위해서라도 실험을 할까도 생각했는데 좀 귀찮아서 하지 않았다..)
그래도 작업을 대하는 질문은 바뀌었다. 예전에는 “어느 모델에게 정리를 맡길까?”를 먼저 생각했다. 지금은 “이 과정에서 AI가 꼭 읽고 판단해야 하는 것은 무엇일까?”를 먼저 묻는다. 내 대화를 오래 남기는 데 필요했던 변화는, AI에게 덜 중요한 일을 시키지 않는 것부터였다.
로그인하고 댓글을 남겨 주세요

인사이트와 정리하면서 얻은 고찰들이 도움이 많이 되었습니다!
강희주 님, 위 내용 정말 좋네요. 많이 배웠습니다.
지난 오프라인 모임에서 말씀드렸던, 3주차 때 이 내용을 바탕으로 미니 발표를 부탁드리고 싶습니다. 에이스 님과 상의해서 말씀드릴께요.

강희주님, 안녕하세요! 글 잘 읽었어요.
대화 정리를 "보존하기·이해하기·확인하기" 세 가지 일로 쪼개 보니 AI가 꼭 필요한 건 '이해하기'뿐이었다는 발견이 인상 깊었어요. 원문 ID 대조나 파일 생성처럼 코드로 할 수 있는 일을 모델 밖으로 옮기면서도 "검증을 생략한 게 아니라 모델이 안 해도 되는 검증을 밖으로 옮긴 것"이라고 선을 그어 둔 점이 특히 좋았습니다.
100달러 요금제 주간 한도의 90%를 쓰고 나서야 방향이 바뀌었다는 솔직한 시작과, "몇 % 절약했다고는 말할 수 없다"고 한계를 적어 둔 마무리도 믿음이 갔어요. 처음부터 "전부 정리해줘" 하기 전에 작업을 나눠 보라는 마지막 프롬프트도 바로 가져다 쓰고 싶었어요. 고롱고롱… 도서관이 점점 자라는 모습이 기대돼요 🐈⬛


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


흥미로운 사례입니다~
질문 드려요!
1. 챗지피티 앱에서 주로 대화하시나요?
2. 모든 대화를 다 백업하시나요 아니면 프로젝트 단위로 선별하시나요?
3. 어떤 방법으로 크롤링 하시나요?
4. 원문 추출하고 대조하는 것을 코드로 하신다 하셨는데 프로그램을 만드신 건가요?
1. 이번 글에서 정리한 것은 헤르메스(Hermes Agent)에서 나눈 대화입니다. ChatGPT 구독과 연결해 모델을 사용하다 보니 헷갈리게 적힌 것 같아요. 참고로 챗지피티에서 나눈 대화는 챗지피티앱에서 정리를 시키게 했습니다.
2. 특정 프로젝트만 선별하기보다는 일상 대화와 작업 대화를 함께 보관하는 방향입니다. 다만 자동 실행 기록이나 내부 시스템 메시지까지 전부 옮기는 것은 아니고, 실제로 주고받은 대화를 대상으로 확인하며 순차적으로 옮기고 있어요.
3. 웹페이지를 크롤링한 것은 아닙니다. 컴퓨터에 저장된 헤르메스 대화 DB에서 기록을 읽어 와서, 옵시디언에서 읽을 수 있는 마크다운 파일로 만드는 방식입니다. 원본 DB는 수정하지 않고 그대로 두고요.
4. 별도의 화면이 있는 앱을 만든 건 아니고, AI에게 요청해서 추출·파일 생성·대조용 스크립트를 만들었습니다. 발언 내용과 순서가 원문과 일치하는지는 코드로 검사하고, 대화를 어디서 나눌지나 어떤 제목을 붙일지처럼 내용을 이해해야 하는 부분은 AI가 맡도록 나눴어요.