"출입국 업무 정밀검토 앱" gatekit 하네스로 첫 버전 완성하기 (2주차)

2026.10.12
1단계. 시작 전
지난주까지 한 것
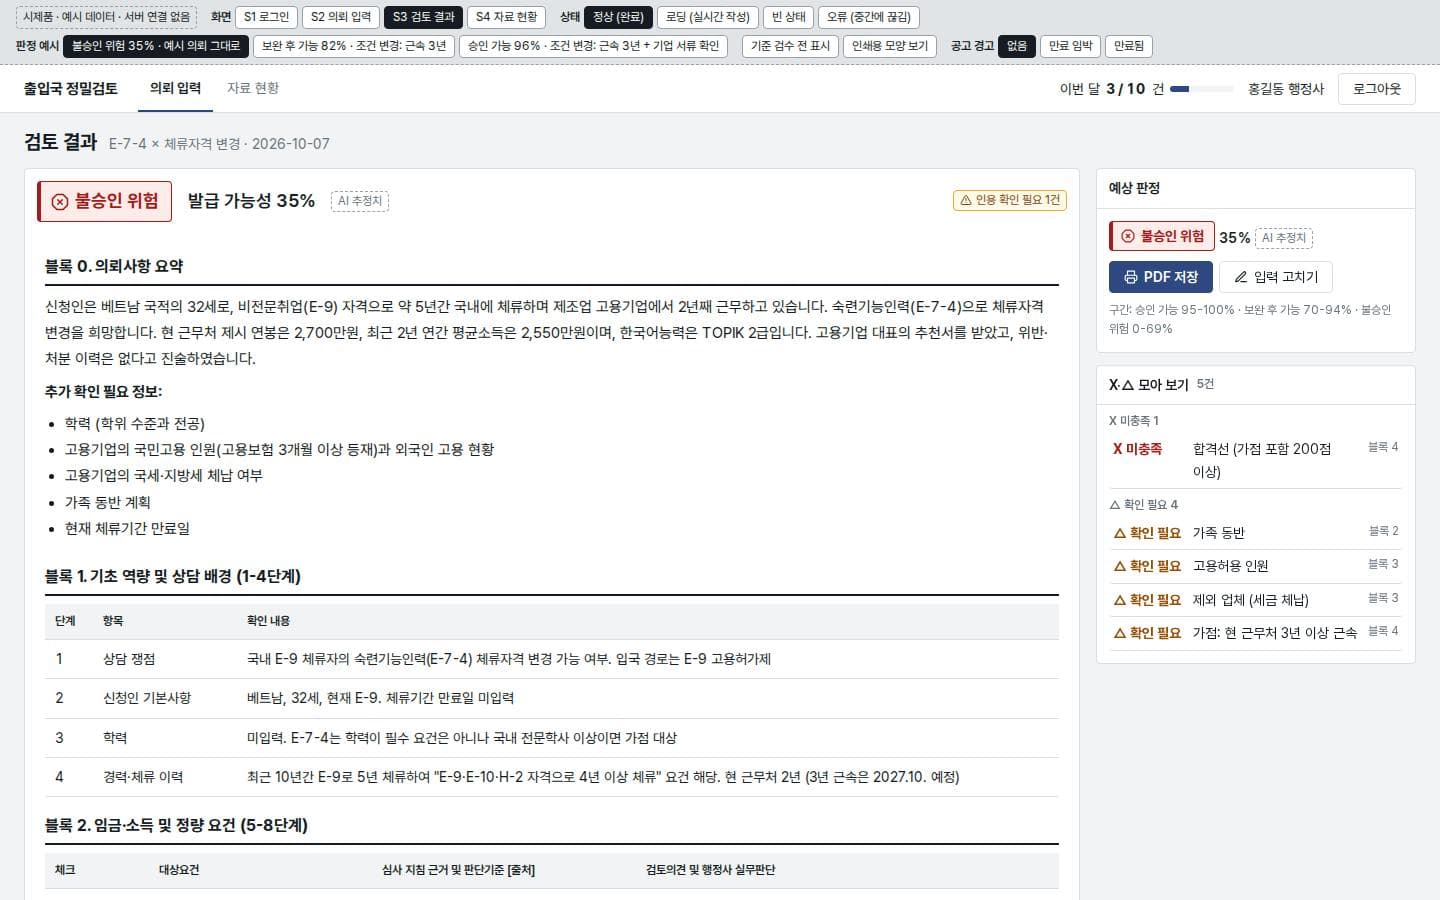
1주차에는 코드를 한 줄도 쓰지 않고 설계문서(무엇을, 누구를 위해, 왜 만드는지 적은 문서)만 만들었습니다. 만들 앱은 "출입국 업무 정밀검토 앱"입니다. 행정사가 의뢰 내용을 입력하면, 앱이 법무부 매뉴얼을 근거로 비자 요건을 하나씩 따져 예상 판정(승인 가능 / 보완 후 가능 / 불승인 위험)을 보여 줍니다.
이번 주 목표: 위임
이번 주부터 코드를 만듭니다. 다만 제가 짜는 게 아니라 Claude에게 맡깁니다(위임).
강의에서 배운 핵심은 이것입니다.
"AI가 일을 망치는 건 AI가 모자라서가 아니라, 작업 지시에 배경·범위·완료 기준이 빠져 있어서다."
걱정했던 것
저는 비개발자라 검은 화면(Ubuntu 터미널)부터 어려웠습니다. "과연 첫 버전까지 갈 수 있을까?"가 가장 큰 걱정이었습니다.
이번 단계에서 가장 중요하게 본 것: 화려한 화면보다 정확한 검토
이 앱의 가치는 예쁜 화면이 아니라 판정이 맞느냐에 있습니다. 그래서 지금 단계에서는 UI 디자인을 화려하게 꾸미기보다, 법무부 업무매뉴얼(사증·체류)과 시스템 프롬프트인 지침서에 따라 요건을 하나하나 정밀하게 따지는 것을 최우선으로 두었습니다. 화면은 업무 도구답게 단순하게 두고, 모든 판단에는 매뉴얼 근거 쪽수가 붙도록 했습니다.
2단계. 실습 과정
gatekit(설계 → 승인 → 제작 → 검사 순서를 지키게 하는 도구)의 순서대로 진행했습니다.
순서 | 명령 | 한 일 |
|---|---|---|
1 |
| 화면 디자인 규칙 정하기 (정보가 많은 업무 도구형 프리셋) |
2 |
| 클릭되는 시제품(진짜 기능 없이 화면만 있는 견본) 만들기 |
3 |
| 만들 일을 작업 8개로 쪼개기 |
4 |
| 완료 기준 5개를 정하고 승인(결재)하기 |
5 |
| Claude가 작업 8개를 차례로 만들고, 하나 끝날 때마다 저장(커밋) |
작업 쪼개기의 요령: 수직 슬라이스
화면만 먼저 다 만들고 나중에 기능을 붙이는 게 아니라, 화면·데이터·처리가 함께 도는 작은 단위로 쪼갰습니다. 예를 들어 "의뢰 입력 화면 + 입력값 검사 + 불가능 조합 안내"가 작업 하나입니다.
전문가 눈으로 잡아낸 것 2가지
AI가 만든 결과를 그대로 믿지 않고 원본과 대조했더니 오류가 나왔습니다.
시제품의 예시 점수: E-7-4 점수제 예시가 220점(합격)으로 나왔는데, 실제 점수표로 다시 계산하니 190점(합격선 200점 미달)이었습니다. → 예시 판정을 "불승인 위험"으로 바로잡음
매뉴얼 쪽번호: 광역형 비자 지침의 쪽 대응이 3쪽씩 어긋나 있었습니다. → 근거 쪽수가 틀리지 않게 고침
어려웠던 점: tasks·gate 단계, 특히 '기준값' 만들기
gatekit 순서 중 tasks(작업 쪼개기)와 gate(완료 기준을 정하고 승인)에서 시간이 가장 오래 걸리고 작업량도 가장 많았습니다. 그중에서도 기준값 만들기가 가장 힘들었습니다. 기준값은 앱이 판정할 때 쓰는 숫자와 요건입니다(예: E-7-4 점수제 합격선 200점, F-2-99 연간소득 4,000만원). 체류자격마다 매뉴얼에서 해당 쪽을 찾아 하나하나 옮겨야 했습니다.
내용이 너무 많음: 사증·체류 매뉴얼은 합쳐서 약 1,300쪽이고, 글자가 없는 그림 파일이었습니다. → 글자로 바꾼(OCR) 뒤, 판정에 쓰는 쪽은 원본 그림과 한 줄씩 대조했습니다.
매뉴얼 안에서도 숫자가 다름: 같은 매뉴얼 안에서 E-7-4 벌금 기준이 100만원과 300만원으로, F-6 소득표가 2024·2025·2026년 표로 섞여 있었습니다. → 행정사인 제가 기준을 정하고, 앱에는 "관서 확인 필요" 주석을 달았습니다.
토큰(크레딧) 소모가 큼: 원본 그림 대조와 긴 대화 때문에 크레딧이 빠르게 줄었습니다. → 판정 숫자·요건이 있는 쪽만 대조하고, 진행 상황을 인계서로 정리한 뒤 새 대화창으로 갈아타서(브랜치) 이어 갔습니다.
gate 재승인 반복: 체류자격 하나를 검수할 때마다 작업과 완료 기준이 늘어나, 그때마다 기준을 다시 승인해야 했습니다. → 번거롭지만 덕분에 기준이 몰래 바뀌지 않는다는 믿음이 생겼고, 승인은 Claude를 끈 창에서 명령 한 줄로 처리했습니다.
3단계. 결과물
동작하는 첫 버전을 완성했습니다.
로그인 → 의뢰 입력 → 정밀검토 → 결과 보고서까지 실제로 돌아갑니다. 지금은 예시 모드(실제 AI 대신 미리 만든 예시 보고서를 보여 주는 모드)입니다.
항목 | 결과 |
|---|---|
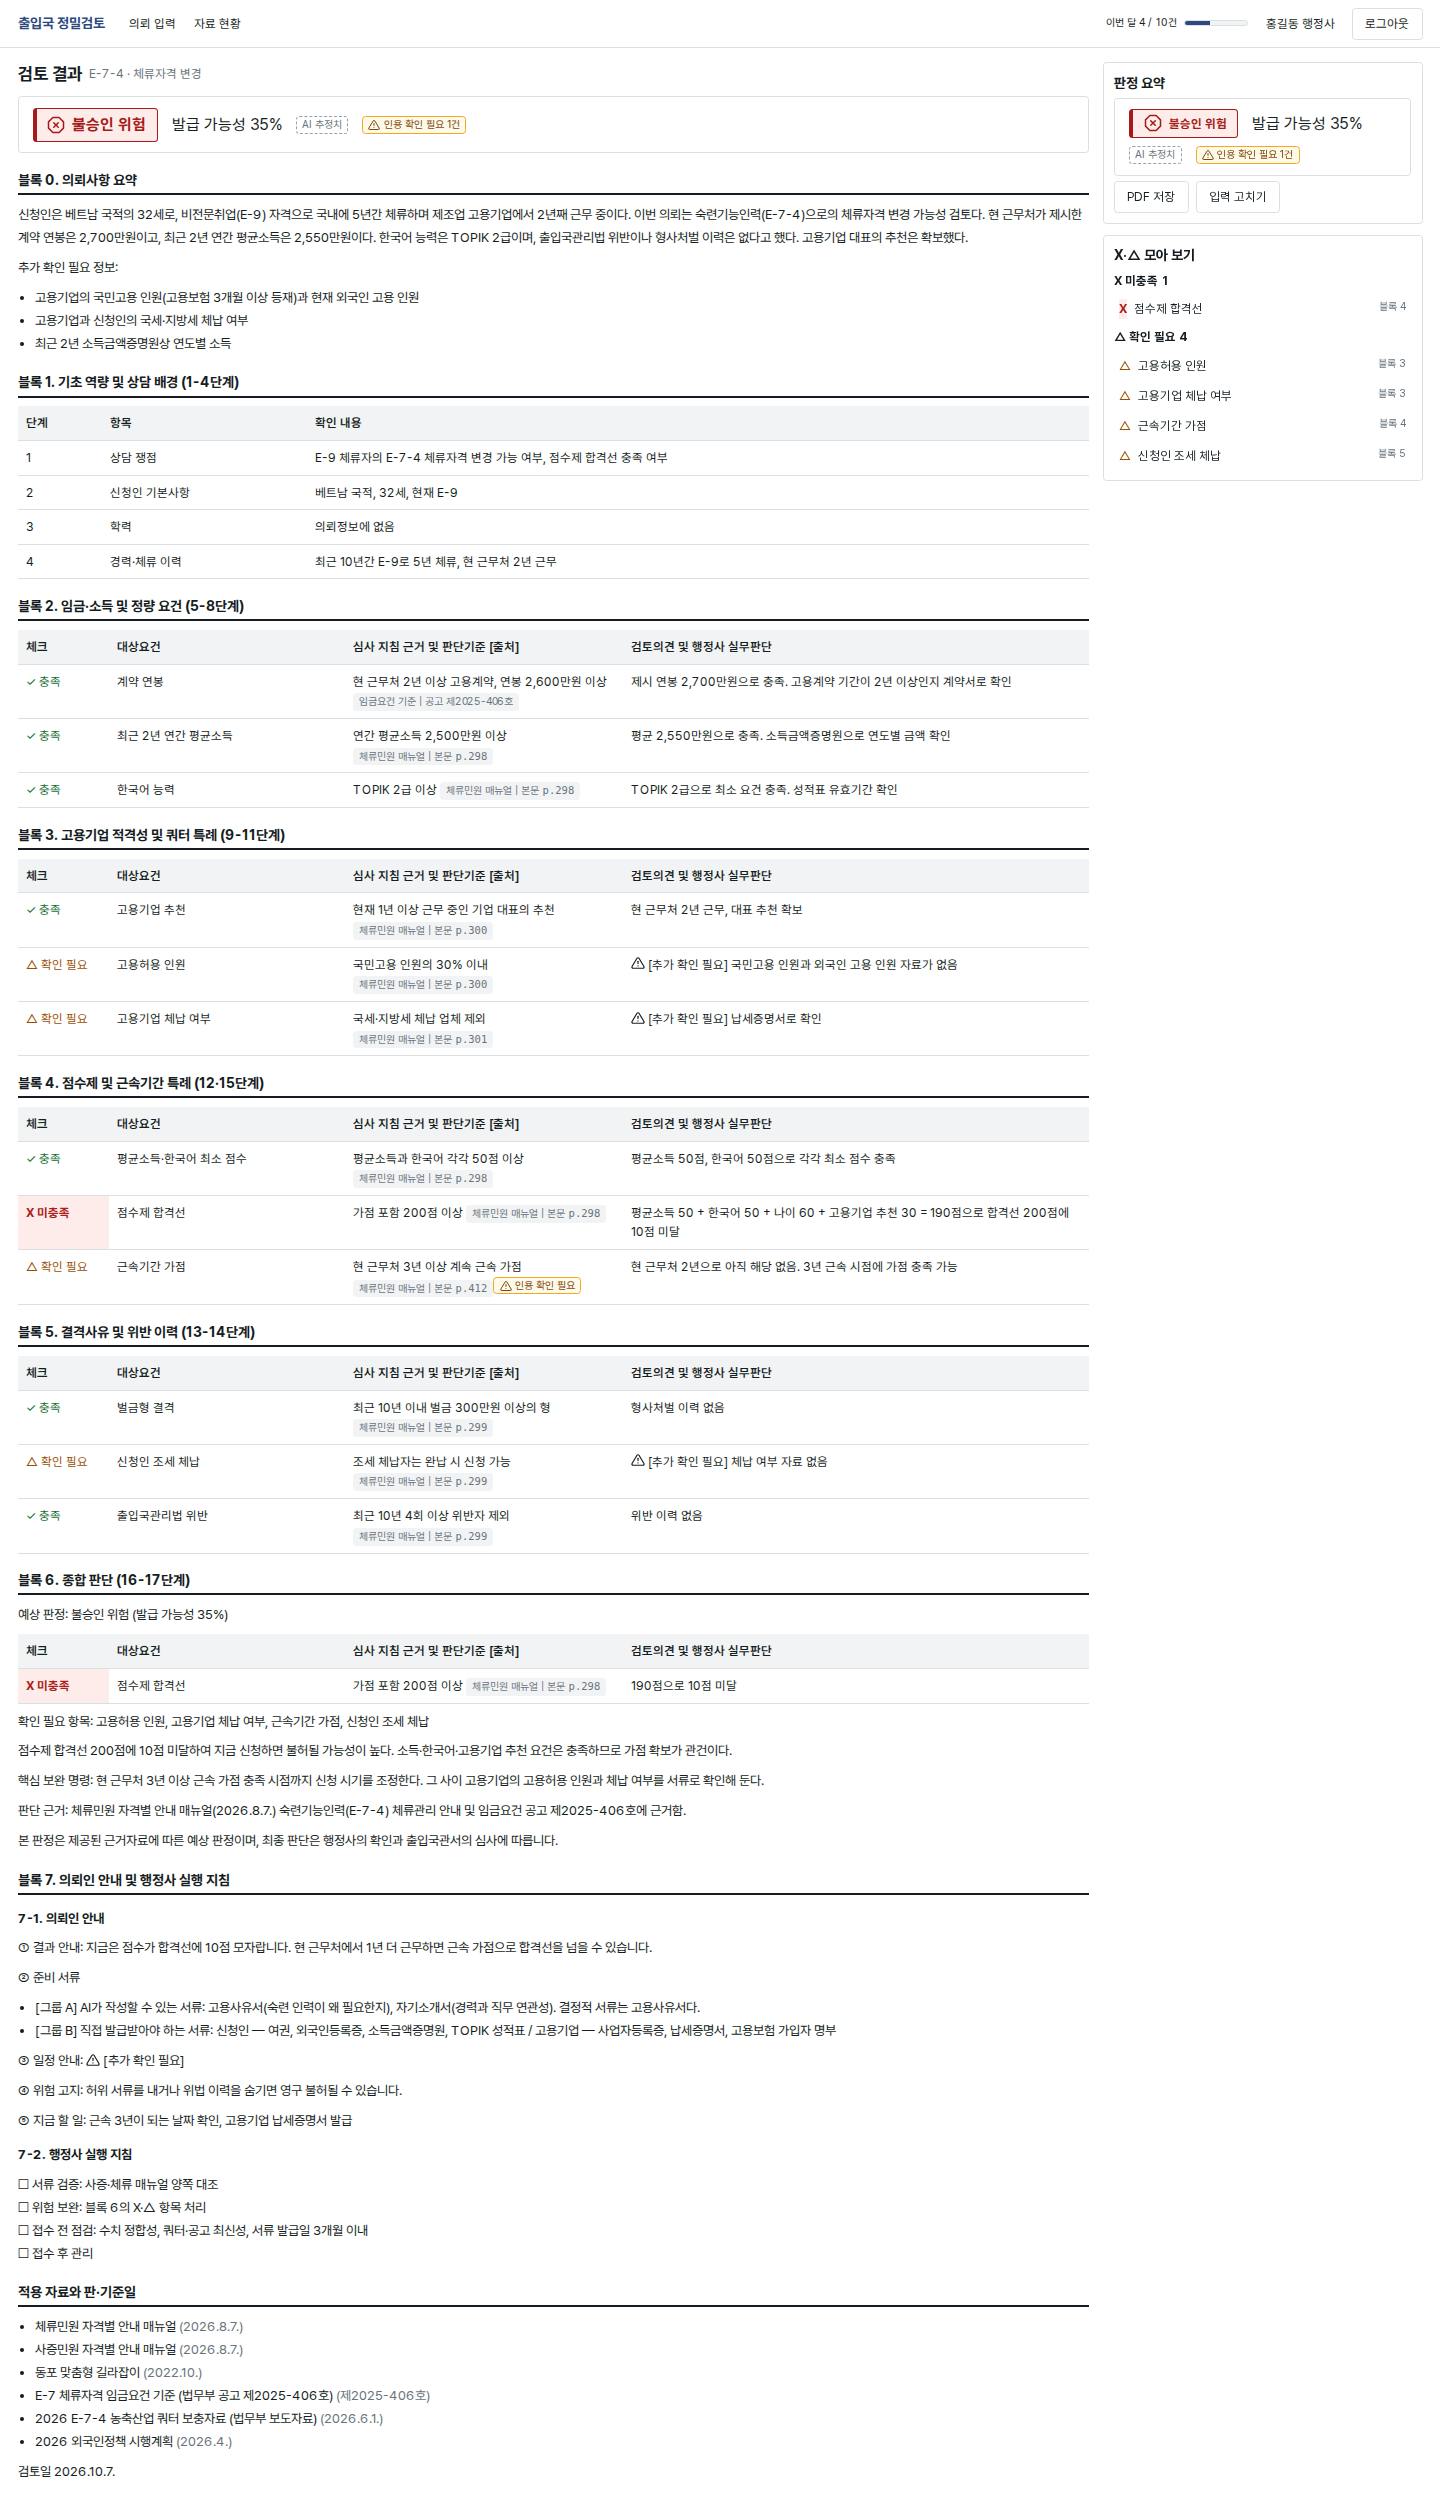
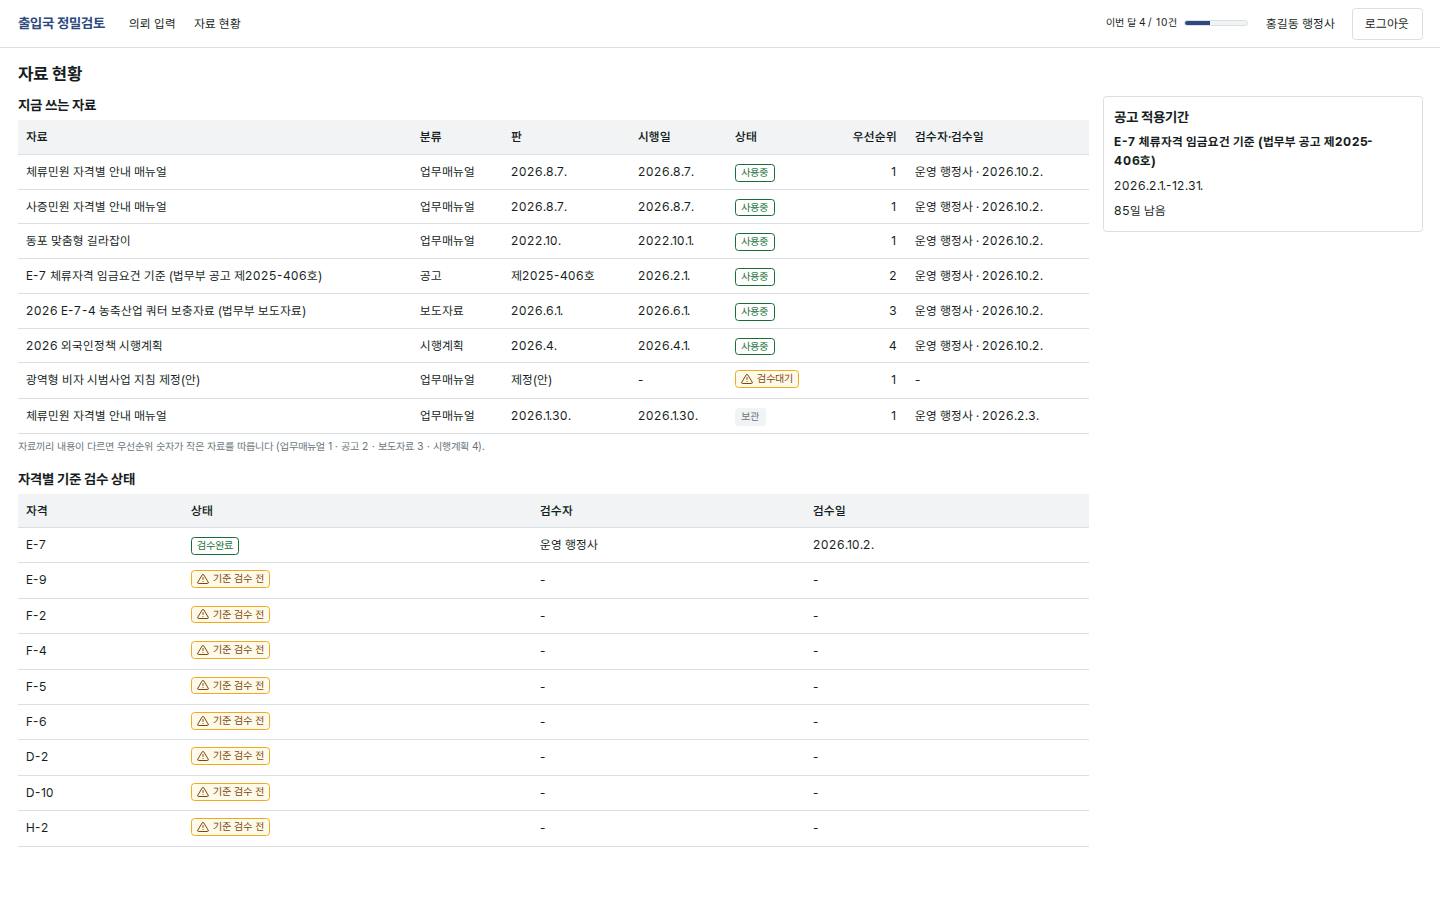
화면 | 4개 (로그인, 의뢰 입력, 검토 결과, 자료 현황) |
작업 | 8개 모두 통과 |
완료 기준 | 5개 모두 통과 (자동 테스트 117개, 타입 검사, 색 검사, 미완성 표시 없음, 브라우저로 실제 눌러 보기) |
저장(커밋) | 작업마다 저장, 총 10번 |
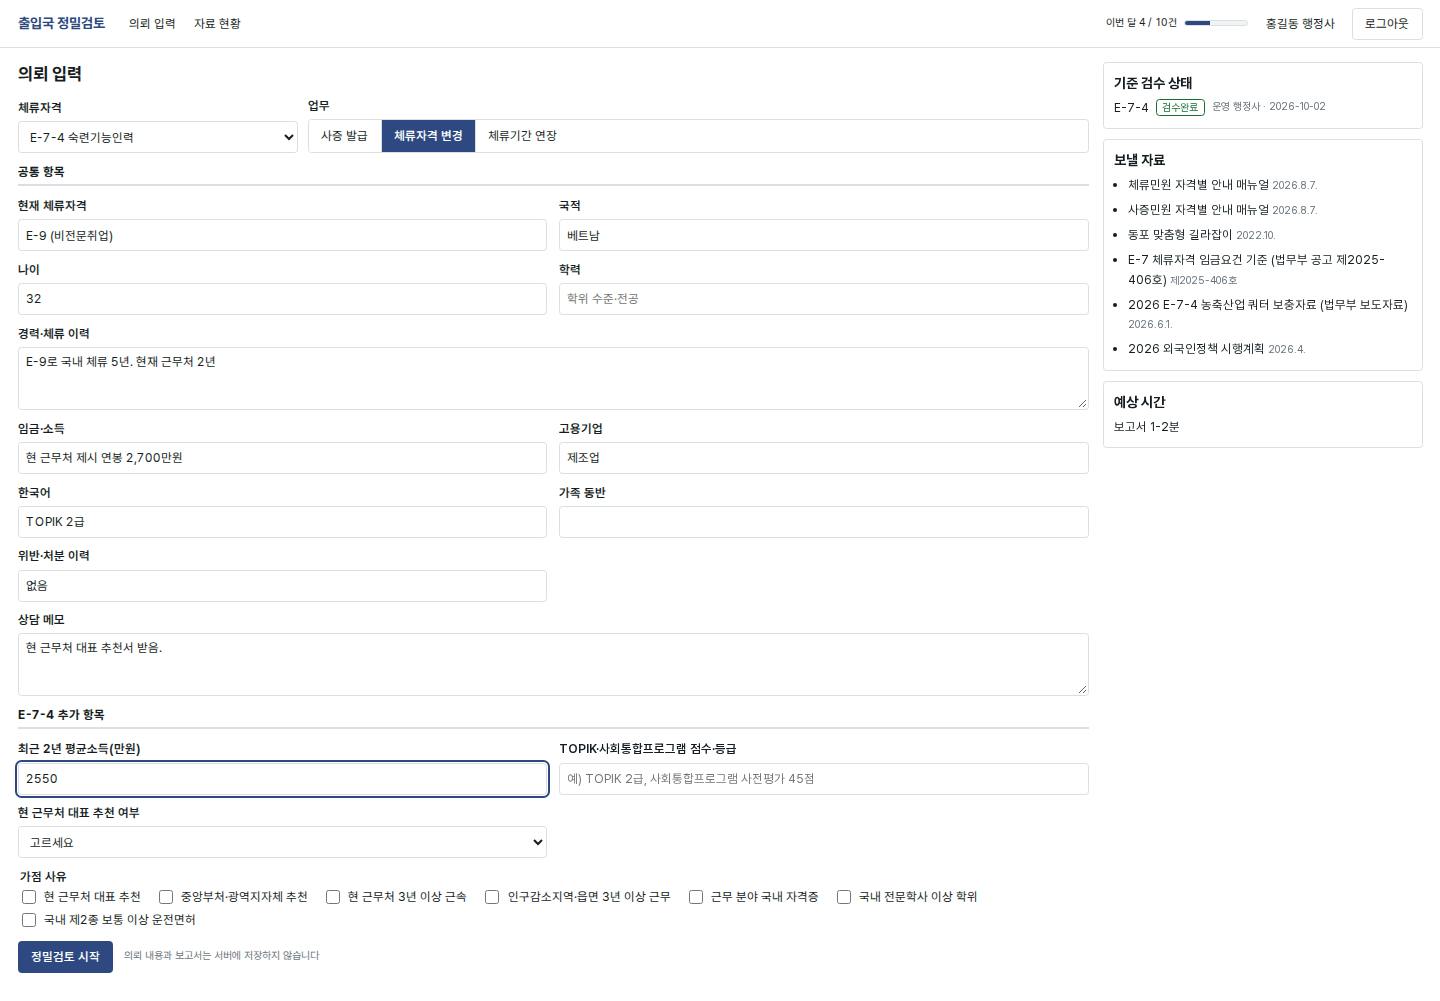
예시 결과 화면에서 확인한 것
맨 위에 "불승인 위험 · 발급 가능성 35% · AI 추정치"
블록 0~7 보고서와 4단 진단표(✓ 충족 / X 미충족 / △ 확인 필요), 근거 쪽수
[체류민원 매뉴얼 | 본문 p.298]"인용 확인 필요 1건": 일부러 넣은 가짜 쪽번호를 앱이 스스로 잡아냄
H-2 비자 발급을 고르면 "2026.2.12.부터 신규 발급 중단" 안내가 먼저 뜸
메모에 여권번호 같은 글자를 넣으면 개인정보 경고
4단계. 느낀 점
인상 깊었던 점
작업 지시가 자세하면 AI가 혼자 끝까지 간다. 작업마다 "무엇을 만들고, 어디까지 손대고, 무엇이 되면 끝인지"가 적혀 있으니, Claude가 작업 8개를 스스로 만들고 검사하고 저장했다.
기준은 몰래 못 바꾼다. 완료 기준을 고치자 승인이 자동으로 풀리고, 내가 다시 승인해야 했다. 귀찮지만, 그래서 "통과"를 믿을 수 있었다.
gatekit 뒤에는 파이썬 '전산 시스템'이 있다. 설계 문서 형식 검사부터 작업별 검사, 완료 기준 최종 심사까지 모든 단계를 파이썬이 기계적으로 확인했다. 그중 gate는 결재권자인 내가 명령 한 줄(approve)로 직접 도장을 찍는 창구였고, 마지막에
ok가 나오면 "승인한 기준이 그대로"라는 뜻이었다. AI가 일하고, 파이썬이 확인하고, 사람이 결재하는 구조라서 결과를 믿을 수 있었다.화면보다 근거가 먼저다. 화려한 디자인은 나중에도 바꿀 수 있지만, 매뉴얼과 지침서를 벗어난 판정은 행정사에게 쓸모가 없었다. 지금 단계에서는 "얼마나 보기 좋은가"보다 "업무매뉴얼과 지침서대로 정확히 검토하는가"가 훨씬 중요하다는 것을 다시 느꼈다.
전문가 검수는 여전히 사람 몫이다. 점수표 오류와 쪽번호 오류는 출입국 업무를 아는 사람만 잡을 수 있다. AI는 만들고, 행정사는 맞는지 판단해야 한다.
다음에 도전할 것
3주차: 다른 세션의 독립 검수(1차 완료, 기준 13/13 통과) 후 늘어난 자격까지 2차 독립 검수하기, 이미 시작한 9개 체류자격 기준 대조를 마무리하기
4주차: 실제 AI와 저장소를 연결하고, 동료 행정사가 실제 의뢰로 써 보게 하기
로그인하고 댓글을 남겨 주세요

신창환님, 코드를 한 줄도 안 쓰고 설계문서만 만든 1주차 뒤에 "위임"으로 넘어가 8개 작업을 전부 통과시킨 2주차 기록이네요. 특히 시제품의 E-7-4 점수제 예시가 220점(합격)으로 나왔는데 실제 점수표로 다시 계산하니 190점이라 "불승인 위험"으로 바로잡으셨다는 대목이 인상 깊었어요. AI가 만든 숫자를 원본과 대조해서 잡아낸 건 출입국 업무를 아는 분만 할 수 있는 검수라는 말씀에 깊이 공감합니다.
약 1,300쪽 그림 매뉴얼을 OCR하고, 판정에 쓰는 쪽만 한 줄씩 대조하신 방식도 크레딧을 아끼는 좋은 요령이에요. gate 재승인이 번거롭지만 "기준이 몰래 바뀌지 않는다"는 믿음으로 이어졌다는 점도 오래 남을 배움 같습니다. 고롱고롱… 3주차 독립 검수 이야기도 기다릴게요 ✨

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
너무 대단하십니다👍 👍 👍 :) 기준값 정하기 부터, QA까지 진행하고 계신것 같아요 :) 민감정보를 어떻게 처리하셨는지도 궁금하네요 :)
성명,전화번호 등 개인정보는 입력해도 앱에서 자동 걸러내는 방식입니다. 의뢰인이 착오로 넣었더라도 클코가 자동으로 삭제합니다. 클코 프로 요금제인데 정밀검토 앱이다보니 토큰 소모량이 어마어마 합니다. 별도 크레딧 구매후 작업합니다. 클코가 잘하는 만큼 머니도 마니 먹네요.ㅎ