과제 포기, 대신 업무(일부)자동화 도전
2024.07.02
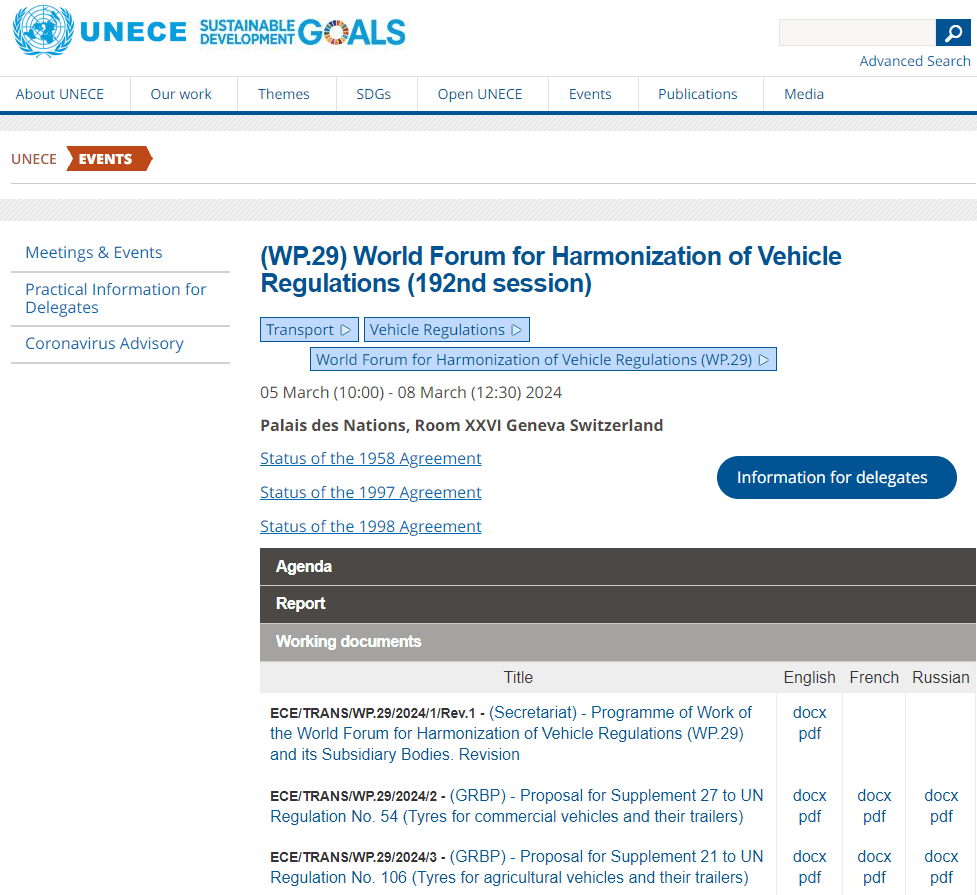
이번 과제는 일단 과감히 포기했습니다.
대신 제가 크롤링을 배울때 부터 목표로 했던 업무에 적용을 해보려고 도전했습니다.
저의 업무 중 유럽의 자동차법규가 업데이트 되는 것을 정기적으로 문서를 다운로드 받아야 하는 일이 있어요. 그 사이트는 아래와 같이 생겼습니다.
여기서 “Working document”의 English pdf 파일을 하나하나 다운 받아야 해요.
첫주 수업후에 사실 도전해본적이 있었는데, 이유는 모른채 실패했어요.
하지만, 곰곰히 생각해보니 저 “working document” 탭이 dynamic style(?)이어야 저 탭을 “open” 했을때부터 element를 추출하여 보여줬습니다. 그랬더니 성공.
아래의 step으로 발전시켜 갔습니다.
Step 1. Title과 English pdf 파일 크롤링
Step 2. 추출한 pdf에서 그 근거문서에 대한 reference 추출. 이 과정은 pdf 파일을 열었을 때 아래 표시된 문구만 추출하는 것.
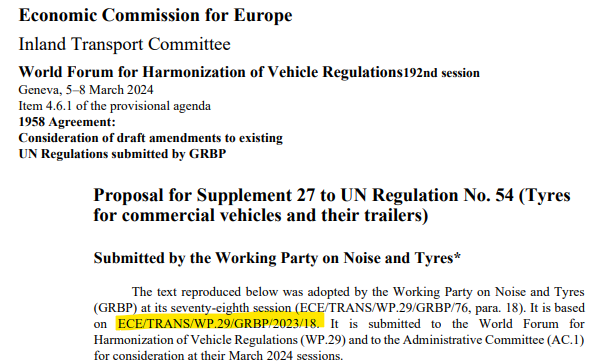
일단 시간 관계로 이렇게까지만 추출하고 다음의 미래의 step은 남겨두었습니다.
Step 3. 추출된 문서번호로 검색창에 입력하여 다시 그 파일의 링크 추출
Step 4. 최종 문서 summary 한글 번역
대신 오늘은 Step 2에서 Steamlit으로 과제 비슷하게 만들어 보았습니다.
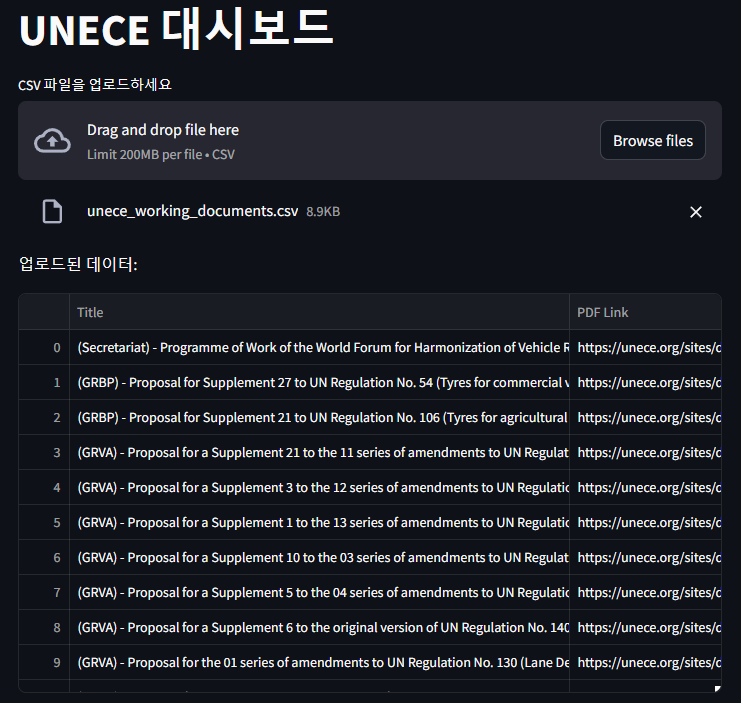
(옆으로 추출된 문서번호도 볼수가 있어요)
요기까지.
ps. 좀더 노력해야 할 부분
1) step 2에서 pdf 파일의 일부 내용 추출시 추출이 되는 파일도 있고, 추출을 실패하는 파일도 있는데 이유를 못찾겠습니다.
2) 문서 Summary 후 번역을 하고 싶은데 이게 가능한 일일까요?

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
1) step 2에서 pdf 파일의 일부 내용 추출시 추출이 되는 파일도 있고, 추출을 실패하는 파일도 있는데 이유를 못찾겠습니다.
→ 저도 자세히 살펴봐야 알것 같지만, 지금 제가 추측하기로는 중간에 time sleep이 잘 들어갔는지 궁금합니다.
2) 문서 Summary 후 번역을 하고 싶은데 이게 가능한 일일까요?
→ 가능은 합니다.
Gemini API를 쓰시면 가능할것 같습니다!
과제를 과감히 생략했지만 본인의 업무의 효율을 높힌점이 너무 좋았습니다!
수고 많으셨고, 이번 마지막 강의 때 남아서 시연해주시면 빠르게 더 피드백 드릴 수 있을 것 같습니다!! :)