KakaotalkLoader 만들어 보기(BaseLoader 상속 방식 코드 추가)
이른아침에
2024.07.08
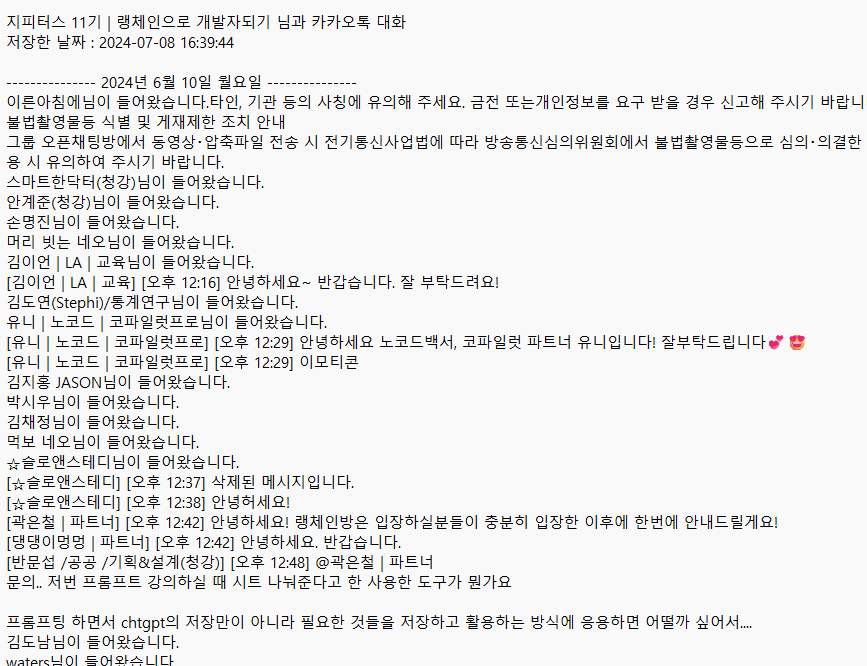
캠프 기간 동안 활발하게 운영된 단톡방의 대화 내용을 좀 더 활용해 보기 위해, kakaotalk 단톡방의 대화 내용을 다운로드 받은 파일(.txt)을 langchain의 document_loader 처럼.. Document 객체로 로드하는 “KakaotalkLoader”를 유사하게 한번 만들어 봤습니다.
(“인맥내비” 해커톤 준비하면서…)
작업 순서는 다음과 같습니다
카카오톡 오픈 채팅방 대화 내용 다운로드
대화 내용 정리 하는 코드 작성(with 클로드)
document loader 형식의 클래스 코드로 변환(by 클로드)
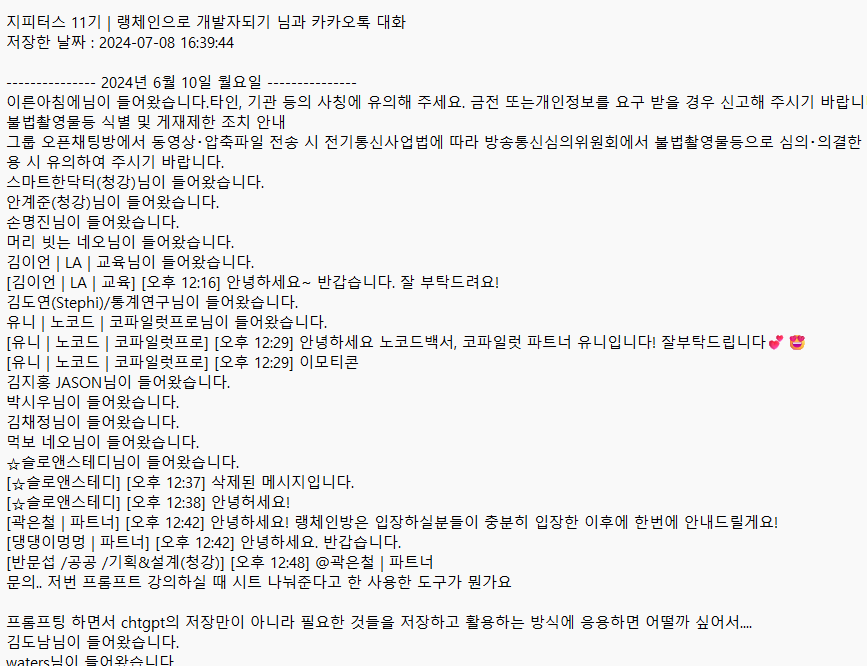
참고로.. 카카오톡 대화 내용 다운로드 텍스트 파일의 형식이 여러 가지가 있는 걸로 아는데요.
아래는 제가 사용한 다운로드 텍스트 파일의 형식입니다.(윈도우 카카오톡)
kakaotalk_loader.py 코드
import re
from langchain_core.documents import Document

class KakaoDocument(Document):
    def __repr__(self):
        return f"Document(page_content={self.page_content!r}, metadata={self.metadata!r})"

class KakaotalkLoader:
    def __init__(self, file_path):
        self.file_path = file_path

    def load(self):
        with open(self.file_path, 'r', encoding='utf-8') as file:
            text = file.read()

        campName, conversations = self._process_kakao_chat(text)
        return self._process_conversations(conversations, campName)

    def _process_kakao_chat(self, text):
        lines = text.split('\n')
        campName = lines[0].split(' 님과')[0]

        current_date = None
        conversations = {}

        for line in lines[1:]:
            date_match = re.match(r'--------------- (\d{4}년 \d{1,2}월 \d{1,2}일 [월화수목금토일]요일) ---------------', line)
            if date_match:
                current_date = date_match.group(1)
                conversations[current_date] = []
            elif current_date:
                conversations[current_date].append(line)

        return campName, conversations

    def _process_conversations(self, conversations, campName):
        documents = []
        for date, messages in conversations.items():
            current_message = ""
            skip_next = False

            for message in messages:
                if "님이 들어왔습니다." in message or "님이 나갔습니다." in message:
                    continue
                if "불법촬영물등 식별 및 게재제한 조치 안내" in message:
                    skip_next = True
                    continue
                if skip_next:
                    skip_next = False
                    continue

                match = re.match(r'\[(.+?)\] \[(.+?)\] (.+)', message)
                if match:
                    if current_message:
                        doc = self._create_document(current_message, campName, date)
                        if doc:
                            documents.append(doc)
                    nickname, time, content = match.groups()
                    current_message = f"[{nickname}] [{time}] {content}"
                else:
                    current_message += " " + message.strip()

            if current_message:
                doc = self._create_document(current_message, campName, date)
                if doc:
                    documents.append(doc)

        return documents

    def _create_document(self, message, campName, date):
        match = re.match(r'\[(.+?)\] \[(.+?)\] (.+)', message)
        if match:
            nickname, time, content = match.groups()
            return KakaoDocument(
                page_content=content,
                metadata={
                    "campName": campName,
                    "createDate": date,
                    "createTime": time,
                    "nickName": nickname
                }
            )
        return None
사용 방법
from kakaotalk_loader import KakaotalkLoader
import json

loader = KakaotalkLoader(r"C:\New_LLM_Camp\11_kakaotalk\KakaoTalk_20240708_1639_21_156_group.txt")
docs = loader.load()

# 필요한 정보만 추출하여 새로운 리스트 생성
cleaned_docs = [
    {
        "page_content": doc.page_content,
        "metadata": doc.metadata,
    } for doc in docs
]

# JSON 파일로 저장
with open('kakao_chat_docs_cleaned.json', 'w', encoding='utf-8') as f:
    json.dump(cleaned_docs, f, ensure_ascii=False, indent=4)

print("데이터가 'kakao_chat_docs_cleaned.json' 파일로 저장되었습니다.")
※ kakaotalk_loader.py 파일을 “myenv > Lib > site-packages > langchain-early”에 복사해 놓고, 다음과 같이 사용할 수 있음.
from langchain_early.kakaotalk_loader import KakaotalkLoader출력 결과 일부(json 파일)
[
    {
        "page_content": "안녕하세요~ 반갑습니다. 잘 부탁드려요!",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:16",
            "nickName": "김이언 | LA | 교육"
        }
    },
    {
        "page_content": "안녕하세요 노코드백서, 코파일럿 파트너 유니입니다! 잘부탁드립니다💕😍",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:29",
            "nickName": "유니 | 노코드 | 코파일럿프로"
        }
    },
    {
        "page_content": "이모티콘",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:29",
            "nickName": "유니 | 노코드 | 코파일럿프로"
        }
    },
    {
        "page_content": "삭제된 메시지입니다.",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:37",
            "nickName": "☆슬로앤스테디"
        }
    },
    {
        "page_content": "안녕허세요!",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:38",
            "nickName": "☆슬로앤스테디"
        }
    },
    {
        "page_content": "안녕하세요! 랭체인방은 입장하실분들이 충분히 입장한 이후에 한번에 안내드릴게요!",
        "metadata": {
            "campName": "지피터스 11기 | 랭체인으로 개발자되기",
            "createDate": "2024년 6월 10일 월요일",
            "createTime": "오후 12:42",
            "nickName": "곽은철 | 파트너"
        }
    },

...
...
...

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
@이재엽 배우신 분이라뇨.. 부끄럽습니다~ㅎㅎ 실력이 미천하여.. 기본부터 하나하나 공부해 보려고 합니다. 그래도 좋게 봐 주셔서 감사합니다!!