[9기 랭체인] LangChain 과제 수행
박희순
2024.02.12
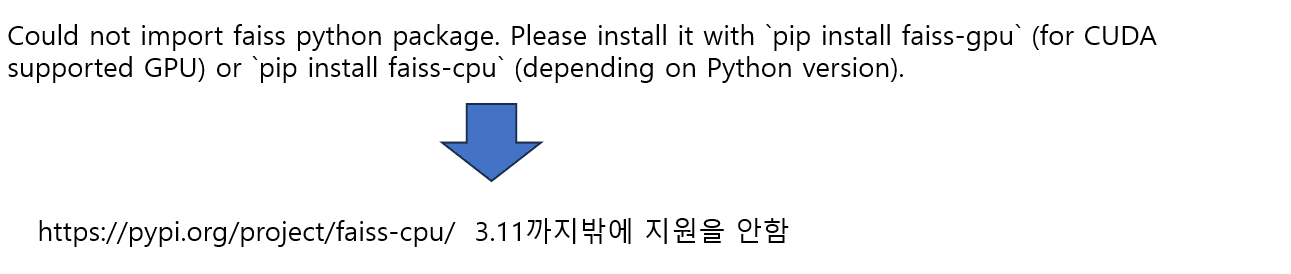
lanchain을 이용하여 내 자료를 저장하고 정보를 조회하여 대답하기
Data 준비 : 자료 데이터를 읽어서 텍스트 분리하여 준비
자료를 Embeddings모델을 이용하여 벡터DB에 저장(Chroma DB)
3. ChromaDB에서 질문과 관련된 내용을 similarity로 가져오기
4. 자료 기반의 질문-답변 chain만들기
1.Data 준비
    filename="스케줄.pdf"
    collection_name="schedule"
2. 자료를 Embeddings모델을 이용하여 벡터DB에 저장(Chroma DB)
def Text_embedding_test_chroma(docs, collection_name,persist_directory):
    embedding_model= GPT4AllEmbeddings()

    vectordb = Chroma.from_documents(
        documents=docs,
        collection_name=collection_name,
        embedding=embedding_model,
        persist_directory =persist_directory
    )

    vectordb.persist()
    vectordb=None
*저장 결과 확인
 def get_documentfromcolleciton(collection_name,persist_directory):
    client = chromadb.PersistentClient(path=persist_directory)
    collection = client.get_collection(name=collection_name)
    print(collection.count())
    print(collection.peek())
3. ChromaDB에서 질문과 관련된 내용을 similarity로 가져오기
vectordb = Chroma(persist_directory=dbname,
                  collection_name=collection_name,
                  embedding_function=embedding_function)
retriever = vectordb.as_retriever(search_type="similarity", search_kwargs={"k":2})
4.자료 기반의 질문-답변 chain만들기
llm_name = "gpt-3.5-turbo"
llm = ChatOpenAI(openai_api_key=openai_key,model_name=llm_name, temperature=0.1)
qa_chain = RetrievalQA.from_chain_type(
      llm,
       retriever=retriever,
       chain_type="stuff",
      chain_type_kwargs={"prompt": QA_CHAIN_PROMPT}
    )
question =input("질문을 입력해주세요    :  ")
results = qa_chain({"query": question})
result1=output_parser.invoke(results["result"])
print(results["result"])
7. 기타
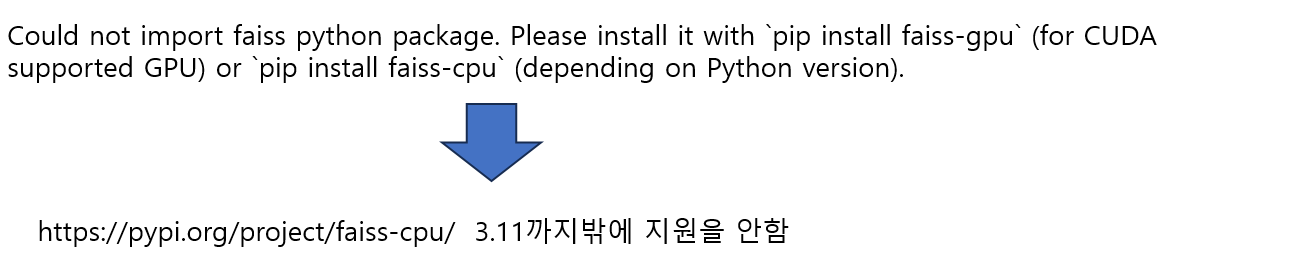
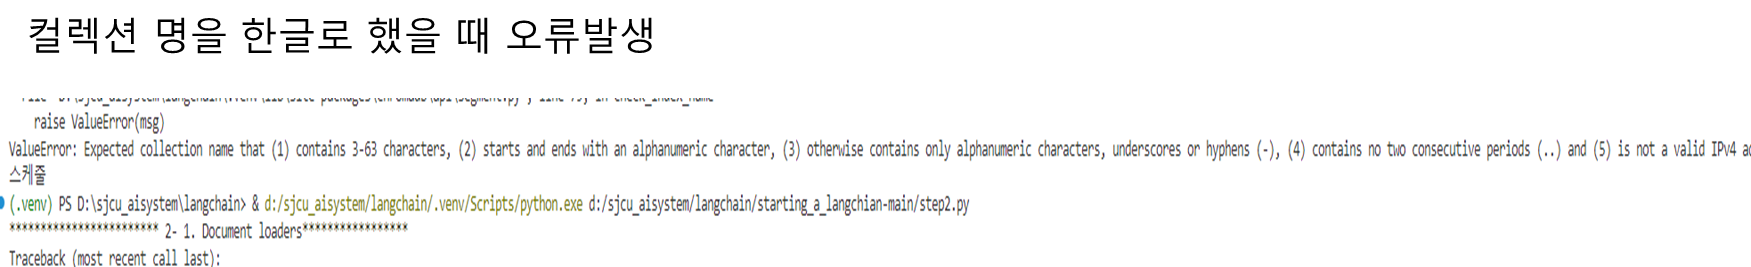
#9기랭체인

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
영어로 작성하지 않으면 오류가 발생하나 보네요. 오늘 랭체인을 배워볼 생각으로 다른 글을 읽어보고 있는데, 꿀팁 감사합니다 ㅎㅎ