RAG 생성을 위해 고려할 사항들
2024.09.03
배경 및 목적
RAG를 생성하고, 답변을 받을 때 주요한 요인 중 하나가 'RAG를 어떻게 생성했는가?' 이다
RAG를 생성 할 때 고려해야 할 요소들을 llama index의 SimpleNodeParser 옵션을 통해 이해해보고, 문서의 유형에 따라 적절한 옵션 값은 무엇인지 탐구해본다
참고 자료
RAG 우리가 절대 쉽게 결과물을 얻을 수 없는 이유(이경록, TEDDY)
인터넷 검색(구글서치, 라마인덱스 등)
손영진, 임유경, 박민정, & 채상미. (2024). 효과적인 RAG Document Data 구조화 전략. ASK 2024 학술발표대회 논문집, 31(1), 807-809.
클로드, GPT
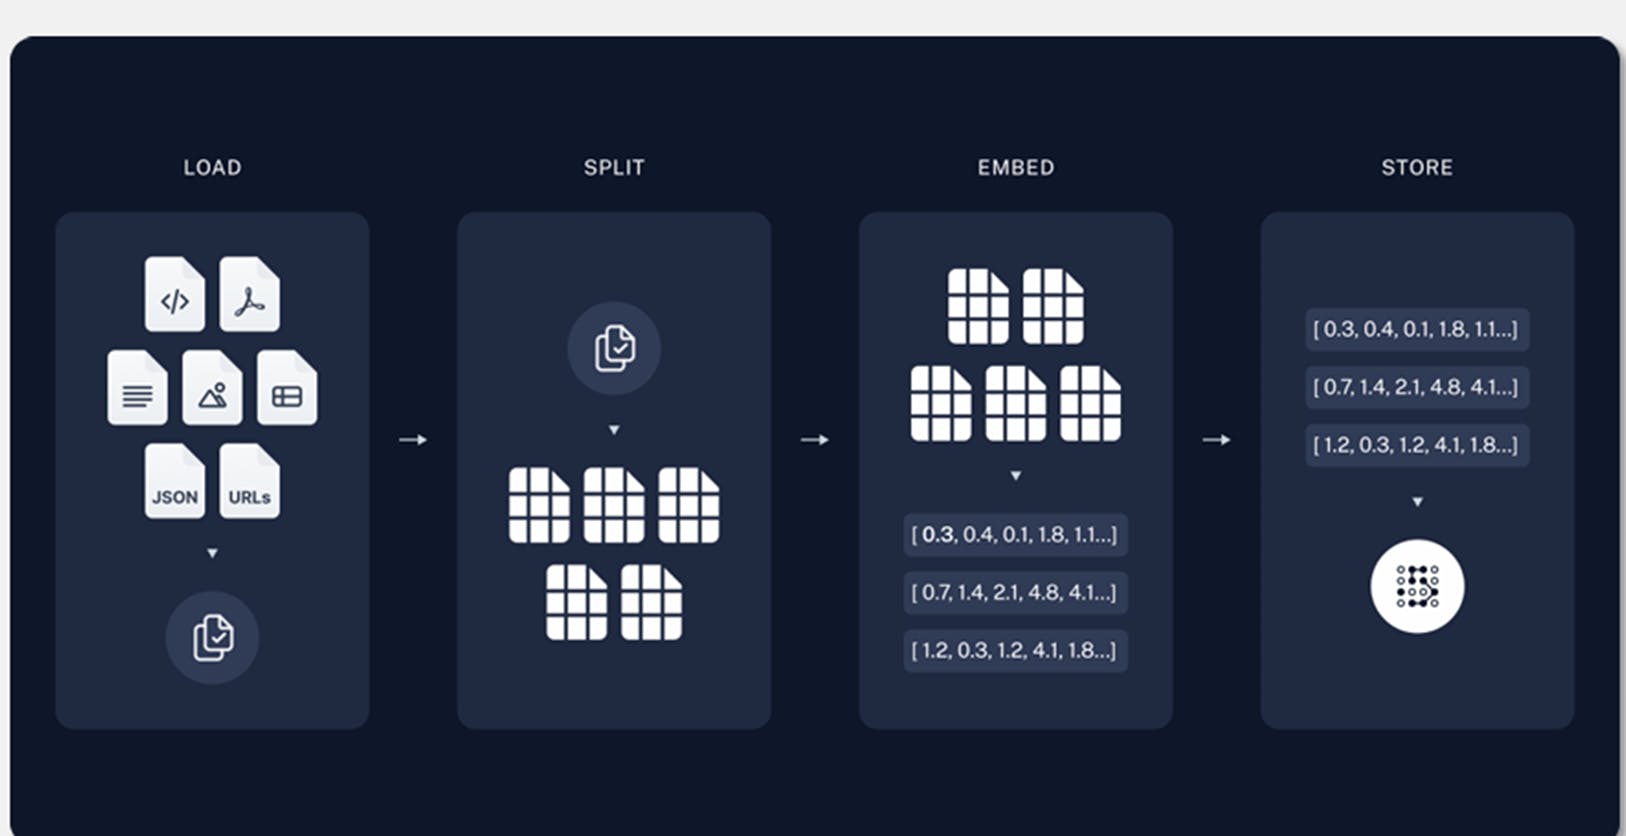
* RAG 문서 처리 과정
LOAD : 문서(PDF, HTML, TXT 등)을 불러오는 단계로 문서 형태에 따른 적절한 로더 선택, 대용량 문서처리 능력, 문서의 메타데이터 보존, 단어사전(정의, 유의어) 준비
SPLIT : 로드된 문서를 청크(Chunk)로 나누는 단계로 '청크 크기의 최적화', '오버랩', '형태소 분석기 선택
EMBED : 쪼개어진 청크를 백터로 변환하는 단계로, 적절한 임베딩 모델 선택, 다국어, 임베딩 차원 결정 필
STORE : 백터를 검색 가능한 형태로 저장하는 단계로 '백터 데이터베이스 선택', '인덱싱 방식 결정', '스케일링 가능성'여부를 검토
1. RAG를 만들 때 고려해야 할 요소들
가. 문서 분할 방식 (Document Splitting Method)
문서를 일정 크기로 나누는 방식이다. 청크 크기와 오버랩 설정이 문맥 유지와 검색 효율성에 중요한 영향을 미친다.
나. 텍스트 분할기 (Text Splitter)
문서를 나누는 기준을 정하는 것이다. 문단, 문장, 구두점, 특정 패턴 등을 기준으로 텍스트를 분할할 수 있다.
※ 텍스트 분할기의 종류
문단 단위 분할 (Paragraph Splitting): 문단을 기준으로 텍스트를 분할하여 내용의 흐름을 잘 유지할 수 있다.
문장 단위 분할 (Sentence Splitting): 문장을 기준으로 분할하여 자연스러운 문맥을 유지한다.
구두점 기반 분할 (Punctuation-Based Splitting): 마침표, 쉼표 등 구두점을 기준으로 텍스트를 분할한다.
문자수 기반 분할 (Character Count Splitting): 일정한 문자 수를 기준으로 텍스트를 나눈다.
토큰수 기반 분할 (Token Count Splitting): 토큰의 개수를 기준으로 텍스트를 분할하여 특정 길이로 청크를 나눈다.
다. 임베딩 방식 (Embedding Method)
텍스트를 벡터로 변환하는 방식이다. 임베딩 모델과 벡터 크기가 검색 결과의 정확성과 성능에 영향을 준다.
라. 벡터 검색 방식 (Vector Search Method)
벡터 간의 유사성을 계산하여 검색하는 방법으로, 검색 속도와 정확도에 영향을 미친다.
마. 인덱싱 전략 (Indexing Strategy)
텍스트나 벡터를 저장하고 검색하기 위한 인덱스 구조와 메타데이터 포함 여부가 검색 성능과 효율성에 중요한 역할을 한다.
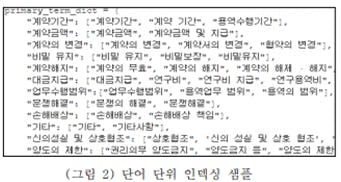
문서 안에서 같은 의미를 가진 다양한 표현이나 불필요한 단어들을 정리하고, 명확한 단어로 통일된 인덱싱 데이터를 제공함으로써 RAG 시스템의 정확도를 높일 수 있음
예) 단어의 정의, 유사어 사전 작성
바. 토크나이저 (Tokenizer)
텍스트를 토큰으로 나누는 방식으로, 언어 특성에 맞는 형태소 분석기를 선택하는 것이 중요하다.
사. 데이터 전처리 (Data Preprocessing)
텍스트의 표준화와 중복 제거를 통해 검색 일관성과 인덱스 효율성을 높이는 과정이다.
아. 쿼리 확장 (Query Expansion)
검색의 범위를 넓히기 위해 동의어나 유사어 등을 추가하여 쿼리를 확장하는 방법이다.
자. 데이터베이스(DB) 형태
RAG 시스템의 데이터 저장 및 검색 방식에 따라 성능과 확장성에 영향을 미치며, 관계형 DB, NoSQL, 벡터 DB 등이 있다.
차. 하드웨어 및 시스템 설정
GPU 사용과 메모리 관리는 임베딩 및 벡터 검색 성능을 최적화하는 데 중요한 요소이다.
2. 심플노드파서의 기본 옵션 (SimpleNodeParser)
※ 현재(0.11.3 ver)는 추천되지 않는 라이브러리(기존 코드를 위해서 존재)
가. chunk_size
설명: 각 청크의 최대 크기를 설정한다. 청크 크기는 주로 문자 수로 지정하며, 크기가 클수록 문맥을 잘 유지할 수 있지만, 검색의 세분화가 떨어질 수 있다. 예를 들어, 소설이나 긴 문서에서는 큰 청크가 유리할 수 있다.
기본값: 보통 512 또는 1024로 설정하며, 필요에 따라 조정할 수 있다.
나. chunk_overlap
설명: 인접한 청크 간의 겹치는 문자 수를 설정한다. 오버랩을 통해 청크 간의 문맥을 자연스럽게 이어줄 수 있다. 예를 들어, 설명이 연속적인 기술 문서에서는 오버랩이 중요하다.
기본값: 일반적으로 50에서 100 사이의 값을 사용하며, 문서의 특성에 따라 조정할 수 있다.
다. text_splitter
설명: 문서를 청크로 나눌 때 사용하는 텍스트 분할기를 지정한다. 기본적으로
RecursiveCharacterTextSplitter를 사용하지만, 필요에 따라 문장 단위로 나누는SentenceSplitter나 문단 단위로 나누는ParagraphSplitter등 다양한 커스텀 분할기를 지정할 수 있다.기본값:
RecursiveCharacterTextSplitter예시:
SentenceSplitter,ParagraphSplitter,CharacterSplitter,TokenSplitter등.
라. include_metadata
설명: 각 청크에 문서의 메타데이터(예: 문서 제목, 작성일 등)를 포함할지 여부를 설정한다. 메타데이터를 포함하면 검색할 때 특정 문서를 쉽게 찾거나 필터링하는 데 도움이 된다. 예를 들어, 특정 날짜에 작성된 문서만 검색하고 싶을 때 유용하다.
기본값: True
마. include_prev_next_rel
설명: 각 청크 간의 이전/다음 관계를 유지할지 여부를 설정한다. 이 옵션을 활성화하면, 문서의 논리적 흐름을 자연스럽게 이어줄 수 있다. 예를 들어, 보고서나 매뉴얼에서 단계별 절차를 유지하는 데 유용하다.
기본값: False
바. metadata_extractor
설명: 커스텀 메타데이터 추출기를 지정하여, 문서에서 특정 메타데이터를 추출하고 청크에 포함할 수 있다. 이 기능은 기본 메타데이터 외에 추가적인 정보를 추출하여 사용하고자 할 때 유용하다. 예를 들어, 문서의 특정 섹션에서 중요한 키워드를 추출해 메타데이터로 활용할 수 있다.
기본값: None
사. tokenizer
설명: 텍스트를 토큰으로 나누는 데 사용하는 토크나이저를 지정한다. 언어의 특성에 맞는 적절한 토크나이저를 선택하는 것이 중요하다. 예를 들어, 한국어 문서의 경우 Mecab, Okt, Komoran 등의 한국어 특화 토크나이저를 사용할 수 있다.
기본값: LlamaIndex의 내장 토크나이저 (필요시 외부 토크나이저 사용 가능).
※ 비고: 한국어 처리 시 KoNLPy (Korean Natural Language Processing in Python), Mecab이 많이 이용됨.
Mecab-ko: 속도가 빠르고, 형태소 분석 성능이 뛰어나 한국어 처리에 널리 사용됨.
KoNLPy: 여러 한국어 형태소 분석기를 지원하여 다양한 텍스트 처리 작업에 활용 가능함.
Okt (Open Korean Text): 구어체와 비정형 텍스트에 강점이 있으며, 대화체나 서술형 문서를 자연스럽게 처리할 수 있음.
Komoran: 정확한 형태소 분석과 복잡한 문장 구조 처리가 필요한 기술 문서나 법률 문서에 적합함.
Hannanum: 오래된 형태소 분석기 중 하나로, 학술 연구 등에서 사용되며 문장 구조 분석에 강점이 있음.
Kkma: 형태소 분석과 더불어 구문 분석 기능을 제공하여, 복잡한 문장 구조를 다룰 때 유용함.
3. 문서 유형별 적정 옵션 값
가. 서술형 문서
유형 : 소설, 보고서, 매뉴얼, 법률 문서
청크 크기: 500
오버랩: 75
include_prev_next_rel: True (서술형 문서는 앞뒤 내용이 논리적으로 연결되는 것이 중요)
tokenizer: KoNLPy의 Okt (다양한 문장 구조와 구어체 처리 필요)
나. 기술적 문서
유형 : 코드 설명서, API문서, 설치 가이드, 매뉴얼
청크 크기: 400
오버랩: 75
include_prev_next_rel: True (특정 개념, 절차, 문제 해결 방법과 같은 구조를 띠기 때문에 순서가 중요)
tokenizer: KoNLPy의 Komoran (정확한 용어와 복잡한 문장 구조 처리가 요구됨)
다. 대화형 문서
유형 : 대화록, 인터뷰 기록, 고객 지원 로그
청크 크기: 350
오버랩: 75
include_prev_next_rel: True (대화형 문서에서 앞뒤 대화의 연결이 중요)
tokenizer: KoNLPy의 Okt (자연스러운 대화체 처리가 중요하기 때문에 Okt가 적합함)
라. 교육 자료
유형 : 강의 노트, 교과서, 학습 가이드
청크 크기: 400
오버랩: 75
include_prev_next_rel: True (교육 자료에서 앞뒤 개념이 서로 이어져 설명되는 것이 중요)
tokenizer: KoNLPy의 Komoran (정확한 개념 전달과 용어 분석 필요)
마. 법률 문서
유형 : 계약서, 법률 조항, 판계
청크 크기: 500
오버랩: 125
include_prev_next_rel: True (법률 문서에서 조항 간의 논리적 연결이 매우 중요)
tokenizer: KoNLPy의 Komoran (복잡한 문장 구조와 정확한 용어 처리가 필수)
바. 연구 논문
유형 : 학술논문, 연구 보고서
청크 크기: 500
오버랩: 125
include_prev_next_rel: True (연구 논문에서 각 섹션 간의 논리적 연결이 매우 중요)
tokenizer: KoNLPy의 Okt (다양한 문장 구조와 자연스러운 텍스트 처리가 중요)
사. 스토리텔링 자료
유형 : 시나리오, 연극 대본, 스토리 보드
청크 크기: 400
오버랩: 75
include_prev_next_rel: True (스토리텔링 자료에서 이야기의 연속성이 중요)
tokenizer: KoNLPy의 Okt (구어체와 서술 처리에 강한 Okt가 적합)
아. 프로젝트 문서
유형 : 프로젝트 계획서, 진행 보고서, 마일스톤 문서
청크 크기: 400
오버랩: 75
include_prev_next_rel: True (프로젝트 문서에서 단계별 내용이 논리적으로 이어지는 것이 중요)
tokenizer: KoNLPy의 Komoran (정확한 용어와 단계적 설명이 중요)
자. 도표 위주 실적 자료
유형 : 실적 보고서, 그래프 및 테이블이 많은 보고서
청크 크기: 250
오버랩: 20
include_prev_next_rel: False (도표 위주 문서에서 앞뒤 도표 간의 관계가 중요하지 않음)
tokenizer: KoNLPy의 Okt (간단한 설명 텍스트 처리가 중요하기 때문에 Okt가 적합)
결과 및 인사이트
본 학습을 통해 RAG를 만들 때 고려해야 할 요소들을 깊이 이해할 수 있었고, LlamaIndex의 SimpleNodeParser 옵션에 대해 조사하면서 청크 크기와 오버랩 설정이 문서의 흐름을 유지하고 검색 결과의 품질을 향상시키는 데 어떻게 기여하는지를 알게 되었다. 또한, 문서의 특성에 따라 메타데이터 포함 여부나 이전/다음 관계 유지 설정이 RAG 시스템의 검색 정확성을 어떻게 높일 수 있는지 파악하게 되었으며, 이를 바탕으로 문서 유형별 옵션 전략을 설정하는 데 유용한 기준점을 마련할 수 있었다.
로그인하고 댓글을 남겨 주세요
정리해 주신 내용 잘 봤습니다.
말씀 주신 SimpleNodeParser 코드가 어떻게 되어 있는지를 보려고 찾아 봤는데.. 못 찾겠더라구요 ???
혹시 어디서 볼 수 있을까요 ???
"llamaindex simplenodeparser"로 검색하니 다음과 같은 내용만 나오네요..
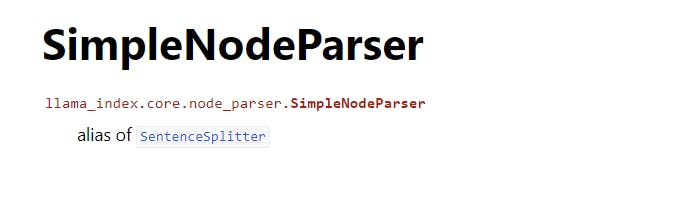
말씀 해주신 내용으로 이리저리 수소문 해보니, 제가 사용하는 llama index 0.11.3(깃헙 node_parser폴더의 init.py 참조)에선 기존 코드를 지원하기 위해 남아는 있지만 SentenceSplitter로 대체 이용을 권하는 상태라 하네요.(그런데 sentencesplitter엔 simplenodeparser에서 제공하는 include_prev_next_rel 옵션이 없네요 ㅠㅠ, 아마 다른 라이브러리(맞나?)에서 제공할 것 같은데, 추후 찾아서 업데이트 하겠습니다)
파이썬을 한번도 배워본적 없이 코드짜고 학습하느라 눈뜨고 전력질주 하는 기분 입니다.ㅠㅠ 조언 감사드립니다 👍
막연하게 문서의 문장구조나 단어의 수 등을 통해 적절한 chunk size나 다른 옵션 값을 추출할 수 있을거라 생각했었는데. 역시 선구자들이 있군요^^ 후속 스터디도 진행하겠습니다. 감사합니다~
간단한 예를 들어 html 과 md 형식인 경우 맥략을 이어주기 위해 h1, 기준으로 다음 h2 또는 h3 이 내용이 많아서 청크로 나뉠때 h1 또는 h2 정도를 다음 잘린 청크에 h1 과 h2 텍스트를 붙여줍니다. 이는 오버랩보다 훨씬 효과적이고 맥락을 이어주는 주요한 역할을 합니다. 물론 응용해서 앞선 내용을 요약해서 넣어줘도 되구요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
정리되어 좋네요.
사실 최종 답변에 따라서(사용자의 니즈) 청크는 조정 되어야 하는 경우가 많지만 기준점을 제시하는 건 RAG로 고민하시는 분들에게 좋은 자료인것 같습니다.