나만의 컴퓨터에서 채팅 가능한 UI에서 돌리는 SLLM (feat. gemma, llama, gradio)
2024.07.29
과제 소개
Gemma, llama3 등 SLLM 모델들을 개인 PC에서 돌릴 수 있게 하며, 채팅 웹 UI에서 사용할 수 있도록 구현
목적
chatGPT에 의존하지 않고, SLLM을 개인 PC에서 돌리면서 업무 가능
chatGPT를 돌리지 못하는 상황 (데이터 반출 금지)에서 사용 가능
과제 목표 : 회사 구성원들이 업무상 필요한 나만의 챗봇을 누구나 손쉽게 구현하여 활용 할 수 있도록 하여 업무 생산성을 높이고자 함.
방법론
본 과제는 gradio를 활용하여 구현하고자 함
사용 도구 : 개발 환경(VS Code, powershell), LLM(llama3, gemma), Gradio
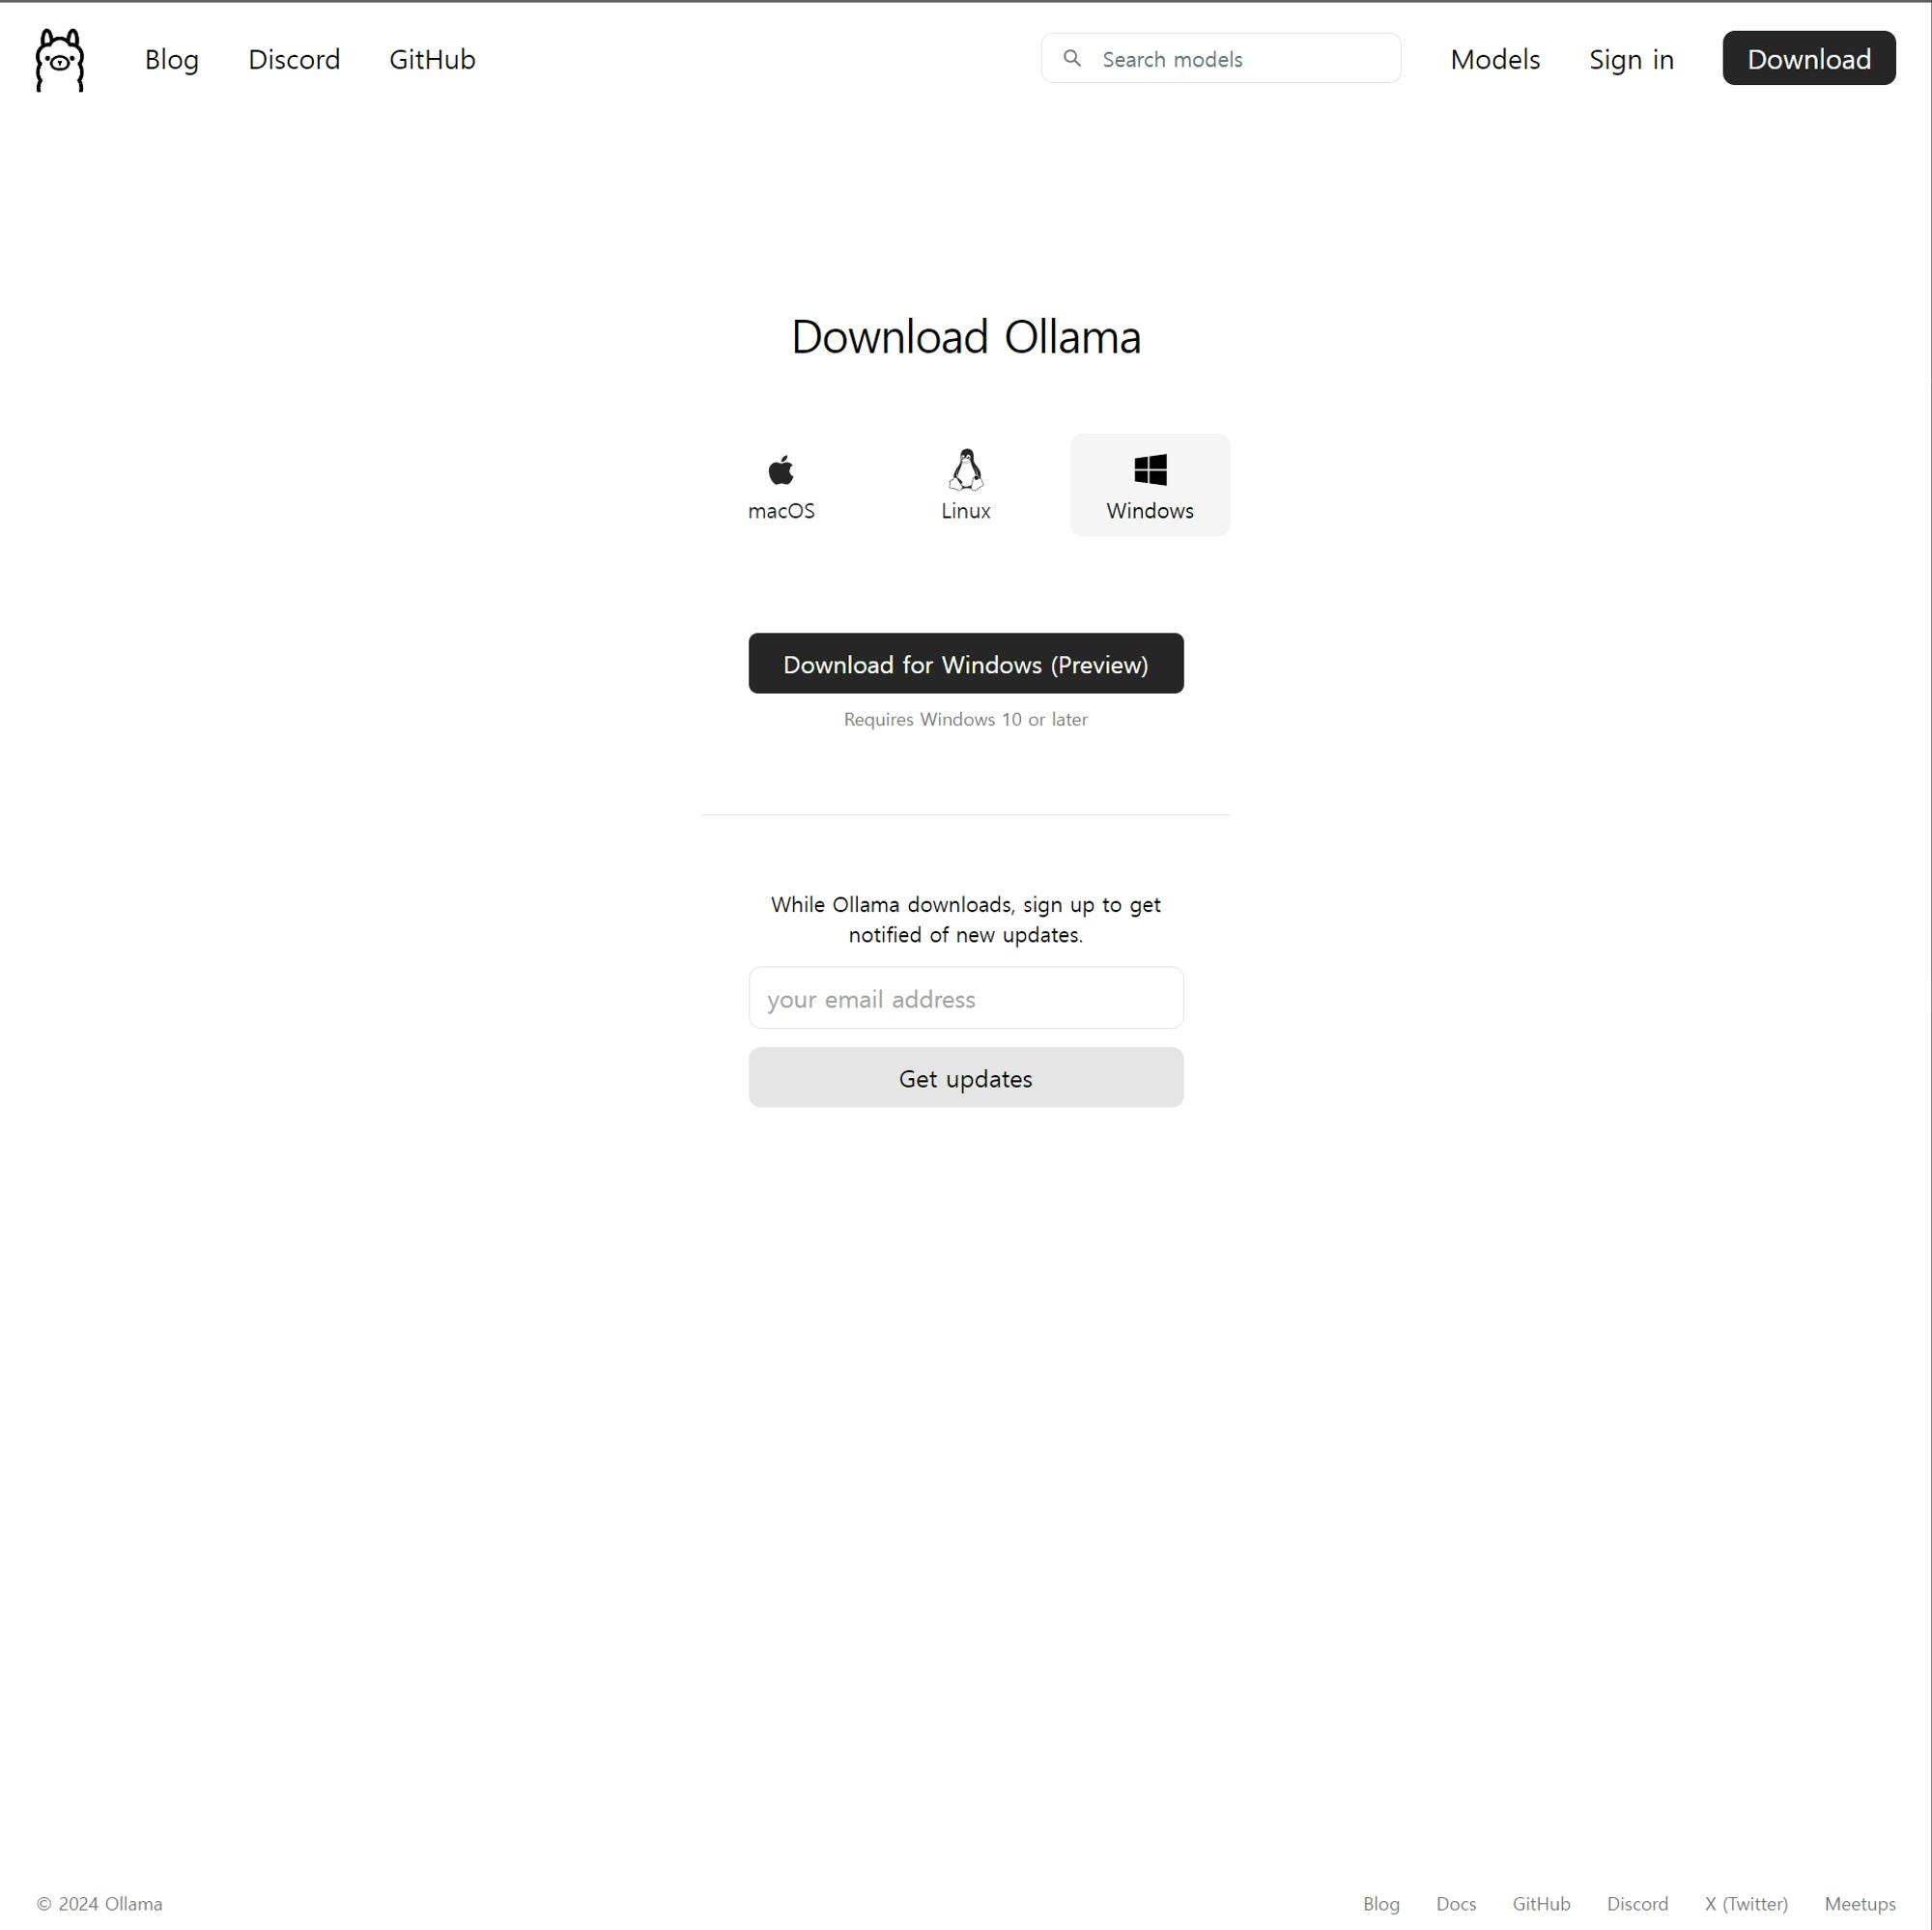
1. 올라마 접속
2. 올라마 설치
Download 누릅니다.
각 OS에 맞는 설치합니다
설치가 잘 됐는지 확인하는 방법!
-> 파워쉘에서 ollama를 쳐봅니다.
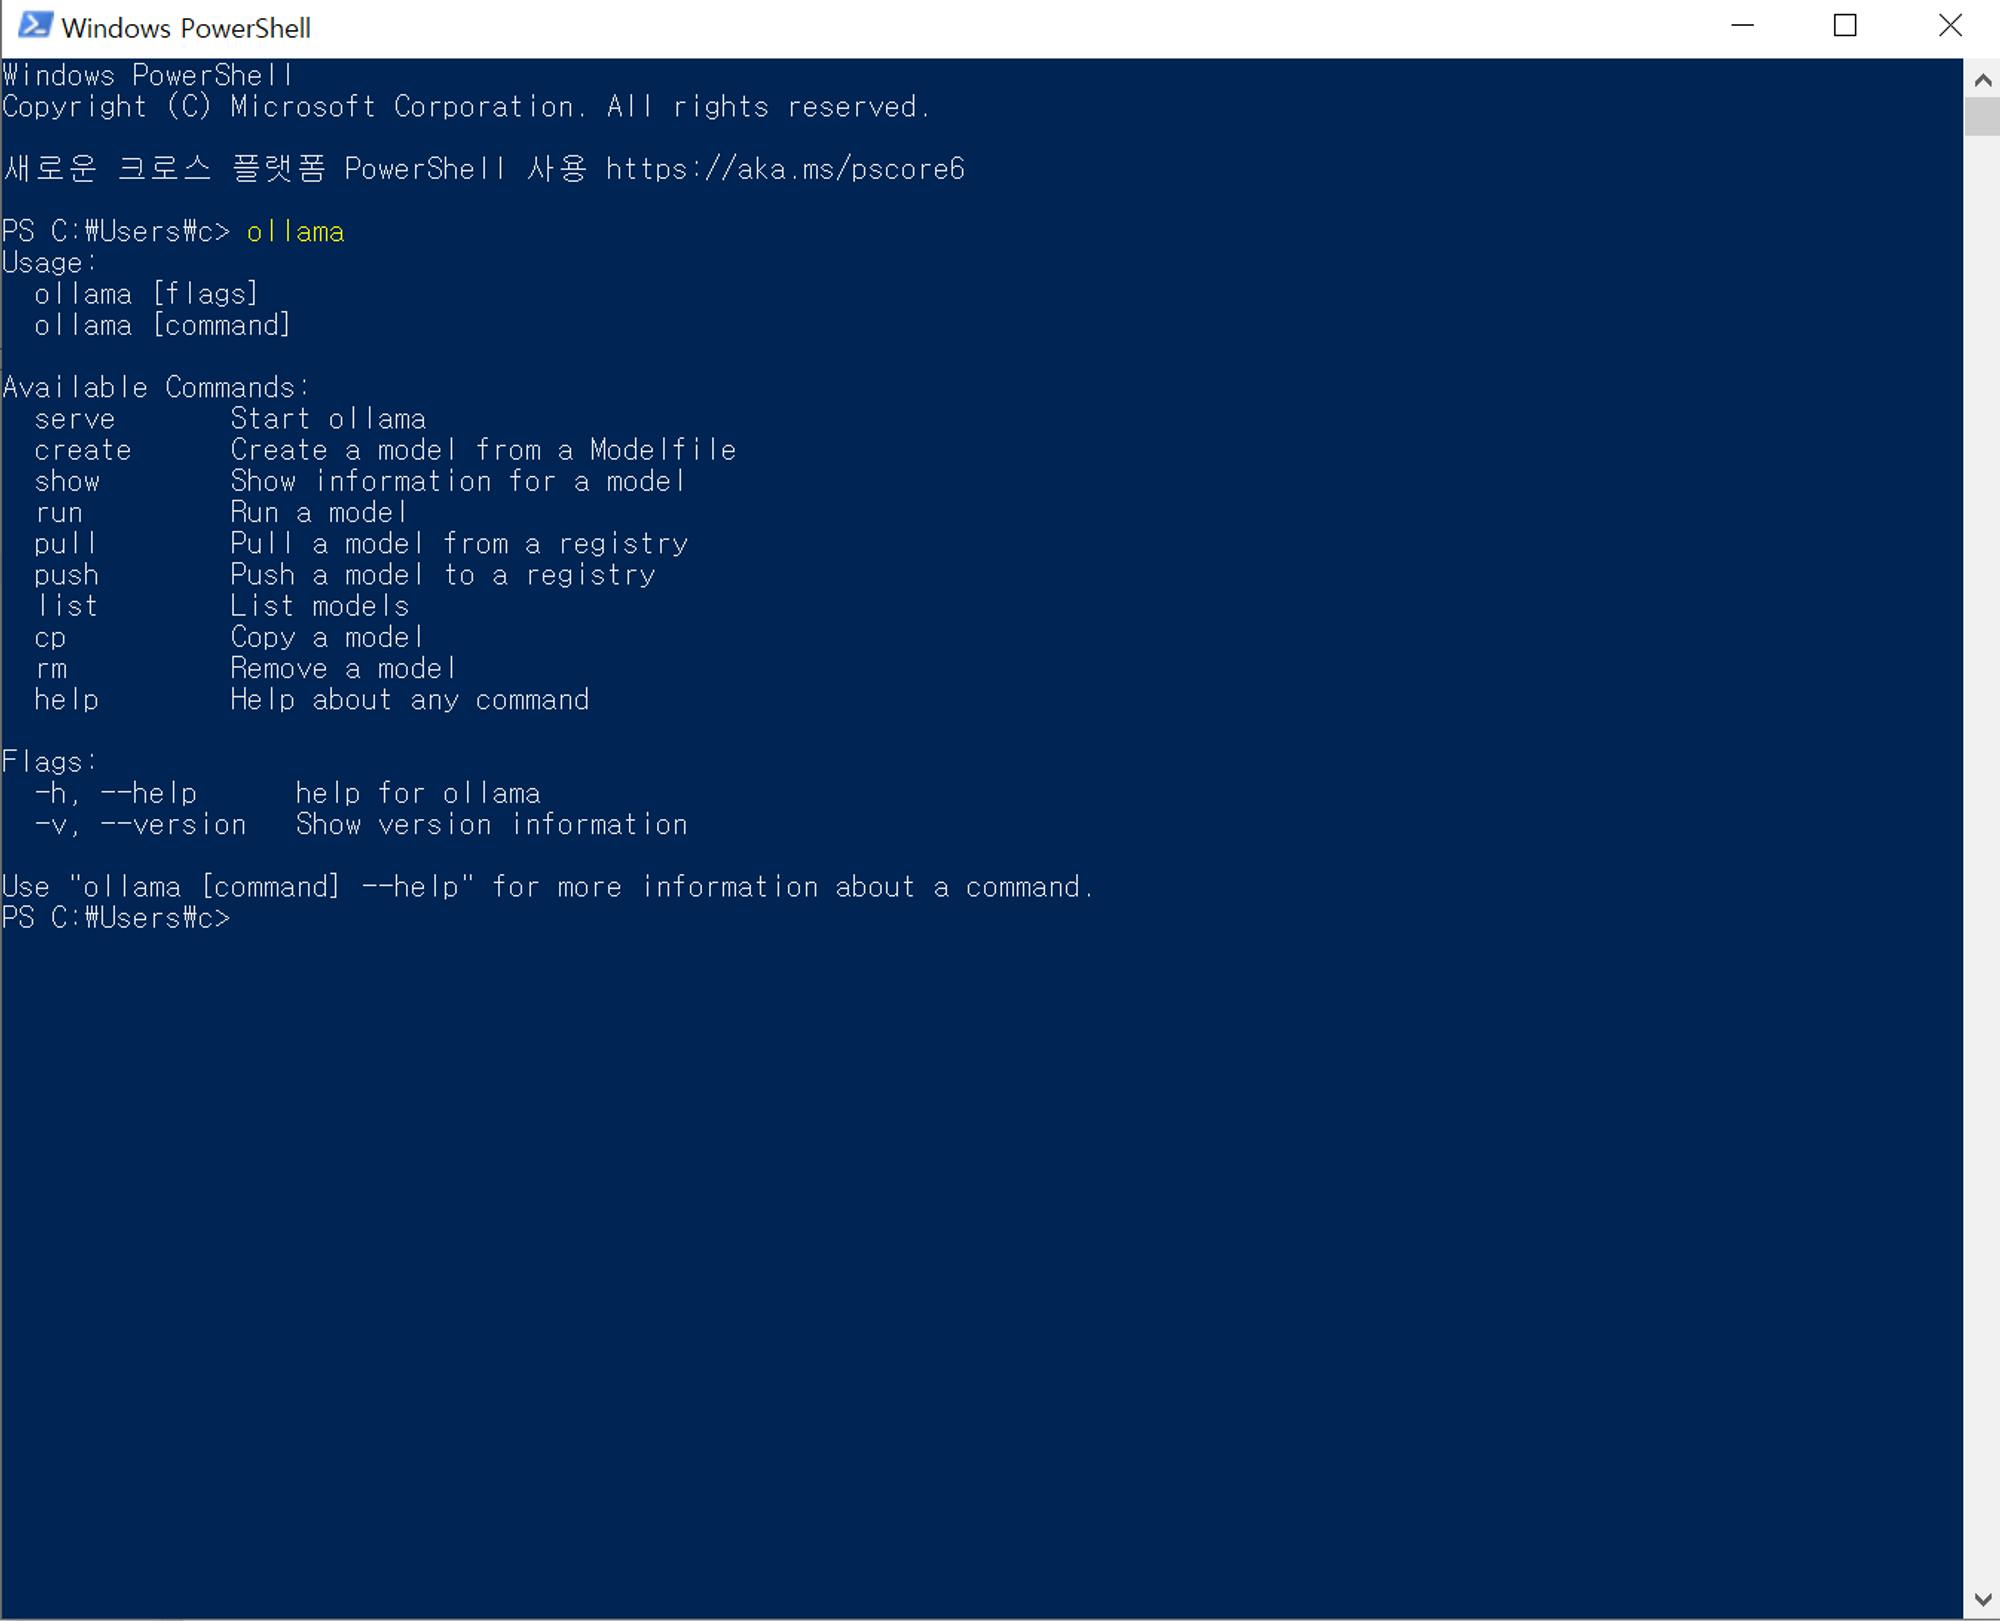
-> 다음과 같이 나오면 설치 성공입니다.
우리가 먼저 사용할 모델 : llama2 보다 성능이 높은 gemma2b 입니다.
4.파워쉘에서 다음과 같이 작성합니다
ollama run gemma:2b-instruct
주의!! git bash에서 ollama 작동 안함 (버그인듯)
잘 돌아가는지 확인하기
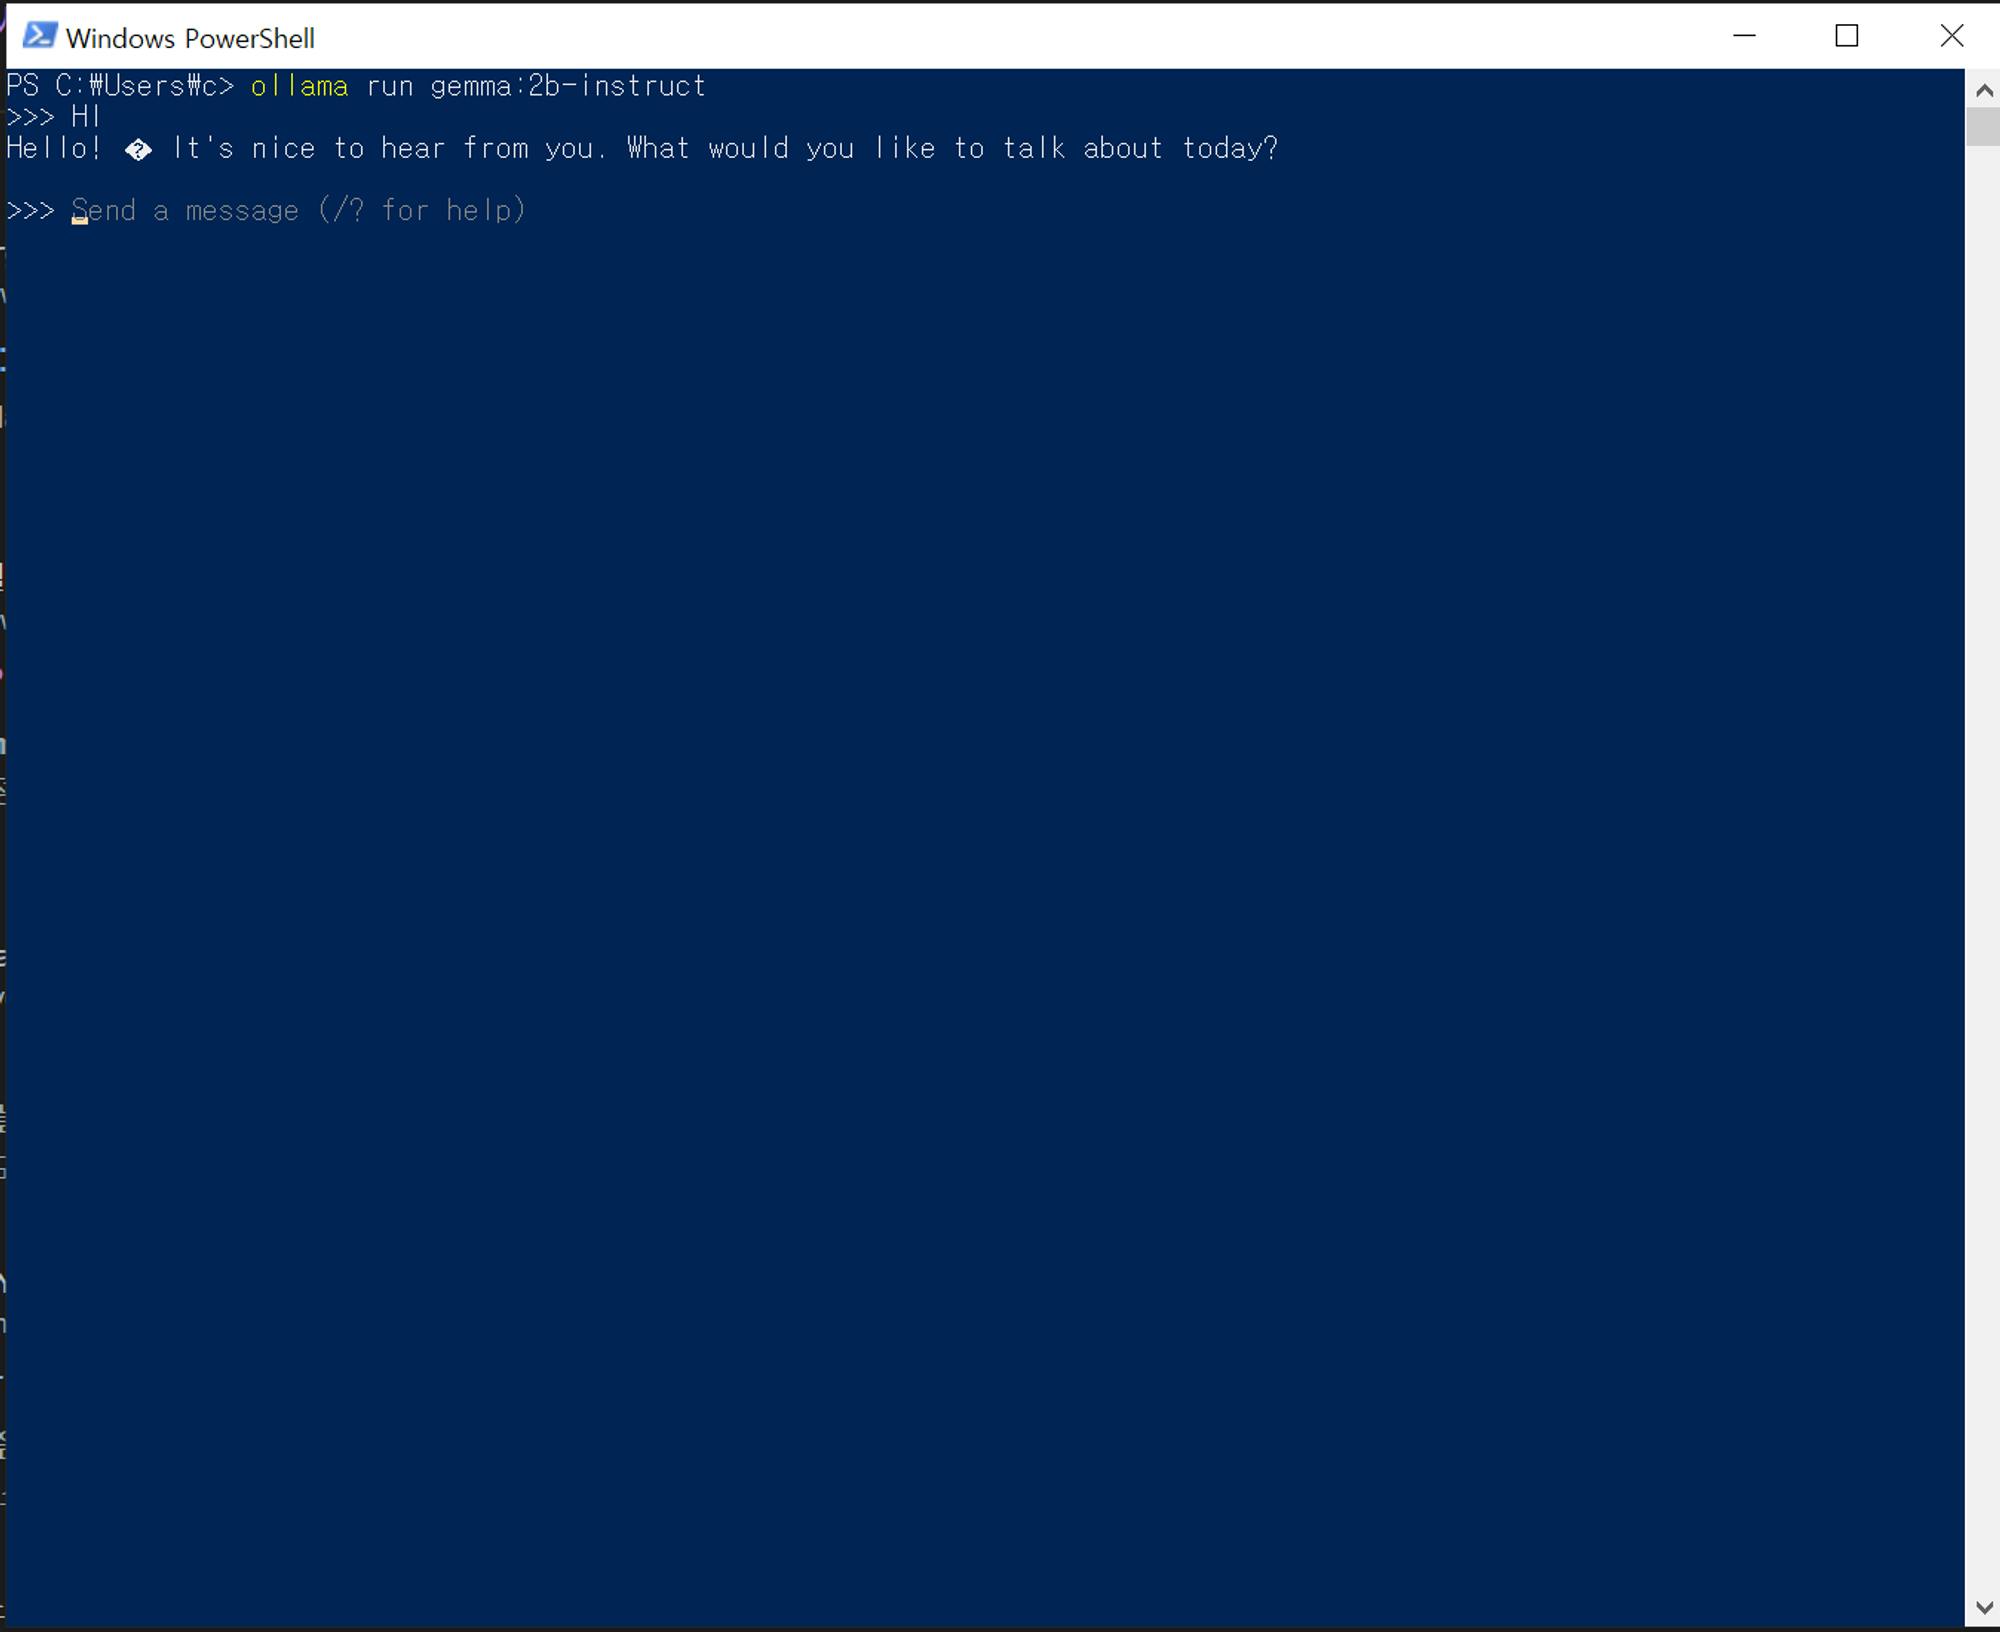
-> 만약 gemma 모델을 다시 돌려보고 싶다
명령어
ollama run gemma2b-instruct 를
파워쉘에서 작성하면 다시 gemma와 얘기를 나눌 수 있습니다.
/bye를 치면 나갈 수 있습니다.
이제 프로젝트 폴더를 만듭니다. (폴더명 상관 X)
main.py에 다음과 같이 작성 합니다.
-> 코드를 올리기가 어려워 제 githuib링크를 드립니다.
github링크
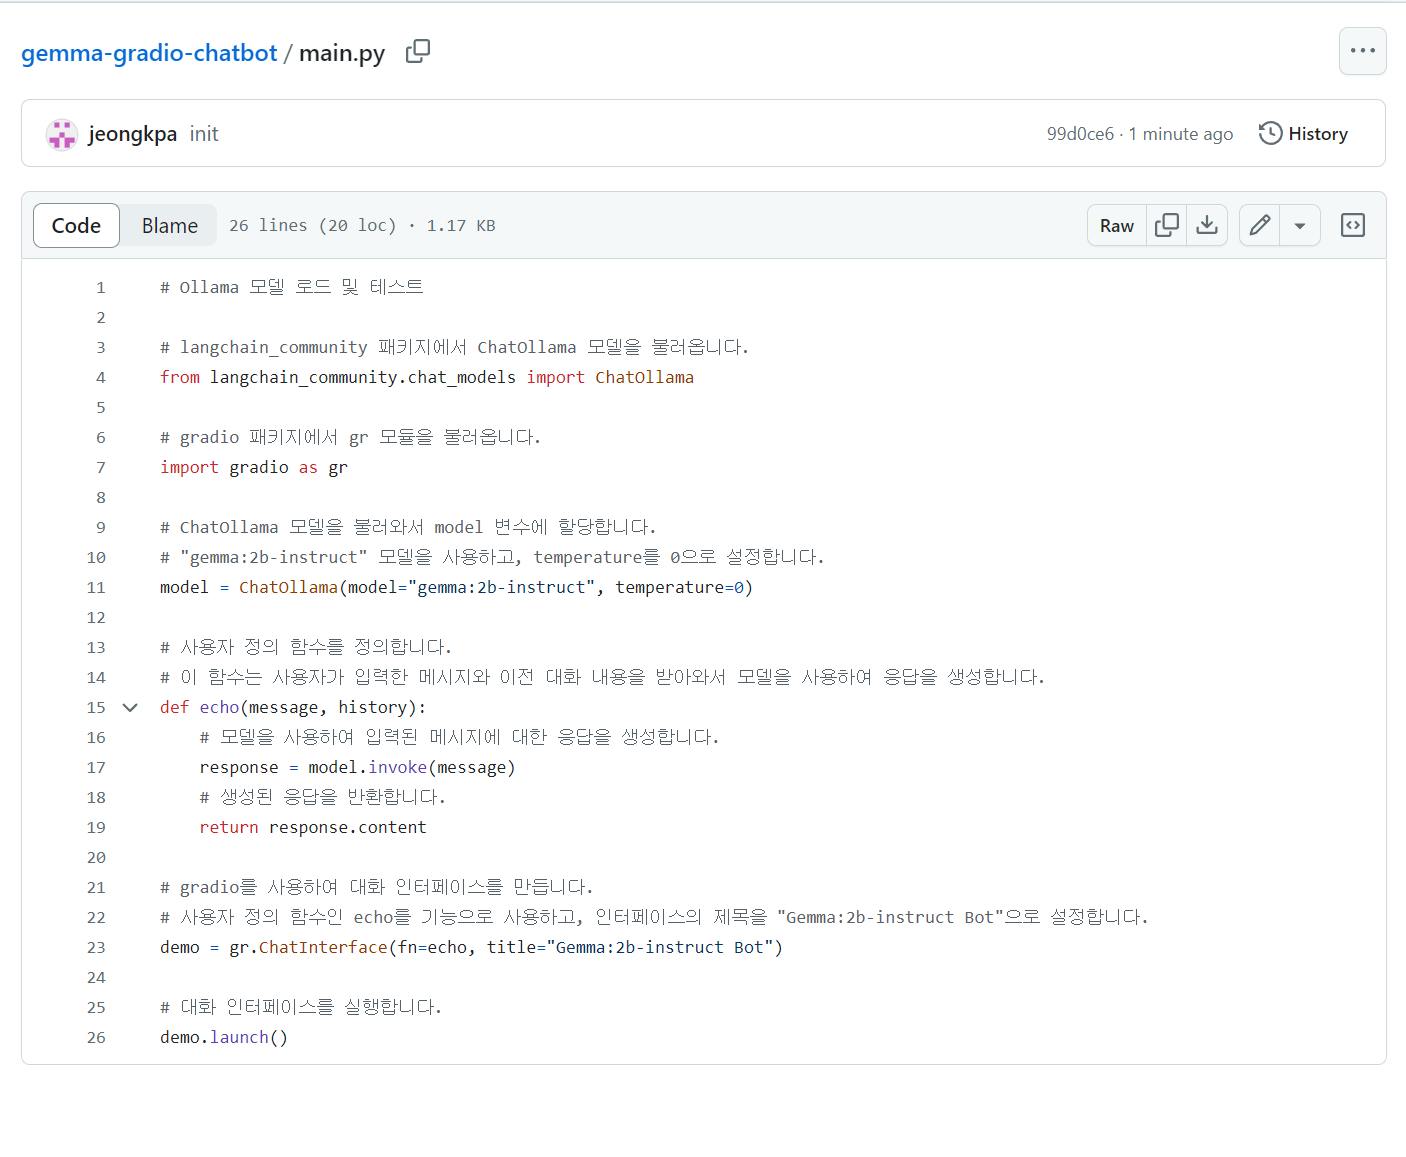
이 코드를 넣습니다. 그리고 필요한 패키지를 설치합니다.
pip install langchain gradio
그리고 python main.py로 실행합니다.
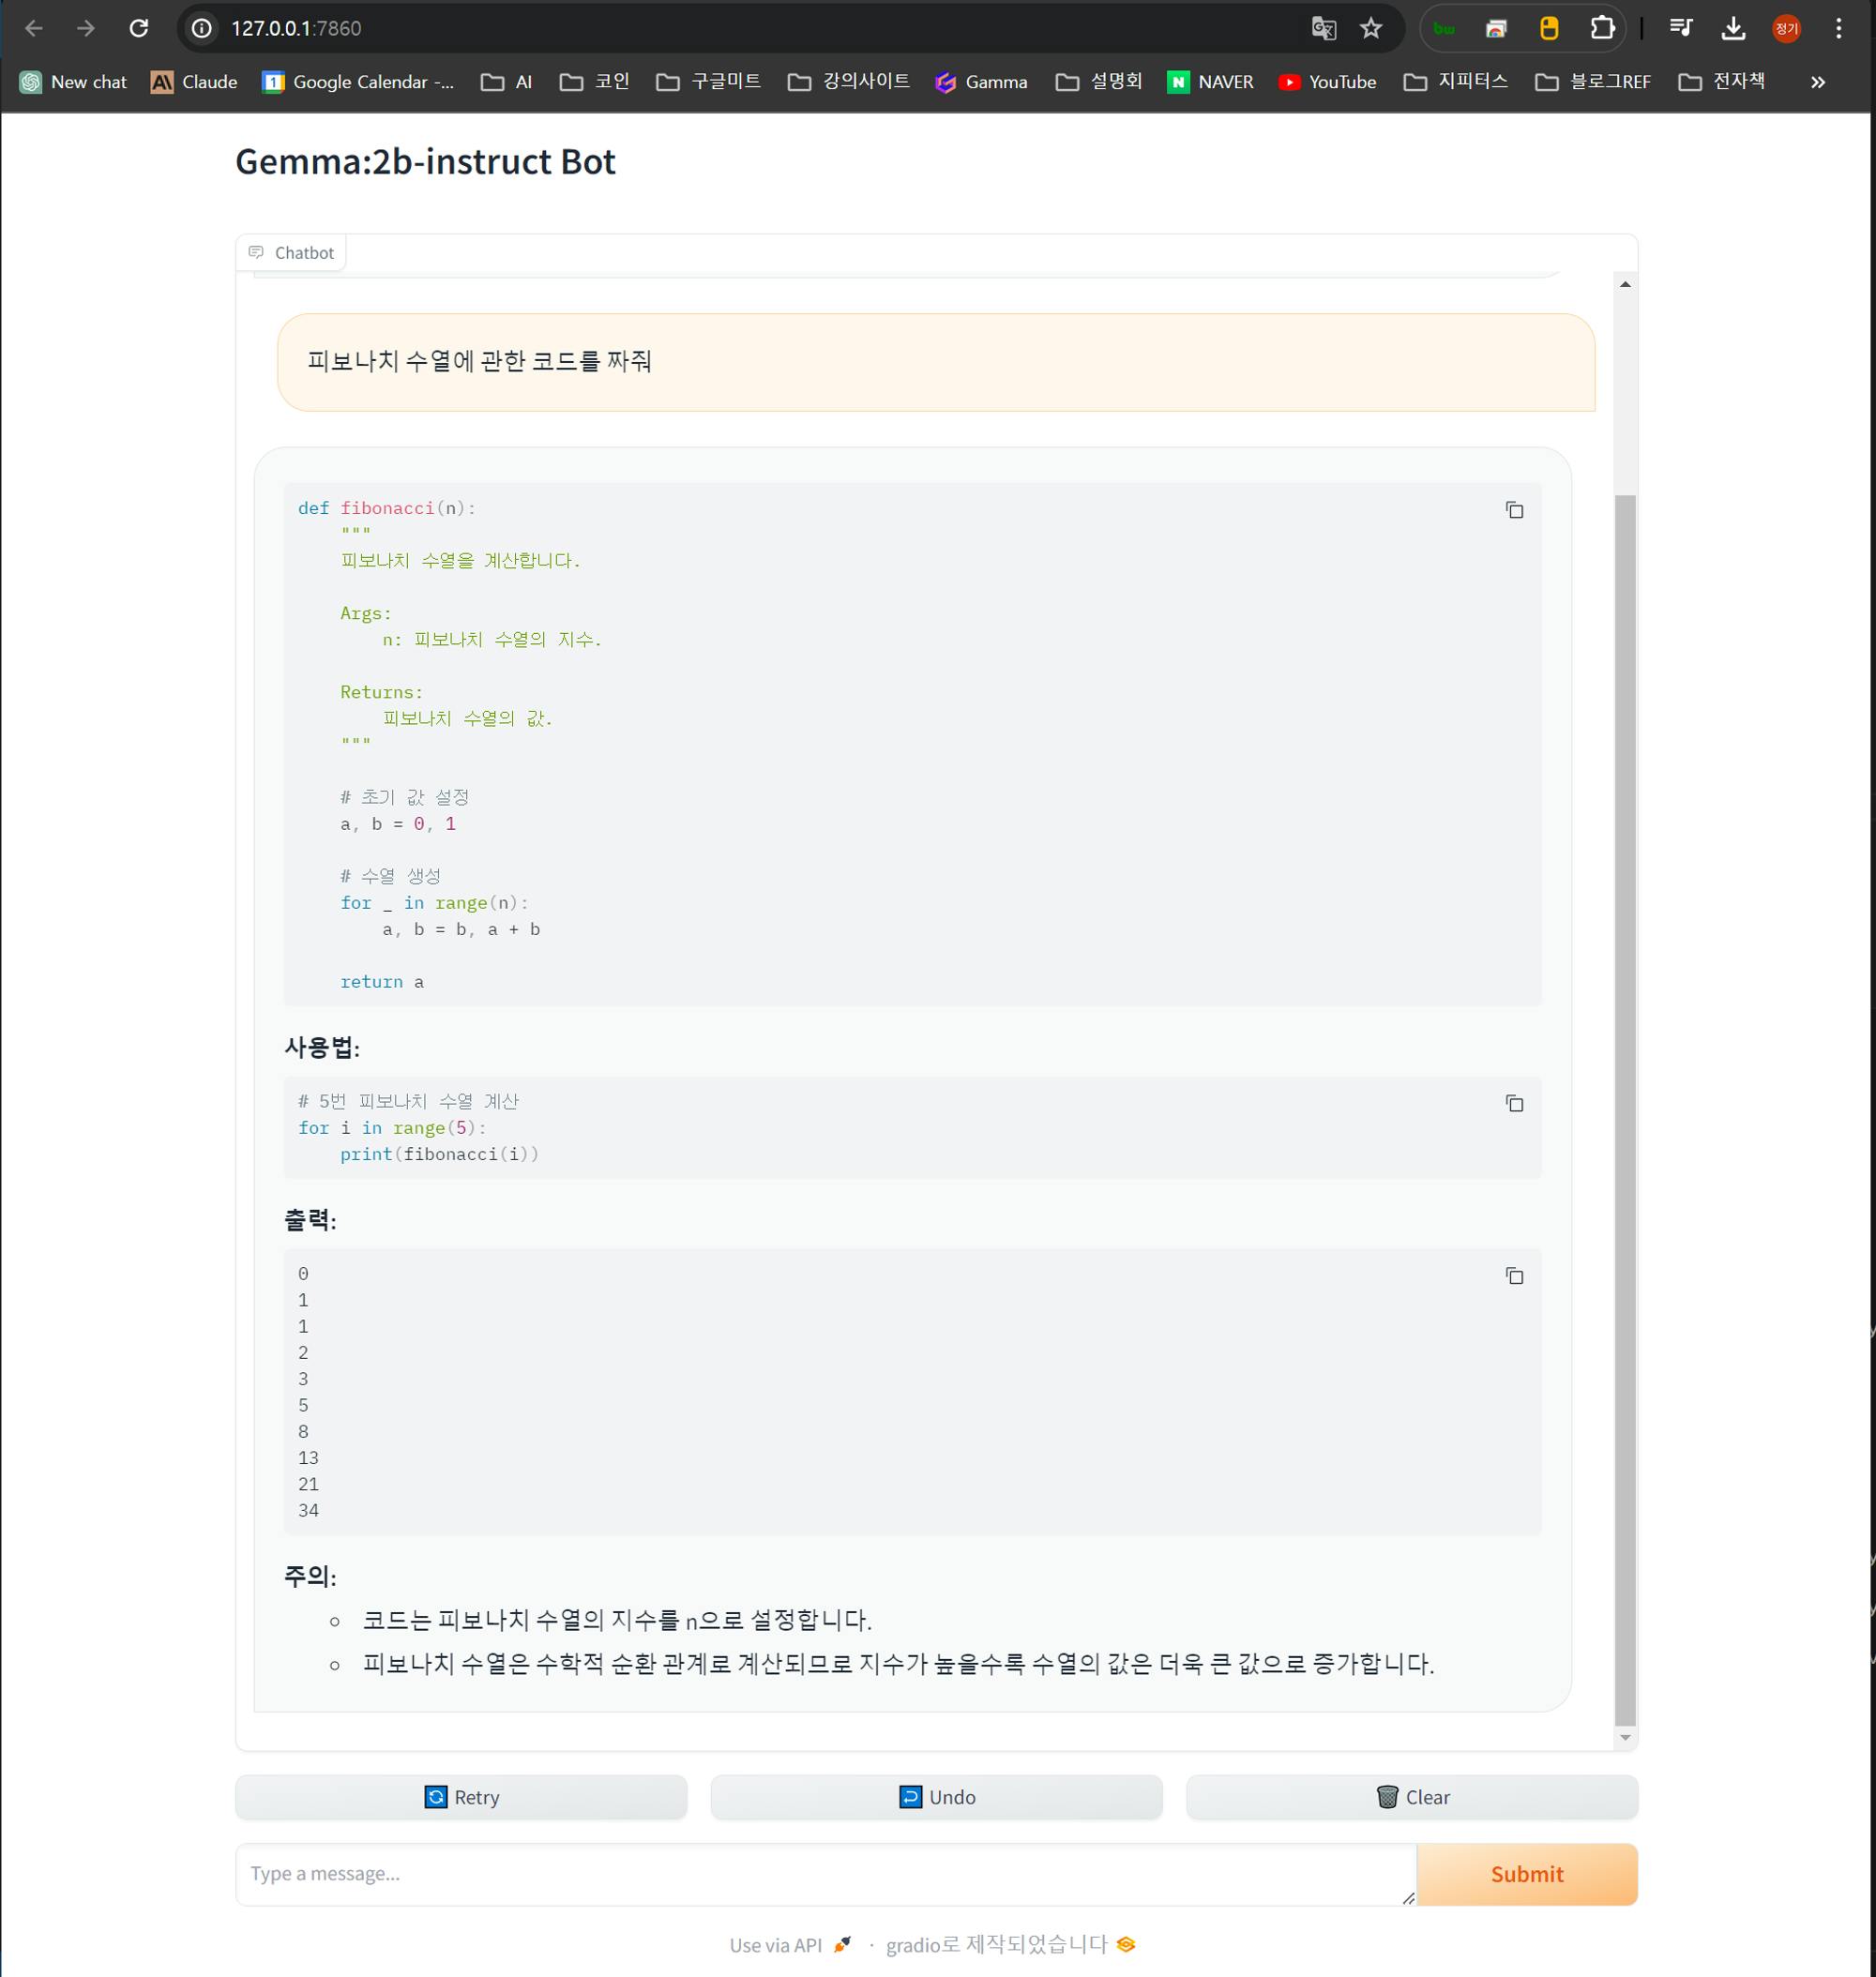
다음과 같이 뜨면 성공입니다!
PS C:\Users\c\gemma-gradio-chatbot> python .\main.py Running on local URL: http://127.0.0.1:7860 To create a public link, set share=True in launch().
-> 이렇게 뜬다면
http://127.0.0.1:7860에 접속하여 채팅을 즐겨주시면 됩니다!
요즘 핫한 LLAMA3-8b 모델로도 만들어봅니다.
https://huggingface.co/QuantFactory/Meta-Llama-3-8B-Instruct-GGUF/tree/main
이 사이트에 접속합니다.
Meta-Llama-3-8B-Instruct.Q8_0.gguf
이 모델을 다운로드 받습니다.
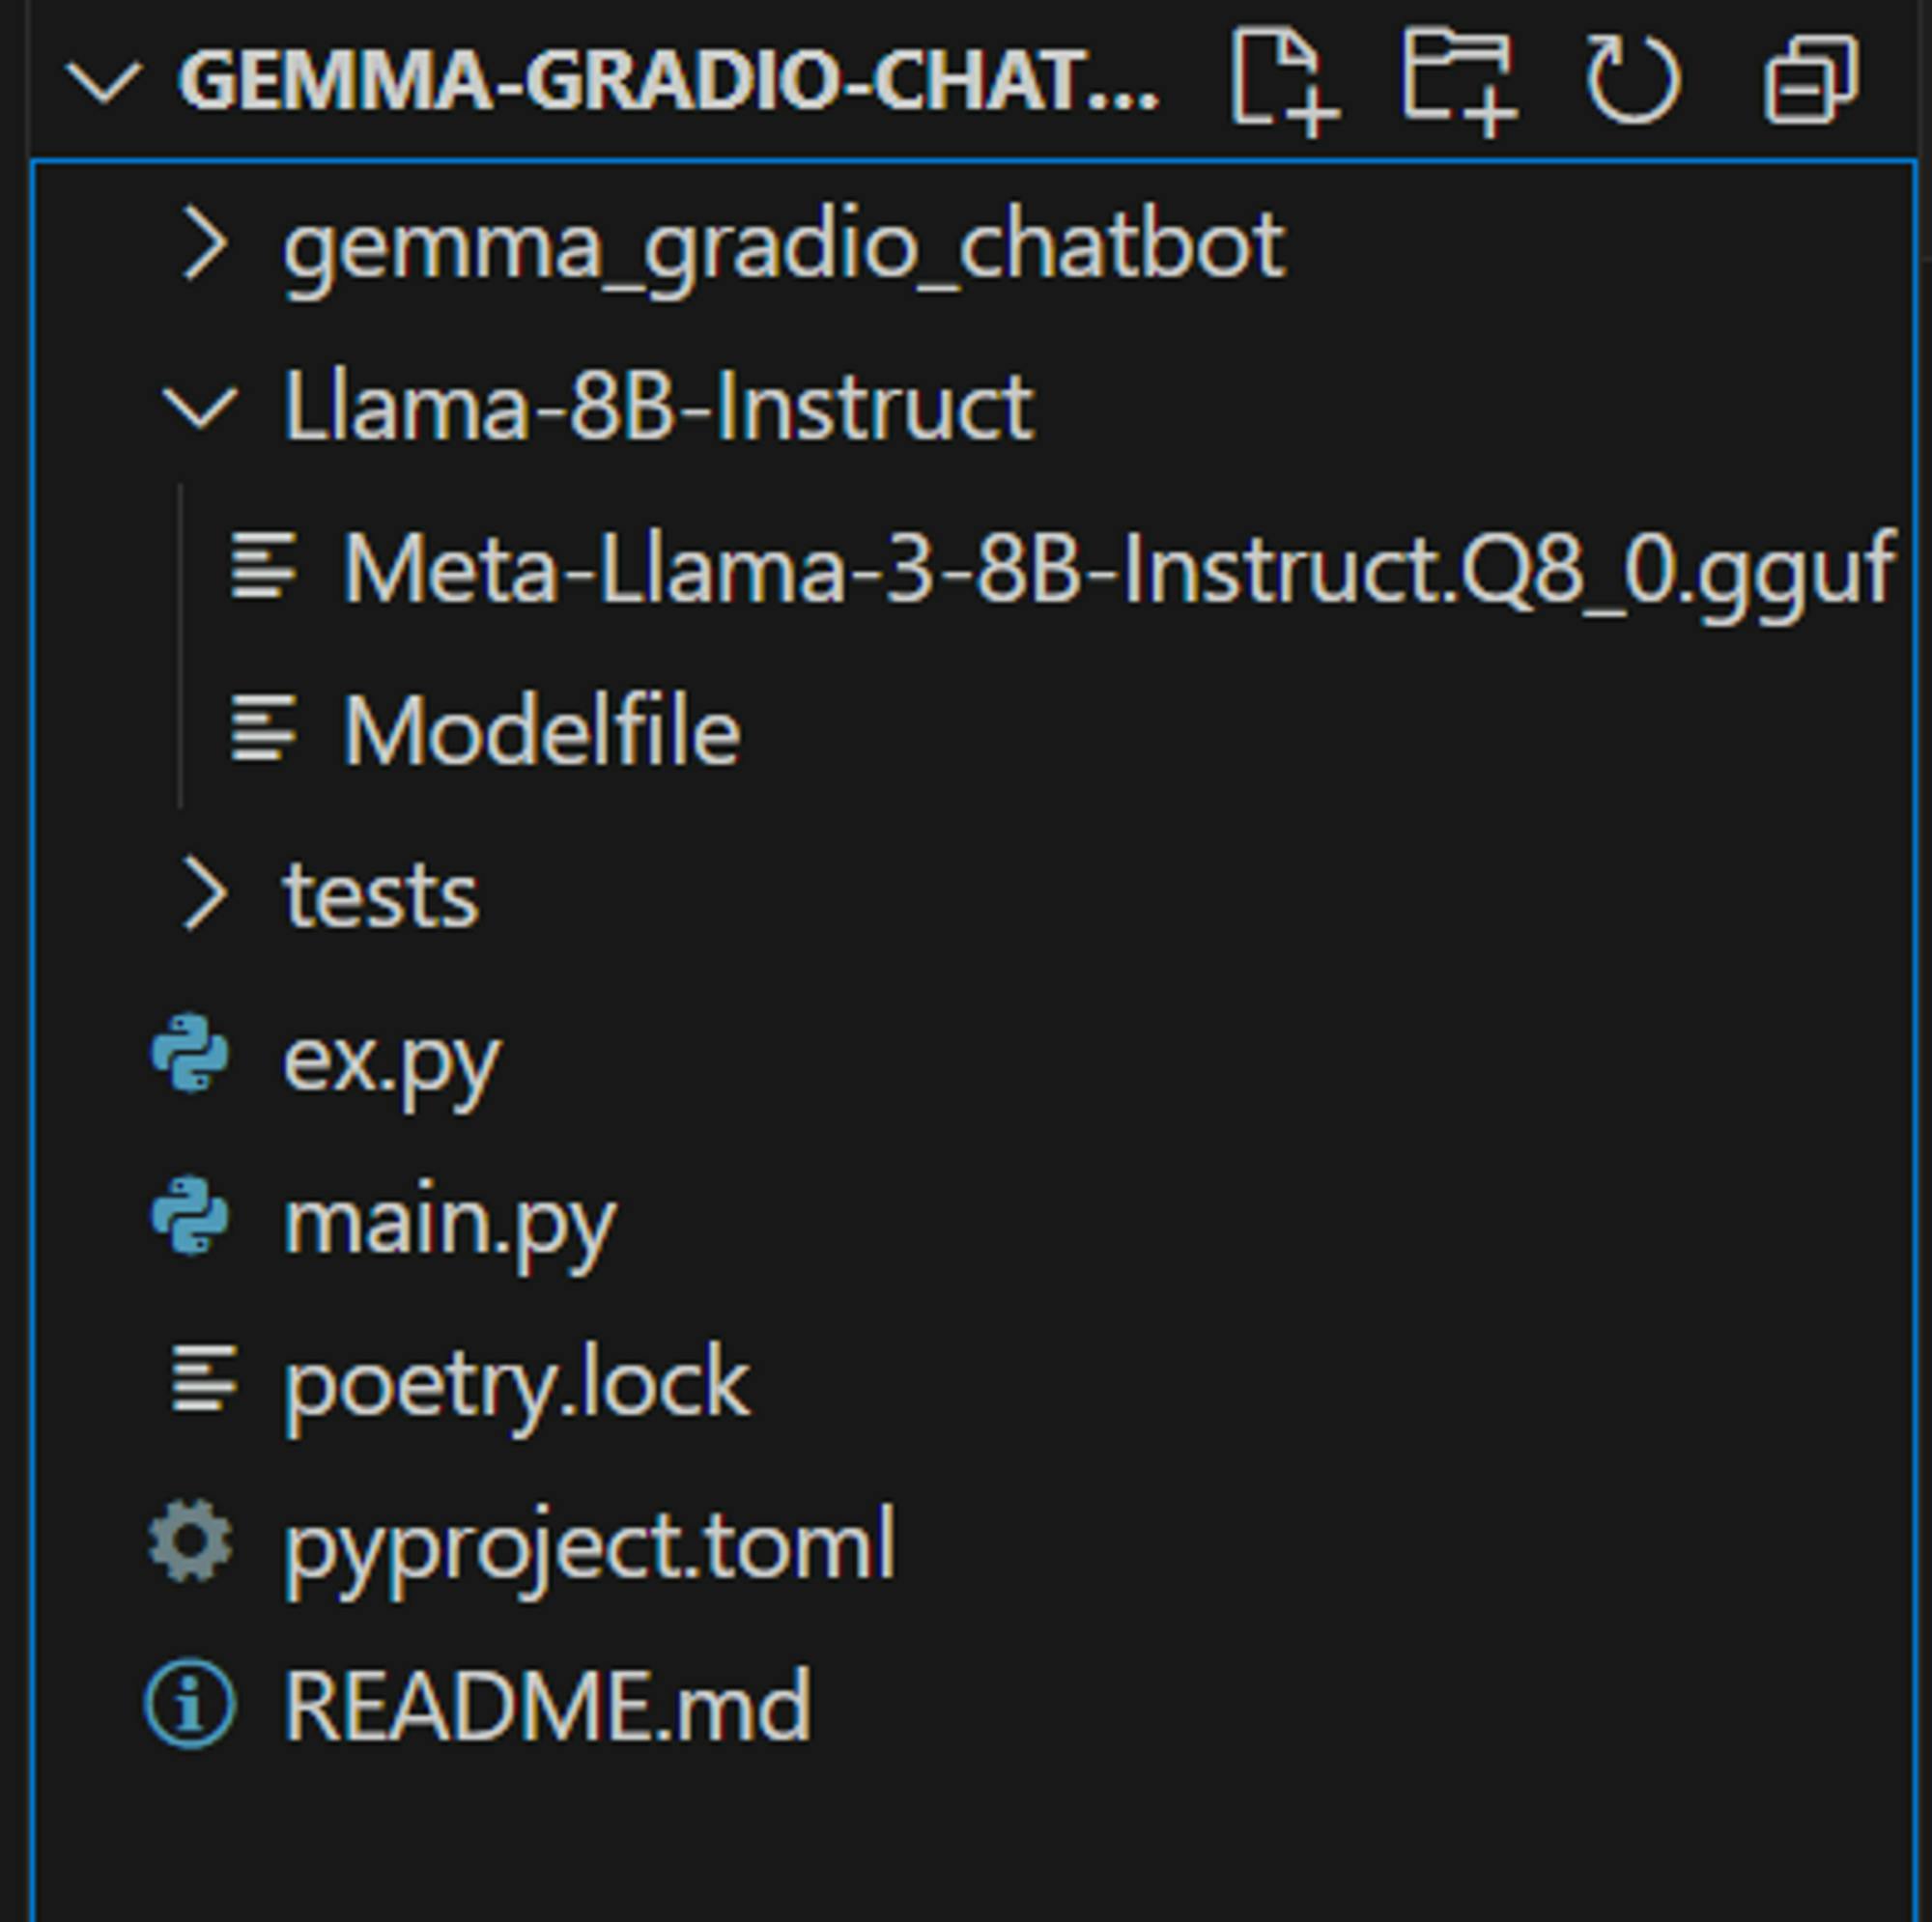
프로젝트 폴더에 Llama-8B-Instruct 폴더를 만들고
여기에 모델 다운로드 받습니다.
Modelfile도 만듭니다.
Modelfile은 다음을 복사해서 붙여넣습니다.
이번에도 github 링크를 드립니다.
https://github.com/jeongkpa/gemma-gradio-chatbot/blob/main/Llama-8B-Instruct/Modelfile
파일 구조는 다음과 같습니다.
그 다음 터미널에 다음과 같이 작성하여 ollama에 llama3 모델을 등록 시킵니다.
cd Llama-8B-Instruct
ollama create llama3-instruct-8b -f Modelfile
모델을 올라마에 올리면
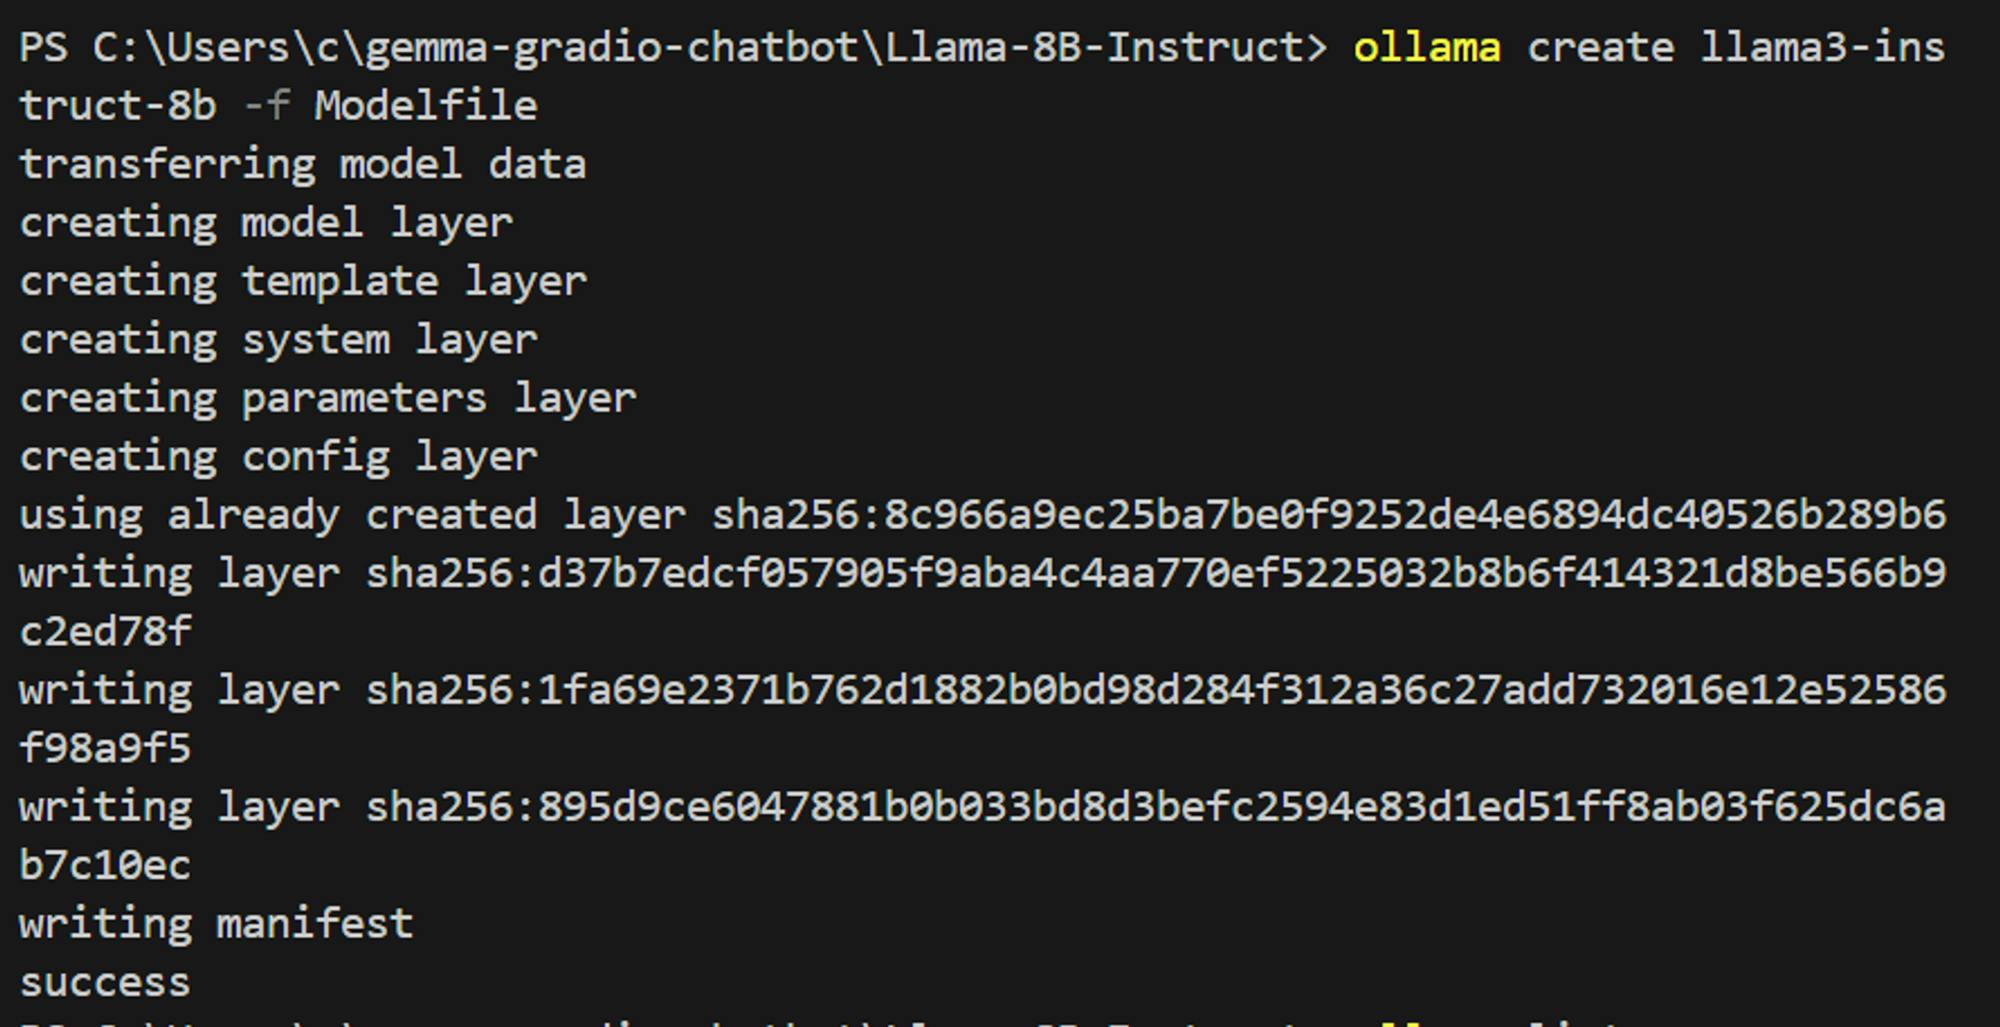
다음과 같이 성공하면 대화를 해볼 수 있습니다.
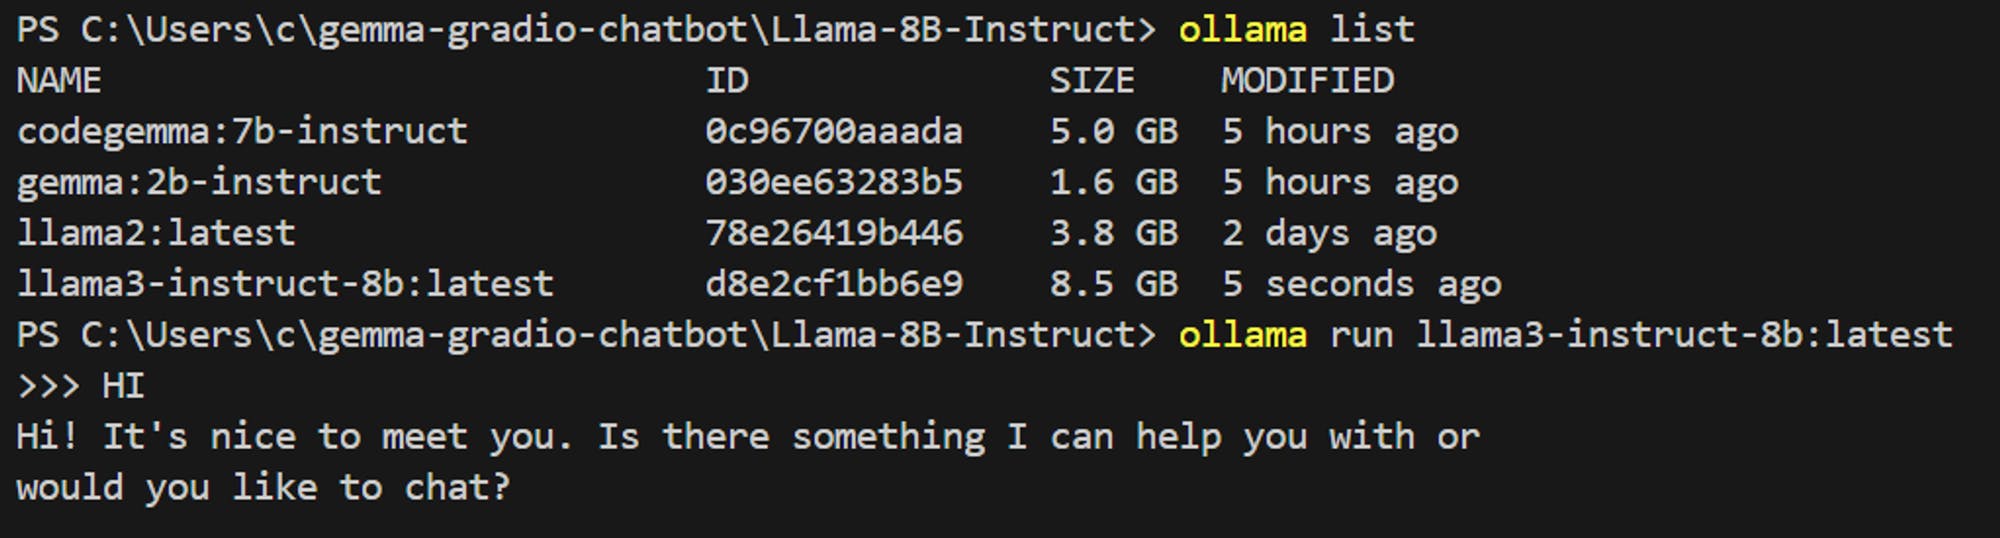
이제 아까 만들었던 main.py에서 모델 부분만 수정해봅니다.
model = ChatOllama(model="llama3-instruct-8b:latest", temperature=0)
demo = gr.ChatInterface(fn=echo, title="llama3-instruct-8b:latest")
2줄만 수정해 주시면 됩니다.
이렇게 하면 나만의 SLLM 라마3 챗봇 완성입니다!
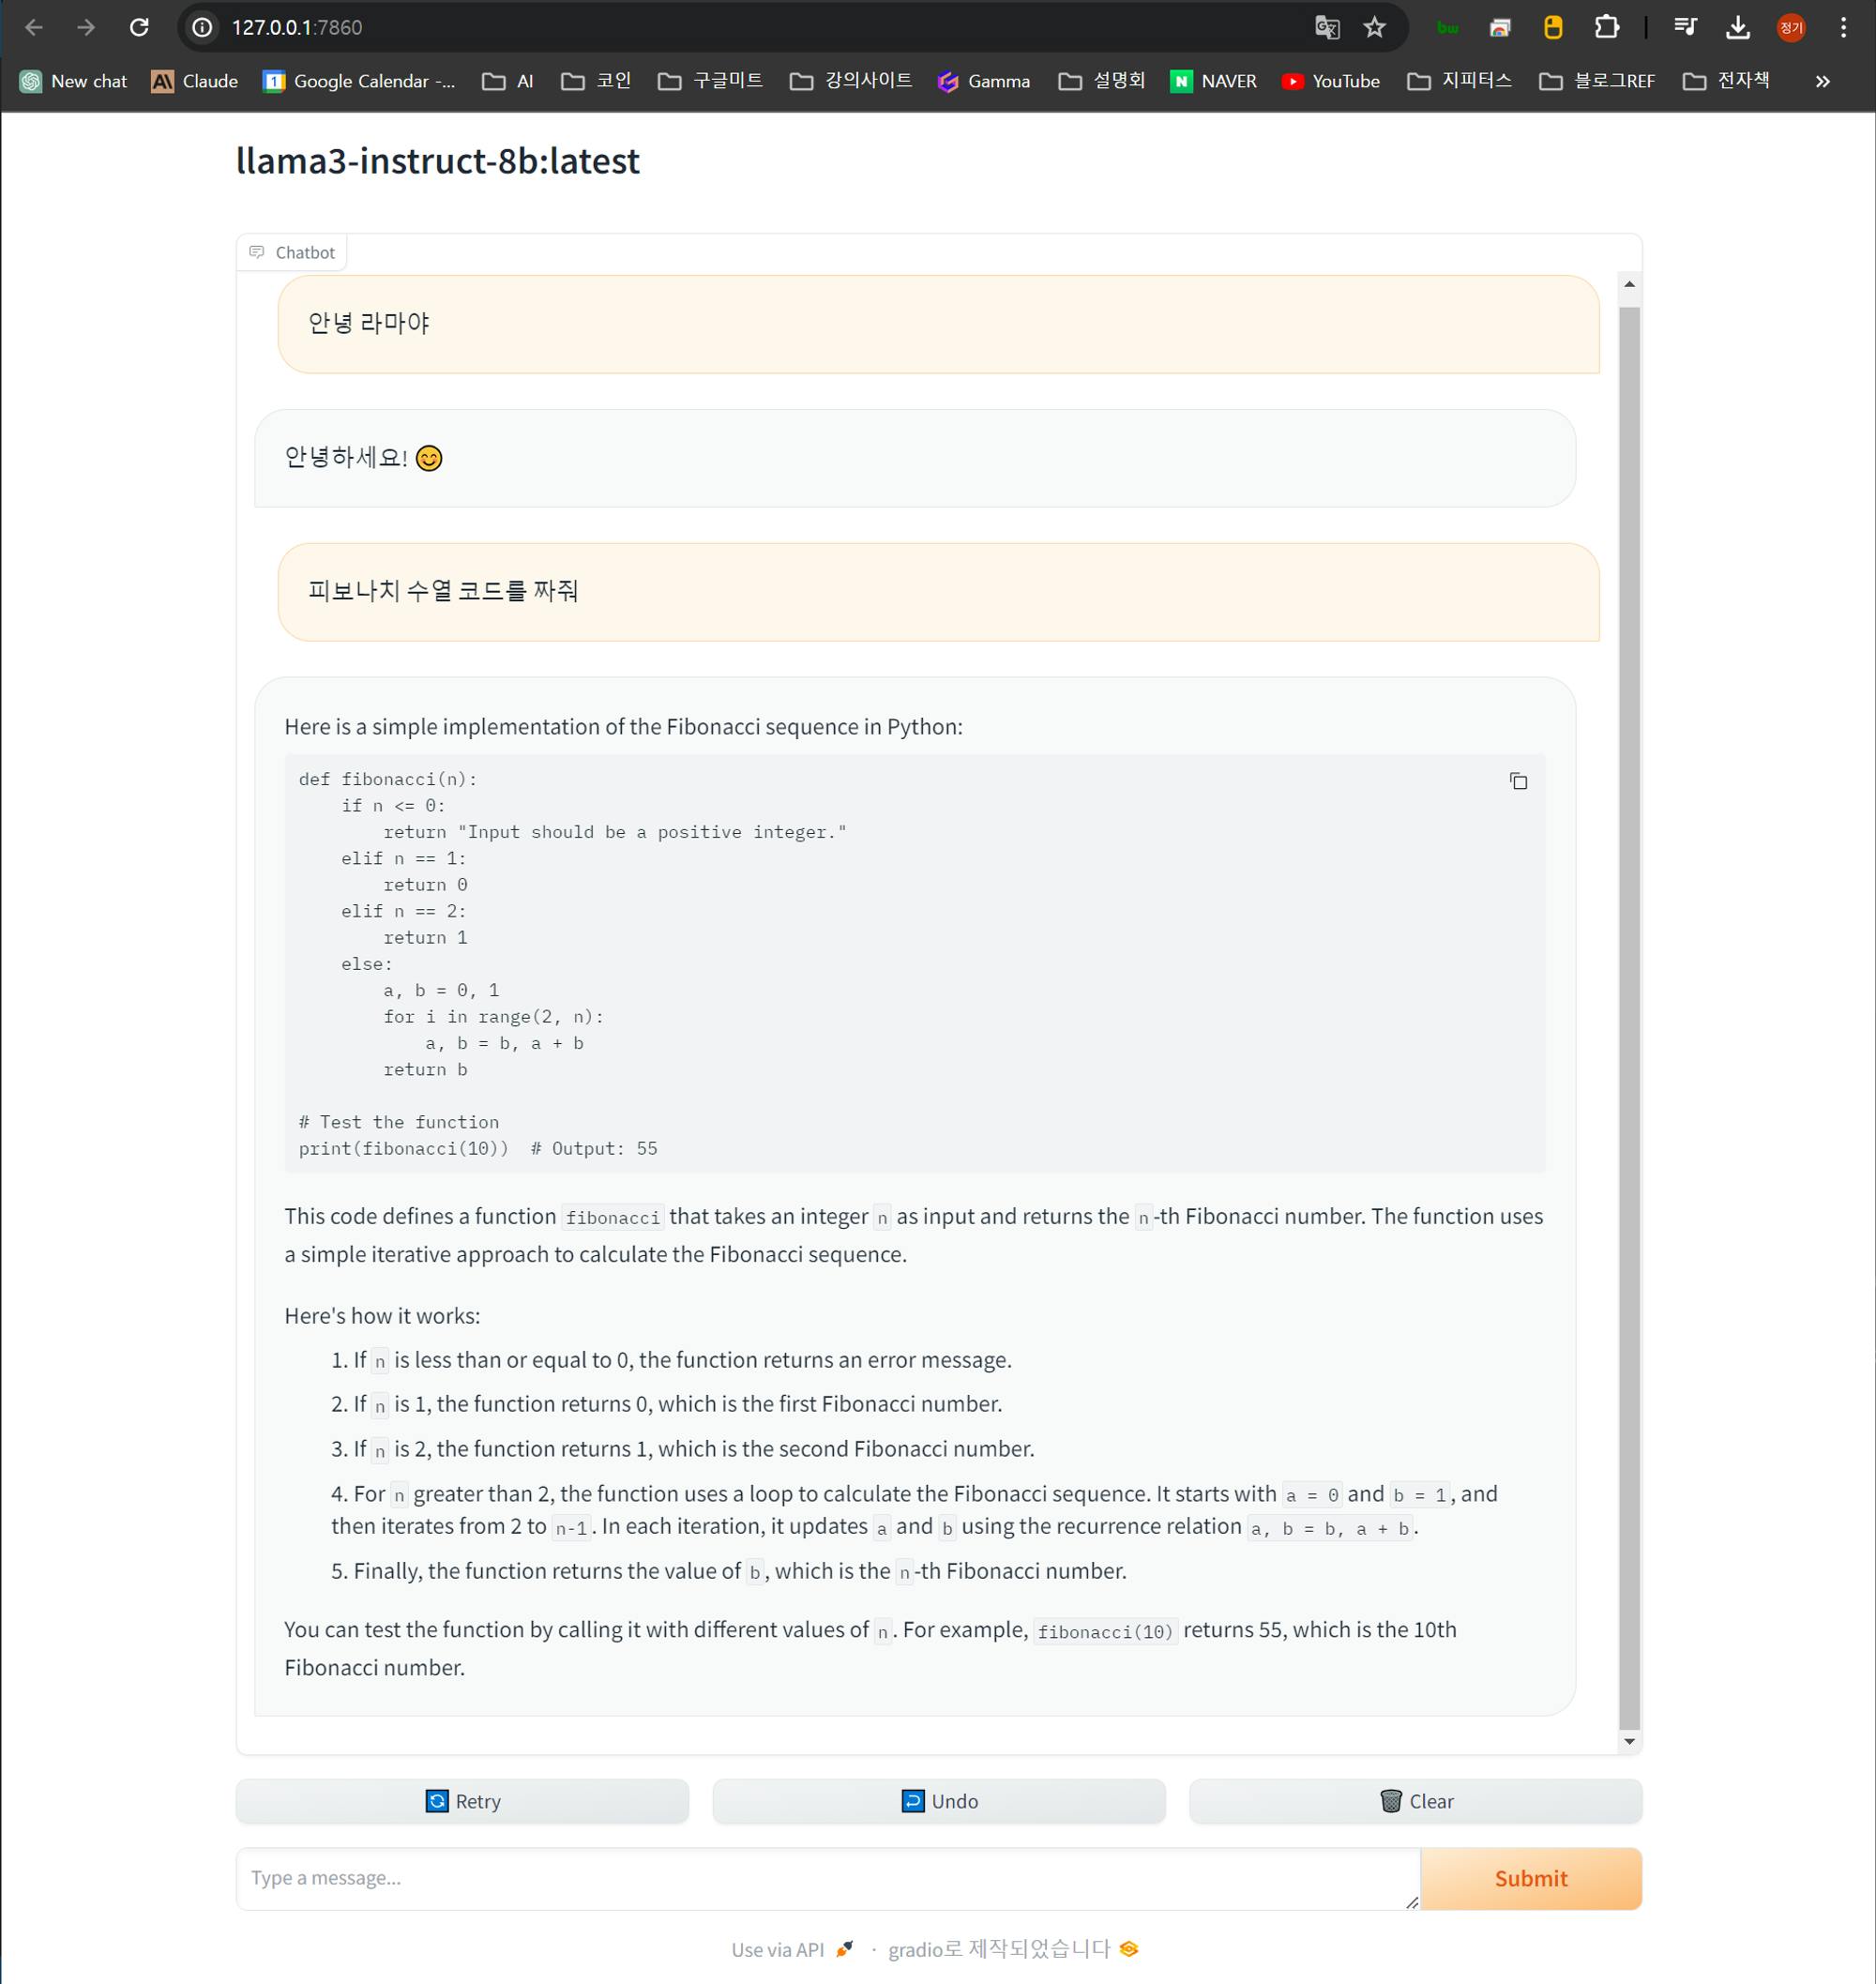
이제 데이터 반출에 구애 받지 않는 나만의 개인 SLLM 챗봇 구현을 성공했습니다.
더 좋은 PC, GPU와 RAM이 구성된 것이 있다면, 70b 모델로 구현하시면 GPT4보다 성능이 좋은 LLM을 써보실 수 있습니다!
(🚧 본 글은 2024.05.06에 작성됐던 글입니다)
로그인하고 댓글을 남겨 주세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
채팅 웹 UI뿐 아니라 API로도 사용 가능하려나요?