HuggingFace를 이용하여 GPT2 fine tuning 해보기
2024.02.20
안녕하세요! 9기 HuggingFace 참여자 이유준입니다.
오늘은 HuggingFace와 PyTorch를 이용해서 fine tuning을 진행해 보았습니다!
목차
AIHub에서 자료 찾기
HuggingFace의 모델을 찾은 자료로 fine tuning 하기
GPT2 기본 모델에 프롬프트 엔지니어링을 적용하기
[AIHub에서 자료 찾기]
fine tuning을 하기 위한 데이터를 찾기 위해서, AIHub를 접속해보았습니다!
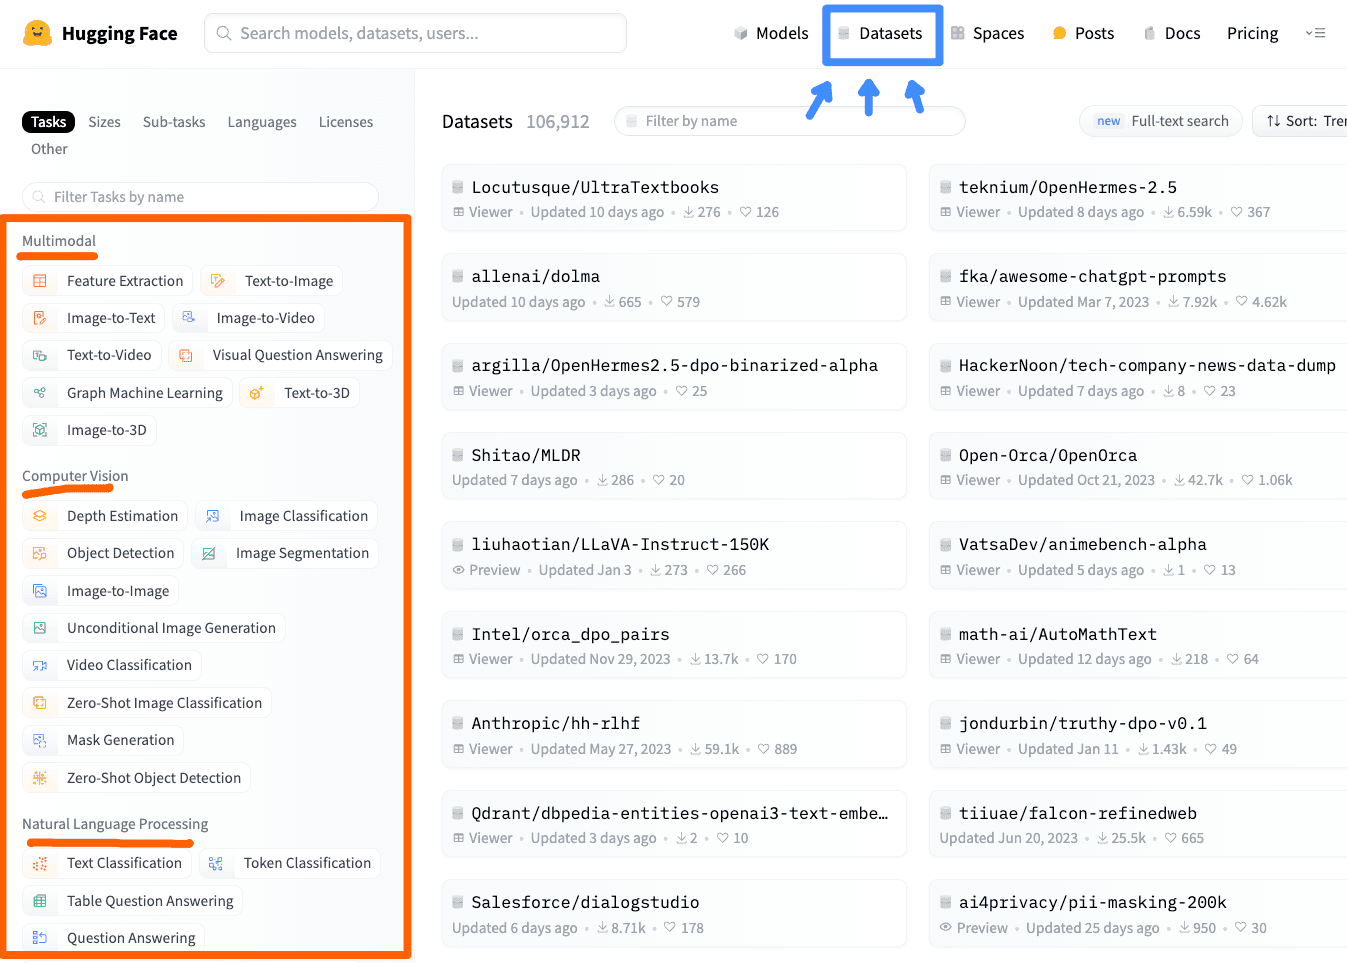
사실.. HuggingFace의 Datasets를 찾아보았지만.. 한국어 대화 데이터셋이 없어서.. AIHub에서 찾아보았습니다.
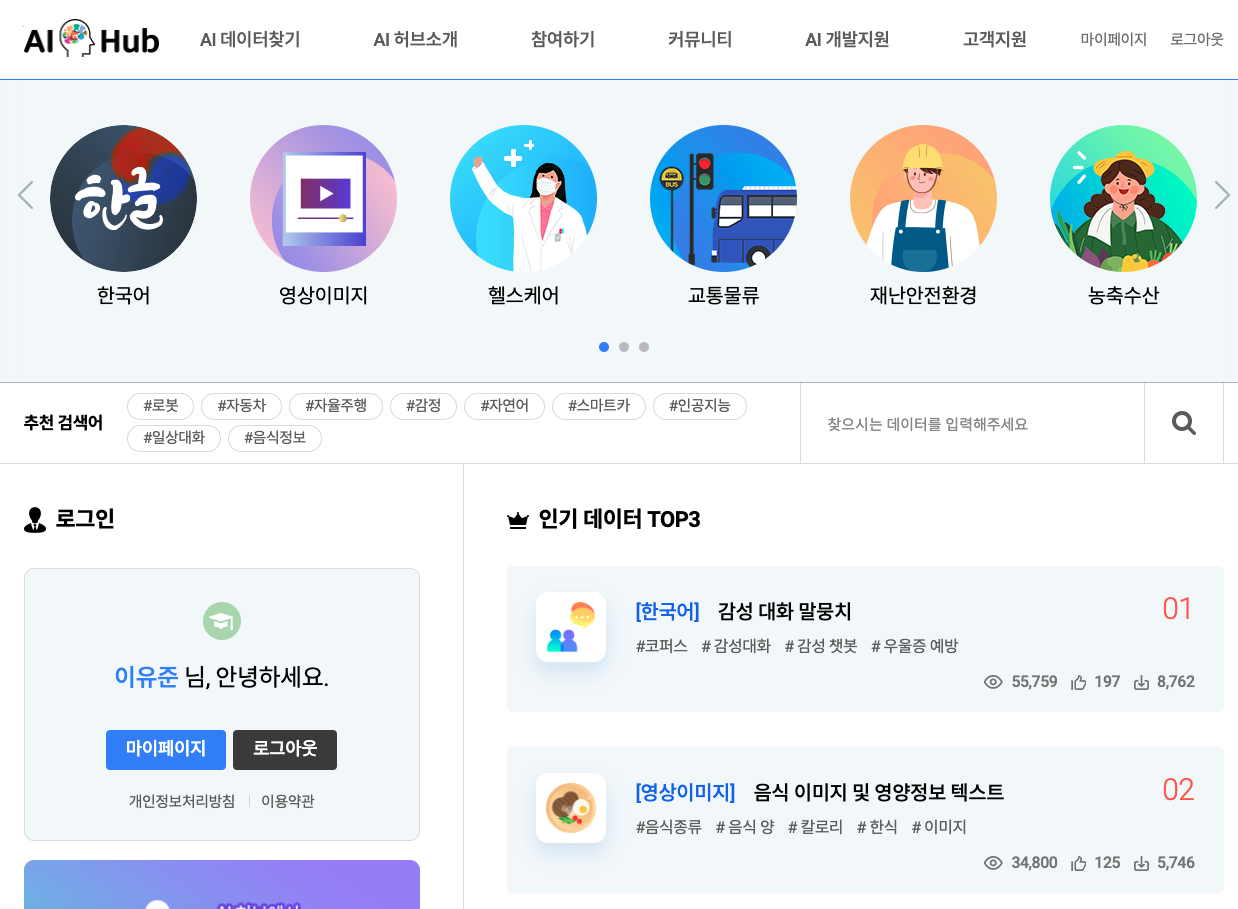
상단의 AI 데이터찾기에서 데이터를 찾아보실 수 있습니다.
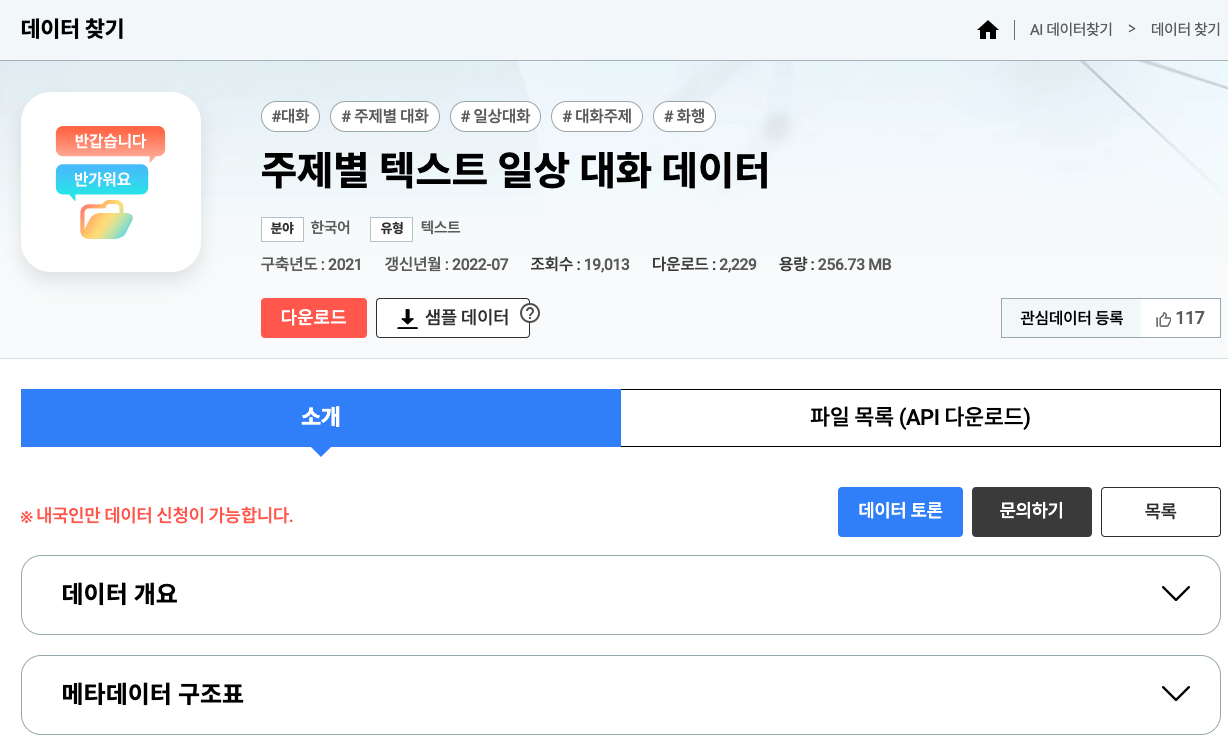
제가 사용한 데이터셋은 ‘주제별 텍스트 일상 대화 데이터'입니다!
[HuggingFace의 모델을 찾은 자료로 fine tuning 하기]
제가 사용한 모델은 HuggingFace에서 SKT가 올린 KoGPT2입니다!
import numpy as np
import pandas as pd
import torch
from pytorch_lightning import Trainer
from pytorch_lightning.callbacks import ModelCheckpoint
from torch.utils.data import DataLoader, Dataset
from transformers.optimization import AdamW, get_cosine_schedule_with_warmup
from transformers import PreTrainedTokenizerFast, GPT2LMHeadModel
import re, os
from tqdm import tqdm


Q_TKN = "<usr>"
A_TKN = "<sys>"
BOS = "</s>"
EOS = "</s>"
MASK = "<unused0>"
SENT = "<unused1>"
PAD = "<pad>"

save_dir = "saved_models"
os.makedirs(save_dir, exist_ok=True)


print("start1")


class ChatbotDataset(Dataset):
    def __init__(self, chats, max_len=40):  # 데이터셋의 전처리를 해주는 부분
        self._data = chats
        self.max_len = max_len
        self.q_token = Q_TKN
        self.a_token = A_TKN
        self.sent_token = SENT
        self.eos = EOS
        self.mask = MASK
        self.tokenizer = koGPT2_TOKENIZER

    def __len__(self):  # chatbotdata 의 길이를 리턴한다.
        return len(self._data)

    def __getitem__(self, idx):  # 로드한 챗봇 데이터를 차례차례 DataLoader로 넘겨주는 메서드
        turn = self._data.iloc[idx]
        q = turn["Q"]  # 질문을 가져온다.
        q = re.sub(r"([?.!,])", r" ", q)  # 구둣점들을 제거한다.

        a = turn["A"]  # 답변을 가져온다.
        a = re.sub(r"([?.!,])", r" ", a)  # 구둣점들을 제거한다.

        q_toked = self.tokenizer.tokenize(self.q_token + q + self.sent_token)
        q_len = len(q_toked)

        a_toked = self.tokenizer.tokenize(self.a_token + a + self.eos)
        a_len = len(a_toked)

        # 질문의 길이가 최대길이보다 크면
        if q_len > self.max_len:
            a_len = self.max_len - q_len  # 답변의 길이를 최대길이 - 질문길이
            if a_len <= 0:  # 질문의 길이가 너무 길어 질문만으로 최대 길이를 초과 한다면
                q_toked = q_toked[-(int(self.max_len / 2)) :]  # 질문길이를 최대길이의 반으로
                q_len = len(q_toked)
                a_len = self.max_len - q_len  # 답변의 길이를 최대길이 - 질문길이
            a_toked = a_toked[:a_len]
            a_len = len(a_toked)

        # 질문의 길이 + 답변의 길이가 최대길이보다 크면
        if q_len + a_len > self.max_len:
            a_len = self.max_len - q_len  # 답변의 길이를 최대길이 - 질문길이
            if a_len <= 0:  # 질문의 길이가 너무 길어 질문만으로 최대 길이를 초과 한다면
                q_toked = q_toked[-(int(self.max_len / 2)) :]  # 질문길이를 최대길이의 반으로
                q_len = len(q_toked)
                a_len = self.max_len - q_len  # 답변의 길이를 최대길이 - 질문길이
            a_toked = a_toked[:a_len]
            a_len = len(a_toked)

        # 답변 labels = [mask, mask, ...., mask, ..., <bos>,..답변.. <eos>, <pad>....]
        labels = [
            self.mask,
        ] * q_len + a_toked[1:]

        # mask = 질문길이 0 + 답변길이 1 + 나머지 0
        mask = [0] * q_len + [1] * a_len + [0] * (self.max_len - q_len - a_len)
        # 답변 labels을 index 로 만든다.
        labels_ids = self.tokenizer.convert_tokens_to_ids(labels)
        # 최대길이만큼 PADDING
        while len(labels_ids) < self.max_len:
            labels_ids += [self.tokenizer.pad_token_id]

        # 질문 + 답변을 index 로 만든다.
        token_ids = self.tokenizer.convert_tokens_to_ids(q_toked + a_toked)
        # 최대길이만큼 PADDING
        while len(token_ids) < self.max_len:
            token_ids += [self.tokenizer.pad_token_id]

        # 질문+답변, 마스크, 답변
        return (token_ids, np.array(mask), labels_ids)


def collate_batch(batch):
    data = [item[0] for item in batch]
    mask = [item[1] for item in batch]
    label = [item[2] for item in batch]
    return torch.LongTensor(data), torch.LongTensor(mask), torch.LongTensor(label)


koGPT2_TOKENIZER = PreTrainedTokenizerFast.from_pretrained(
    "skt/kogpt2-base-v2",
    bos_token=BOS,
    eos_token=EOS,
    unk_token="<unk>",
    pad_token=PAD,
    mask_token=MASK,
)
model = GPT2LMHeadModel.from_pretrained("skt/kogpt2-base-v2")

dataname = "totaldata.csv"
Chatbot_Data = pd.read_csv("./"+ dataname, encoding='ISO-8859-1')
Chatbot_Data.dropna(subset=["A"], inplace=True)
Chatbot_Data.dropna(subset=["Q"], inplace=True)
Chatbot_Data.dropna(subset=["id"], inplace=True)


print("start3")


device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
train_set = ChatbotDataset(Chatbot_Data, max_len=40)
train_dataloader = DataLoader(
    train_set,
    batch_size=32,
    num_workers=0,
    shuffle=True,
    collate_fn=collate_batch,
)

model.to(device)

learning_rate = 3e-5
criterion = torch.nn.CrossEntropyLoss(reduction="none")
optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)

epoch = 10
Sneg = -1e18


for epoch in range(epoch):
    dataloader = tqdm(train_dataloader, desc=f"Epoch {epoch}")
    for batch_idx, samples in enumerate(dataloader):
        optimizer.zero_grad()
        token_ids, mask, label = samples
        token_ids, mask, label = token_ids.to(device), mask.to(device), label.to(device)
        out = model(token_ids)
        out = out.logits
        mask_3d = mask.unsqueeze(dim=2).repeat_interleave(repeats=out.shape[2], dim=2)
        mask_out = torch.where(mask_3d == 1, out, Sneg * torch.ones_like(out))
        loss = criterion(mask_out.transpose(2, 1), label)
        avg_loss = loss.sum() / mask.sum()
        avg_loss.backward()
        optimizer.step()


model_save_path = os.path.join(save_dir, "chatbot_model.pth")
torch.save(
    {
        "model_state_dict": model.state_dict(),
        "optimizer_state_dict": optimizer.state_dict(),
        "epoch": epoch,
    },
    model_save_path,
)

print("Model saved at:", model_save_path)
출처: https://youngchannel.co.kr/aistudy/GPT2-파인튜닝으로-친근한-대화형-챗봇-만들기
그러나 크나큰 장벽과 부딪혔으니…
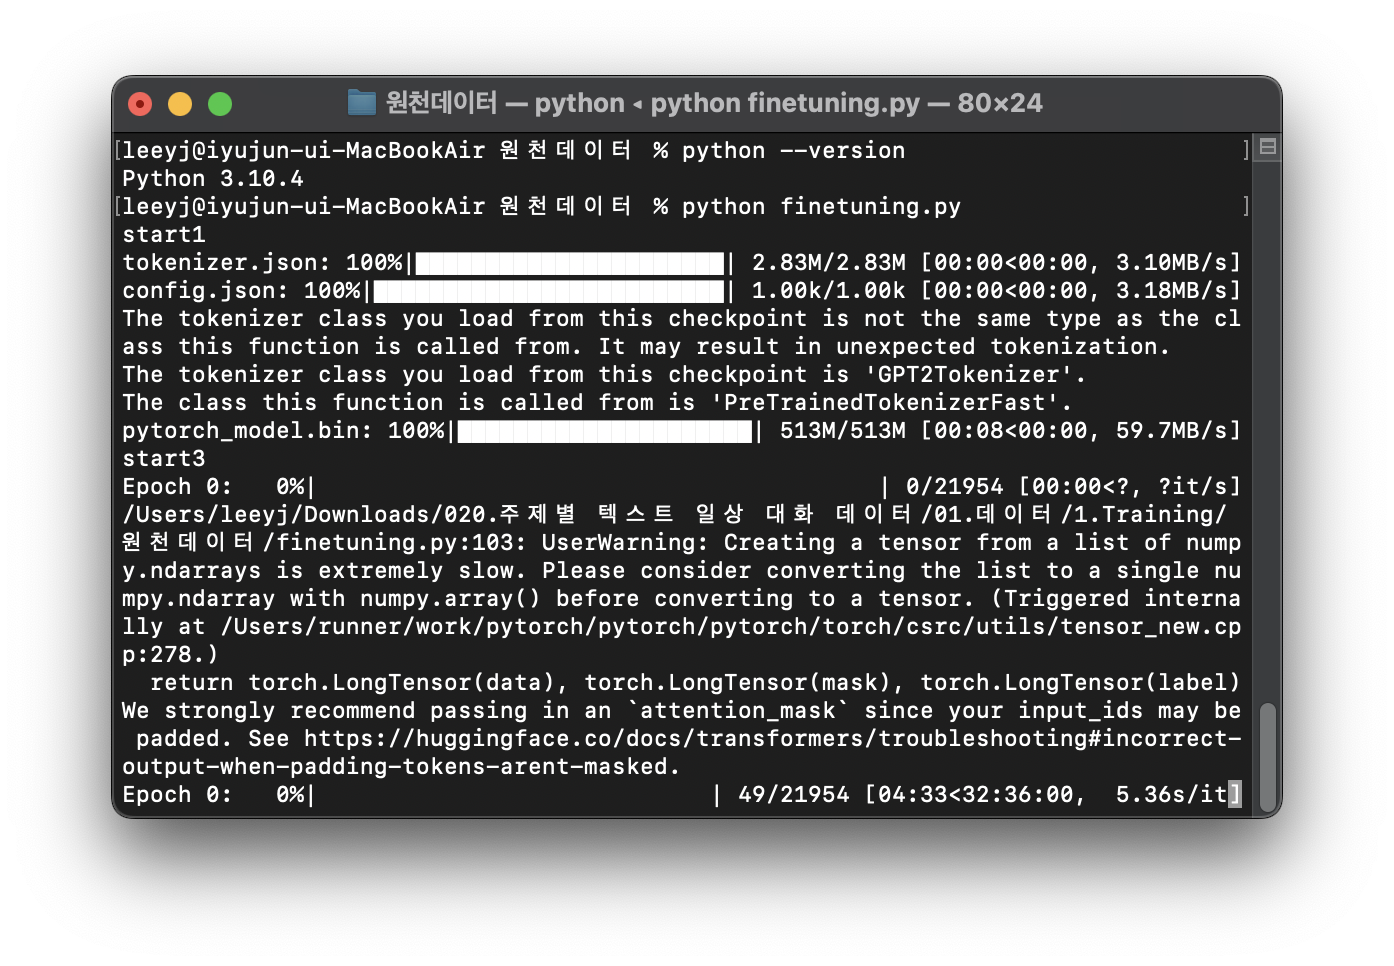
1Epoch 도는 데에 예상 시간이 32시간 소요되는 치명적 문제가…
60만 개의 대화 데이터셋이고, 10Epoch 지정했었는데, 그러면 320시간.. 꼬박 13일이 걸리는 테스크였네요…
혹시 제 로컬 컴퓨터의 성능이 별로여서 그런가 싶어, colab을 이용해 보았습니다. 그러나..
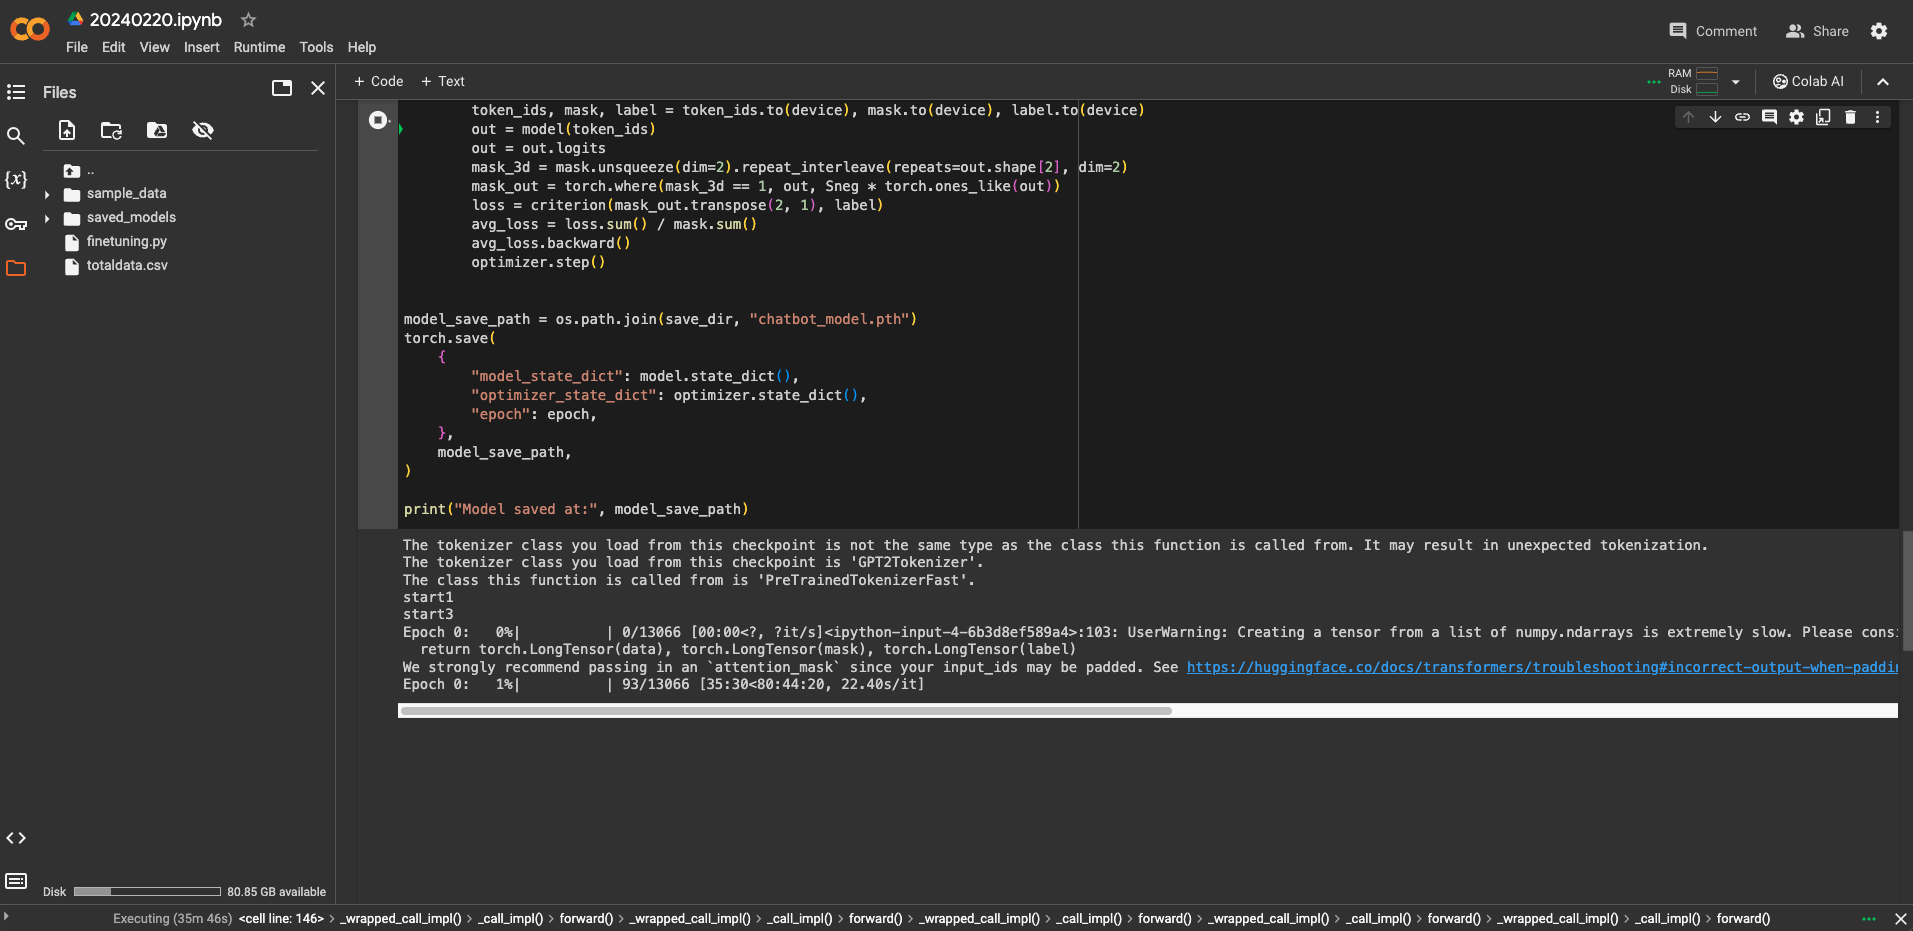
얘가 더하네요!! 80시간 ㅋㅋ
그래서, 이번에는 fine tuning을 시도해보았다는 것에 의의를 두고자 합니다…ㅋㅋ
이번 시도는 transformers와 PyTorch를 이용해서 진행되었는데, 다음 번에는 transformers 패키지만으로 모델 로드와 fine tuning를 해보려고 합니다!
[GPT2 기본 모델에 프롬프트 엔지니어링을 적용하기]
근데 이렇게 끝내기만은 아쉬워서, 프롬프트에 조금의 변화를 주어 GPT2를 ChatBot으로 사용해보는 시도를 해보았습니다.
평범하게 GPT2를 사용하면 이렇게 답을 주었었습니다.
from transformers import GPT2LMHeadModel, GPT2Tokenizer, pipeline

# 모델과 토크나이저의 경로 지정
model_path = './gpt2'
tokenizer_path = './gpt2'

# 모델 로드
model = GPT2LMHeadModel.from_pretrained(model_path)

# 토크나이저 로드
tokenizer = GPT2Tokenizer.from_pretrained(tokenizer_path)

# 텍스트 생성 파이프라인 생성
gpt2 = pipeline("text-generation", model=model, tokenizer=tokenizer)

# 텍스트 생성 실행
generated_texts = gpt2("I am a student. So ", max_length=80, truncation=True)
print(generated_texts[0]['generated_text'])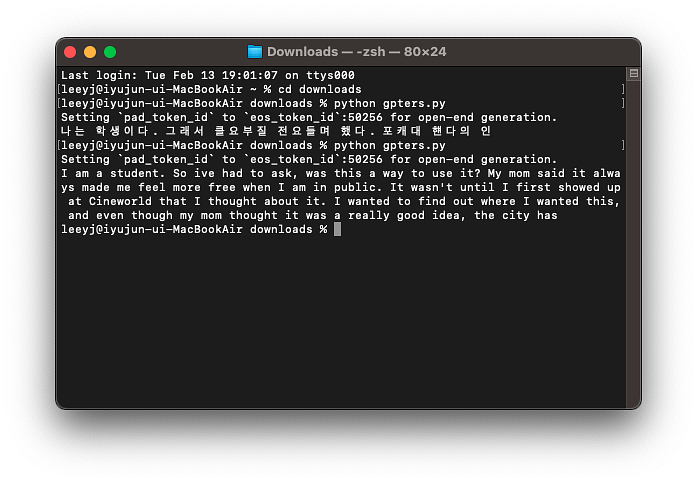
GPT2 기본 모델을 사용했기에, 한국어로 프롬프트(나는 학생이다. 그래서)를 넣어주면 이해하기 어려운 답(클요부질…햰다의 인)을 주는 모습입니다. 그러나 영어로 프롬프트(I am a studnet. So)를 주면, 어느 정도 읽을 수는 있는 글을 적어 줍니다.
저는 ChatBot을 만들어보려고 하는 터라, Next Token Prediction의 원리로, Q.~~ A. 이런 식으로 프롬프트를 적어보았습니다.
from transformers import GPT2LMHeadModel, GPT2Tokenizer, pipeline

# 모델과 토크나이저의 경로 지정
model_path = './gpt2'
tokenizer_path = './gpt2'

# 모델 로드
model = GPT2LMHeadModel.from_pretrained(model_path)

# 토크나이저 로드
tokenizer = GPT2Tokenizer.from_pretrained(tokenizer_path)

# 텍스트 생성 파이프라인 생성
gpt2 = pipeline("text-generation", model=model, tokenizer=tokenizer)

# 텍스트 생성 실행
generated_texts = gpt2("** User Info ** ['1', 'he is a student.'], ['2', 'he is a computer engeenering student.'] ** end User Info ** Q. How can I make money using AI tools? A.", max_length=200, truncation=True)
print(generated_texts[0]['generated_text'])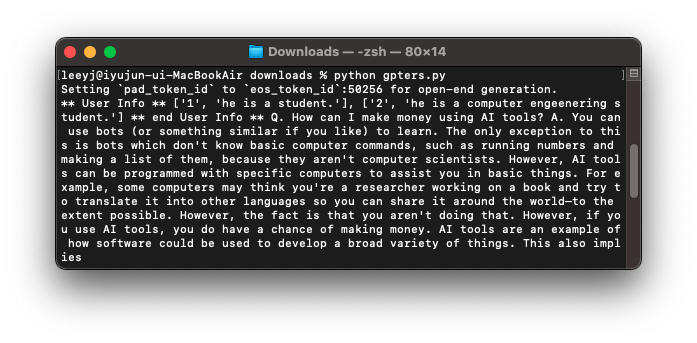
상당히 흥미롭게 답을 주는(A. 부분의 Next Token Prediction을 진행하는) 모습입니다!!
This also implies 후에 내용이 너무나 궁금하게 잘 끊어서…ㅋㅋ max_length를 250으로 늘려서 한 번 더 진행해 보았습니다!
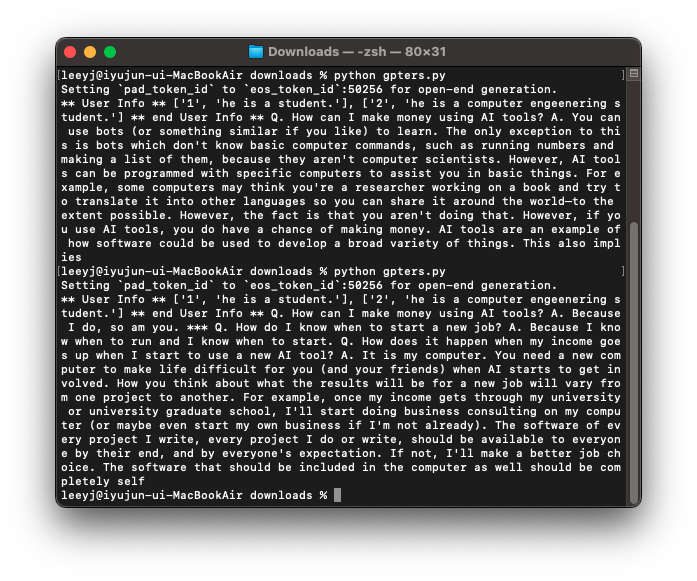
첫 시도가 운이 좋았던 것 같습니다..
다음 번에는 transformers의 trainer 클래스를 공부해서 한 번 fine tuning을 시도해 보려고 합니다!
이상입니다!
#9기HuggingFace
로그인하고 댓글을 남겨 주세요
토요일 오프 모임에서 인사 나눴는데, 이렇게 게시글을 통해서 다시 뵙게 되어 너무 반갑습니다~~ 올려 주신 글 잘 읽었습니다. 뭔지는 잘 모르겠으나, 너무 재미 있는 사례 같아 보이네요.. 다음 배움 거리로 키핑해 놓도록 하겠습니다!!
앗! 유준님, 너무 좋은 사례였는데! 발표에서 왜 손 안드셨어요 ㅠㅠ 좋은 시도 사례네요. 감사합니다. 코드 분석도 잘 해주셨구요. fine-tuning이니 학습은 10 epoch 정도로 시도해보면 좋을 것 같고, 가능하다면 LoRA fine tuning 키워드로 찾아보고 시도해보셔도 좋을 것 같아요.
HuggingFace의 PEFT에서 LoRA fine-tuning 지원해줍니다!
https://huggingface.co/docs/peft/index

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

@이른아침에 안녕하세요~~ 작성자 손에 글재주가 없어 조금 어렵게 작성된 탓이지요..ㅎㅎ
HuggingFace를 공부해보니~ 잘 공부해두면 본인의 아이디어에 따라서 모래밭의 진주가 될 수 있겠다는 생각이 들더군요~!!
앞으로도 양질의 정보와 함께 돌아오겠습니다~~ ^^