Hermes와 AKM 금융지식창고 연결
2026.08.06
1. 소개
Hermes가 금융 관련 요청을 처리할 때, 대화 내용에만 의존하지 않고 별도의 AKM 금융지식창고에 축적된 원본 자료, 해석 지식, 분석 절차와 검증 결과를 활용하도록 연결했습니다.
* 적용 이유
Hermes가 금융 관련 요청을 처리할 때 대화 내용에만 의존하지 않고, 별도의 AKM 금융지식창고에 축적된 원본 자료·해석 지식·분석 절차·검증 결과를 활용하도록 연결했습니다.
두 시스템의 역할은 다음과 같이 구분했습니다.
Hermes
→ 사용자 요청 해석
→ 금융지식창고 선택
→ 필요한 자료 조회·저장
→ 답변 작성

AKM 금융지식창고
→ 금융 원본·지식·절차·검증 결과 보관
→ 자료 분류·보안·검증 기준 제공
연결된 금융지식창고의 위치는 다음과 같습니다.
/home/beast/akm_main/jarvis_finance_akm2. README.md 기반 설정 방법
설정 기준은 금융지식창고의 다음 문서입니다.
adapters/hermes/README.md별도의 플러그인·MCP·RAG·데이터베이스를 설치하지 않고, Hermes가 새 세션마다 읽는 프로필 지침 파일에 AKM 경로와 운영규칙을 추가했습니다.
2.1 핵심 연결 설정
수정한 파일은 다음과 같습니다.
/home/beast/.hermes/SOUL.md
/home/beast/.hermes/memories/MEMORY.md
수정 전 복구를 위해 다음 백업을 생성했습니다.
/home/beast/.hermes/backups/
SOUL.md.before-akm-adapter.20260731_191957SOUL.md에는 다음 규칙을 등록했습니다.
markdown
금융 요청이면 금융지식창고를 선택한다.
INDEX를 따라 필요한 정본만 조회한다.
저장 전 SECURITY와 ROUTER를 적용한다.
변경 후 구조·링크·비밀정보를 검사한다.
중요 결과는 VERIFICATION 기준으로 검증한다.
반복 오류와 사용자 수정은 LOOP에 따라 개선한다.
2.2 핵심 운영방식: 조건부 로딩
전체 금융지식창고를 모든 Hermes 세션에서 읽지 않습니다. 금융 관련 요청이 들어왔을 때만 금융지식창고를 선택하고, 해당 작업에 필요한 인덱스와 정본을 조건부로 읽습니다.
일반 대화
→ SOUL.md만 로드
→ 금융지식창고를 읽지 않음

금융 관련 요청
→ 금융지식창고 선택
→ INDEX.md
→ INDEX.local.md
→ 40-memory 포인터
→ 작업에 필요한 정본만 조회
이 방식을 적용한 이유는 다음과 같습니다.
일반 대화에서 불필요한 금융자료 로딩 방지
컨텍스트와 토큰 사용량 절감
금융·학습·업무 지식창고 간 불필요한 혼합 방지
현재 작업에 필요한 정본만 선택적으로 조회
README는 세션 시작 시 INDEX.md와 40-memory를 읽는 기본 모델을 제안하지만, 현재는 여러 목적별 AKM을 연결하고 있으므로 모든 세션 선행 로딩 대신 지식 작업 진입 시 선택적 로딩을 적용한 확장 방식입니다.
3. README.md 주요 설정 적용 현황
두 번째 첨부 화면의 전체 19개 설정 중, 연결 구조를 이해하는 데 중요한 항목만 정리했습니다.
README | 주요 설정 | 현재 적용 상태 | 판정 |
|---|---|---|---|
L9 | AKM 절대경로 등록 | 금융지식창고 경로를 | 완료 |
L10 | 세션 시작 시 INDEX·40-memory 로딩 | 모든 세션이 아닌 금융지식 작업 진입 시 조건부 로딩 | 조건부 대체 적용 |
L11 | 지속 저장 전 ROUTER 분류 |
| 완료 |
L12 | 실패·사용자 수정의 Learn Back |
| 완료 |
L16 | 프로필 지침 파일에 어댑터 설치 |
| 완료 |
L18 | 중요 결과에 VERIFICATION 적용 | 지속·공개·고위험 결과에 Tier 0~3 적용 | 완료 |
L22 | 하나의 정본, 다른 곳에는 포인터 | 금융지식 본문은 AKM, Hermes에는 경로 포인터 유지 | 완료 |
L26 | Hermes MEMORY는 짧은 포인터 중심 | AKM 경로 포인터가 있으나 일부 Hermes 환경정보도 유지 | 부분 적용 |
L27 | 사용자 모델을 | 상세 사용자 모델이 아직 Hermes | 미수행 |
L29 | 절차 본문은 AKM, 스킬은 호출 래퍼 | 분석 절차는 있으나 전용 Hermes 스킬은 없음 | 부분 적용 |
L34 | 여러 프로필이 AKM 하나를 공유 | 현재는 | 의도적 구조 차이 |
L42 | qmd 의미검색 | 설치하지 않고 인덱스·파일검색 사용 | 미수행 |
L47 | SECURITY 선행 및 비밀정보 금지 | 보안검사 후 분류하도록 설정 | 완료 |
특히 L22와 L27은 구분해서 봐야 합니다.
L22 — 동일 본문의 중복 방지
→ 현재 충족

L27 — 사용자 모델 정본의 AKM 이전
→ 아직 미수행
사용자 모델이 30-context/users/<user>.md에 등록될 경우, 같은 작업에서 해당 Hermes 프로필의 USER.md를 정본 경로 한 줄로 전환해야 합니다. AKM이 파일 생성을 감지해 자동으로 포인터를 만드는 별도 후크는 현재 없습니다.
4. Hermes와 AKM 실제 연결 메커니즘
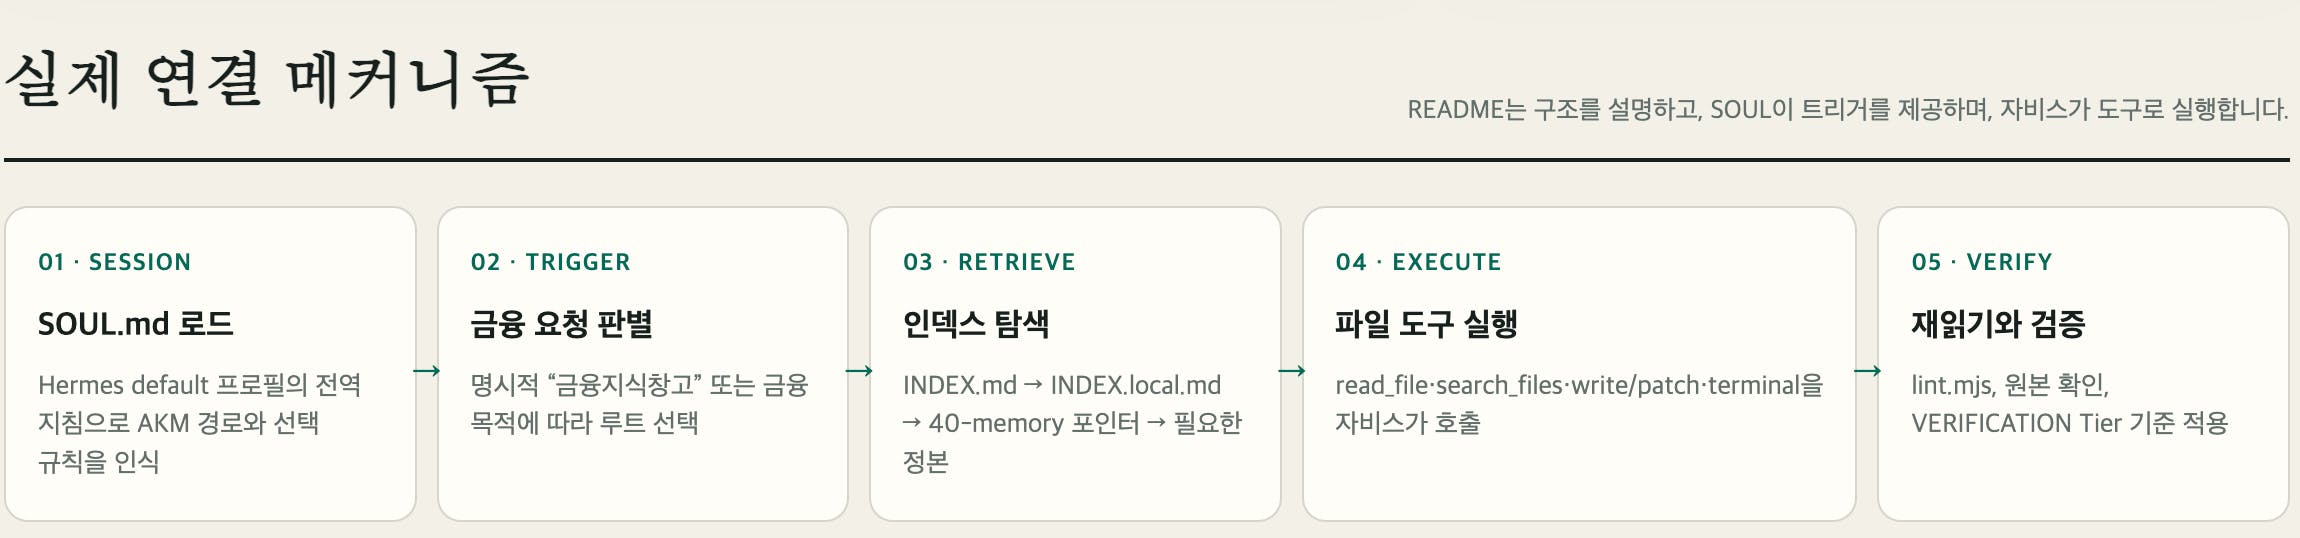
그림 1. Hermes와 AKM 금융지식창고의 실제 연결 메커니즘 README는 연결 구조와 운영원칙을 설명하고,
SOUL.md는 금융 요청에서 AKM을 선택하도록 트리거를 제공하며, Hermes가 파일 도구로 실제 조회·저장·검증을 수행합니다.
① SESSION — SOUL.md 로드
새 Hermes 세션이 시작되면 default 프로필의 SOUL.md가 로드됩니다.
SOUL.md
→ 금융지식창고 경로
→ 요청별 지식창고 선택 기준
→ 조회·저장·검증 규칙
이 단계에서 AKM 전체 문서가 메모리에 적재되는 것은 아닙니다. 연결 경로와 선택 규칙만 인식합니다.
② TRIGGER — 금융 요청 판별
사용자가 금융지식창고를 명시하거나 요청 내용이 금융 목적이면 Hermes가 금융지식창고를 선택합니다.
주식·ETF·채권·예금
환율·금리·유가
재무계획·연금·세금
부동산·금융 의사결정
③ RETRIEVE — 필요한 자료만 조회
금융지식창고가 선택된 후에만 다음 순서로 필요한 자료를 찾습니다.
INDEX.md
→ INDEX.local.md
→ 40-memory 포인터
→ 관련 지식·맥락·절차
→ 필요 시 10-sources 원본
이 단계가 현재 설정의 핵심입니다. 모든 세션에서 AKM 전체를 읽는 것이 아니라, 금융 요청이 발생한 경우에만 필요한 문서를 조건부로 조회합니다.
④ EXECUTE — Hermes가 파일 도구 실행
README나 ROUTER가 직접 파일을 읽고 생성하는 것은 아닙니다. Hermes가 실제 도구를 실행합니다.
text read_file search_files write_file patch terminal
저장 요청에서는 보안검사와 분류기준을 적용한 후 Hermes가 적절한 AKM 계층에 Markdown 파일을 생성합니다.
⑤ VERIFY — 재읽기와 검증
작업 후에는 생성·수정된 파일을 다시 읽고 다음 검사를 수행합니다.
text node scripts/lint.mjs --akm node scripts/lint.mjs --links node scripts/lint.mjs --secrets
중요한 결과에는 VERIFICATION.md의 Tier 0~3 기준을 적용하고, 실패나 반복 오류는 LOOP.md에 따라 원인 계층에 환류합니다.
5. 배운 점
Hermes 와 AKM의 구성 이해
현재 구성은 AKM이 백그라운드에서 독립적으로 파일을 생성하는 방식이 아니라, Herms가 요청을 해석하고 AKM 규칙에 따라 실행하는 방식입니다.
나만의 사용에 맞는 적용
금융지식창고를 읽을 수 있다고 해서 모든 세션 시작 시 무조건 읽는 것은 아닙니다. 현재는 연결 기능을 유지하면서 불필요한 컨텍스트 사용을 줄이기 위해 조건부 로딩을 적용했습니다.
6. 앞으로의 계획
사용자 승인 후 사용자 모델을
30-context/users로 이전하고USER.md를 포인터로 전환금융 분석 절차를 호출하는 전용 Hermes 스킬 제작
자료 증가 시 qmd 의미검색 도입 검토
이번 연결을 통해 Hermes는 단순히 금융정보를 답변하는 것을 넘어, 금융지식창고에서 근거를 선택적으로 조회하고 필요한 지식을 분류·검증·축적하는 실행형 에이전트로 확장됐습니다
로그인하고 댓글을 남겨 주세요
플러그인이나 MCP, RAG를 하나도 붙이지 않고 프로필 지침 파일에 경로와 운영규칙만 등록해서 두 시스템을 연결할 수 있다는 건 저도 이 글 보고 처음 알았습니다.
이 구조의 핵심은 결국 조건부 로딩의 트리거가 얼마나 결정론적인가에 있을 것 같은데요, 금융 요청 판별을 SOUL.md의 서술 규칙에만 맡기면 경계에 있는 요청에서 창고를 읽지 않고 답해도 겉으로는 정상 답변과 구분되지 않거든요. 예를 들어, 답변 끝에 이번에 실제로 조회한 정본 경로를 한 줄 남기게 해두시면 읽고 답한 것인지 사후에 판정할 수 있어서, L27 이전이나 전용 스킬을 붙이실 때 회귀 확인도 쉬워질 것 같습니다.
저도 지식 파일은 하나에 사실 하나만 담고 인덱스에는 한 줄 포인터만 두는 식으로 정리했는데, 그렇게 해두지 않으면 인덱스 자체가 비대해져 매 세션 비용이 되더라고요. 김태형님이 L26을 부분 적용으로 남겨두신 대목도 같은 결의 고민 같아 반가웠습니다.
사례 공유 감사드립니다:)
금융 질문이 들어올 때만 별도 지식창고의 목차와 필요한 문서를 읽게 한 선택이 실용적으로 다가왔습니다. 매 대화마다 창고 전체를 펼치지 않아도 되고, 금융 내용은 한곳에 두면서 Hermes에는 길만 알려 줄 수 있으니까요. 실제 분석 요청에서 필요한 문서까지 찾아가는 한 번의 사용 장면으로 이어지겠네요.
헤르메스가 이런 쓰임이 있는 걸 알 수 있었습니다.저도 이런 일을 규정하고, 조직화 하는 것을 하고 싶은데!! 이 글을 읽으며 더더 빨리 해야겠네요^^
플러그인이나 MCP, RAG, 데이터베이스를 새로 설치하지 않고 Hermes가 새 세션마다 읽는 프로필 지침 파일에 경로와 운영규칙만 얹어 연결하셨다는 점이 눈에 띄었습니다. 손대는 곳을 SOUL.md와 MEMORY.md 두 개로 좁히고, 수정 전에 날짜가 붙은 백업을 먼저 떠두신 순서도 좋았습니다. 되돌릴 방법을 만들어 두고 시작하는 습관이 이런 구조 작업에서는 결국 시간을 아껴주는 것 같습니다.
조건부 로딩 쪽 판단이 특히 설득력 있었습니다. 일반 대화에서는 지침 파일만 읽고 금융지식창고는 건드리지 않다가, 금융 요청이 들어오면 인덱스와 로컬 인덱스, 40-memory 포인터를 거쳐 그 작업에 필요한 정본만 조회하는 순서가 명확했습니다. 목적별 지식창고를 세 개 연결하고 계시니 모든 세션에서 선행 로딩하면 창고 간 지식이 섞일 위험이 있는데, 그 혼합 방지까지 이유로 적어두신 게 이 설계의 근거를 잘 보여줍니다.
README의 19개 설정을 완료·부분 적용·미수행·의도적 구조 차이로 판정해 표로 남기신 방식은 그대로 참고하고 싶습니다. 특히 여러 프로필이 하나의 창고를 공유하는 권고를 따르지 않은 것을 미수행이 아니라 의도적 구조 차이로 구분해 두신 점이 정확하다고 느꼈습니다. 사용자 모델이 아직 Hermes 쪽에 남아 있다는 것, 파일 생성을 감지해 자동으로 포인터를 만드는 후크가 지금은 없다는 것까지 밝혀두셔서 어디까지 사람이 챙겨야 하는지가 분명하게 읽혔습니다.
4장의 연결 메커니즘 설명도 좋았습니다. 지침 파일은 트리거와 선택 규칙만 갖고 있고, 실제 조회와 저장은 Hermes가 파일 도구로 수행한다는 구분, 저장 요청에서 보안검사를 먼저 통과한 뒤 분류와 스키마를 적용하는 순서, 작업 후에 만든 파일을 다시 읽어 구조와 링크, 비밀정보를 각각 검사하는 단계까지 이어지는 흐름이 촘촘했습니다. 중요한 결과에만 검증 등급을 적용하고 반복 오류는 원인 계층으로 환류시킨다는 부분은 검증 비용을 어디에 쓸지 정해둔 셈이라 흥미로웠습니다.
배운 점에 적으신 대로 지금 구성은 창고가 알아서 파일을 쌓는 방식이 아니라 Hermes가 요청을 해석하고 규칙에 따라 실행하는 방식이라는 정리가 이 글의 핵심으로 보였습니다. 읽을 수 있다는 것과 항상 읽어야 한다는 것을 갈라놓으신 판단도 같은 맥락이겠지요. 사용자 모델을 맥락 계층으로 옮기고 USER.md를 포인터 한 줄로 바꾸는 작업, 금융 분석 절차를 부르는 전용 스킬, 자료가 늘었을 때의 의미검색 도입 검토까지 다음 계획이 구체적이라 후속 글이 기대됩니다. 응원하겠습니다!

조건부 로딩 선택이 흥미롭네요. README가 기본 모델로 세션 시작 시 INDEX·40-memory를 읽도록 제안하는데, 여러 목적별 AKM을 동시에 연결 중이라 모든 세션 선행 로딩 대신 금융 작업 진입 시 선택적 로딩으로 변형하신 것 — "스펙 그대로 따르지 않고 내 구조에 맞게 적용했다"는 판단 근거가 글에 명확히 적혀있어요.
L22와 L27을 구분해서 적으신 것도 좋았어요. 동일 본문 중복 방지(L22)는 충족, 사용자 모델 AKM 이전(L27)은 미수행으로 현황을 솔직하게 남기셔서 이 글 읽는 분들이 완성본이 아닌 진행형 구조로 이해할 수 있겠더라고요.
기지개 한 번 펴고 다음 단계도 응원할게요 🐈⬛

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


잘 읽었습니다~