온톨로지 뜻부터 엔비디아 오토 온톨로지(Auto Ontology)까지: 자동 구축 정리

2026.11.10
AI에 회사 데이터를 연결해서 지난달 매출을 물었는데, 마케팅팀과 재무팀이 아는 매출이 서로 다르게 나온 상황 없으셨나요? 이번에 엔비디아(NVIDIA)가 공개한 오토 온톨로지(Auto Ontology)가 이 문제의 해결책이 될 수 있어 보여요.
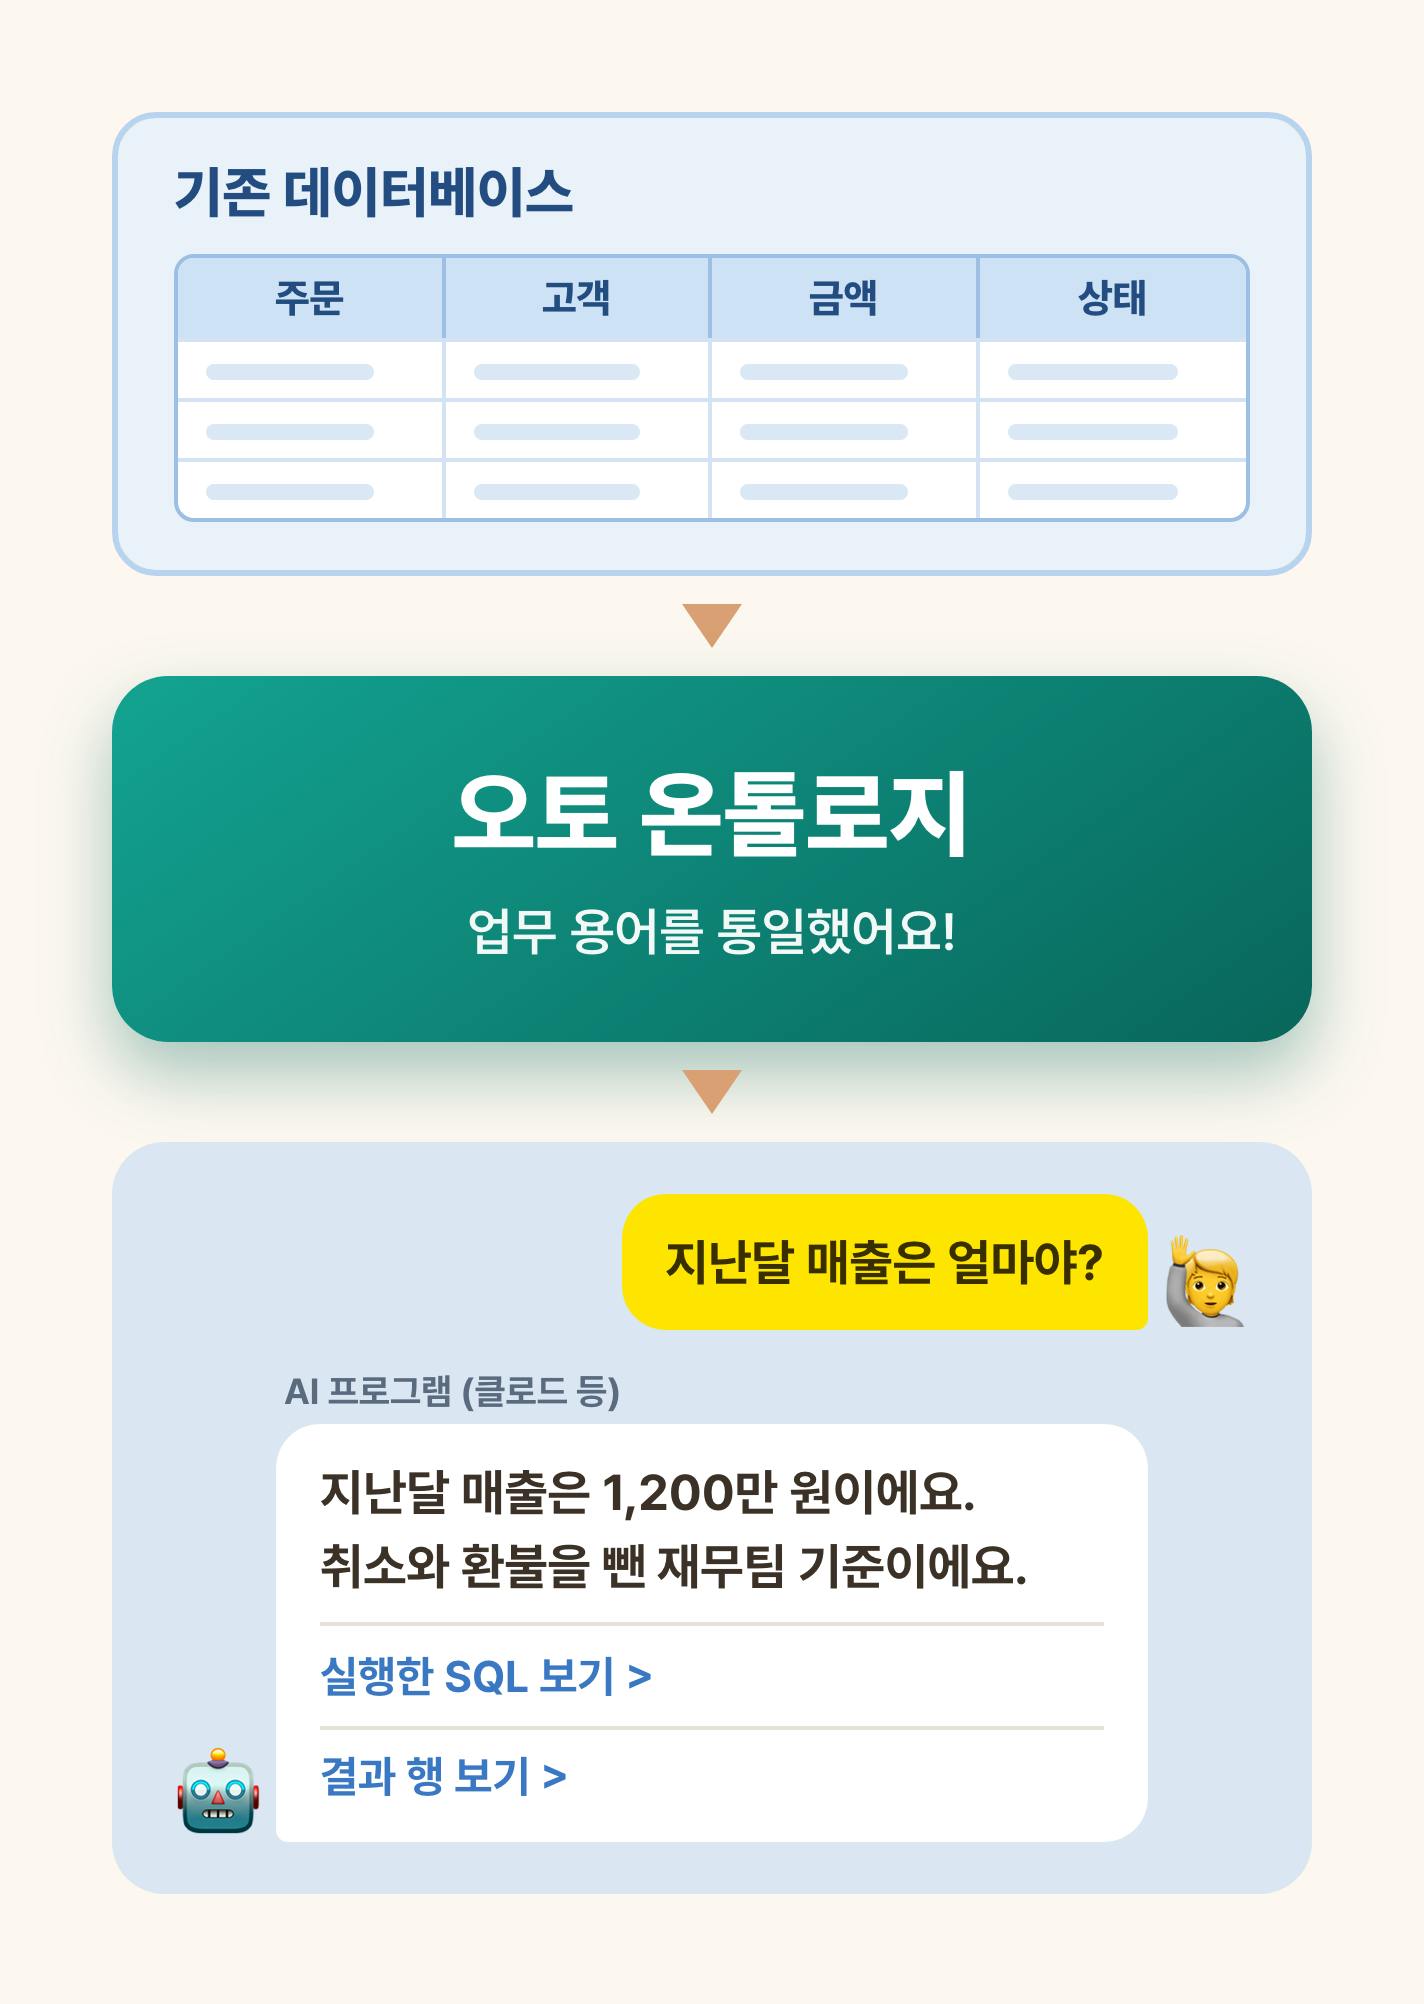
오토 온톨로지는 회사 데이터베이스에서 온톨로지를 자동으로 만들어 주는 프레임워크예요. 온톨로지는 매출, 고객, 주문 같은 업무 용어가 무슨 뜻이고 어떻게 계산하는지를 정리해서 팀마다 다른 업무 기준을 하나로 맞추는 구조입니다. 이 기준이 있으면 클로드(Claude) 같은 AI가 질문을 받았을 때 그 기준을 보고 답할 수 있습니다.
다만 파일 하나 올리면 끝나는 서비스는 아니에요. 서버와 데이터베이스 연결을 직접 준비해야 합니다.
같은 회사 매출인데
팀마다 계산식이 다르다면?
가상의 온라인 상점으로 예를 들어볼게요. 마케팅팀은 결제된 주문을 매출로 보고, 재무팀은 취소와 환불을 뺀 금액을 매출로 본다고 해봅시다.
AI에게 지난달 매출을 물으면 어느 팀 기준으로 계산해야 할까요? 주문 테이블(주문 데이터를 담은 표)을 읽을 권한만으로는 정할 수 없습니다. 날짜 기준, 제외할 주문, 할인액 처리가 모두 정해져 있어야 합니다.
온톨로지 뜻은
무엇일까요?
온톨로지는 회사에서 쓰는 말의 뜻과 관계, 데이터 위치를 한곳에 정리해 둔 구조예요. 앞의 가상 상점에서 매출을 정리하면 이렇습니다.
- 뜻: 매출은 취소와 환불을 뺀 결제 금액이에요.
- 관계: 고객이 주문을 하고, 주문에는 상품이 담겨요.
- 데이터 위치: 매출은 주문 테이블의 금액 컬럼(표의 세로 항목)을 더해서 계산해요.
이렇게 적어 두면 AI가 질문을 해석할 때 참고할 기준이 생깁니다. 주문 테이블만 읽을 때와 달리 취소 주문을 빼야 한다는 것까지 알고 답할 수 있어요.
매출은 예시일 뿐이에요. 활성 고객, 재구매율, 이탈 고객처럼 팀마다 기준이 갈리는 말이면 같은 방식으로 정리합니다. 활성 고객을 마케팅팀은 최근에 접속한 사람으로, 영업팀은 최근에 결제한 사람으로 볼 수도 있으니까요.
오토 온톨로지는
무엇을 해 줄까요?
이 온톨로지를 자동으로 만드는 일을 오토 온톨로지가 맡습니다. 공식 소개를 보면 데이터베이스의 메타데이터(테이블과 컬럼 이름, 관계 같은 데이터 설명 정보)에서 온톨로지를 생성하고, 이미 있는 의미 모델(용어와 데이터의 연결 정보)을 보완하는 기능이 있습니다. 사내 시스템을 통째로 바꾸지는 않고, 데이터를 읽는 기준만 만들어 줘요.
자동으로 만들면
끝일까요?
자동 생성은 데이터 연결과 메타데이터 수집에서 시작합니다. 테이블, 컬럼, 관계를 바탕으로 용어를 만듭니다. 그런데 컬럼 이름만 보고 우리 회사의 환불 처리 기준까지 맞출 수는 없어요.
그래서 사람이 확인할 곳은 계산식과 업무상 예외입니다. 앞의 가상 매출이라면 결제일 기준인지 배송일 기준인지, 취소 주문은 어떻게 처리하는지, 한 주문에 상품이 여러 개일 때 금액이 겹치지 않는지를 봅니다.
공식 모델 관리 지침도 같은 방향이에요. 정의를 바꾸기 전에 변경안을 사용자에게 알리고, SQL(데이터를 꺼내는 명령)을 검증하고, 저장된 내용을 다시 확인하라고 안내합니다. 요청이 성공한 것과 업무 의미가 맞게 저장된 것은 다른 일이니까요.
클로드로 회사 데이터에
어떻게 물어볼까요?
오토 온톨로지에는 MCP 서버가 있습니다. MCP는 AI 프로그램을 외부 서버와 연결하는 규격이에요. 클로드 데스크톱(Claude Desktop)처럼 MCP를 지원하는 프로그램을 이 서버에 연결하면, 사내 데이터에 자연어로 질문하고 답변에 쓰인 의미 모델도 조회할 수 있습니다.
연결하려면 오토 온톨로지가 실행 중인 배포 환경이 먼저 있어야 합니다. MCP 서버에는 오토 온톨로지가 실행 중인 주소를 알려 주고, 클로드 같은 프로그램은 그 MCP 서버 주소로 연결합니다. 사용자가 로그인하면 이후 호출은 그 사용자의 권한으로 처리돼요. 클로드 쪽 설정 파일에 데이터베이스 비밀번호를 적는 구조는 아니에요.
MCP 문서에 나온 기능은 9개이고 모두 읽기 전용이에요. MCP에서는 이 기능을 도구라고 불러요. 주요 기능은 세 가지입니다.
ask_question: 답변과 실행한 SQL, 결과 행을 돌려줘요.search_terms: 용어를 찾아요.check_answerable: 질문에 답할 의미 정보가 있는지 확인해요.
용어를 고치거나 의미 모델을 다시 만드는 일은 관리용 API(프로그램끼리 요청을 주고받는 창구)가 맡습니다. AI가 질문하는 길과 사람이 정의를 고치는 길이 나뉘어 있는 거예요.
제가 서버를 설치하고 클로드에 연결해 실행해 본 것은 아니에요. 이 부분은 공식 문서 기준입니다. 도입하신다면 쓰는 버전의 기능 목록과 인증 설정을 문서와 맞춰 보세요.
답변에 쓰는 데이터베이스와
수집한 데이터베이스가 다를 수 있다고요?
이 부분은 오토 온톨로지 서버를 직접 설치하고 관리하는 분을 위한 내용이에요. 그런 일을 맡지 않으셨다면 다음 소제목으로 넘어가도 괜찮습니다.
데이터베이스 연결은 화면에서 추가하거나 배포 환경의 CONNECTION_STRINGS에 넣을 수 있어요. 두 방식을 같이 쓰면 질의와 수집에 서로 다른 연결이 잡힐 수 있습니다.
- 질의(질문에 답할 때): 화면에서 추가한 연결이 먼저예요. 없을 때만
CONNECTION_STRINGS를 써요. - 수집(온톨로지를 만들려고 데이터를 읽을 때):
CONNECTION_STRINGS가 먼저예요. 비어 있을 때만 화면에서 추가한 연결을 읽어요.
공식 연결 문서는 이 차이 때문에 서버 하나에 연결 방식을 1개만 쓰라고 권합니다. 수집한 데이터베이스와 답변에 쓰는 데이터베이스가 달라지는 일을 막으려는 거예요.
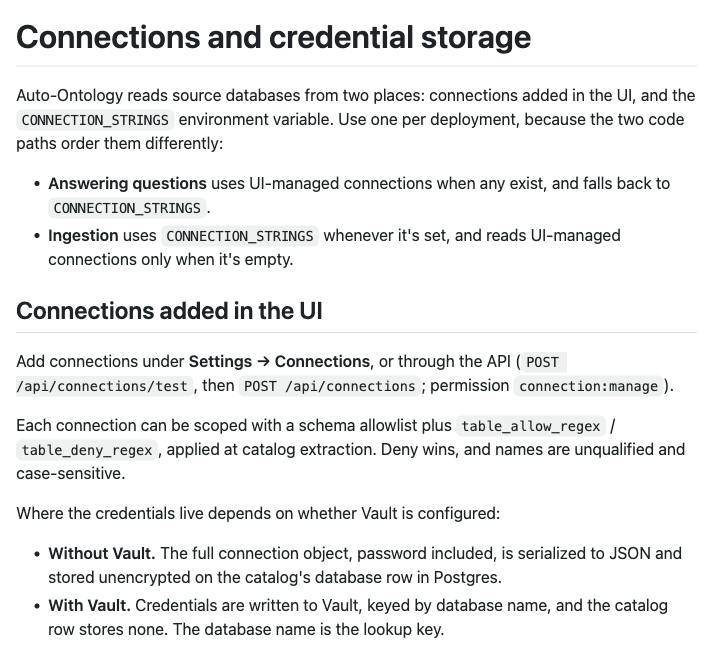
출처: NVIDIA Auto Ontology 연결 문서. 캡처: 2026-11-04.
연결한 데이터베이스 비밀번호가
평문으로 저장된다고요?
사내 데이터를 연결하기 전에 꼭 볼 조건이에요. 화면에서 추가한 데이터베이스 연결은 볼트(Vault)를 설정하지 않으면 비밀번호까지 평문으로 저장돼요. 볼트는 비밀정보를 따로 보관하는 서비스입니다. 비밀번호가 담긴 연결 정보 전체가 JSON으로 바뀌어 포스트그레스(Postgres)의 카탈로그(오토 온톨로지가 정보를 저장해 두는 곳) 행에 암호화 없이 들어가요.
볼트를 켜면 비밀번호는 볼트에 저장되고 카탈로그 행에는 남지 않습니다. 조회할 때는 데이터베이스 이름을 키로 씁니다.
2026-11-09 기준으로 볼트를 켜려면 설정값(환경변수) 4개가 모두 필요해요.
VAULT_ADDR: 볼트 주소VAULT_NAMESPACE: 네임스페이스VAULT_ROLE_ID,VAULT_SECRET_ID: 인증
기본값은 꺼짐이에요. 일부만 설정하면 경고가 뜨고 평문 저장으로 돌아갑니다. VAULT_AUTH_MOUNT, VAULT_KV_MOUNT 2개는 인증과 저장 경로를 바꾸는 선택 변수라서 필수 변수를 대신하지 못합니다.
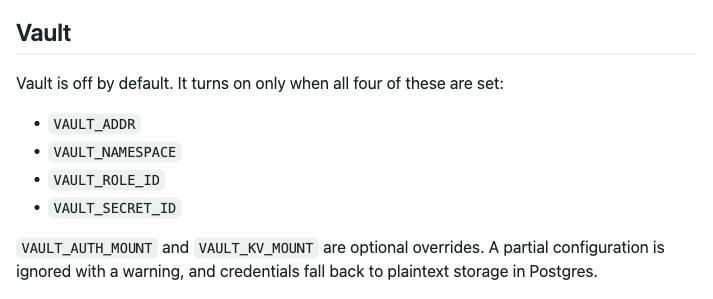
출처: NVIDIA Auto Ontology 연결 문서, Vault 구간. 캡처: 2026-11-04.
코드가 공개라면
무료로 쓸 수 있을까요?
오토 온톨로지는 아파치 2.0(Apache-2.0) 라이선스로 공개돼 있어요. 하지만 코드가 공개됐다고 운영이 공짜는 아닙니다. 앱을 돌릴 서버, 내부 데이터를 연결할 환경, 모델을 호출할 계정이 필요해요.
로컬 개발 안내를 보면 프런트엔드, 백엔드, 데이터 수집 서비스, 카탈로그를 저장할 데이터베이스를 함께 실행하는 구성이에요. 설치와 데이터 권한을 맡을 담당자가 있는 팀에 맞는 프레임워크예요.
기본 모델 설정은 엔비디아가 호스팅하는 모델 API를 써요. 호환되는 다른 모델 주소(엔드포인트)를 지정할 수도 있지만, 그때는 그 제공자와 모델의 이용 조건을 따라야 합니다. 공식 안내에는 자체 호스팅 모델 실행 환경인 엔비디아 NIM(NVIDIA NIM)을 쓰는 구성도 나와요.
그래서 도입 전에 3개를 확인하세요.
- 회사 데이터가 외부 모델 API로 나가도 되는지
- 요청에 어떤 정보가 담기는지
- 사용량이 어떻게 과금되는지
AI의 답이 맞는지
어떻게 확인할까요?
공식 질의 지침은 질문 의도, SQL, 결과, 답변 문장을 같이 검증하라고 안내합니다. 쿼리가 실행된 것과 답이 맞는 것은 다르기 때문이에요. 2026-11-09 기준으로 MCP 응답의 결과 행은 최대 100개이고, 결과가 잘렸는지는 truncated로 알 수 있어요.
우리 팀에도 같은 이름인데 정의가 다른 지표가 있나요? 있다면 그 지표 하나로 먼저 시험해 보세요. 연결한 클로드에 이렇게 물어보면 됩니다.
지난달 매출을 알려줘. 취소와 환불은 빼고 계산해 줘. 실행한 SQL도 같이 보여 줘.
같은 질문인데 이번에는 취소와 환불을 포함해서 계산해 줘.
두 답을 지금 쓰는 집계 숫자와 비교하세요. 다르면 SQL의 날짜 조건과 제외 조건에서 갈린 곳을 찾을 수 있어요.
도입 전에 팀이 정할 것은 세 가지예요. 지표의 기준을 합의하고, 서버와 연결을 맡을 담당자를 정하고, AI의 답을 기존 집계와 대조할 사람을 정하세요.
글쓴이 강지인. AI 커뮤니티 지피터스(GPTers)에서 1인 마케팅을 맡고 있고, 매일 AX와 AI 뉴스, 에이전트에 관한 글을 씁니다.
확인일 2026-11-09
- 개요와 운영 조건: NVIDIA Auto Ontology README
- 연결 우선순위와 자격 증명 보관: Auto Ontology 연결 문서
- MCP 연결과 기능: Auto Ontology MCP 문서

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요