퍼포먼스 팩토리, AI의 진단을 다른 AI가 반박하게 만든 이유

2026.11.20
AI가 오류 원인을 설명했는데, 고치고 나서도 같은 문제가 남는다면 무엇을 다시 물어봐야 할까요? 오픈AI(OpenAI)의 퍼포먼스 팩토리(Performance Factory)는 첫 진단을 반박하는 별도 AI 세션을 뒀습니다.
퍼포먼스 팩토리는 챗GPT(ChatGPT)의 성능 문제를 조사하고, 수정안을 제안하고, 회복 여부를 확인하는 내부 시스템이에요. 코딩 AI 코덱스(Codex)가 찾은 원인을 다른 세션이 검토하는 진단 반박 절차도 이 안에 있습니다.
2026년 11월 19일 공개된 운영 사례에서, AI에게 진단을 맡길 때 함께 물어볼 질문을 가져와볼게요.
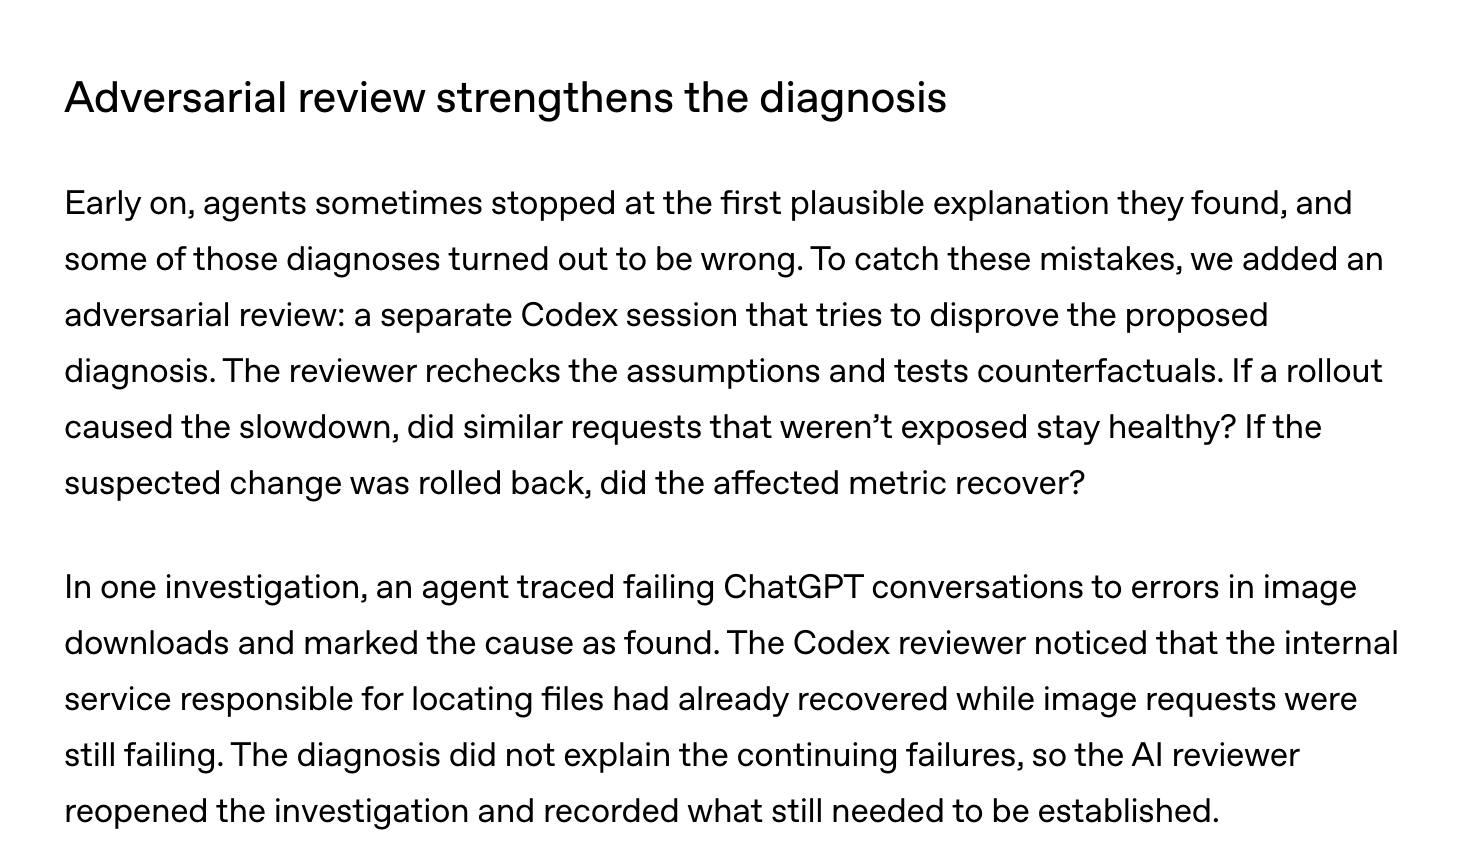
출처: OpenAI 공식 발표의 진단 반박 구간. 발표 2026-11-19, 캡처 2026-11-20.
원인을 찾았다는데
이미지는 왜 안 뜰까요?
파일을 찾는 시스템은 회복됐는데 이미지 요청은 계속 실패했기 때문입니다. 첫 진단으로는 남아 있는 장애를 설명하지 못했어요. 공식 발표에는 이 진단을 다시 검토한 사례가 나옵니다.
처음 조사한 AI는 챗GPT 대화가 실패하는 현상을 이미지 다운로드 오류까지 추적했습니다. 여기서 원인을 찾았다고 표시했는데요. 별도 코덱스 세션이 보니 파일 위치를 찾는 내부 시스템은 이미 회복된 상태였습니다.
그런데 이미지 요청은 여전히 실패하고 있었어요. 원인으로 지목한 쪽이 회복됐다면, 왜 증상은 남아 있을까요? 검토 세션은 조사를 다시 열고 아직 밝혀야 할 내용을 기록했습니다.
반박 검토는
무엇을 확인하는 걸까요?
반박 검토의 목적은 원인이라는 주장이 틀릴 조건을 찾는 것이에요. 발표에서 말하는 적대적 검토는 처음 조사한 AI의 가정을 다시 살피고, 그 설명과 맞지 않는 증거를 시험하는 절차입니다.
가령 새 코드를 적용한 뒤 느려졌다면, 그 코드가 원인이라는 설명이 나올 수 있겠죠. 검토 세션은 같은 코드를 적용하지 않은 비슷한 요청도 느려졌는지 봅니다. 적용 여부와 무관하게 느려졌다면 다른 원인을 더 찾아야 하니까요.
원인으로 의심한 변경을 되돌렸을 때, 실제 속도가 회복됐는지도 확인합니다. 변경 시점과 장애 시점이 가까웠다는 사실만으로 둘 사이의 원인 관계가 입증되지는 않아요.
초기에는 AI가 처음 발견한 그럴듯한 설명에서 멈췄고, 그중 일부는 오진이었습니다. 오픈AI는 이런 실수를 잡으려고 반박 검토를 추가했다고 설명합니다. 진단 문장이 얼마나 매끄러운지보다, 그 진단으로 실제 현상을 설명할 수 있는지를 따져보는 거예요.
발표에서 사람이 검토한 원인 제안은 100건이고, 이 중 70%를 정확하다고 평가했습니다. 나머지 30%는 추가 보완이 필요하거나 원인 관계가 충분히 입증되지 않은 제안이에요.
다른 AI는
다른 모델을 뜻하나요?
이번 발표에서 확인되는 구성은 별도 코덱스 세션입니다.
퍼포먼스 팩토리는 조사와 진단 반박, 수정안 제안을 각각 다른 코덱스 실행에 맡겼습니다. 단계마다 할 일을 따로 정해 지시하는 방식이죠.
작업 상태와 주요 발견은 다른 AI나 엔지니어가 이어받도록 별도 작업 기록에 저장합니다. 코드 검토나 실제 반영을 기다린 뒤에도 그 기록을 바탕으로 작업을 재개합니다.
진단이 맞아도
수정은 사람이 검토해요
공식 운영 절차에서는 엔지니어가 수정안의 반영 여부를 결정합니다. 진단이 반박 검토를 통과하면 코덱스가 수정 코드를 만들고, 변경 내용을 검토해달라는 요청인 PR을 엽니다.
엔지니어는 제안한 코드를 고치거나, 진단을 참고해 직접 수정할 수도 있어요. 댓글로 의견을 남기면 AI가 다시 작업합니다. 원인을 찾았다는 판단과 그 수정 코드를 실제로 반영해도 된다는 판단을 나눈 것입니다.
수정안에도 반박 검토를 붙였어요. 원인을 정확히 짚었더라도 필요 이상으로 복잡하게 고치거나 새 문제를 만들 수 있기 때문입니다. 자주 쓰는 데이터를 잠시 저장해 속도를 높이는 캐시를 추가하면, 오래된 데이터가 남는 문제도 함께 따져야 합니다.
실제 반영 뒤에는 AI가 성능이 이전 수준으로 돌아왔는지 확인합니다. 개선이 없으면 조사를 다시 진행하고, 일부만 회복됐다면 남은 문제를 새 작업으로 열어요.
조사 방식을 바꾸면
과거 장애로 다시 시험해요
오픈AI는 과거 실제 장애를 다시 풀게 하는 시험으로 조사 방식을 점검합니다. AI의 작업 지침이나 모델을 바꾸면 어떤 사례는 더 잘 진단하고, 다른 사례는 놓칠 수 있기 때문이에요.
이때 조사할 AI에게 과거 해결 보고서나 이전 실행의 결과를 보여주지 않습니다. 새 조사 세션에 당시의 신호를 주되, 답을 알려줄 정보는 제외해요. 정답을 읽고 그럴듯하게 설명한 결과와 처음부터 원인을 찾아낸 결과를 구분하려는 것입니다.
다만 과거 장애를 재현하는 데도 조건이 있습니다. 당시 수집한 기록은 보관 기간이 지나 사라질 수 있고, 복구 뒤 수집한 증거에는 원인을 짐작하게 하는 정보가 들어갈 수도 있어요. 조사자가 어떤 증거를 볼 수 있었는지 함께 확인해야 합니다.
평가도 원인을 맞혔는지만 보지 않습니다. 문제가 시작된 시점과 영향을 받은 요청, 가능한 원인들을 증거에 맞게 비교했는지를 나눠 살펴봐요.
내 업무에서는
반박할 자료부터 챙겨요
클로드(Claude) 같은 AI에 오류 원인을 물어봤다면, 새 대화에 첫 진단과 판단에 쓴 자료를 함께 넣어보세요. 오류 메시지, 문제가 시작된 시점, 최근 바뀐 설정처럼 원인을 대조할 자료가 필요합니다. 회사 자료라면 비밀값과 개인정보는 빼고, 외부 AI에 넣어도 되는 범위부터 확인해야 해요.
첫 답변의 요약만 주면, 검토할 AI도 그 답변에 담긴 주장만 보게 됩니다. 원래 기록을 함께 주고 어떤 자료가 부족한지 말하게 해보세요.
예를 들어 가상의 파일 저장 자동화가 중간에 멈춘 상황이라면, 처음 AI가 접근 권한 문제를 지목했다고 해볼게요. 권한을 수정한 기록과 그 뒤에도 남은 오류 메시지를 함께 줘야, 검토할 AI가 처음 설명의 빈틈을 살펴볼 수 있습니다.
다음 진단에는
이 질문을 붙여보세요
최근 AI에게 받은 원인 설명이 있다면, 새 대화에서 진단과 맞지 않는 증거를 물어보세요. 아래는 첫 진단과 관련 자료를 붙인 뒤 시험해볼 질문입니다.
이 진단이 맞다고 가정하고, 첨부한 기록에서 설명되지 않는 증상을 찾아줘. 확인할 자료가 부족하면 무엇이 필요한지 알려줘.
이번에는 이 진단이 틀렸다고 가정하고, 같은 기록에서 다른 가능한 원인을 찾아줘. 근거가 없으면 없다고 말해줘.
팀에서는 시험할 업무와 변경 실행을 승인할 사람을 먼저 정해두세요. 두 질문의 답이 다를 때 추가 자료를 확인할 담당자도 함께 정하면 좋겠습니다.
글쓴이 강지인. AI 커뮤니티 지피터스(GPTers)에서 1인 마케팅을 맡고 있고, 매일 AX와 AI 뉴스, 에이전트에 관한 글을 씁니다.
확인일 2026-11-20
- 공식 발표: 퍼포먼스 팩토리 운영 사례 (OpenAI, 2026-11-19)

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요