클로드 코드를 이용해 신탁공매 물건 취합하여 레포트 자동화 제작기

2026.01.20
소개
안녕하세요, 이번에 지피터스에 처음 가입하게 된 원펜스입니다.
우선, 이번에 참여하게 된 스터디는 AI로 시작하는 부동산 투자인데요. 첫 OT 때, 분위기를 보니 스터디장님들과 스터디원 분들이 이미 AI 스터디 경험이 많으신 것 같더라고요! 초보다보니 위축이 들지만 열심히 해보도록 하겠습니다!
일단 제가 개인적으로 이번에 진행할 과제는 '신탁 공매'물건 취합 및 레포트 작성 자동화입니다. 제가 주마다 신탁 공매 물건을 하나 골라서 업로드 하는데 물건 찾을 때마다 엄청 품이 많이 드는 작업이라 이번에 스터디에 참여하면서 개인적으로 진행하고자 하는 프로젝트인데요. 아직 작업 중이지만 로그성으로 과제글로 남기고자 합니다.
목표: 신탁 공매 물건 취합 및 레포트 작성
내용: 금주의 업로드된 물건 중 우선순위에 따라 10개의 물건을 추리고 그 중 상위 2건의 물건을 레포트 형식으로 작성하여 옵시디언에 저장
우선 순위: 지역, 가격, 물건 유형 등을 비교하여 조사
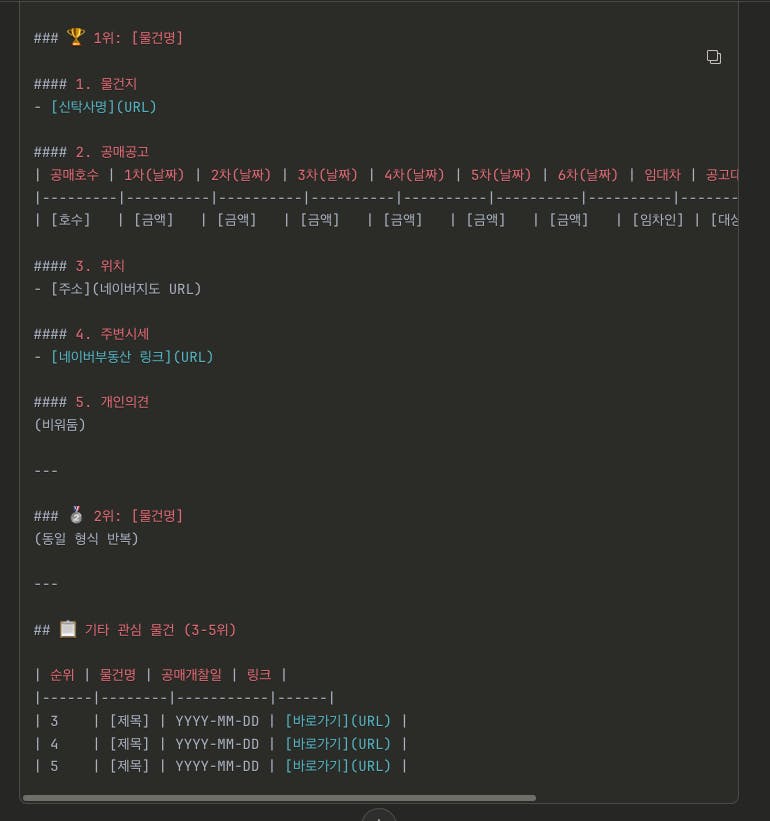
특징: 상위 2건의 물건을 레포트 형식. 레포트 형식에는 물건지(공매 공고 URL), 공매회차별 정보(최저입찰가, 동호수, 공매개시일자 등을 표 형식으로 작성), 위치(네이버지도), 주변 물건 비교(네이버부동산) 등. 이외의 나머지 8건은 간단한 정보만 포함(공고 URL, 공매물건이름, 유형, 최저입찰가)
진행 방법
어떤 도구를 사용했고, 어떻게 활용하셨나요?
사용 도구: 클로드 코드
활용 방법
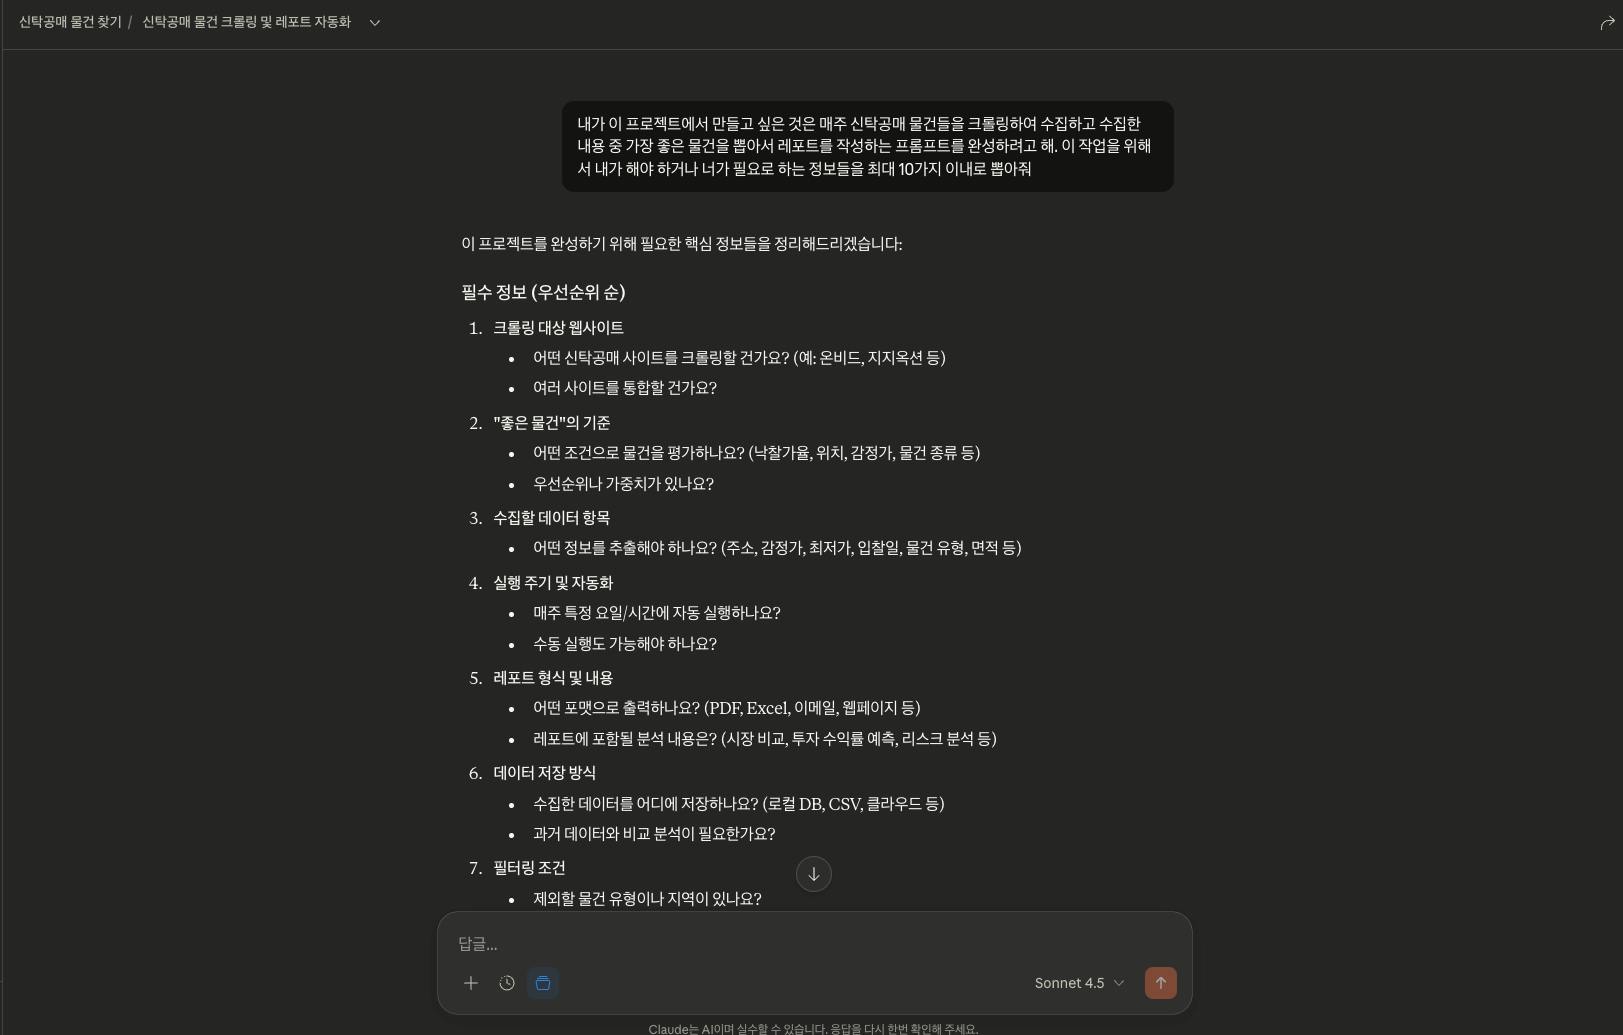
클로드와의 대화를 통해 자동화를 위한 프롬프트 전문 작성
작성된 프롬프트를 클로드 코드를 통해 프로그램 소스 작성
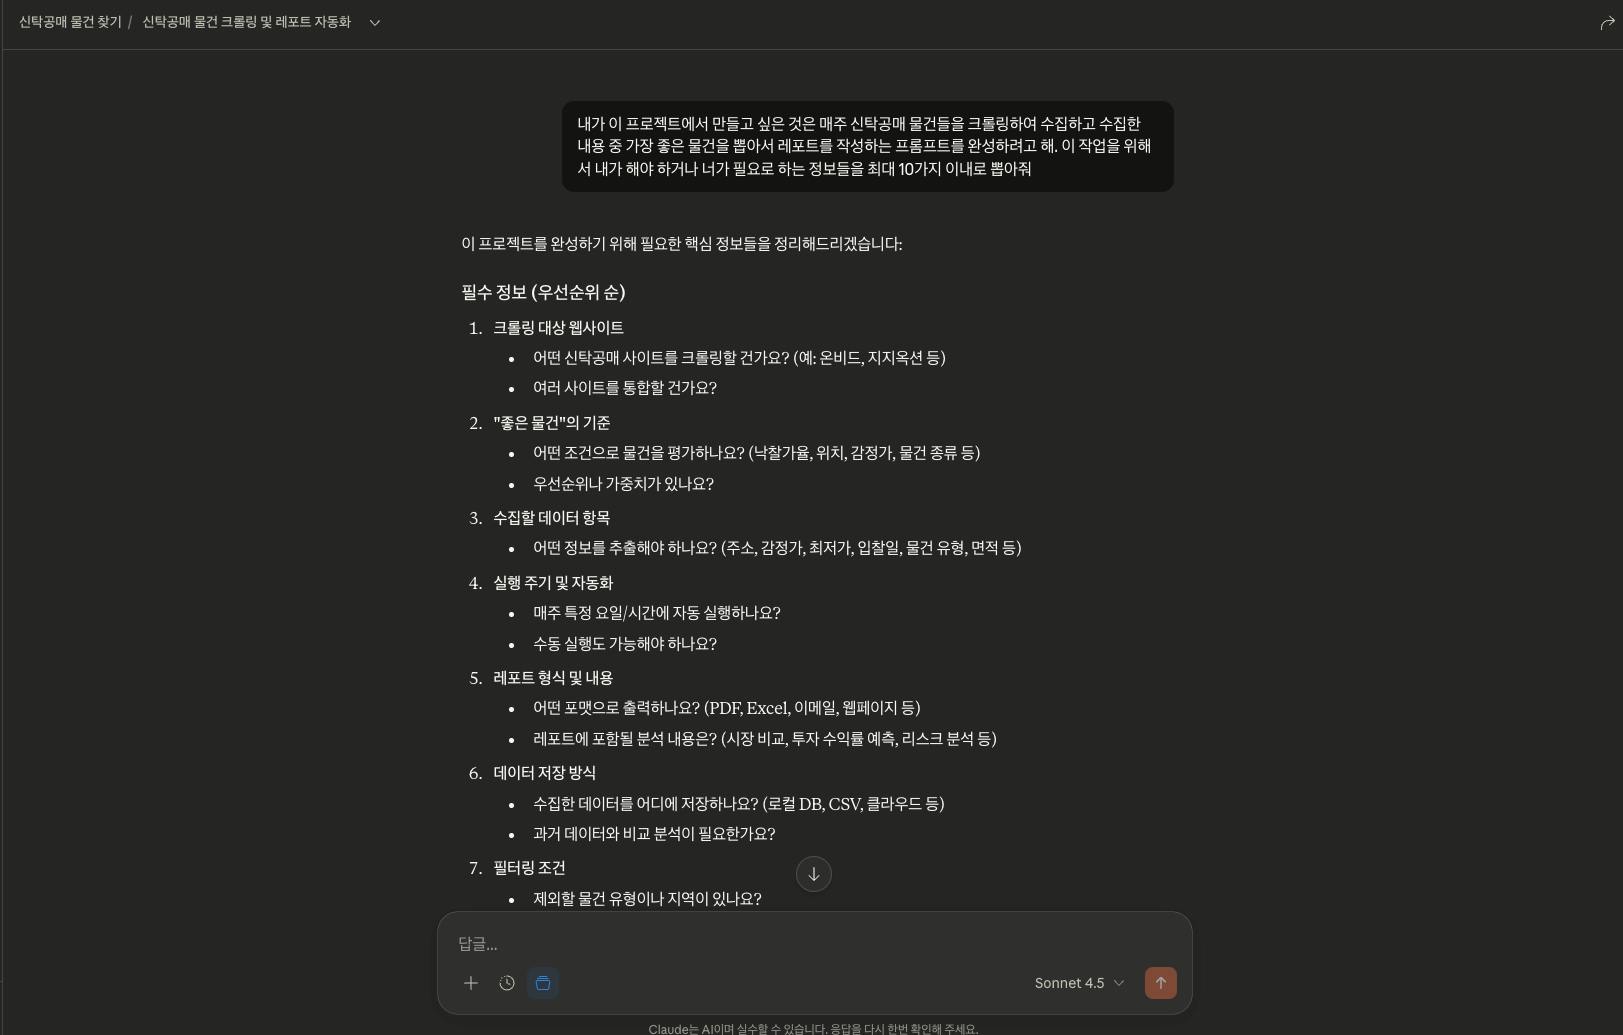
사용 프롬프트 전문(로그)
# 신탁공매 크롤러 개발 로그
## 프로젝트 개요
신탁사 14곳의 공매 물건을 자동으로 수집하고, 필터링하여 상위 5개 물건을 Obsidian 레포트로 생성하는 시스템
작업 기간: 2026-01-19
프로젝트 경로: /Users/igon/Downloads/trust_auction_crawler
## 주요 요구사항
1. 크롤링 대상: 14개 신탁사 웹사이트
2. 수집 조건: 조회 시점 기준 10일 이내 등록된 공매 물건
3. 필터링 조건:
- 1회차 최저입찰가 20억 이하
- 아파트/상가/오피스텔만
4. 우선순위: 서울 아파트 > 수도권 아파트 > 서울 상가 > ...
5. 결과물: Obsidian 마크다운 레포트 (상위 5개)
6. 자동 실행: 매주 토요일 오전 6시
## 프로젝트 구조
```
trust_auction_crawler/
├── config.py # 신탁사 URL, 필터링 조건, 우선순위
├── utils.py # 유틸리티 함수
├── pdf_parser.py # PDF/HWP 공매공고문 파싱
├── crawlers.py # 범용 크롤러
├── filter.py # 필터링 및 우선순위 정렬
├── naver_api.py # 네이버 지도/부동산 URL 생성
├── report_generator.py # Obsidian 마크다운 레포트 생성
├── main.py # 메인 실행 스크립트
├── shinhan_ocr_crawler.py # 신한부동산신탁 전용 크롤러 (OCR)
├── shinhan_final_crawler.py # 신한부동산신탁 (HWP 파싱)
└── requirements.txt # 의존성 패키지
```
## 기술 스택
- 웹 크롤링: Playwright (비동기 브라우저 자동화)
- PDF 파싱: pdfplumber
- HWP 파싱: pyhwp, hwp5txt 명령어
- OCR: pytesseract, tesseract
- 이미지 처리: PIL (Pillow)
- 비동기: asyncio, aiohttp
- 정규표현식: re
## 개발 진행 상황
### Phase 1: 기본 구조 완성 ✅
- 8개 핵심 파일 생성
- 14개 신탁사 URL 설정
- 범용 크롤러 구현
- 필터링 및 레포트 생성 로직 구현
첫 실행 결과:
- 107개 물건 수집
- 0개 통과 (가격 정보 추출 실패)
### Phase 2: 신한부동산신탁 집중 🔄
사용자 피드백을 통해 요구사항 명확화:
- 목록 페이지에서 10일 이내 물건 필터링
- 상세 페이지 접속하여 가격/일정 추출
- 상세 페이지에 정보 없으면 PDF/HWP 다운로드
발견된 문제:
1. 신한부동산신탁은 가격 정보가 이미지로 제공됨
2. HWP 파일에는 표 형식으로 회차별 정보 있음
### Phase 3: OCR 구현 🔄
설치한 패키지:
```bash
pip3 install pytesseract Pillow
brew install tesseract tesseract-lang
pip3 install pyhwp
```
OCR 전처리 파이프라인:
1. 이미지 그레이스케일 변환
2. 대비 증가 (contrast × 2)
3. 선명도 향상 (SHARPEN 필터)
4. pytesseract.image_to_string()
가격 추출 정규식:
```python
r'(\d{1,3}[.,]\d{3}[.,]\d{3}[.,]?\d{0,3})'
```
날짜 추출 정규식:
```python
r'(20)?(\d{2})[/.\-](\d{1,2})[/.\-](\d{1,2})'
```
## 주요 코드 스니펫
### 1. 목록 페이지 크롤링 (10일 이내 필터링)
```python
cutoff_date = datetime.now() - timedelta(days=10)
for idx, item in enumerate(items[:30], 1):
item_text = await item.inner_text()
# 물건 유형 체크
property_type = None
if '아파트' in item_text:
property_type = '아파트'
elif '상가' in item_text or '근린' in item_text:
property_type = '상가'
elif '오피스텔' in item_text:
property_type = '오피스텔'
if not property_type:
continue
# 공고일 확인
if '공고일' in item_text:
date_match = re.search(r'(\d{4})\.\s*(\d{1,2})\.\s*(\d{1,2})', item_text)
if date_match:
year, month, day = date_match.groups()
post_date = datetime(int(year), int(month), int(day))
if post_date < cutoff_date:
print(f" 물건 {idx}: {property_type} - 공고일 {post_date.date()} (10일 초과)")
continue
```
### 2. 이미지 OCR 가격 추출
```python
async def extractfrom_images(self, page) -> List[Dict]:
"""이미지에서 OCR로 가격 정보 추출"""
images = await page.query_selector_all('img')
for i, img in enumerate(images):
bbox = await img.bounding_box()
if not bbox or bbox['width'] < 500:
continue
# 이미지 스크린샷
img_path = os.path.join(self.temp_dir, f'img_{i}.png')
await img.screenshot(path=img_path)
# OCR로 텍스트 추출
text = self._ocr_image(img_path)
# 가격 추출
rounds = self._extract_prices_from_text(text)
if rounds:
return rounds
return []
```
### 3. OCR 이미지 전처리
```python
def ocrimage(self, img_path: str) -> str:
"""이미지 OCR (전처리 포함)"""
try:
img = Image.open(img_path)
# 그레이스케일
img = img.convert('L')
# 대비 증가
enhancer = ImageEnhance.Contrast(img)
img = enhancer.enhance(2)
# 선명도
img = img.filter(ImageFilter.SHARPEN)
# OCR
text = pytesseract.image_to_string(img, lang='eng', config='--psm 6')
return text
except Exception as e:
return ""
```
### 4. OCR 텍스트에서 회차별 정보 추출
```python
def extractprices_from_text(self, text: str) -> List[Dict]:
"""OCR 텍스트에서 회차별 가격과 일정 추출"""
rounds = []
lines = text.split('\n')
round_num = 0
for line in lines:
# 큰 금액이 있는지 확인 (억 단위)
price_match = re.search(r'(\d{1,3}[.,]\d{3}[.,]\d{3}[.,]?\d{0,3})', line)
if not price_match:
continue
price_str = price_match.group(1).replace(',', '').replace('.', '')
try:
price = int(price_str)
# 1억 ~ 1000억 범위
if not (100_000_000 <= price <= 100_000_000_000):
continue
except ValueError:
continue
# 금액이 있으면 회차 번호 추정 (순서대로 1, 2, 3...)
round_num += 1
# 날짜 찾기
date_match = re.search(r'(20)?(\d{2})[/.\-](\d{1,2})[/.\-](\d{1,2})', line)
auction_date = ''
if date_match:
year_prefix = date_match.group(1) or '20'
year = year_prefix + date_match.group(2)
month = date_match.group(3).zfill(2)
day = date_match.group(4).zfill(2)
auction_date = f"{year}-{month}-{day}"
rounds.append({
'round': round_num,
'price': price,
'start_date': auction_date,
'open_date': auction_date,
'unit': '',
'area': 0,
'area_pyeong': 0,
'tenant': ''
})
# 회차 번호로 정렬
rounds = sorted(rounds, key=lambda x: x['round'])
# 중복 제거 (같은 회차면 큰 금액 선택)
unique_rounds = {}
for r in rounds:
round_num = r['round']
if round_num not in unique_rounds or r['price'] > unique_rounds[round_num]['price']:
unique_rounds[round_num] = r
# 리스트로 변환
final_rounds = [unique_rounds[i] for i in sorted(unique_rounds.keys())]
return final_rounds
```
### 5. HWP 파일 다운로드 및 파싱
```python
async def downloadand_parse_hwp(self, page) -> Optional[Dict]:
"""HWP 다운로드 및 파싱"""
try:
# HWP 파일명이 있는 요소 찾기
hwp_elements = await page.locator('text=/\\.hwp$/i').all()
if not hwp_elements:
print(" HWP 파일 없음")
return None
for hwp_elem in hwp_elements:
text = await hwp_elem.inner_text()
if '공매공고' in text or '공매' in text:
print(f" HWP 다운로드: {text}")
# 다운로드
async with page.expect_download(timeout=10000) as download_info:
await hwp_elem.click()
download = await download_info.value
hwp_path = os.path.join(self.download_dir, f"temp_{os.getpid()}.hwp")
await download.save_as(hwp_path)
# HWP 파싱
hwp_data = self._parse_hwp_file(hwp_path)
# 파일 삭제
os.remove(hwp_path)
return hwp_data
return None
except Exception as e:
print(f" HWP 다운로드 오류: {e}")
return None
def parsehwp_file(self, hwp_path: str) -> Dict:
"""HWP 파일 파싱"""
try:
# hwp5txt로 텍스트 추출
result = subprocess.run(
['hwp5txt', hwp_path],
capture_output=True,
text=True,
timeout=30
)
if result.returncode != 0:
return {}
text = result.stdout
# 데이터 파싱
data = {
'address': self._extract_address(text),
'property_type': self._extract_property_type(text),
'rounds': self._extract_auction_info(text),
}
return data
except Exception as e:
print(f" HWP 파싱 오류: {e}")
return {}
```
## 발생한 문제 및 해결
### 문제 1: lxml 빌드 실패
원인: lxml==4.9.3이 Python 3.14에서 컴파일 실패
해결: requirements.txt에서 lxml 제거
### 문제 2: 범용 크롤러가 가격 0원 추출
원인: 사이트마다 구조가 달라 범용 크롤러로 불가능
해결: 신탁사별 전용 크롤러 구현 방식으로 변경
### 문제 3: 신한부동산신탁 가격 정보가 이미지
원인: 상세 페이지에 가격이 텍스트가 아닌 이미지로 제공
해결: pytesseract OCR 도입
### 문제 4: OCR 결과 불일치
현상:
- 첫 실행: 3개 회차 (90억, 31억, 75억)
- 두 번째 실행: 2개 회차 (90억, 75억)
- 세 번째 실행: 1개 회차 (4억)
시도한 해결책:
- 이미지 전처리 강화
- 최소 금액 기준 상향 (1천만원 → 1억원)
- 회차 번호 직접 인식 대신 순서대로 번호 부여
현재 상태: 여전히 불안정, 추가 개선 필요
## 테스트 결과
### 신한부동산신탁 OCR 크롤러 테스트
```bash
python3 shinhan_ocr_crawler.py
```
결과:
- 12개 물건 발견
- 1개 수집 완료: 충청남도 천안시 두정역 밸리온 오피스텔
- 1회차: 410,000,000원 (2020-01-21)
실제 웹사이트 확인:
- 동일 물건에 3개 회차 존재:
- 1회: 90,963,200,000원
- 2회: 31,888,000,000원
- 3회: 75,410,000,000원
- OCR이 일부만 인식함
## 남은 작업
### 우선순위 높음
1. 신한부동산신탁 OCR 정확도 개선
- 다양한 OCR 설정 시도 (lang='kor+eng', PSM 모드 변경)
- 이미지 전처리 추가 실험
- 또는 HWP 파싱으로 대체 고려
2. 나머지 13개 신탁사 크롤러 구현
- KB부동산신탁
- 한국토지신탁 (HWP)
- 나머지 12곳 (PDF)
### 우선순위 중간
3. 전체 시스템 통합 테스트
- 모든 크롤러를 main.py에 통합
- 14개 신탁사 동시 실행 테스트
4. 네이버 URL 생성 기능 완성
- 네이버 지도 URL 생성
- 아파트만 네이버 부동산 URL 생성
### 우선순위 낮음
5. 자동 실행 설정
- Cron 작업 설정 (매주 토요일 오전 6시)
- 로그 파일 관리
## 실행 방법
### 환경 설정
```bash
cd /Users/igon/Downloads/trust_auction_crawler
# 가상환경 생성 (선택)
python3 -m venv venv
source venv/bin/activate
# 의존성 설치
pip3 install -r requirements.txt
playwright install chromium
# Tesseract 설치 (OCR)
brew install tesseract tesseract-lang
# pytesseract 설치
pip3 install pytesseract Pillow
# pyhwp 설치 (HWP 파싱)
pip3 install pyhwp
```
### 크롤러 실행
```bash
# 전체 크롤러 실행 (현재 미완성)
python3 main.py
# 신한부동산신탁 OCR 크롤러
python3 shinhan_ocr_crawler.py
# 신한부동산신탁 HWP 크롤러
python3 shinhan_final_crawler.py
```
## 참고 링크
- 신한부동산신탁: https://www.shinhantrust.kr/biz-information/auction-properties?category=all
- Playwright 문서: https://playwright.dev/python/
- pytesseract 문서: https://pypi.org/project/pytesseract/
- pdfplumber 문서: https://github.com/jsvine/pdfplumber
## 다음 세션 작업 계획
1. 신한부동산신탁 OCR 정확도 개선 재시도
- 다양한 OCR 설정 실험
- 또는 HWP 파싱으로 완전 전환
2. 성공 시, 다른 신탁사(PDF 사용) 크롤러 구현 시작
- KB부동산신탁 우선 시도
3. 2개 신탁사 완성 후 전체 시스템 통합 테스트
## 메모
- OCR 정확도가 불안정하여 HWP 파싱이 더 안정적일 수 있음
- 신한부동산신탁도 HWP 파일이 있으므로 OCR 대신 HWP 파싱으로 전환 고려
- 14개 신탁사 모두 개별 크롤러가 필요할 것으로 예상 (사이트 구조가 모두 다름)
Tip: 사용한 프롬프트 전문을 꼭 포함하고, 내용을 짧게 소개해 주세요.
Tip: 활용 이미지나 캡처 화면을 꼭 남겨주세요.
Tip: 코드 전문은 코드블록에 감싸서 작성해주세요. ( / 을 눌러 '코드 블록'을 선택)
(내용 입력)
결과와 배운 점
결과는 역시 초심자의 행운이 없었던 대 실패였습니다 ㅠㅠ 일단 크롤링을 위해서는 단계별로 지침을 주었어야 했는데 지침 자체가 너무 추상적이었던 것 같아요.
신탁 공매 사이트가 총 14군데 인데 사이트마다 구조가 너무 달랐던 것이 일단 기본적으로 문제였네요....
어떤 사이트는 iframe안에 pdf파일을 올려놓은 곳도 있고 어떤 곳은 아예 공매 정보를 사이트 페이지 내에 작성하지 않고 첨부파일로만 올려둔 곳도 있고요. 그리고 첨부파일도 hwp파일로 올린 곳도 있고요 ㅠㅠ
이런 정보들을 미리 분석해서 클로드에게 제대로 지침을 내려야 할 필요를 느꼈습니다. 이를 위해서는 14개 사이트를 각각 분석해서 하나씩 만들어서 나중에 이를 합치는 작업이 오히려 효율적이겠다 생각이 들더라고요. 한꺼번에 14개 사이트를 크롤링 하는 작업을 하다보니 클로드가 많이 헷갈려 하는 것 같습니다.
앞으로는 작업 단위를 쪼개서 하나씩 구현하는 방식으로 진행해서 원하는 결과물을 내도록 노력해보겠습니다.
도움 받은 글 (옵션)
(내용 입력)
로그인하고 댓글을 남겨 주세요

AI가 접근할수 있는지부터 확인이 필요하고
홈페이지 주소만 줄게 아니라 크롤링 해야할 데이터가 있는 위치의 주소와 규칙들까지 상세하게 분석해야해요
처음부터 너무 난이도 높은 작업을 선택하신듯 한데 한번에 다하려 하지마시고 단계적으로 쪼게서 조금씩 시도해보세요

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

데이터 수집하실 때 한번에 모든걸 처리하기 보다는, 단계적으로 수집하시는 걸 추천드립니다. 제대로 데이터가 수집되는지 검증은 필수고요. 캠코 공매물건은 PublicDataReader Library에서 API로 수집하실 수 있습니다.
라이브러리가 있으면 굳이 크롤링 할 필요는 없을 것 같긴 하네요! 좋은 정보 공유 감사합니다~