지식 허브를 문서 링크망과 온톨로지 기준으로 점검하기
2026.10.06
소개
제 지식 허브의 노트 141개를 1주차 강의가 가른 LLM Wiki와 온톨로지 기준으로 세어, 링크 326건은 이어져 있지만 뜻이 붙은 관계는 0건이라는 것을 확인하고 결정 노트 하나를 작은 온톨로지로 옮겨 돌려 보았습니다. 노트를 꾸준히 링크해 왔는데 그다음 단계가 무엇인지 궁금한 분께 권합니다.
제 지식 허브(~/knowledge-hub)의 운영층은 23기에 DECK 스터디장의 AKM 구조를 보고 만들었습니다. source, context, memory, evolution, decisions 레인이 그때 생겼습니다. 이번 기수는 같은 스터디장이 "LLM Wiki에서 온톨로지까지"를 제목으로 걸었으니, 그 허브가 지금 어느 단계에 있는지 물어볼 때가 됐다고 봤습니다.
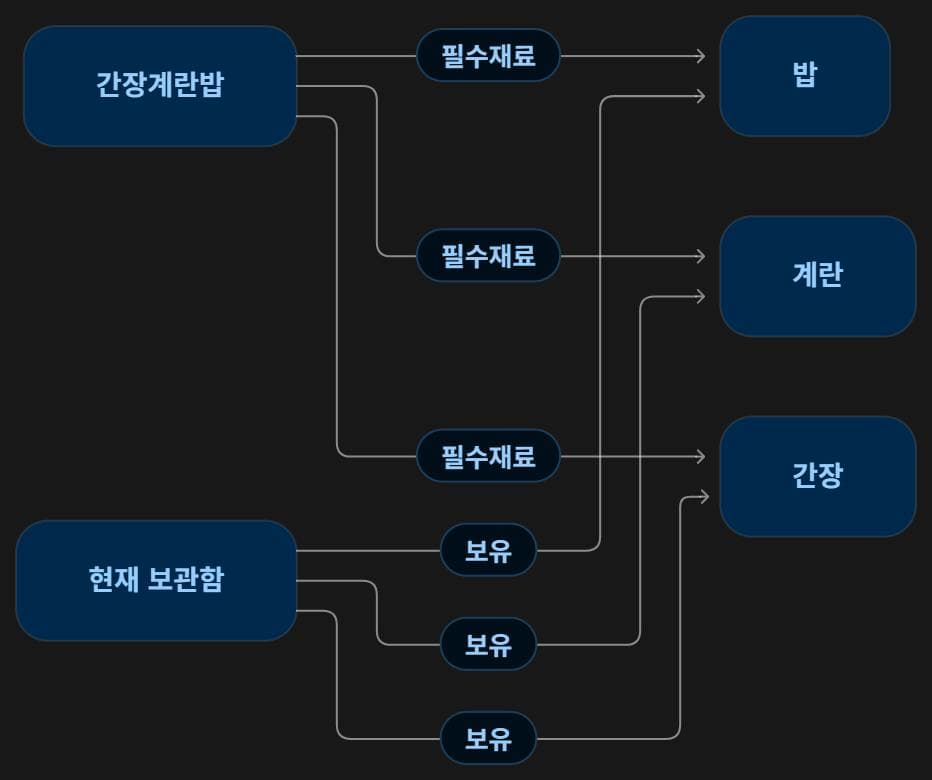
1주차 강의가 두 단계를 갈랐습니다. LLM Wiki는 "AI에게 다시 질문하지 않기 위해 질문한 것의 기록을 남기는" 문서 링크망이고, 온톨로지는 "간장달걀밥이 존재하려면 무엇이 필요한지"를 종류, 대상, 이름 붙은 관계, 판단 규칙으로 적어 조건을 넣으면 무엇이 성립하는지 판단하는 체계입니다. 시연 중 코덱스 화면에는 "관련 문서 사이 링크와 '필요로 한다, 보유한다' 같은 의미 관계를 구분하라"는 지시가 떠 있었습니다.
그래서 이번 주는 그 구분으로 제 허브를 재기로 했습니다. 노트에 종류가 선언되어 있는지, 링크망이 이어져 있는지, 링크에 뜻이 붙어 있는지, 판단 규칙이 프로그램으로 돌릴 수 있는 형태인지. 지난 화요일 AX 코칭 사례글에서 같은 허브의 출처 비율과 커밋 상태를 쟀으니, 그 수치는 다시 쓰지 않고 구조만 봤습니다.
진행 방법
사용 도구: Claude Code, Python 3
범위
구분 | 개수 |
|---|---|
허브 안 md 파일 | 765개 |
노션 덤프( | 604개. 회사 기밀 경계라 개수만 세고 내용은 열지 않았습니다 |
| 4개 제외 |
레인 목차 | 16개 제외 |
측정 대상 노트 | 141개 |
141개는 다시 둘로 갈립니다. 제가 합성해 쓴 레인 53개(literature 16, projects 14, playbooks 10, MOCs 3, pointers 3, meta 3, evolution 2, decisions 1, context 1)와 발행물과 작업 파일 88개(publications 80, presentations 1, private 4, 루트 3)입니다. 한글 경로는 NFC로 정규화하고 집계는 전부 Python으로 했습니다.
Step 1. 종류가 선언되어 있는가
온톨로지의 첫 재료는 종류입니다. 요리 예제에서는 요리, 재료, 보관함이었고, 코덱스 화면의 프론트매터에는 akmType: concept이 있었습니다. 제 허브의 프론트매터를 셌습니다.
FM = re.compile(r'\A---\n(.*?)\n---', re.S)
for p in notes:
    m = FM.match(p.read_text(encoding='utf-8', errors='ignore'))
    d = dict(re.findall(r'^([A-Za-z_][\w-]*):\s*(.*)$', m.group(1), re.M)) if m else {}
구분 | 합성 레인 53개 | 발행물과 작업 파일 88개 |
|---|---|---|
프론트매터 있음 | 53개 (100%) | 16개 (18%) |
| 53개 (100%) | 14개 |
| 각 53개 (100%) | 8개, 7개 |
| 각 40개 (75%) | 8개, 3개 |
합성 레인은 OKF 규약의 유일한 필수 항목 type을 전부 갖추고 있었습니다. 그런데 type 값을 모아 보니 analysis 16, project 14, playbook 13, pointer 3, moc 3, meta 2, note 1, decision 1이었습니다. 이것은 노트의 형식을 가르는 값이지, 강의가 말한 종류가 아닙니다. 요리 온톨로지에서 "요리"와 "재료"가 갈리듯 제 분야에서 "모델 계열"과 "데이터셋"과 "규제 문서"가 갈려야 하는데, 그런 종류는 어느 프론트매터에도 없었습니다. tags는 고유값이 66개(AI 33, 바이오제약 13, 문헌 12, 파운데이션모델 11 순)로, 분류는 태그가 떠안고 있었습니다.
Step 2. 링크망이 이어져 있는가
LLM Wiki의 조건은 문서가 서로 링크로 이어지고 index에 기록되는 것입니다. 마크다운 링크를 해석해 들어오는 링크와 나가는 링크를 셌습니다.
LINK_MD = re.compile(r'\]\(([^)\s]+?\.md)(?:#[^)]*)?\)')
for p in notes + index_files:
    body = FM.sub('', p.read_text(encoding='utf-8', errors='ignore'), count=1)
    targets = {resolve(p, t) for t in LINK_MD.findall(body)} - {None, p.resolve()}
    for r in targets: inbound[r] += 1
항목 | 값 |
|---|---|
마크다운 | 326건 |
위키링크 | 12건 |
깨진 링크 | 8건. 그중 3건은 index 안내 주석의 자리표시( |
노트에서 노트로 가는 링크 | 184건. 합성 레인 안에서 152건, 노트당 평균 3.9건 |
들어오는 링크가 없는 노트 | 66개 (publications 60, private 4, meta 1, 루트 1) |
나가는 링크가 없는 노트 | 76개 (publications 67) |
MOC 3개가 가리키는 노트 | 20개 / 비MOC 노트 138개 (14%) |
들어오는 링크 상위 | MOCs/ai-research-production 15, literature/bio-foundation-models 13, projects/paper-analysis-harness 10, _meta/router 10 |
합성 레인 53개 가운데 들어오는 링크가 없는 노트는 _meta/success-formula.md 하나, 나가는 링크가 없는 노트는 projects/niep.md와 pointers/company-scrna.md 둘이었습니다. 이 53개는 링크망이 이어져 있습니다. 반면 publications 80개는 60개가 어디서도 들어오지 않고 67개가 어디로도 나가지 않습니다. BRIC 리포트의 절 파일, 출처 분석, 링크드인 초안이 거기 있습니다. 발행 작업물은 링크망 밖에 있고, 그것이 지난 기수에 "노트 103개 중 58개가 한 레인에 있다"고 적은 그 레인입니다.
Step 3. 링크에 뜻이 붙어 있는가
여기가 강의가 그은 선입니다. 요리 예제의 화살표에는 "필요로 한다"가 적혀 있고, 코덱스 지시문은 "관련 문서 링크와 의미 관계를 구분하라"고 했습니다. 세 가지를 셌습니다.
REL_KEYS = {'related','relations','depends_on','supersedes','superseded_by','part_of','requires', ...}
fm_rel = [p for p, d in fm_data.items() if REL_KEYS & set(d.keys())]
TYPED = re.compile(r'(필요로 한다|보유한다|의존한다|선행한다|대체한다|포함한다|requires|depends on|part of)')
typed = [l for p in notes for l in body(p).split('\n') if LINK_MD.search(l) and TYPED.search(l)]
항목 | 값 |
|---|---|
프론트매터에 관계 필드가 있는 노트 | 1개 ( |
본문에 "관련:" 줄로 이름 없이 묶은 노트 | 24개 |
링크와 관계 동사가 같은 줄에 있는 경우 | 0건 |
링크 326건의 문맥을 무작위로 뽑아 보면 이렇습니다. "관련: [PharmaSignal] · [반출 금지 경로에 폴백을 두지 않는다]", "- [서열·유전체 계열], DNA 언어모델", "프로젝트 자체는 [AutoBioX]에 있고". 전부 "이 문서도 보라"는 뜻이고, 무엇이 무엇을 필요로 하는지, 무엇이 무엇에 속하는지는 어디에도 적혀 있지 않습니다. 예외는 superseded_by 하나인데, 그것도 문서가 문서를 대체한다는 관계라 도메인 대상 사이의 관계는 아닙니다.
Step 4. 판단 규칙이 돌아가는 형태인가
온톨로지의 세 번째 재료는 "재료가 다 있으면 가능, 없으면 불가능"처럼 조건을 넣으면 답이 나오는 규칙입니다. 조건문 표현("이면", "일 때", "조건", "판정 기준")이 5회 이상 나오는 노트를 골랐습니다.
노트 | 횟수 | 성격 |
|---|---|---|
| 8 | G1~G5 통과 조건 표. 사람이 읽는 체크리스트 |
| 5~12 | 리포트 원고의 산문 |
합성 레인에서 규칙 문서는 품질 게이트 하나이고, 라우팅 표(_meta/router.md)와 fail-closed 결정(decisions/fail-closed-sensitive-routing.md)도 조건과 결과를 적고 있습니다. 셋 다 표와 산문입니다. 조건을 바꿔 넣고 돌려 볼 수 있는 형태로 적힌 규칙은 0건입니다.
Step 5. 23기에 만든 운영층은 어디에 해당하는가
23기에 만든 레인 | 노트 수 | 스터디장의 AKM 폴더 | 이번 강의 기준에서 |
|---|---|---|---|
source | 0 (노션 덤프 604개는 별도) | 10-sources | 저장 위치 |
context | 1 | 30-context | 저장 위치 |
memory | 0 | 40-memory | 저장 위치 |
evolution | 2 | 70-evaluation | 저장 위치. 규칙 문서 1개 포함 |
decisions | 1 | 해당 폴더 없음 | 저장 위치 |
레인은 "어디에 두는가"에 답합니다. 23기 강의가 다룬 층 나누기는 그것으로 충분했습니다. 이번 강의는 나눈 뒤의 문제를 다룹니다. 스터디장조차 "가드레일을 촘촘하게 세워 놨는데도 어떤 걸 읽어야 되는지 꼬인다"고 했고, 그래서 읽을 문서를 고르는 결정 모델(Jev)을 붙였습니다. 제 허브는 아직 그 앞 단계에 있습니다. 레인 5개 중 둘은 비어 있고, 채워진 셋에도 관계와 규칙은 산문으로만 있습니다.
Step 6. 강의가 권한 크기로 하나 옮겨 봤습니다
실습 페이지의 안내는 "자기 도메인은 판단 하나, 자료 3~5개, 질문 3개부터"였고, 코덱스 화면은 "종류 2~3개, 대상 5~8개, 관계 2종"이었습니다. 허브의 결정 노트 하나를 그 크기로 옮겼습니다. 판단은 "민감 문서를 어느 추론 경로로 보낼 수 있는가"이고, 근거는 허브 노트 4개(결정, 문헌, 프로젝트, 조용한 실패 유형)입니다.
재료 | 만든 것 |
|---|---|
종류 | 문서(민감도), 경로(상용 제공자 여부, 제3자 인프라 여부, 가용 여부), 원장 |
대상 | 문서 3개, 경로 3개, 원장 1개 |
관계 | "요구한다" 2건, "보낸다" 1건, "거친다" 1건, "기록된다" 1건 |
규칙 | public이면 모든 경로, restricted면 상용 경로 금지, 허용 경로가 없으면 포기하고 원장에 기록, 제3자 인프라를 거치면 "회사 밖으로 안 나갔다"고 말하지 못함 |
요리 예제에서 버터를 넣고 빼듯 경로의 가용 여부를 바꿔 돌렸습니다.
== 시나리오 2: 지정 엔드포인트(R2) 불가
  D2 사내 임상 문서  처리  allowed [R3]  주장: 상용 제공자에게 보내지 않음
== 시나리오 3: R2, R3 모두 불가
  D2 사내 임상 문서  포기  ledger L1에 기록
  D3 피험자 텍스트   포기  ledger L1에 기록
종류 3 개 | 대상 7 개 | 이름 붙은 관계 5 건 | 판단 규칙 4 개
결정 노트의 산문에서 "용어에서 조심할 것" 절에 따로 떨어져 있던 단서("마켓플레이스 경로는 회사 밖으로 안 나갔다고 말하면 안 된다")가, 경로의 속성으로 만들자 판단 결과에 자동으로 붙었습니다. 산출물은 24기AI지식관리_1주차_과제_소규모온톨로지.md에 두었고 허브 파일은 고치지 않았습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
측정 대상 노트 | 141개 (md 765개 중 노션 덤프 604개, index 16개, 설정 4개 제외) |
합성 레인 노트의 | 53 / 53개. 다만 값은 노트 형식(analysis, project, playbook) 8종 |
도메인 대상의 종류를 선언한 노트 | 0개 |
마크다운 링크 | 326건, 노트에서 노트로 184건 |
들어오는 링크가 없는 노트 | 66개. 합성 레인은 1개, publications가 60개 |
MOC가 가리키는 노트 | 20 / 138개 (14%) |
뜻이 적힌 관계 | 0건 (프론트매터 |
돌릴 수 있는 판단 규칙 | 0건. 규칙 문서는 표와 산문 3개 |
강의 크기로 옮긴 온톨로지 | 종류 3, 대상 7, 관계 5, 규칙 4. 시나리오 3개 통과 |
배운 점
제 허브는 LLM Wiki이고, 그 안에서도 합성 레인만 그렇습니다. 53개는 전부
type이 있고 서로 이어져 있으며 들어오는 링크가 없는 노트가 하나뿐입니다. 1주차 기준은 통과합니다. 그런데 publications 80개는 60개가 어디서도 들어오지 않습니다. 발행물은 목적지가 정해져 있어 링크 없이도 쓰이니 그동안 문제로 보이지 않았습니다.type이 있다고 종류가 있는 것은 아닙니다. OKF 필수 항목을 100% 채웠다고 안심했는데, 그 값은 "이 파일이 분석인가 절차인가"를 가를 뿐입니다. 강의의 요리 온톨로지에서 종류는 요리와 재료, 즉 도메인의 대상입니다. 제 분야의 대상(모델 계열, 데이터셋, 규제 문서, 추론 경로)은 태그 66개 속에 흩어져 있고 종류로 선언된 곳이 없습니다.링크 326건은 모두 "이 문서도 보라"입니다. 관계에 이름이 붙은 것이 0건이라는 숫자는 예상보다 분명했습니다. 저는 노트마다 "관련:" 줄을 성실히 적어 왔고, 그것이 연결이라고 생각했습니다. 강의는 그 줄과 "필요로 한다"를 구분하라고 했고, 구분하고 보니 제 허브에는 앞엣것만 있었습니다.
규칙을 산문에서 꺼내니 틀린 전제가 보였습니다. 품질 게이트와 라우팅 표와 fail-closed 결정은 전부 사람이 읽는 형태입니다. 결정 하나를 규칙 4개로 옮겨 돌렸더니 첫 실행에서 상용 API 경로에 "상용 제공자에게 보내지 않음"이라는 주장이 붙었습니다. 주장을 만드는 코드가 속성 하나만 보고 있었습니다. 산문으로 읽을 때는 당연해서 넘어갔을 전제가 출력 한 줄에서 드러났습니다. 스터디장이 "온톨로지는 판단을 남기는 절차"라고 한 말이 이 장면이었습니다.
23기에 만든 레인은 저장 위치이지 관계가 아닙니다. 같은 스터디장의 두 기수를 이어 들으니 제 허브가 어느 기수의 기준에 머물러 있는지 보였습니다. 층을 나누는 일은 했고, 나눈 것 사이의 관계와 규칙은 아직입니다.
시행착오
141개 전체로 프론트매터 비율을 내면 50%입니다. 프론트매터가 없는 publications 파일이 65개이고, 대부분 BRIC 리포트의 절 파일과 출처 분석이어서입니다. 합성 레인과 작업 파일을 갈라 다시 세니 100%와 18%였습니다. 두 숫자를 다 적었습니다.
type값이 전체에서 18종 나와 "종류 18개"로 적을 뻔했습니다. 합성 레인은 8종이고, 전부 노트 형식입니다.깨진 링크 8건 중 3건은 "새 노트를 만들면
[제목](/MOCs/파일.md)한 줄로 추가"라는 안내 주석의 자리표시였습니다. 실제로 깨진 것은 5건입니다.소규모 온톨로지의 첫 실행에서 주장 문구가 틀렸습니다. 위에 적은 대로 고쳤습니다.
이 측정은 2026년 10월 2일 ~/knowledge-hub 안의 md 파일 765개 가운데 노션 덤프 604개를 제외한 141개 노트와 index 16개의 본문, 그리고 그 안의 링크 326건을 Python으로 센 결과입니다. 노션 덤프의 내용과 다른 기기의 자료는 보지 않았습니다.
도움 받은 글 (옵션)
24기 AI지식관리 1주차 강의 (DECK, 묘랑): LLM Wiki와 온톨로지의 구분, 요리 온톨로지 예제의 종류, 관계, 판단 규칙, "관련 문서 링크와 의미 관계를 구분하라"는 실습 지시, 시작 크기(판단 하나, 자료 3~5개, 질문 3개), AKM 볼트에 Jev를 붙여 읽을 문서를 고르게 한 사례
23기 AI지식관리 1주차 사례글 (본인): 이번에 잰 운영층 레인(source, context, memory, evolution, decisions)을 2026-07-29에 만든 기록. 그때는 층을 나누는 것이 기준이었고 이번에는 나눈 것 사이의 관계가 기준입니다
24기 AX 코칭 1주차 사례글 (본인): 같은 허브의 출처 비율과 커밋 상태를 잰 글. 수치가 겹치지 않도록 이번에는 구조만 쟀습니다

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


예전에 제가 써 둔 결정 이유를 나중에는 사실처럼 읽을 수도 있겠다는 생각이 들었어요. 시간이 흐르면 왜 그 말을 적었는지는 잊고 문장만 남을 수도 있겠네요.