검수 에이전트 정의의 쓰기 권한과 실제 수정 이력 점검하기
2026.10.22
소개
제 검수 에이전트 정의 14개 가운데 파일을 쓸 수 있는 도구를 가진 11개가 실제로 파일을 고쳤는지, 그리고 검수 호출 뒤에 수정이 이어졌는지를 세션 로그로 확인했습니다. 검수 에이전트를 만들어 두기만 하고 권한과 실제 사용을 점검해 보지 않은 분, 리뷰어를 다른 모델로 두라는 말을 들었지만 내 환경에서 그 리뷰가 무엇을 바꿨는지 궁금한 분이 읽으면 좋겠습니다. 측정은 2026-10-22에 했습니다.
3주차는 스터디장의 시연과 수강생 네 분의 발표로 진행됐습니다. 스터디장은 플랜 md를 쓰고 우로보로스 인터뷰, 시드, 런으로 하네스를 만드는 순서를 보여 주었고, 주식 분석 팀으로 Codex와 Claude가 서로의 노트를 감사하는 교차 검증을 시연했습니다. 하네스로 영상을 만들면서 결과가 마음에 들지 않을 때는 마스터에게 바로 피드백을 주고, 마음에 들면 "이 과정을 스킬과 하네스로 업데이트해 줘"라고 시켜 순환을 돌리라고 했습니다. 그렇게 쌓인 피드백이 가이드라인과 검수 기준이 되고, 부서를 껐다 켜도 리뷰어가 같은 기준을 쓰도록 영구 반영하라는 설명도 있었습니다. 수강생 발표에서는 Elly 님이 앱 개편 작업의 의사결정 대시보드를, 나나nana 님이 리뷰어를 다른 모델로 바꾼 브이로그 팀을, 망원궁예 님이 승인 단계가 있는 콘텐츠 파이프라인을, 공정표 님이 싱글과 멀티와 서브에이전트 검수의 비교를 소개했습니다.
저는 청강생이라 과제를 그대로 하지는 않았습니다. 지난 글에 망원궁예 님이 남긴 댓글이 이번 점검의 출발입니다. 리뷰어별 판정과 실제 반영 여부를 이어서 보면 모델을 나눈 효과가 더 분명해진다는 내용이었습니다. 그래서 검수 호출 뒤에 파일 수정이 이어졌는지를 센 뒤, 2주차 계획의 실행 여부와 같은 명령으로 다시 잰 값을 나란히 놓았습니다. 측정한 저장소와 설정 파일은 읽기만 했고, 검수 정의도 고치지 않았습니다. 새로 만든 것은 이 스터디 폴더 안의 검사 스크립트 하나와 그 시험입니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, 세션 로그(2026-08-30부터 남아 있는 586개), 자비스 전달 기록
Step 1. 강의 기준의 측정 항목 선정
3주차 강의와 발표에서 파일이나 로그로 셀 수 있는 말만 골랐습니다.
강의 기준 | 강의에서 나온 말(영상 시각) | 잴 것 |
|---|---|---|
피드백을 검수 기준으로 영구 반영 | "부서를 껐다 켜도 리뷰어가 계속 역할을 할 수 있게 영구적으로 업데이트해 줘"(01:10) | 검수 정의와 리뷰어 지침 파일의 수정 여부, 규칙 파일에 새로 붙은 날짜 줄 |
검수에는 다른 모델 | 리뷰어를 다른 모델로 두면 도움이 되었다는 발표, 스터디장의 "좋은 선택"(01:46) | 자비스 리뷰어 창의 모델 분포, 읽기 전용 |
검수를 붙이면 느려지니 쓸 기준이 필요 | 중요하지 않은 수정에도 멀티에이전트가 필요한지 묻는 발표(02:07) | 검수 호출 뒤 실제 수정이 이어졌는지 |
같은 일을 여러 조건에서 시험하고 전후 비교 | 업데이트할 때마다 전후를 비교해야 성능이 좋아졌는지 알 수 있다는 설명(02:16) | 2주차와 같은 명령으로 다시 잰 값, 검사 스크립트의 시험 |
이 가운데 세 번째가 이번 글의 중심입니다. 2주차 계획에 "검수 정의 14개 중 Write나 Edit가 있는 11개가 실제로 파일을 고쳤는지 로그에서 확인한다"는 항목이 있어서, 그 확인을 검수 호출 뒤의 수정 연결까지 넓혔습니다.
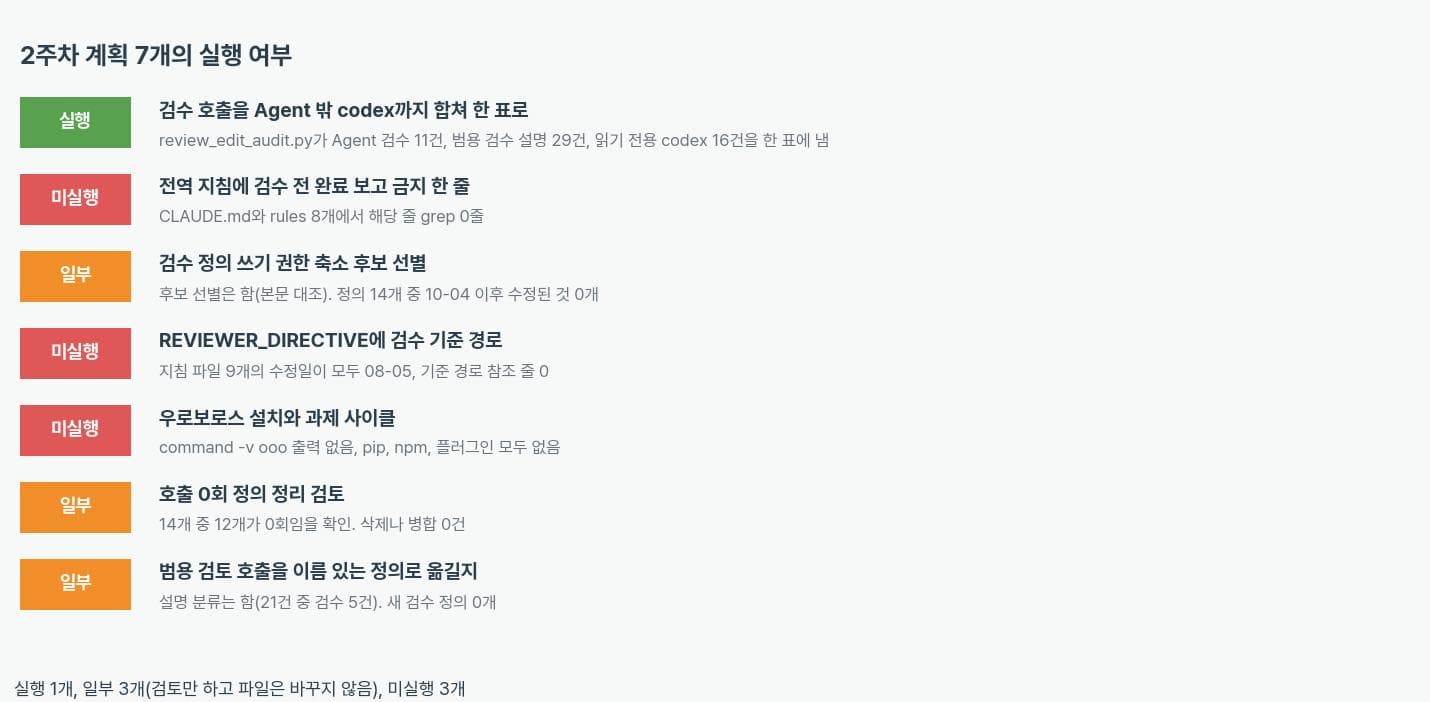
Step 2. 2주차 계획 7개의 실행 여부
2주차 글을 쓸 때 다음 주 계획으로 일곱 가지를 따로 적어 두었습니다. 항목마다 증거를 명령으로 확인했습니다.
grep -rn "생산 에이전트\|검수.*완료.*보고" ~/.claude/CLAUDE.md ~/.claude/rules/*.md   # (출력 없음)
stat -f '%Sm %N' -t '%Y-%m-%d' ~/.cys/pack/directives/*.md                        # 9개 모두 2026-08-05
command -v ooo ouroboros                                                          # (출력 없음)
검수 호출을 한 표로 합치는 일은 이 글의 스크립트로 했습니다. 전역 지침 한 줄, 리뷰어 지침의 검수 기준 경로, 우로보로스 설치와 과제 사이클은 하지 않았습니다. 검수 정의의 쓰기 권한 축소, 호출 0회 정의 정리, 범용 호출을 이름 있는 정의로 옮기는 일은 어디까지 필요한지 살펴보는 데서 멈췄고 파일은 바꾸지 않았습니다. 이번에는 ~/.claude 안의 정의를 고치지 않고 후보만 남겨 두었습니다.
Step 3. 검수 정의 14개의 쓰기 도구와 본문 대조
정의 파일의 tools: 줄은 세 가지로 갈렸습니다. Write나 Edit가 있는 것이 9개, tools: 줄이 없어 전체 도구를 쓰는 것이 2개, 읽기 전용이 3개입니다. 앞의 두 묶음을 합친 11개가 확인 대상입니다. 호출 수는 세션 로그에서 Agent 도구의 subagent_type으로 셌습니다.
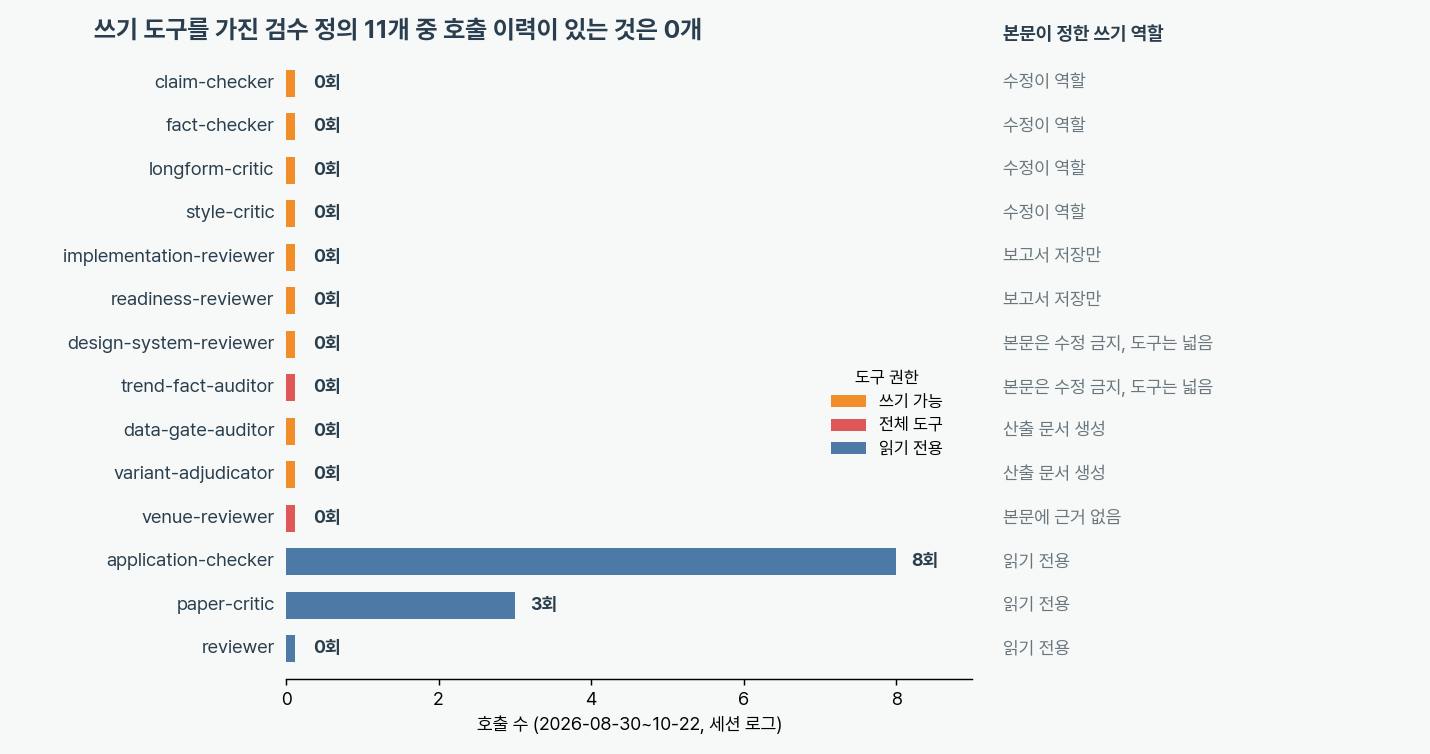
쓰기 도구를 가진 11개 정의는 로그에 한 번도 불린 기록이 없었습니다. 그래서 "실제로 고쳤는가"에는 고친 기록도 안 고친 기록도 없다는 답이 나옵니다. 대신 정의 본문에서 쓰기에 대해 적은 문장을 읽어 11개를 나누었습니다.
본문이 직접 수정을 지시한 것 4개: fact-checker, longform-critic, style-critic, claim-checker. 교정이 역할인 정의라 읽기 전용으로 바꾸면 일을 못 합니다. 이름에 critic이 붙어 있어도 하는 일은 교정입니다.
본문이 수정을 금지하고 Write는 자기 보고서 한 파일에만 쓰라고 한 것 2개: implementation-reviewer, readiness-reviewer. Edit가 이미 없어서 도구와 본문이 맞습니다.
본문은 수정하지 말라는데 도구가 더 넓은 것 2개: design-system-reviewer는 Edit가 들어 있고, trend-fact-auditor는
tools:줄이 없어 전체 도구입니다. 읽기 전용으로 바꿀 후보는 이 둘입니다.감사 결과 문서를 만들거나 이어 쓰는 것 2개: data-gate-auditor, variant-adjudicator. Write는 필요하고 Edit가 필요한지는 로그로 알 수 없습니다.
본문에 쓰기 허용도 금지도 적혀 있지 않은 것 1개: venue-reviewer(전체 도구).
읽기 전용 전환 후보는 확실한 것이 2개, 본문에 근거가 없어 제가 정해야 하는 것이 1개입니다.
Step 4. 시험 먼저 쓰기와 두 번의 보정
검수자가 고쳤다는 수를 어떻게 세는지가 결과를 좌우하므로, 스크립트(review_edit_audit.py)를 쓰기 전에 합성 로그로 시험을 먼저 만들었습니다. 합성 로그에는 사람이 손으로 센 답을 심었습니다. 검수자가 읽은 파일을 덮어쓰면 수정, 읽지 않은 새 파일에 쓰면 보고서 저장, 같은 tool_use id가 두 줄 기록되면 한 번만 세는 규칙입니다.
python3 -I -m pytest -q test_review_edit_audit.py    # 구현 전(빈 함수): 7 failed
python3 -I -m pytest -q test_review_edit_audit.py    # 구현 후: 7 passed
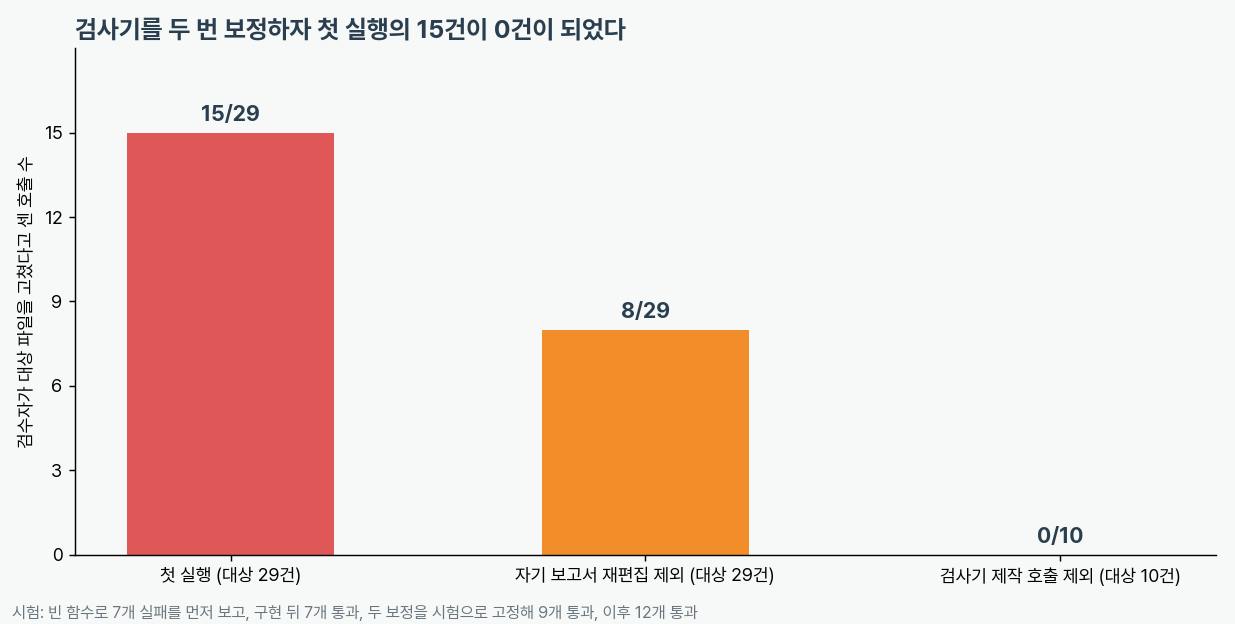
처음 실제 로그에 돌렸더니 범용 에이전트 중 검수 계열 단어가 설명에 든 호출 29건 가운데 15건에서 검수자가 파일을 고쳤다고 나왔습니다. 믿기 어려워 그중 Coach review라는 호출 세 건의 서브에이전트 로그를 열어 보았습니다. 세 건 모두 검토 결과 파일을 새로 만든 다음 그 파일을 다시 Edit한 기록이었습니다. 검수자가 자기 보고서를 다듬은 것을 대상 파일 수정으로 센 것입니다. 이 규칙을 시험으로 고정하자 15건이 8건으로 줄었습니다.
남은 8건의 설명은 Write check_proposal test-first, Fix techdoc and script per cross-check, Build check_anonymize and wiki candidates처럼 검사기나 문서를 쓰고 고치는 호출이었습니다. 설명에 check나 점검이 들어 있어 2주차와 같은 단어 목록에 걸렸을 뿐 검수 호출이 아닙니다. 설명이 Build, TDD, Write, Fix, Draft, Gate로 시작하거나 작성, 구현, 반영이 들어간 호출을 뺀 좁은 정의를 시험으로 고정하자 대상이 29건에서 10건이 되었고 검수자가 고친 호출은 0건이 되었습니다. 이어서 같은 호출이 이어받은 세션 파일에 두 번 기록된 경우를 거르는 시험, 검수가 아닌 Agent 호출의 기준선을 내는 시험, 검수가 끝난 뒤 다른 에이전트에게 수정을 맡긴 경우를 세는 시험을 더해 12개가 통과했습니다.
Step 5. 검수 호출 뒤 수정 연결
검수 호출을 세 종류로 나누었습니다. 이름 있는 검수 에이전트 11건, 범용 에이전트 중 검수 성격의 호출 10건, 다른 회사 모델에 읽기 전용으로 맡긴 codex exec 16건입니다. 호출이 끝난 뒤 30분 안에 호출한 쪽이 Edit나 Write로 고쳤거나 다른 에이전트에게 고치게 한 호출을 셌습니다.
python3 -I review_edit_audit.py --exclude <이 글을 만드는 세션> --out assets/검수수정_전체.json
수정은 어느 호출 뒤에나 자주 일어나므로 비교할 기준선이 필요합니다. 검수가 아닌 Agent 호출 478건을 같은 방식으로 세서 기준선으로 삼았습니다.
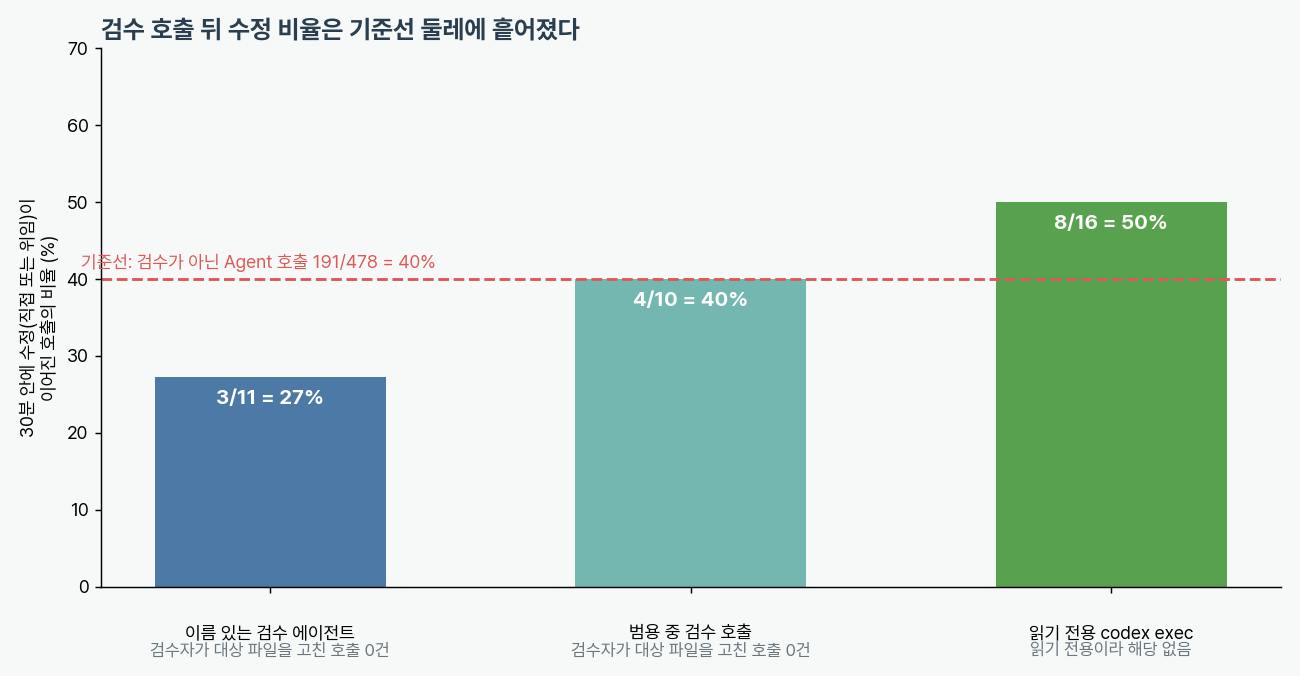
이름 있는 검수 호출 11건에서 검수자가 대상 파일을 고친 것은 0건이었고 새 보고서 파일을 저장한 것도 0건이었습니다. 호출 뒤 30분 안에 수정이 이어진 비율은 27%, 40%, 50%로 기준선 40% 둘레에 흩어졌습니다. 표본이 11건, 10건, 16건이라 이 차이를 효과로 읽을 수는 없습니다.
창을 10분과 120분으로 바꿔 다시 세어도 읽기 전용 codex exec 뒤의 수정만 기준선보다 계속 높았습니다. 다만 16건은 일곱 세션에 있고 수정이 뒤따른 8건은 그중 네 세션에 몰려 있어 표본이 서로 독립이 아닙니다. 또 codex exec는 결과문이 로그에 남지 않아 그 수정이 검수 지적을 반영한 것인지는 알 수 없습니다.
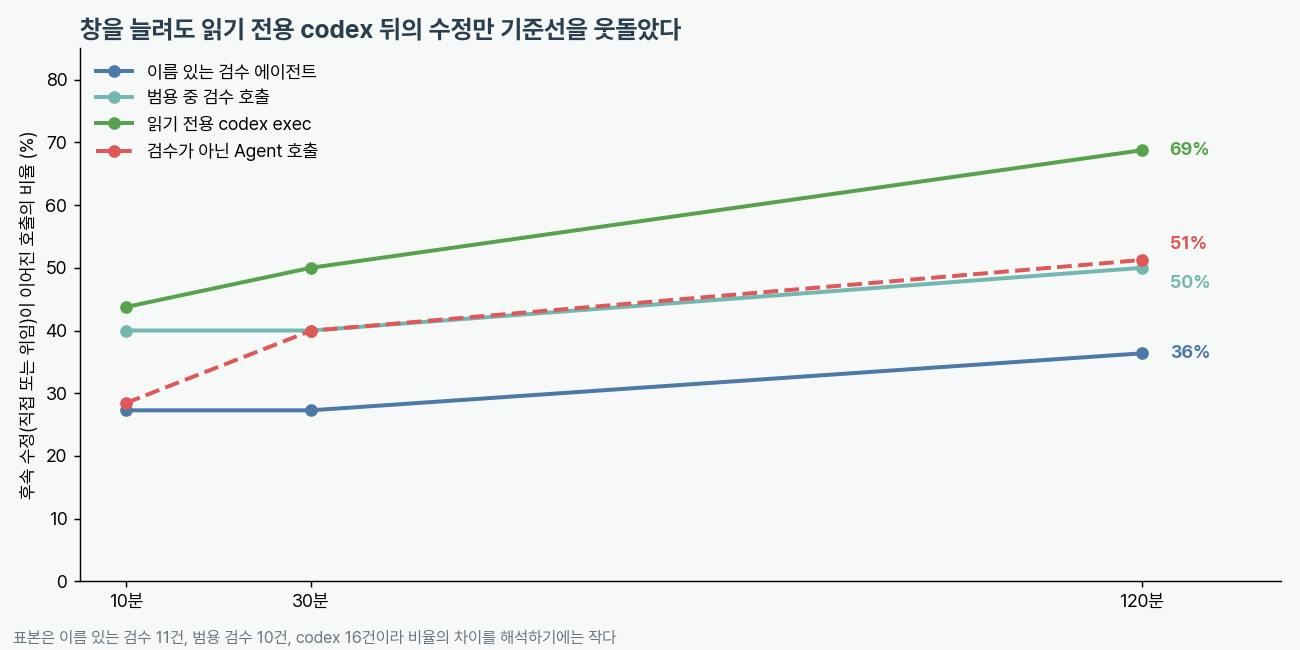
판정과 반영을 이어 보라는 댓글에는 여기까지만 답할 수 있습니다. 이름 있는 검수 11건 가운데 결과문에 판정이 보이는 것은 6건이고, 나머지 5건은 서브에이전트 로그의 마지막 글이 100자도 안 되는 진행 메시지였습니다. 결과문이나 요청문에 파일 이름이 나온 수정이 뒤따른 호출은 11건 중 1건(검수가 아닌 호출은 478건 중 25건, 5%)이어서 연결은 하한값입니다. 판정이 실패였던 호출(2026-09-13의 application-checker, 실패 5건) 뒤에도 120분 안에 Edit나 Write 기록은 없었습니다. 이 도구는 Bash로 파일을 고친 경우를 세지 못하고, 다른 application-checker 호출은 호출 시각부터 120분 안에 Bash 호출이 30건 이어졌습니다.
Step 6. 2주차와 같은 명령으로 재측정
2주차 글의 측정 스크립트를 복제해 구간 경계만 10-14로 옮겨 다시 돌렸습니다. 같은 스크립트가 tool_use id의 중복을 거르지 않는다는 것을 이번에 알게 되어, id로 걸러 센 값도 함께 냈습니다. 로그에서 Agent와 Task 호출은 기록 줄로 555줄이었고 고유 id로는 518개였습니다.
항목 | 1주차 구간(~10-03) | 2주차 구간(10-04~10-13) | 3주차 구간(10-14~10-22) |
|---|---|---|---|
이름 있는 검수 에이전트 호출 | 8 | 1 | 2 |
범용 중 설명에 검수 계열 단어(2주차 정의) | 5 | 21 | 3 |
그중 검수 성격의 호출 | 3 | 5 | 2 |
읽기 전용 | 2 | 8 | 6 |
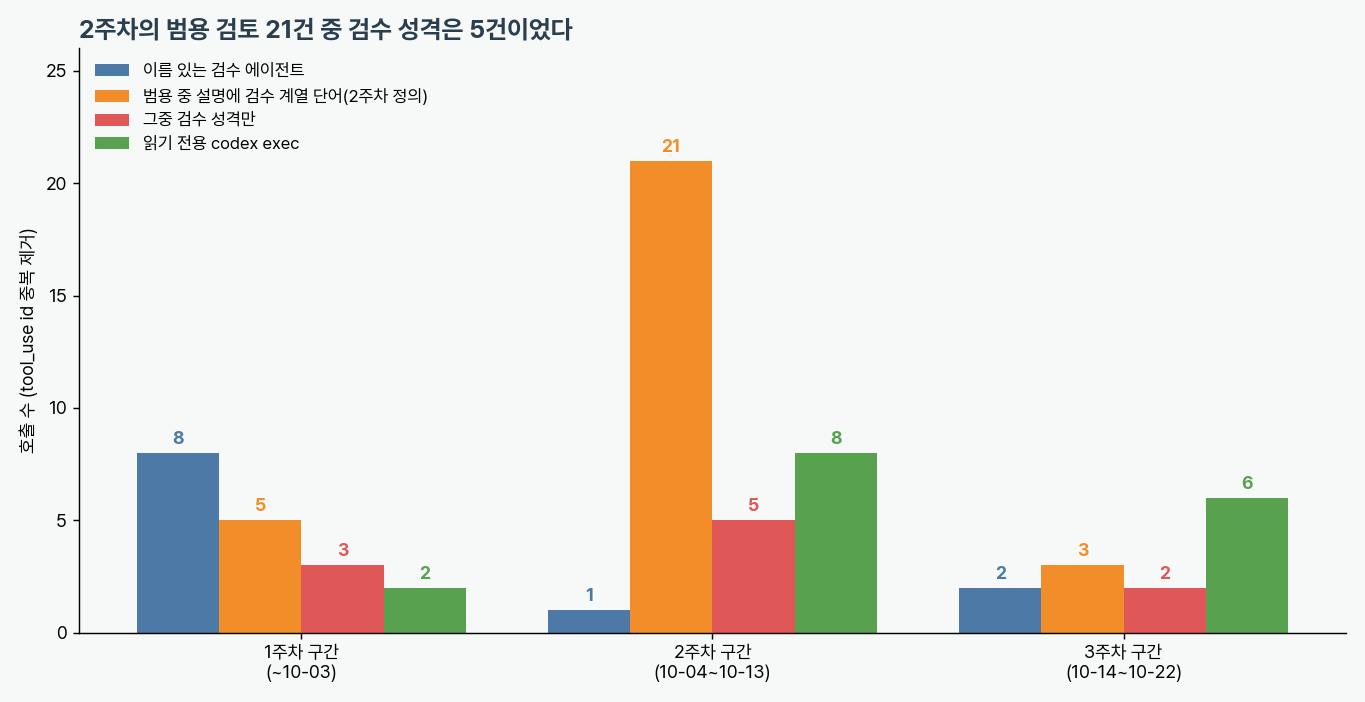
2주차 글에서 범용 호출 안의 검수 계열 단어가 5건에서 21건으로 늘었다고 쓰고 "이름 없는 범용 에이전트에게 검토를 시키는 쪽으로 옮겨 갔다"고 읽었습니다. 21건을 설명까지 읽어 보니 검수 성격은 5건이었고 나머지 16건은 검사기나 문서를 쓰거나 고치는 호출이었습니다. 이 해석은 정정합니다. 10-14 이전 Agent 호출은 원래 방식으로 415건, id 중복을 거르면 384건입니다. 지난 글의 1주차 구간 검수 호출 10건은 같은 정의로 지금 다시 세면 id 중복을 거른 값이 8건이고, 차이 2건 가운데 1건은 id 중복이지만 나머지 1건의 원인은 확인하지 못했습니다. 로그 보존 상태가 달라졌을 수 있습니다.
Step 7. 리뷰어 지침과 규칙 파일의 변화
강의가 말한 피드백의 영구 반영을 제 환경에서는 두 곳에서 확인했습니다. 첫째는 검수 정의 14개 파일과 자비스 지침 파일 9개의 수정 시각입니다. 10-04 이후 수정된 검수 정의는 0개이고 지침 파일 9개는 모두 2026-08-05 그대로입니다. 둘째는 전역 규칙 파일에 괄호로 날짜를 붙여 쌓은 줄입니다. 10-14 이후 20줄이 붙었고 글쓰기 규칙 16줄, 제목 규칙 2줄, 에이전트 배분 1줄, 스크립트 안전 1줄입니다. 이 가운데 검수나 리뷰를 다룬 줄은 없었습니다. 지적을 규칙으로 옮기는 일은 계속되고 있지만 대상이 글쓰기에 몰려 있습니다.
자비스 쪽에서는 10-14 이후 역할 지침 주입이 19건 있었습니다(마스터 3, CSO 2, 워커 4, 리뷰어 10, 10-18과 10-20과 10-21). 같은 창에 마지막으로 보낸 기동 명령으로 모델을 읽으면 워커 4건은 모두 Claude이고 리뷰어 10건은 Codex 4건, Antigravity 4건, Claude 2건이었습니다. 리뷰어를 워커와 다른 모델로 둔다는 구성은 갖춰져 있습니다. 다만 이 기간의 자비스 계정 세션 로그에는 도구 호출이 0건이라, 그 리뷰어가 무엇을 바꿨는지는 이 측정으로 알 수 없습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
검수 정의 14개의 도구 권한 | 쓰기 가능 9, 전체 도구 2, 읽기 전용 3 |
쓰기 도구를 가진 11개 중 호출 기록이 있는 것 | 0개 |
이름 있는 검수 호출에서 검수자가 대상 파일을 고친 호출 | 0/11 |
범용 중 검수 성격의 호출에서 검수자가 대상 파일을 고친 호출 | 0/10 |
호출 뒤 30분 안 수정 비율 | 검수 27%, 범용 검수 40%, codex 50%, 기준선 40% |
2주차 계획 7개 | 실행 1, 일부 3, 미실행 3 |
지침 파일 9개와 검수 정의 14개 가운데 10-04 이후 수정된 것 | 0 |
이 측정은 2026-10-22 현재 ~/.claude/agents와 프로젝트 .claude/agents의 정의, ~/.claude/projects와 ~/.cys/claude/projects에 남은 세션 로그 586개(이 글을 만든 세션 제외, Agent와 Task 호출 고유 id 518개), 자비스 전달 기록을 Python으로 센 결과입니다. 로그는 2026-08-30 무렵부터만 남아 있어 그 이전의 검수 호출은 셀 수 없습니다.
배운 점
쓰기 권한은 열려 있고 쓴 기록은 없었습니다. 쓰기 도구를 가진 정의 11개는 로그에서 한 번도 불리지 않았고, 불린 두 정의(application-checker, paper-critic)는 읽기 전용이었습니다. 그래서 권한이 사고를 냈다는 증거는 없고, 쓸 수 있는 상태가 점검 없이 남아 있었다는 것까지만 말할 수 있습니다. 본문으로 나누어 보니 4개는 교정이 역할이라 그대로 두어야 하고, 2개가 읽기 전용 전환 후보입니다.
같은 단어로 센 호출이 다른 일을 섞고 있었습니다. 설명에 검수 계열 단어가 든 범용 호출 29건 중 검수 성격은 10건뿐이었고, 지난 글의 "검토를 범용 에이전트에게 시키는 쪽으로 이동했다"는 해석은 근거가 약했습니다. 단어 목록으로 센 수치는 열어 본 뒤에야 믿을 수 있었고, 첫 실행의 15건이 0건이 된 과정이 그 예입니다.
검수 호출 뒤 수정 비율은 기준선과 크게 다르지 않았습니다. 이름 있는 검수 27%, 범용 검수 40%, 기준선 40%입니다. 공정표 님 발표가 말한 대로 검수를 붙이면 느려지는데 그만큼 고쳐지는지는 이 표본으로 확인되지 않았습니다. 읽기 전용
codex exec뒤의 수정이 기준선보다 높게 남은 것은 그 수정이 검수 때문인지 같은 세션의 다른 작업 때문인지 가릴 수 없습니다.피드백의 영구 반영은 제 환경에서는 글쓰기 규칙에만 이루어졌습니다. 강의는 피드백이 검수 기준이 되고 리뷰어 역할을 고치라고 했는데, 제 검수 정의와 리뷰어 지침은 수정이 0건이고 새로 붙은 규칙 20줄에 검수 항목은 없었습니다. Elly 님이 하네스가 정교해지는지를 어떻게 측정할지가 고민이라고 했는데, 저도 정교해졌는지는 재지 못하고 수정 기록이 있는지만 확인했습니다.
이 점검은 Edit와 Write 기록만 셉니다. Bash로 파일을 고친 경우, 결과문이 로그에 남지 않는
codex exec, 마지막 글이 진행 메시지로 끝난 서브에이전트는 연결을 약하게 만듭니다. 그래서 수정 비율을 하한으로 읽어야 하고, 호출 0회인 11개 정의를 지금 읽기 전용으로 바꿔도 되는지는 이 측정이 보장하지 않습니다.
시행착오
처음에는 범용 호출의 검수자 수정 15건을 그대로 믿을 뻔했습니다. 서브에이전트 로그를 열어 보니 검수자가 새로 만든 보고서 파일을 다시 Edit한 기록이었습니다.
같은 호출이 이어받은 세션 파일에 두 번 남아 2주차 값이 부풀려져 있었습니다. 10-14 이전 Agent 호출만 415건에서 384건으로 줄었습니다.
처음에는 후속 수정을 호출한 쪽의 직접 수정만 셌는데, 검수 뒤에 다른 에이전트에게 고치게 한 경우가 빠져 있었습니다. 위임한 수정을 더하니 이름 있는 검수의 30분 안 수정이 2건에서 3건이 되었습니다.
정의 본문의 분류는 문장을 읽고 나눈 것이라 사람마다 다르게 나눌 수 있습니다. claim-checker는 수정한다는 문장이 직접 있지 않고 수정할 수 없는 항목의 표기만 적혀 있어, 교정이 역할이라는 쪽은 간접 근거입니다.
도움 받은 글
24기 나만의AI팀 3주차 강의(엔지니어H): 피드백을 스킬과 하네스로 업데이트하고 검수 기준으로 남기는 순환, 리뷰어 지침의 영구 반영 문구, 같은 일을 여러 조건에서 시험하고 전후를 비교하는 평가 방법
3주차 수강생 발표: Elly 님의 의사결정 대시보드와 하네스 정교화의 측정 고민, 나나nana 님의 리뷰어 모델 분리, 망원궁예 님의 승인 단계가 있는 파이프라인, 공정표 님의 싱글과 멀티와 서브에이전트 검수 비교
망원궁예 님이 제 2주차 글에 남긴 댓글: 리뷰어별 판정과 실제 반영 여부를 연결해 보라는 제안
24기 나만의AI팀 2주차 사례글(본인): 같은 정의로 다시 센 기준값과 7개 계획의 출처

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요