오류 주입 시험지로 문체 검사기와 검수 에이전트 점검하기
2026.10.26
소개
제 한국어 글을 점검하는 장치 셋(금지 표현 검사 스크립트, 문체 검수 에이전트, 사실 대조 에이전트)이 실제로 오류를 찾는지 확인하기 위해, 이미 쓴 글에 정답을 아는 오류 17개를 심고 세 장치에 맡겨 보았습니다. 검수 장치를 만들어 두기만 하고 그것이 무엇을 놓치는지는 재어 보지 않은 분, 검사 스크립트와 AI 검수를 어떻게 나누어 쓸지 고민하는 분이 읽으면 좋겠습니다. 측정은 2026-10-23에 했습니다.
4주차는 마지막 주차였습니다. 스터디장님은 웨딩 필름 영상 하네스를 피드백으로 고쳐 가는 과정을 시연했습니다. 처음에는 열 개 중 아홉 개를 다시 만들어야 했는데, 피드백을 하네스에 반영하고 나니 한두 개만 고치면 되는 수준이 되었다고 했습니다. 이어서 Elly 님, 아이콩 님, 모멘텀 님이 발표했습니다. 아이콩 님은 보고서에 정답을 아는 오류 여덟 개를 심어 검수 AI가 찾는지 시험했고, Elly 님은 검수 결과가 마스터에게 실제로 반영되는지 어떻게 판단할지가 고민이라고 했습니다.
저는 아이콩 님의 시험 방식을 제 장치에 적용했습니다. 3주차까지 재 온 것은 검수 호출 뒤에 수정이 이어졌는지였는데, 그 검수가 오류를 찾는지는 따로 재지 못했기 때문입니다. 3주차 계획 15개의 실행 여부와 4주 동안의 변화도 같은 명령으로 다시 쟀습니다. ~/.claude, 측정한 저장소, 블로그는 읽기만 했고, 새로 만든 것은 이 스터디 폴더 안의 시험지 도구와 그 검사입니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, matplotlib, 세션 로그(598개), 문체 검사 스크립트, 읽기 전용 검수 에이전트 둘
Step 1. 강의 기준의 측정 항목 선정
4주차 강의에서 파일이나 로그로 확인할 수 있는 말만 골랐습니다.
강의 기준 | 강의에서 나온 말(영상 시각) | 잴 것 |
|---|---|---|
하네스를 고치면 다시 만드는 비율이 줄어든다 | 열 개 중 아홉 개를 고치던 것이 한두 개로 줄었다(00:28) | 검수 호출 뒤 수정 비율, 검수 정의의 수정 여부 |
검수 결과가 반영되었는지 판단할 방법 | Elly 님의 고민. 작업 완료에는 근거가 되는 검수 번호를 적는 규칙(01:06) | 판정 원장의 건수, 관문 스크립트 결과 |
검수 AI를 믿어도 되는지 시험 | 정답을 아는 오류 여덟 개를 심어 찾게 했다(01:18) | 오류 주입 시험지에서 찾은 개수 |
코드로 처리할 일은 코드로 | 영상을 합치는 일은 LLM에 시킬 이유가 없다(01:32) | 검사 스크립트가 찾는 것과 에이전트가 찾는 것의 구분 |
여러 축으로 교차 확인 | 모델 서넛이 모두 통과해야 통과로 본다(02:00) | 세 장치를 합쳤을 때 찾은 개수 |
이 가운데 세 번째와 네 번째를 이번 글의 중심으로 삼았습니다. 3주차 계획 15개의 실행 여부와 4주 변화는 처음부터 다시 잴 수 있는 것만 넣었습니다.
Step 2. 3주차 계획 15개의 실행 여부
3주차 글 끝에 적어 둔 계획을 항목마다 명령으로 확인했습니다.
grep -rn "생산 에이전트" ~/.claude/CLAUDE.md ~/.claude/rules/*.md        # (출력 없음)
stat -f '%Sm %N' -t '%Y-%m-%d' ~/.cys/pack/directives/*.md             # 9개 모두 2026-08-05
command -v ooo ouroboros                                                # (출력 없음)
ls ~/.claude/agents/*.md | wc -l                                        # 13
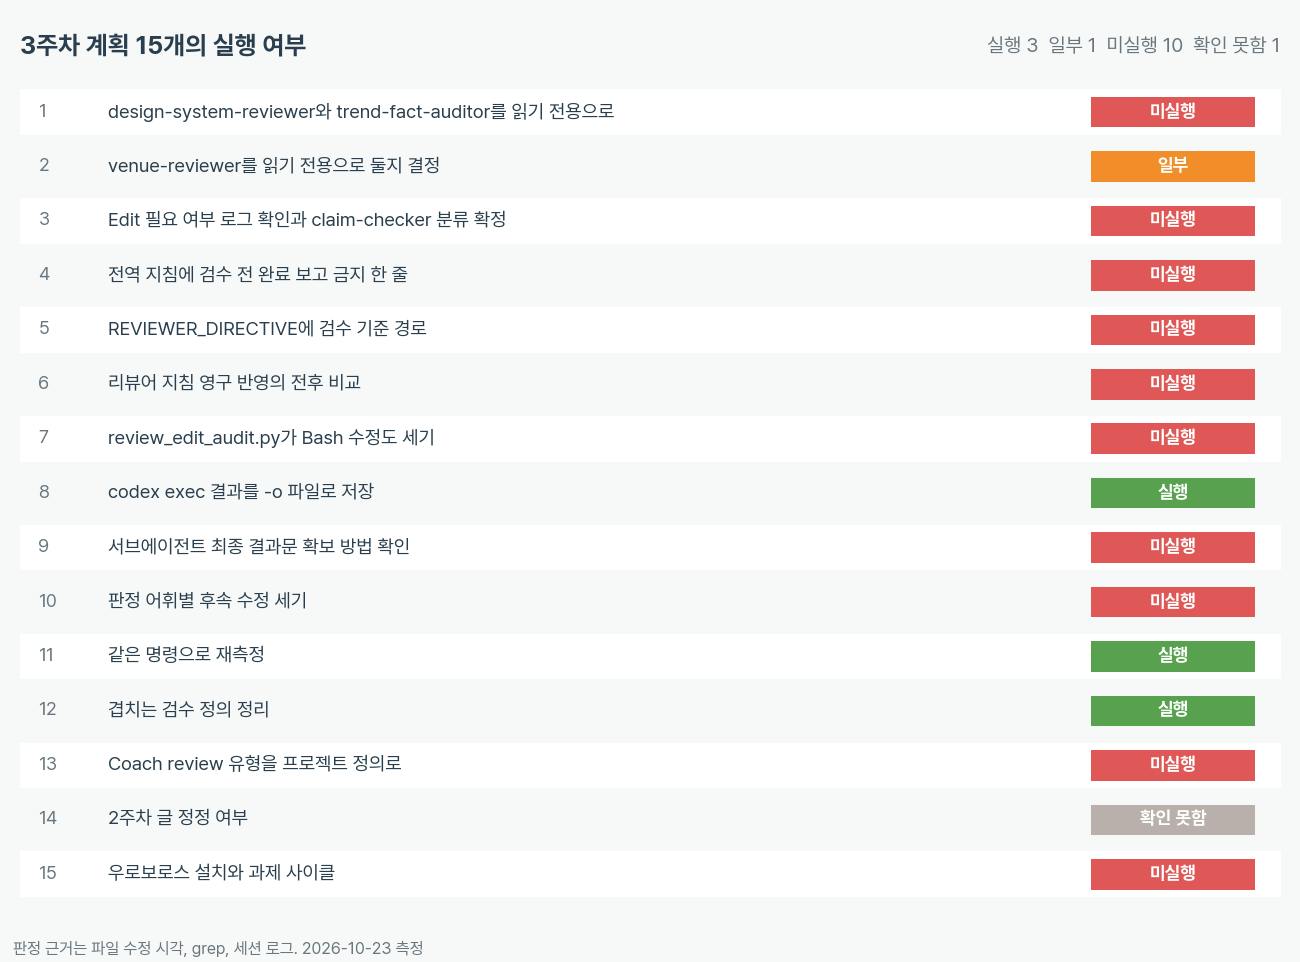
실행한 것은 세 가지입니다. codex exec의 결과를 -o 파일로 남기는 일은 10-23 새벽(한국 시간) 호출부터 적용했습니다. 같은 명령으로 재측정하는 일은 이 글에서 했습니다. 겹치는 검수 정의를 정리하는 일은 전역 에이전트 정리 작업 안에서 이루어져 검수 정의가 14개에서 10개로 줄었습니다. 정의와 지침 파일을 직접 고치는 항목(읽기 전용 지정, 전역 지침 한 줄, 리뷰어 지침의 검수 기준 경로)은 한 건도 실행하지 않았습니다. 1주차 계획은 5개 중 0개, 2주차 계획은 7개 중 1개 실행이었으므로, 장치로 한 번에 바뀌는 일은 되고 파일을 하나씩 고치는 일은 계속 밀리는 경향이 이어졌습니다.
Step 3. 시험지 설계와 시험 먼저 쓰기
시험지는 3주차 사례글 사본에 오류 17개를 심어 만들었습니다. 오류는 네 종류이고, 종류마다 어떤 장치가 찾아야 하는지가 다릅니다.
종류 | 개수 | 예 |
|---|---|---|
금지 표현 목록에 있는 것 | 6 | 긴 줄표, 평서체 단정 종결, 번역투 조사 표현, 상투적 접속어, 가운뎃점 세 개 이상 |
문체 규칙에 있으나 검사 스크립트에는 없는 것 | 5 | 공개의 뜻으로 쓴 "열려 있다", "자리", "A가 아니라 B", 공유의 뜻으로 쓴 "돌리다", 질문형 소제목 |
수치와 합계 | 5 | 표와 본문의 값이 다름, 항목 합이 전체와 안 맞음, 원자료와 다름 |
근거를 넘는 해석 | 1 | 표본이 작아 읽을 수 없다고 쓴 문장을 "검수가 수정을 늘린 효과"로 바꿈 |
시험지를 만드는 도구를 쓰기 전에 정답을 아는 작은 문서로 검사부터 만들었습니다. 심은 문장이 글 안에 정확히 한 번 있어야 하고, 심은 곳의 줄 번호를 정답지에 기록하고, 심은 것을 되돌리면 원문과 같아야 합니다. 코드블록과 인용문 안에서는 검사 스크립트가 금지 표현을 보지 않는다는 경계도 맹점으로 고정했습니다.
python3 -I -m pytest -q test_inject_errors.py    # 구현 전: 모듈이 없어 수집 단계에서 실패
python3 -I -m pytest -q test_inject_errors.py    # 구현 후: 9 passed (이후 검사 둘을 더해 11 passed)
실제 글에 심을 때는 17개가 서로 다른 줄에 들어가는지도 검사로 확인했습니다. 처음 작성한 심기 목록에서는 두 줄에 세 개씩 겹쳐 있어서, 줄 번호만으로는 어느 오류를 찾았는지 가를 수 없었습니다. 목록을 고쳐 17개를 17줄에 흩었습니다.
Step 4. 세 장치에 시험지 맡기기
시험지는 정답지와 다른 폴더에 두었습니다. 에이전트가 정답지를 열 수 없게 하려는 것으로, 스터디장님이 후토크에서 말한 검수자의 격리를 시험 환경에서도 지켰습니다. 의뢰문에는 심은 오류가 있다는 말을 쓰지 않았고, 시험지 파일 하나만 열라고 했습니다.
문체 검사 스크립트: 시험지에 그대로 실행했습니다.
문체 검수 에이전트(읽기 전용, 도구는 읽기와 검색만): 문체 규칙 파일 둘을 기준으로 위반을 모두 찾게 했습니다.
사실 대조 에이전트(읽기 전용, 웹 포함): 시험지와 원자료 JSON 세 개를 주고 수치, 합계, 문장 사이의 일관성, 해석의 수위를 보게 했습니다.
두 에이전트는 줄 번호와 문제 문장 인용을 JSON으로 답하게 했습니다.
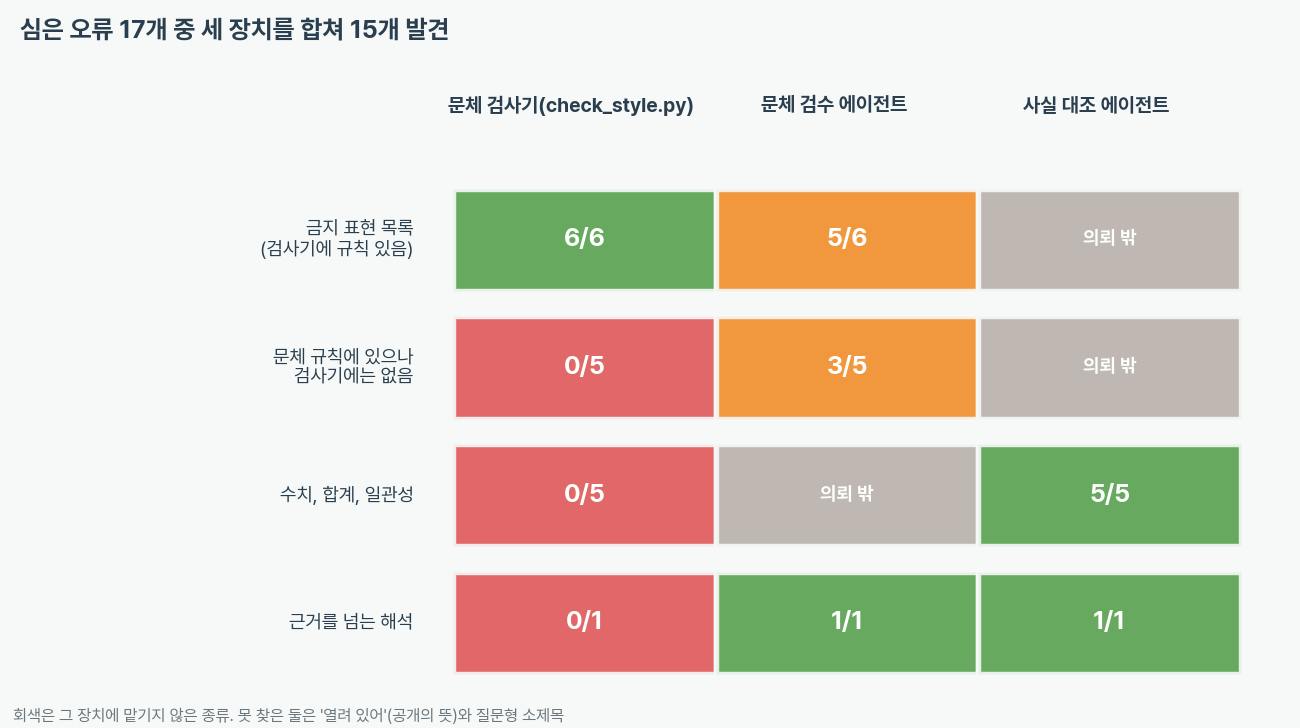
검사 스크립트는 금지 표현 6개를 모두 찾았고 시험지의 다른 줄은 하나도 지적하지 않았습니다. 원본 글을 같은 스크립트에 넣으면 0건이니, 오탐은 없었습니다. 문체 규칙에 있으나 스크립트에 없는 5개와 수치 5개는 한 개도 찾지 못했습니다. 문체 검수 에이전트는 금지 표현 5개, 스크립트에 없는 규칙 3개, 해석 1개를 찾았고 수치 5개는 의뢰 범위 밖이었습니다. 사실 대조 에이전트는 수치 5개를 모두 찾았고, 해석 1개도 인과 단정이라며 지적했습니다.
세 장치를 합치면 17개 중 15개입니다. 어느 장치도 찾지 못한 둘은 공개의 뜻으로 쓴 "열려 있어"와 질문형 소제목이었습니다. 문체 검수 에이전트에는 소제목 규칙이 든 파일을 기준으로 주었는데도 질문형 소제목을 지나쳤습니다. 가운뎃점 세 개 이상도 스크립트는 바로 찾았지만 문체 검수 에이전트는 놓쳤습니다. 줄을 세거나 문자 모양으로 가를 수 있는 규칙을 모델이 놓치고 스크립트가 찾았습니다. 반대로 문맥을 읽어야 하는 "자리"와 "A가 아니라 B"는 스크립트가 못 찾고 에이전트가 찾았습니다.
Step 5. 채점 기준의 보정
처음 채점은 에이전트가 지적한 줄 번호가 심은 줄과 같으면 찾은 것으로 쳤습니다. 이 기준으로는 문체 검수 에이전트가 12개를 찾은 것으로 나왔습니다. 수치 오류가 든 줄에서 에이전트가 수치와 무관한 다른 문장을 지적했는데도 맞은 것으로 센 결과였습니다. 같은 줄을 다른 이유로 지적한 것은 찾은 것으로 세지 않는다는 검사를 먼저 쓰고(실패를 본 뒤), 인용한 문장이 심은 문구와 겹칠 때만 찾은 것으로 바꾸었더니 9개가 되었습니다.
python3 -I inject_errors.py make 원문.md injections.json 시험지.md 정답지.json
python3 -I inject_errors.py score-script 시험지.md 정답지.json
python3 -I inject_errors.py score-issues 이슈.json 정답지.json
처음 기준으로는 12개를 찾은 것으로 나왔지만, 고친 기준으로 센 9개를 이 장치의 값으로 봅니다.
Step 6. 4주 동안의 재측정
3주차와 같은 스크립트를 출력 파일 이름만 바꿔 다시 실행했습니다. 로그는 598개로 늘었습니다.
python3 -I review_edit_audit.py --exclude <이 글을 만드는 세션>     # 검수 호출 뒤 30분 안 수정
python3 -I 24기나만의AI팀_4주차_재측정.py --dedup                  # 3주차 측정 스크립트 그대로
python3 _tools/review_gate.py 24기나만의AI팀_{1,2,3}주차_사례글.md   # 판정 원장 확인
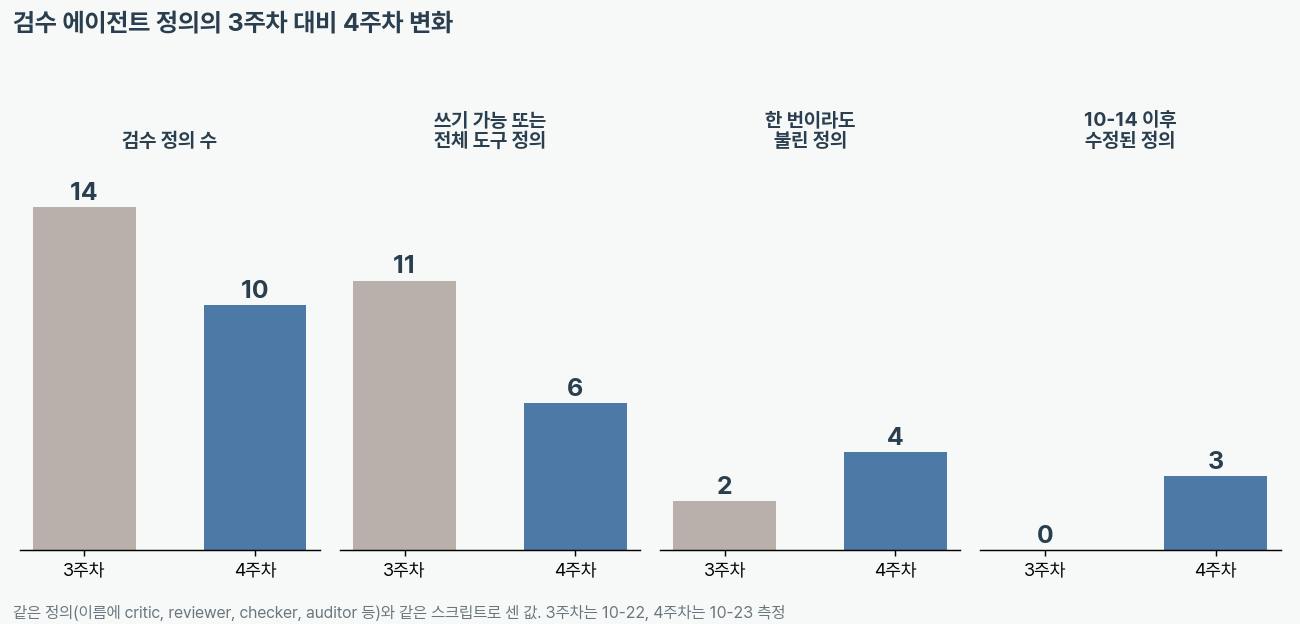
3주차 이후 가장 큰 변화는 전역 에이전트 정리입니다. 검수 역할 정의가 14개에서 10개로 줄었고, 쓰기나 전체 도구를 가진 정의는 11개에서 6개가 되었습니다. 문체, 사실 대조, 논문 판정 정의 셋은 읽기 전용으로 다시 썼습니다. 10-23 새벽(한국 시간)에 이 정의 둘이 처음 불렸고, 그 결과 한 번이라도 불린 정의가 2개에서 4개가 되었습니다. 새 호출 셋(블로그 초안 사실 대조 둘, 문체 검토 하나)에서 검수자가 대상 파일을 고친 것은 0건이고, 30분 안에 호출한 쪽이 수정한 것은 3건 모두였습니다.
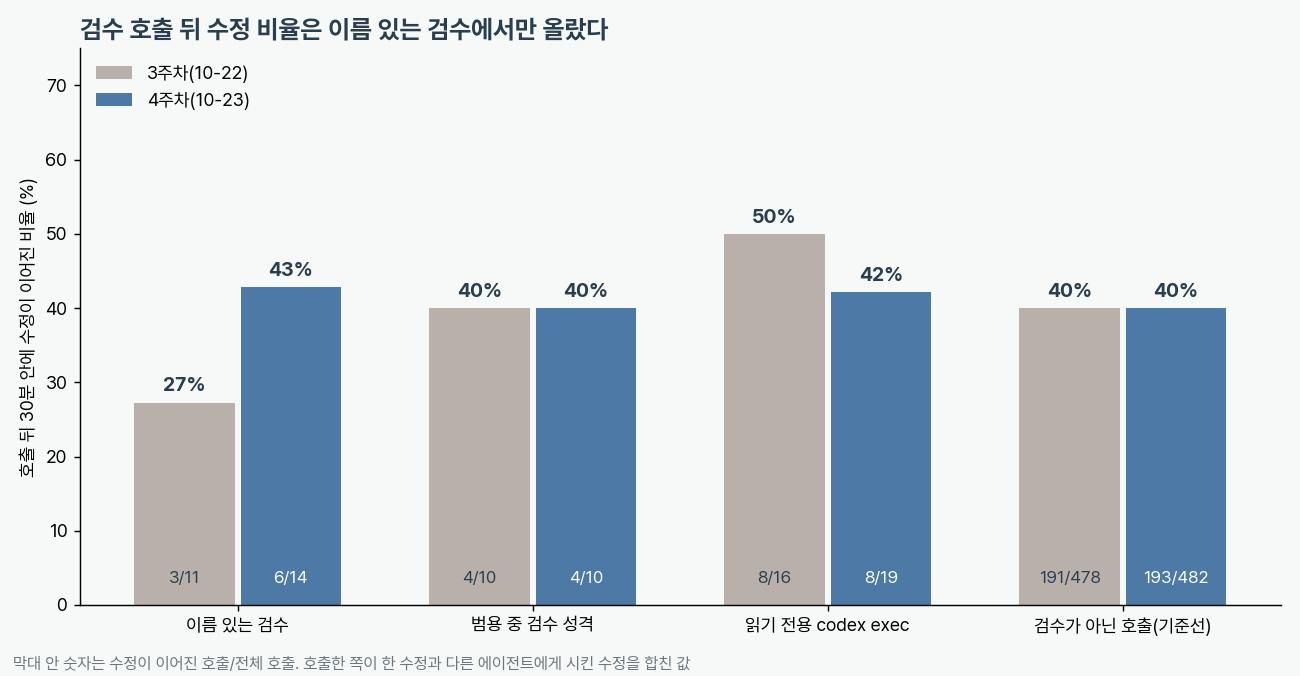
이름 있는 검수 호출 뒤 수정 비율은 27%에서 43%로 올랐습니다. 늘어난 호출이 셋뿐이라 변화로 읽기는 어렵고, 읽기 전용으로 바꾼 뒤 불린 호출 3건에서 검수자가 파일을 고친 것은 0건이었습니다(이름 있는 검수 호출 14건 전체로 봐도 0건입니다).
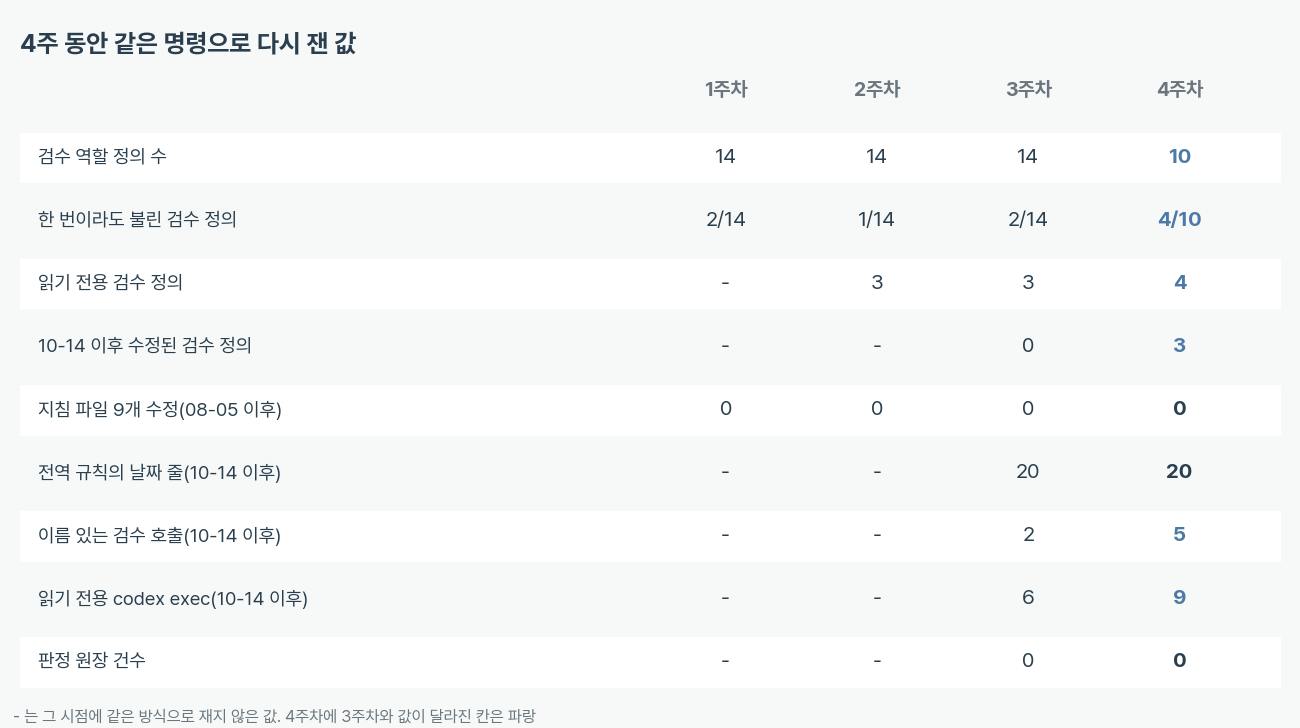
판정 원장(.review/verdicts.jsonl)은 어느 폴더에도 한 건도 없습니다. 사례글 3편에 관문 스크립트를 실행하면 3편 모두 missing(필요한 검수자 style-critic의 판정 없음)으로 나옵니다. 그래서 Elly 님의 질문인 검수 결과가 반영되는지는, 제 환경에는 아직 셀 수 있는 기록이 쌓이지 않았습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
시험지에 심은 오류 | 17개(금지 표현 6, 스크립트에 없는 문체 규칙 5, 수치 5, 해석 1) |
문체 검사 스크립트가 찾은 것 | 6/17(금지 표현 6/6, 나머지 0/11), 오탐 0줄 |
문체 검수 에이전트가 찾은 것 | 9/17(수치는 의뢰 범위 밖), 시험지 원문의 그 밖의 지적 23건 |
사실 대조 에이전트가 찾은 것 | 6/17(수치 5/5, 해석 1/1), 그 밖의 지적 2건 |
세 장치를 합친 것 | 15/17 |
3주차 계획 15개 | 실행 3, 일부 1, 미실행 10, 확인 못함 1 |
검수 정의의 변화(3주차에서 4주차) | 14개에서 10개, 쓰기 또는 전체 도구 11개에서 6개 |
판정 원장 | 0건, 사례글 3편 관문 결과 missing |
이 측정은 2026-10-23 현재 시험지 한 벌에 세 장치를 한 번씩 실행한 결과입니다. 로그는 ~/.claude/projects와 ~/.cys/claude/projects의 세션 598개(이 글을 만든 세션 제외)이고, 정의는 ~/.claude/agents와 프로젝트 .claude/agents의 83개 파일(고유 이름 66개)입니다.
배운 점
검사 스크립트와 에이전트는 서로 다른 오류를 찾았습니다. 스크립트는 금지 표현 6개를 오탐 없이 모두 찾았고 문맥이 필요한 오류는 하나도 못 찾았습니다. 문체 검수 에이전트는 문맥이 필요한 규칙 3개를 찾았지만 가운뎃점 세 개와 질문형 소제목처럼 문자 모양으로 가를 수 있는 것을 놓쳤습니다. 스터디장님이 말한 "코드로 처리할 일은 코드로"가 제 장치에서는 이렇게 갈렸습니다. 놓친 둘은 질문형 소제목과 "열려 있다"인데, 참값이 규칙 파일에 있는 앞의 것은 스크립트에 규칙을 추가하는 후보입니다.
수치 5개는 원자료와 수치 점검 의뢰를 받은 장치만 찾았습니다. 사실 대조 에이전트는 JSON 세 개와 글 안의 합계를 대조해 수치 오류를 모두 찾았습니다. 문체 검수 에이전트는 원자료 없이 글만 읽었고 수치는 의뢰 범위 밖이었으므로 같은 오류를 한 개도 짚지 못했습니다. 이 차이가 입력 때문인지 의뢰 범위 때문인지는 입력과 의뢰 범위를 같이 바꿔 봐야 갈립니다.
시험지가 쉬운 편이었습니다. 심은 오류는 제가 만들었고 글은 평이한 측정 보고서였습니다. 아이콩 님도 자신의 시험이 쉬운 편이었다고 하며, 자주 반박했던 복잡한 자료로 다시 시험해야 한다고 했습니다. 후토크에서 한 수강생이 제 환경에서는 검수 오류가 많이 나오는데 왜 다른지 물었을 때 스터디장님은 전문 분야이거나 알려진 자료가 적을수록 LLM 검수가 놓치는 것이 많아지므로 도메인 기준을 하네스에 넣어야 한다고 답했습니다. 제 시험은 그 반대쪽 끝(평이한 자료)에 있어서 이 15/17은 장치의 상한에 가까운 값으로 읽어야 합니다.
채점 기준이 결과를 12에서 9로 바꾸었습니다. 줄 번호만 맞으면 찾은 것으로 세는 기준은 헛된 일치를 포함했습니다. 검수 AI의 재현율을 말하는 숫자는 어떤 기준으로 찾았다고 셌는지와 함께 읽어야 합니다.
실행된 세 가지는 모두 한 번 바꾸면 계속 작동하는 장치였습니다. 3주차 계획 15개 중 실행한 셋은 결과를 파일로 남기는 옵션, 같은 스크립트의 재실행, 전역 정의 정리였습니다. 정의 파일과 지침 문장을 하나씩 고치는 항목은 10개가 남았습니다. 4주차의 마지막 계획에는 날짜와 확인 명령을 붙였습니다.
시행착오
사실 대조 에이전트가 심지 않은 곳에서 3주차 글의 문장 두 개를 틀렸다고 짚었는데, 원자료를 다시 열어 보니 둘 다 오탐이었습니다. 하나는 "창을 바꿔도
codex exec뒤의 수정만 기준선보다 계속 높았다"는 문장입니다. 범용 검수는 10분 창에서만 기준선보다 높았고(4/10, 기준선 136/478) 30분 창에서는 같았고 120분 창에서는 낮아서,codex exec만 세 창 모두에서 기준선보다 높았습니다. 다른 하나는 "10-04 이후 수정된 검수 정의는 0개"라는 문장입니다. data-gate-auditor의 수정 시각 10월 4일 01:29는 한국 시간이고, 2주차 측정의 경계인 10월 4일 0시(UTC)보다 앞섭니다. 사실 대조 에이전트는 "계속"이라는 한정어와 시간대를 놓쳤고, 저도 처음 보고를 받았을 때 그대로 믿을 뻔했습니다. 검수 판정도 원자료로 다시 확인해야 한다고 이번에 배웠습니다.처음 시험지 목록은 세 개가 같은 줄에 겹쳤습니다. 줄 번호로 채점하려면 한 줄에 오류 하나여야 합니다.
문체 검수 에이전트는 시험지 밖의 지적을 23건 냈습니다. 원문에도 실제 흠이 있었고 판단이 갈리는 것도 있어서, 이 23건을 오탐으로 세지 않고 따로 적었습니다. 오탐을 재려면 흠이 없는 글이 먼저 있어야 합니다.
에이전트는 한 번씩만 실행했습니다. 아이콩 님이 말한 대로 LLM은 확률적이라 같은 시험지에서도 어떤 오류는 나오고 어떤 오류는 안 나올 수 있고, 반복 실행으로 재현율의 폭을 보는 일은 하지 못했습니다.
4주차의 이름 있는 검수 호출은 3건 늘어난 것이 전부라, 3주차와 4주차의 수정 비율 차이(27%에서 43%)는 효과로 읽지 않았습니다.
도움 받은 글
24기 나만의AI팀 4주차 강의(엔지니어H): 피드백을 하네스에 반영해 다시 만드는 비율을 줄이는 과정, 코드로 처리할 일과 모델에 맡길 일의 구분, 검증 기준은 도메인 전문가의 관점에서 세우고 검수자는 작성 맥락에서 떼어 놓는다는 설명
4주차 수강생 발표: 아이콩 님의 오류 주입 시험지와 시험 자료 선정 기준, Elly 님의 검수 결과 반영 확인 고민과 완료 기록에 검수 번호를 적는 규칙, 모멘텀 님의 여러 모델 교차 확인
24기 나만의AI팀 3주차 사례글(본인): 시험지의 원문, 측정 스크립트, 3주차 계획 15개의 출처

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

안녕하세요, Fri-mer님! 오류 주입 시험지 글 잘 읽었어요.
검수 장치를 만들어 두기만 하고 실제로 오류를 찾는지는 재 보지 않는 경우가 많은데, 아이콩 님의 방식을 가져와 정답을 아는 오류 17개를 네 종류로 나눠 심으신 설계가 좋았어요. 금지 표현 스크립트가 잡을 것, 문체 규칙엔 있지만 스크립트엔 없는 것, 수치 합계처럼 종류마다 어느 장치가 찾아야 하는지 갈라 두셔서 "코드로 처리할 일은 코드로"라는 강의 말씀이 그대로 드러났어요.
3주차 계획 15개를 장치로 바뀐 일은 되고 파일을 하나씩 고치는 일은 밀린다는 경향으로 정리하신 대목도 공감됐어요. 슬쩍 옆에 앉아 구경하고 갑니다, 골골 🐾