딸깍봇 도전 1주차 사례글

이창민
2026.05.22
# 봇은 캐릭터가 아니라 구조다 — 좌뇌(Karpathy)·우뇌(명조) 두개로 시작한 1주차

> *추측보다 검증* — 봇 만들기 / 코드베이스 읽기 / 반복 업무 절차화까지 한 번에 돌려본 기록

---

## 소개
저는 트렌드 및 경쟁사 컨텐츠 분석 - 생성 또는 수정 - 숏폼 또는 카드뉴스 컨텐츠를 생성 - 멀티 sns업로드 성과 분석 피드백 을 반복하는
에이전트팀을 만들어 보고 싶었습니다.

### 시도하고자 했던 것과 그 이유

1주차 필수 과제 세 가지 (봇 만들기 / 코드베이스 질문 / 반복 업무 절차화)를 그냥 통과시키지 않고, **선택 과제 "봇 2개 이상 비교"까지 끼워서 하나로 묶었다.**
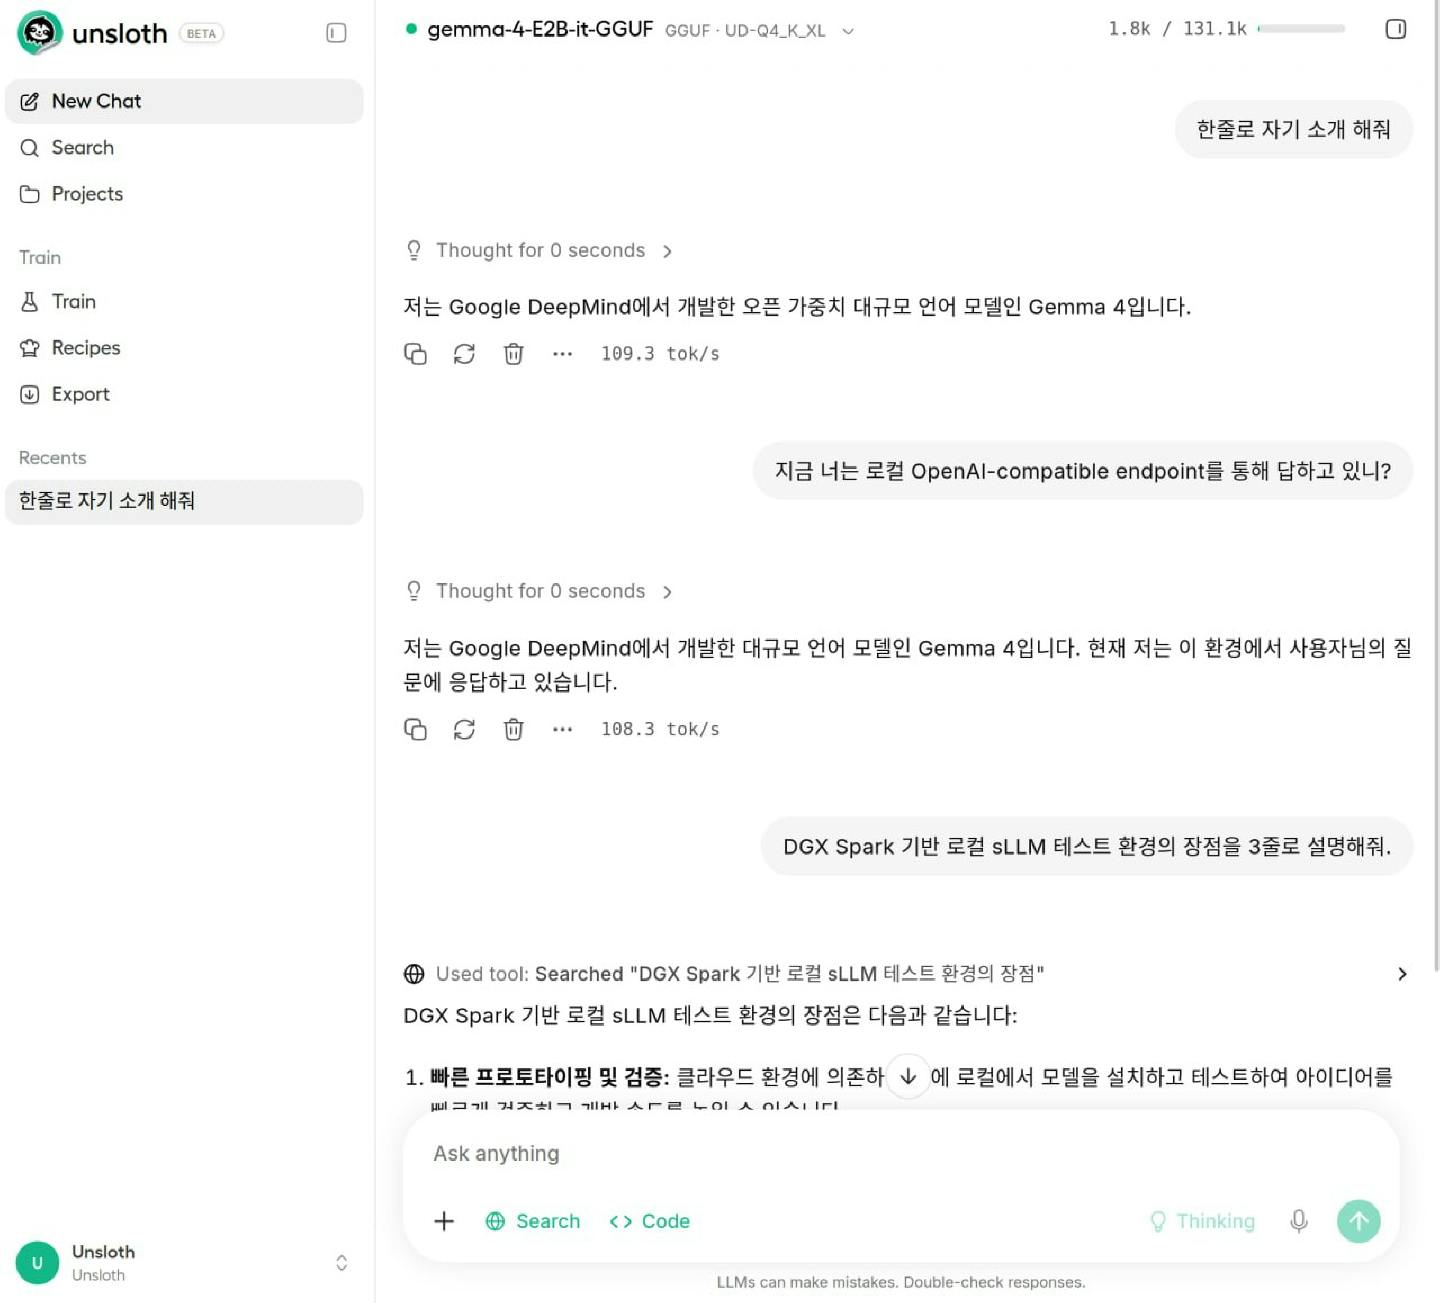
* 스터디장님 영상을 보고 카파시봇을 테스트해보고 실습으로 추가해서 만든봇이 명조 입니다.


내가 시도한 것:
- **봇 2개** — 좌뇌형 `Karpathy` (ML/논문/코드) + 우뇌형 `명조` (PICK PICK 콘텐츠/카피)
- Claude Code로 `hermes-agent` 코드베이스 **Q0~Q6 6개 질문 누적 학습**
- PICK PICK **5단계 콘텐츠 워크플로우의 1단계(트렌드 분석)** 절차화 + 실제 봇에게 한 사이클 의뢰

**왜 이렇게:**

| 과제 | 일반 풀이 | 내가 한 것 | 이유 |
|---|---|---|---|
| 봇 1개 | 봇 1개 | **봇 2개 비교** | SOUL/AGENTS/MEMORY 분리 룰을 *직접 체감*하려면 1개로는 부족. 첫 봇에서 실수해야 두 번째에서 예방함. |
| 코드 질문 5회 | 5개 질문 | **6개 Q + [확인]/[추론]/[확인 불가] 태그 강제** | 추측을 추측으로 쓰는 게 1주차 핵심. 모르는 건 "확인 불가"로 남기는 정직성 실험. |
| 반복 업무 절차화 | 완벽한 가이드 1장 | **합리적 기본값 + 측정 지점 + 개선 사이클** 3종 세트 + 실제 실행 | 첫판 완벽 추구는 함정. 돌려보고 데이터 보고 개선. |

---

## 진행 방법

### 사용한 도구
- **Hermes Agent v0.14.0** — 두 봇의 프로필 호스트
- **Claude Code (Opus 4.7)** — 코드베이스 학습, 가이드 작성, 검증
- **Discord** — 도라에몽 채널 (메모/초안/컨설팅/실행로그 4채널 구조)
* 참고로 도라에몽은 수강이전 클로드로 미리 만들어봤던 봇 입니다.
--- ( 도라에몽 봇 -> 진구 (나) )) --

### 1) 봇 두 마리 만들기 — 좌뇌(Karpathy) + 우뇌(명조)

| 봇 | 한 줄 컨셉 | 톤 |
|---|---|---|
| **Karpathy** | Andrej Karpathy 페르소나 — ML 논문·코드·리서치 멘토 | 회의적·분석적, 한국어+영어 기술용어 혼용 |
| **명조** | PICK PICK 콘텐츠/마케팅 파트너 (인스타·페이백·공구몰 카피) | 호기심, 짧고 많이, 모르면 "내 직감" 라벨 |

**이름의 유래** — Karpathy는 *사람*(Andrej Karpathy), 명조는 *글씨체*(명조체). 좌·우뇌 캐릭터 차이가 *이름 층위에서부터* 갈리도록 설계.

**파일 구조** (둘 다 동일):
```
~/.hermes/profiles/{karpathy|myungjo}/
├── SOUL.md                # 누구인가 (정체성/톤/금지/호칭)
├── memories/
│   ├── MEMORY.md
│   ├── user_jingu.md      # 사용자 컨텍스트
│   ├── persona_scope.md   # 영역 정의
│   └── voice_rules.md     # 톤/언어 규칙
└── workspace/
    └── AGENTS.md          # 어떻게 일하나 (워크플로/도구/응답형식)
```

**세 파일의 직교 분리** (내가 정리한 자기 언어):

| 파일 | 답해야 하는 질문 | 들어가는 것 | 안 들어가는 것 |
|---|---|---|---|
| **SOUL.md** | "이 봇은 누구인가?" (**who**) | 정체성, 한 줄 컨셉, 말투, 가치관, 호칭, 첫 인사 | 단계별 절차, 응답 포맷 체크리스트 |
| **AGENTS.md** | "이 봇은 어떻게 일하나?" (**how**) | 미션 한 줄, 업무별 워크플로, 도구 사용, 응답 형식 | 정체성/말투 상세 묘사 |
| **MEMORY.md** | "이 봇이 계속 기억할 사실은?" (**what**) | 사용자 컨텍스트, 사업 컨텍스트, *일주일 후에도 유효한* 것 | 일회성 작업 상태, 시간 지나면 거짓이 될 사실 |

> 세 가지가 *직교*(orthogonal)일수록 봇이 일관성 있게 동작한다.

---

### 2) Claude Code로 hermes-agent 코드베이스 학습

`STUDY-LOG.md` 헤더에 박은 룰 — **모든 Q에 동일 적용**:

```text
룰 (전 세션 적용):
1. 기억·추측 X, 파일 직접 열고 확인
2. 핵심 주장에 `파일경로:라인` 근거
3. [확인] / [추론] 태그로 사실/추론 구분
4. 모르면 "확인 불가"
5. 각 Q마다 핵심 3줄을 이 파일에 누적
```

**Q0~Q6 6개 질문 순서:**

| Q | 주제 |
|---|---|
| Q0 | 프로젝트 한 줄 + 주 언어/실행 방식 |
| Q1 | 진입점 + 메시지→응답 8단계 경로 |
| Q2 | 에이전트 루프 본문 (`agent/conversation_loop.py`) |
| Q3 | 시스템 프롬프트 3-tier 조립 ⭐ 함정 1 |
| Q4 | 도구 시스템 + ⭐ 함정 2 |
| Q5 | 메모리 frozen-snapshot + 자기개선 nudge |
| Q6 | 마무리 — [추론] 항목 재검증 + 신규 기여자 읽기 순서 |

**사용한 프롬프트 패턴** (Q마다 변형):

```text
hermes-agent 코드에서 [질문]을 확인하고 싶어.

룰:
- 기억·추측 X, 파일 직접 열고 확인
- 모든 핵심 주장에 `파일경로:라인` 근거 달기
- [확인]/[추론]/[확인 불가] 태그로 구분
- 마지막에 핵심 3줄 요약 (STUDY-LOG에 누적)

[구체 질문]
```
---

### 3) 반복 업무 절차화 — 일일 트렌드 분석 (PICK PICK 5단계의 1단계)

5단계 전체는 단일 과제 범위 밖이라 1단계만 절차화 (2~5단계는 Task 트래커 등록).

**가이드 구조** (가이드 376-401 템플릿 충족):
- 입력 — 트리거, 4개 플랫폼, 시간 범위, **카테고리 슬롯**(진구가 채움)
- 출력 — 매일 09:00 KST 디스코드 `#초안승인`에 마크다운 리포트 1장
- 절차 — 7단계 (트리거 → 병렬수집 → 메타 → 점수 → 조건분기 → 리포트 → 응답대기)
- 판단기준 — 통과/보류/다시 확인
- 사람 확인 지점 — 5곳 (카테고리 필터 / 도우인 수동입력 / BGM 저작권 / 시그널 해석 / 임계값 튜닝)
- 봇이 못 하는 일 — *솔직히 명시*

**핵심 트렌드 점수 — A·B·C 분리:**

```
A (시장반응) = (조회수 ÷ 경과시간) × 참여율 × 카테고리매칭도
B (효율)     = 조회수 ÷ 팔로워수     ← 신예 폭발 신호
C (계정 규모) = 마이크로(<1만) / 미디엄(1~10만) / 매크로(10~100만) / 메가(>100만)
```

A만 쓰면 대형 인플루언서가 항상 1위 → 작은 계정 폭발(=초기 트렌드 신호) 놓침. 그래서 B로 *모방 가치 있는 마이크로 폭발* 별도 포착.

**실제 실행** (2026-05-21 18:03 KST, 명조에게 의뢰):

| 플랫폼 | 자동 수집 | 비고 |
|---|---|---|
| **유튜브 숏츠** | ✅ 가능 | Top 3 리포트 자동 생성 |
| 틱톡 | ❌ 캡차 차단 | |
| 인스타 | ❌ 로그인 필요 | |
| 도우인 | ❌ 차단 | 우회 경로(Tikboost)도 차단 |

---

#### 봇 2개 — 페르소나 5개 점검 항목 통과
- **Karpathy 초안에서 SOUL.md에 워크플로 3개 섞임** → 발견 → "구체 워크플로는 AGENTS.md 참고" 한 줄로 대체
- **명조는 처음부터 깨끗** (Karpathy 학습 적용으로 사전 예방)
- **MEMORY.md 사실/추정 라벨 명확화** — "ML 학습 중"이라 단정할 뻔한 걸 "구체 프로젝트는 대화에서 파악"으로 수정

#### 코드 학습 — 6개 Q + "확인 불가" 5건 정직 기록
주요 발견:
- **함정 1 (cd workspace 빠뜨림)** — `prompt_builder.py:1359 _load_agents_md()`는 *cwd-only*, recursive walk 없음. 한 단계 위에서 시작하면 그 세션 내내 AGENTS.md 영구 비활성. *세션 시작 후 cd 해도 안 통함* — prompt 캐시가 고정.
- **함정 2 (도구 호출 UI 표시 부재)** — `tool_executor.py:556-567`의 `tool_progress_callback`이 default None. 호출자가 등록 안 하면 도구는 실행되지만 UI 신호 안 감.
- **3-tier prompt 캐시 최적화** — `stable / context / volatile` 순서, 세션 중간 재조립 X. 이게 함정 1의 *진짜 깊이* — 비용 최적화 때문.
- **AGENTS / CLAUDE / .hermes.md / .cursorrules는 priority chain** — first match wins, 동시 활성화 불가.
- ⭐ **Subagent도 환각함** — Explore가 `_run_interactive_loop()` 같은 *없는 함수명*과 "PALS = Persistent Adaptive Learning System" 같은 *없는 컴포넌트*를 자신 있게 답함. 직접 `grep` 후 기각.

#### 절차화 — 가이드 작성 + 실제 실행으로 함정 4개 발견
*돌려보기 전에는* 안 보였던 함정:

| 함정 | v2 개선 방향 |
|---|---|
| 봇이 검색어를 자기 해석으로 멋대로 정함 | 입력 슬롯에 *진구 직접 검색 키워드 2~3개* 같이 받기 |
| 표본 5개는 Top 3 추리기엔 부족 | 표본 수 *고정 명시* + 부족 시 봇 경고 |
| B점수에 절대 조회수 floor 없음 (B=10.92인데 조회수 1,533 → 미니 폭발 오인) | A점수에 *24시간 기준 절대 조회수 1만 미만 자동 보류* 추가 |
| 4개 플랫폼 자동 가정이 깨짐 | "유튜브 1개 자동 + 3개 진구 보조" 구조로 재설계 |

---

### 시행착오

1. **가이드가 경고한 실수를 직접 한 번 함** — Karpathy SOUL에 "When 진구 asks '이 논문 어때?' → 4단계 답변 순서" 같은 워크플로 3개가 들어가 있었다. AGENTS.md "Workflow by task type"과 중복. 한쪽만 고치면 봇이 모순된 지시 받음. 이 실수를 *직접 겪고 고친* 게 1주차에서 가장 큰 학습.

2. **Explore subagent의 환각을 신뢰할 뻔함** — "PALS = Persistent Adaptive Learning System"이라고 자신 있게 답했으나, `grep -ri "PALS" --include="*.py"` 결과 빈 줄. *그럴듯한 컴포넌트를 만들어냄*. 가이드 룰("파일 직접 읽기")이 주 에이전트 뿐 아니라 *서브에이전트* 결과에도 적용돼야 함을 깨달음.

3. **트렌드 분석 가이드 실행 함정 4개** — 위 표 참고. 문서로만 만들었다면 절대 안 보였을 것들.

---

### 꿀팁 (자기 언어로)

- **봇은 캐릭터가 아니라 구조다.** SOUL/AGENTS/MEMORY가 *직교*일수록 봇이 일관성 있게 동작. 같은 사실도 봇 역할에 따라 *비중*이 달라짐 (Karpathy MEMORY는 "참고용", 명조 MEMORY는 "1차 컨텍스트").
- **신뢰 시스템도 검증한다.** Claude Code의 Explore 서브에이전트조차 환각함. "파일 직접 읽기" 룰은 *나에게* 적용되는 게 아니라 *내가 쓰는 모든 에이전트*에 적용돼야 한다.
- **완벽한 첫판 X, 돌려보고 개선.** 절차/가이드는 *합리적 기본값 + 측정 지점 + 개선 사이클* 3종 세트로 짜라. 안 정한 파라미터(임계값, 가중치)는 "첫 2주 데이터 보고 결정" 슬롯으로 비워둠.
- **"확인 불가"는 정직성.** [추론]을 그대로 [확인 불가]로 옮긴 게 5건. 거짓 자신감보다 정직한 모름이 더 가치 있다.
- **`.hermes.md`는 git root까지 walk** — workspace 자주 옮기는 사람은 AGENTS.md보다 `.hermes.md`로 옮기는 게 안전한 패턴.

---

### 도움 필요한 부분

- **도우인 자동 접근** — 현재 차단. 우회 경로(Tikboost) 시도했으나 실패. 다른 분들 경험 있으면 공유 부탁.
1주차 공유한 크롤링 코드 시도는 못해 봤습니다. 추후 시도해볼 예정
- **`tool_progress_callback` 등록 경로** — CLI/gateway가 *각자* 등록한다는 가설까지만 확인. 정확한 등록 시점은 추가 검증 필요.

---

### 앞으로의 계획

1. **Step 1 트렌드 분석 가이드 2주 운영 데이터 쌓기** → v2 정리 (함정 4개 반영, 임계값 결정)
2. **Step 2~5 절차화 순차 진행** (제품 크롤링 → 가공 → 업로드 → 성과 분석)
3. 카테고리 필터 *고정 N개* 봇 메모리에 박기 (현재는 매일 디스코드 입력)
4. **세 봇 영역 분리 실전 검증** — 도라에몽(비서) / Karpathy(ML) / 명조(콘텐츠) 영역 침범 없는지

---

## 도움 받은 글

- **1주차 과제 가이드** (`week-01-assignment-guide-revised-utf8-bom.md`) — SOUL/AGENTS/MEMORY 역할 구분 + Q0~Q6 코드 학습 룰 + 가이드 작성 템플릿
- **Hermes Agent 공식 레포** (NousResearch/hermes-agent v0.14.0, MIT) — 코드베이스 직접 학습 대상
- **별첨 파일 (이 게시글의 원자료):**
  - `submission-task1.md` — 봇 2개 상세 + 페르소나 비교표
  - `submission-task1-conversations.md` — 봇과의 실제 대화 로그
  - `STUDY-LOG.md` — hermes-agent 코드베이스 Q0~Q6 누적 (344줄)
  - `submission-task5.md` + `submission-task5-step1-trend-analysis.md` — 트렌드 분석 절차화 가이드

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


이창민님 글은 1주차 과제를 “봇 하나 만들기”로만 끝내지 않고, 좌뇌형 Karpathy와 우뇌형 명조를 비교하면서 SOUL / AGENTS / MEMORY 분리 원칙을 몸으로 확인하신 점이 좋았습니다. 특히 Karpathy 초안에서 SOUL.md에 워크플로우가 섞였던 실수를 발견하고, 두 번째 봇에서는 그 실수를 예방한 흐름이 학습 기록으로 잘 남아 있었습니다.
코드베이스 학습에서도 [확인] / [추론] / [확인 불가]를 강제로 나누신 점이 인상적이었습니다. 서브에이전트의 그럴듯한 환각까지 다시 grep으로 기각한 부분은, “에이전트를 쓰는 법”뿐 아니라 “에이전트 결과를 검증하는 법”을 같이 보여주는 사례로 보입니다.
트렌드 분석 절차화도 문서에서 끝내지 않고 실제로 돌려보면서 틱톡/인스타/도우인 접근 차단, 표본 수, 조회수 floor 같은 함정을 발견하신 게 중요했습니다. 완벽한 첫판보다 합리적 기본값과 측정 지점, 개선 사이클을 잡으신 방향이 좋습니다.
다음 한 걸음은 Step 1 트렌드 분석만 2주 동안 작게 운영해보고, 검색 키워드 2~3개, 표본 수, 절대 조회수 기준처럼 “봇이 임의로 정하면 안 되는 값”만 v2 가이드에 고정해보시면 좋겠습니다. 그러면 이후 2~5단계로 확장할 때도 기준이 훨씬 안정적일 것 같습니다.
많은 사례글에도 불구하고 하나하나 읽고 답변 달아 주셔서 감사합니다. 피드백 참고하겠습니다. 감사합니다.