Hermes 에게 색인집을 만들어주기

2026.06.11
Hermes Agent로 BigQuery → Sheets 일간 모니터 자동화 + 세션 인계 시스템 구축기
Hermes Agent 자동화 목표
Hermes Agent가 데이터 업무(BigQuery 조회 → 스프레드시트 자동 갱신)를 직접 수행하게 만들고, 새 세션마다 맥락을 다시 설명하지 않아도 되는 구조 만들기
다루는 BigQuery 프로젝트에 데이터셋이 100개가 넘어, "어떤 테이블에 무엇이 있는지" 찾는 것부터가 매번 큰 비용이었음.
매일 반복되는 지표 조회 → 시트 정리 작업을 사람이 아닌 에이전트가 수행하는 자동화 파이프라인으로 만들고자 했음.
Hermes와 작업하면서 가장 큰 문제는 세션이 리셋되거나 컨텍스트가 압축될 때마다 환경·권한·식별자·규칙을 처음부터 다시 설명해야 한다는 점이었고, 이를 해결할 인계(메모리) 체계를 함께 구축하고자 했음.
활용한 도구와 기술
Hermes Agent (OpenClaw 기반): 셸 명령 실행, 파일 편집, 스킬 호출까지 실제 작업을 수행하는 본체.
OpenClaw Skills (95개): Google Workspace 작업용 스킬(gws-script, gws-script-push, gws-sheets 등) + 작업에 맞는 스킬을 알아서 찾아주는
find-skills메타 스킬.~/.agents/skills/에 설치.Google Cloud SDK (
gcloud,bq): Hermes가 호출하는 GCP 인증 및 BigQuery 조회 도구.gws CLI: Hermes가 Drive/Sheets/Apps Script를 조작할 때 쓰는 손발.
Apps Script: BigQuery 쿼리 결과를 매일 정해진 시간에 시트로 자동 갱신하는 자동화 본체 (Hermes가 코드 작성·푸시).
메모리 파일 (AGENTS.md / 지식백과): 모든 새 세션이 자동으로 읽고 시작하는 장기기억 층.
진행 세부 내용
1️⃣ 환경 셋업 — Hermes의 손발(CLI) 뚫어주기
Hermes가 GCP와 Workspace까지 닿으려면 먼저 손발이 있어야 함. Homebrew → Google Cloud SDK → gws CLI 순으로 셋업하고, OAuth 인증(scope: cloud-platform, spreadsheets, drive, script.projects)을 완료함.
gcloud: command not found부터invalid_client,Permission Denied,RESOURCES_NOT_FOUND까지 인증/권한 에러를 하나씩 해결했는데, 이 과정은 작업 스레드가 아닌 별도 "정비" 흐름으로 분리해 진행함 (작업 컨텍스트 오염 방지).도구별 비용 구조를 정리해 운영 원칙을 세움: Hermes가
bq/gws/gcloud를 직접 호출하면 추가 비용 없음, BigQuery는 실제 데이터 스캔량만 과금 → "메타데이터만 보면 공짜, 에이전트는 판단에·CLI는 노동에".
2️⃣ BQ 메타 캐시 — 800개+ 테이블, 1.5만 개+ 컬럼을 Hermes의 로컬 색인집으로
처음에는 "어떤 테이블 봐야 해?"라고 물을 때마다 Hermes가 BigQuery에 쿼리를 날려 탐색했는데, 데이터셋이 100개가 넘으니 시간도 오래 걸리고 탐색 로그가 세션 컨텍스트를 금방 오염시켰음.
그래서 매일 새벽 한 번 BigQuery 전체 카탈로그(테이블 목록 + 전체 컬럼 목록 + 핵심 테이블 상세 스키마)를 떠와 **로컬 CSV/JSON(약 800KB)으로 캐싱하는
sync.sh**를 Hermes에게 만들게 함.이후로는 어떤 질문이든 Hermes가 BQ에 다녀오는 대신 로컬 파일을 grep 한 번으로 1초 안에 답함. 컨텍스트 윈도우에 거대한 스키마를 들이붓는 대신, 에이전트 작업실 책상 위에 색인집 한 권만 올려둔 셈.
이 캐시의 경로와 사용법을 메모리 파일에 등록해,
/new로 세션을 리셋해도 모든 새 세션이 색인집의 존재를 알고 시작하게 만들었음.
3️⃣ BigQuery → Sheets 일간 모니터 자동화
원래는 Sheets의 Connected Sheets(데이터 커넥터) 기능을 자동화하려 했으나, 공식 API 경로가 없는 UI 전용 기능임을 확인함.
대신 표준 우회 패턴인 Apps Script 내장 BigQuery 서비스를 채택: 매일 오전 10시 트리거 → BQ 쿼리 실행 → 모니터링 시트 자동 기록.
Apps Script 코드(.gs/.html)는 Hermes가
gws-script-push스킬로 직접 푸시: "코드 수정해줘" 한마디 → 수정 → 푸시 → 배포까지 에이전트가 완결하는 루프를 만들었음.지표 추출에 필요한 상태값 코드(매직넘버)와 자주 쓰는 쿼리 패턴도 카탈로그화해 스킬/메모리에 반영함.
4️⃣ "지식백과" + 인계 템플릿 — 세션은 리셋해도 기억은 리셋되지 않게
위 모든 작업의 환경 정보, 핵심 식별자, 도구 구분표, 데이터셋 지도, 매직넘버, 쿼리 패턴, 자주 만나는 에러를 하나의 지식백과 문서로 정리함 (v1 → v2 개편).
문서 마지막에 "새 세션에 던질 인계 템플릿" 섹션을 두어, 세션 리셋 직후 이것만 주입하면 이전 맥락이 그대로 복원되게 했음.
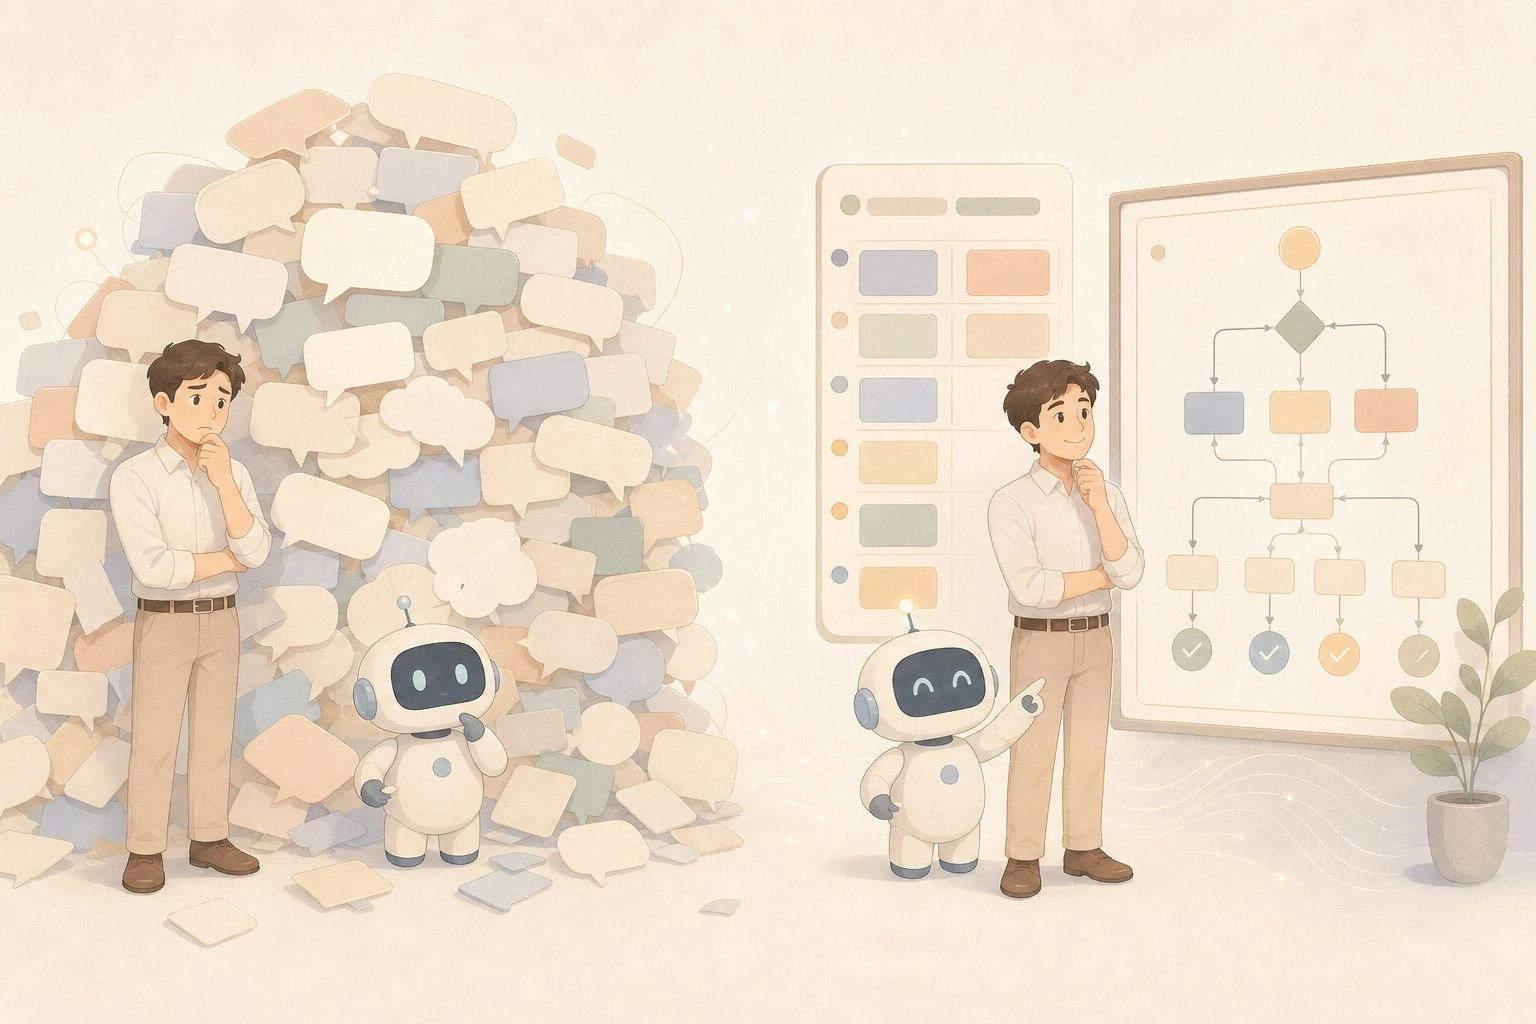
결과적으로 운영 방식이 바뀜: 긴 세션 하나를 컨텍스트 압축까지 견디며 끌고 가는 게 아니라, 잘 정리된 장기기억(문서) 위에서 매번 깨끗한 새 세션을 시작하는 구조. "오래 기억하는 에이전트"가 아니라 "잘 인수인계받는 에이전트"를 만든 것임.
시행착오와 개선점
긴 셸 명령어 깨짐: 멀티라인으로 쪼개진
gcloud auth명령어를 zsh가 URL 일부를 파일 경로로 해석해 "no such file or directory" 에러 발생 → 한 줄 명령으로 재구성. 에이전트가 만든 명령도 사람이 한 번 검수해야 함을 배움.프로젝트 표시명 ≠ 실제 프로젝트 ID: 콘솔에 보이는 이름과 실제 ID가 달라 403/404를 여러 번 맞음 →
gcloud projects list로 실제 ID를 먼저 확인하는 절차를 스킬/메모리에 명시.Connected Sheets는 API 자동화 불가: Google이 의도적으로 UI 전용으로 둔 영역 → Apps Script 내장 BigQuery 서비스로 우회.
자격증명이 대화에 노출되는 사고: 셋업 과정에서 OAuth client_secret 값이 에이전트와의 대화에 박제됨 → 해당 자격증명의 rotate를 검토하기로 함. 에이전트에게 인증 작업을 시킬 때는 시크릿이 컨텍스트에 남지 않게 설계하는 것이 먼저라는 교훈.
탐색 로그가 작업 세션을 오염시킴: BQ 탐색, 에러 해결, 실제 작업이 한 세션에 뒤섞이면 컨텍스트 압축 시 오염된 맥락까지 이어받음 → 환경/지식은 메모리 파일로 빼고, 정비는 별도 흐름으로 분리하고, 작업은 새 세션에서 시작하는 방식으로 전환.
배운 점과 향후 계획
탐색과 자동화는 순서가 있다: "뭐가 있는지 모르는 상태"에서 자동화부터 시키는 건 실패의 지름길. 메타데이터 탐색 → 후보 좁히기 → 자동화 설계 순서가 정석임을 체감함.
에이전트에게 외우게 하지 말고 색인집을 쥐여줘라: 거대한 카탈로그를 매번 컨텍스트에 넣는 대신, 로컬 캐시 + grep 조합이 토큰·비용·시간·컨텍스트 청결도 모두에서 압도적으로 유리했음. 컨텍스트 윈도우는 창고가 아니라 작업대임.
메모리 파일이 곧 컨텍스트다: 지식백과 + 인계 템플릿 + 자동 로드되는 메모리 파일 조합으로, 세션 리셋이 "기억상실"이 아니라 "잘 인수인계받은 신입의 첫 출근"이 되게 만들 수 있었음.
도구별 토큰/과금 구조를 알면 운영이 달라진다: 에이전트 추론(토큰 과금)과 CLI 직접 호출(무료)을 구분하고, BQ는 메타데이터만 보면 무료라는 점을 활용해 분업 설계가 가능했음.
스킬에는 반복 가능한 절차만: 일회성 에러 해법을 스킬에 다 넣으면 다음 실행 때 불필요한 맥락을 끌고 옴. 검증된 절차(예: "실제 프로젝트 ID 먼저 확인")만 스킬에 남기고, 일회성 이슈는 지식백과의 "함정" 섹션으로 분리함.
인증/보안은 자동화의 전제 조건: 시크릿 노출 사고 이후, 자격증명은 Secret Manager 등에서 참조만 하고 대화에는 절대 붙여넣지 않는 원칙을 세움.
향후 계획
현재 일간 모니터를 넘어, "지식 카드 워크북" MVH를 구축할 계획임: 인사이트/메시지 카드를 versioned로 저장하고, LLM이 실험 결과를 읽어 카드 상태 변경을 제안만 하면(review_queue 경유), 사람이 승인해야 반영되는 자가진화 루프 구조.
에이전트가 마스터 데이터를 직접 수정하지 못하게 하는 원칙(제안 → 사람 승인 → 자동 반영 → 모든 변경 append-only 로그)을 코드 레벨에서 강제할 예정.
다른 스터디원들의 사례처럼, 세션·스레드 분리를 넘어 역할별 운영 분리(작업 / 검수 / 정비 / 기억관리)를 이 BQ 자동화 워크플로우에도 적용해볼 계획임.
BQ 메타 캐시의 화이트리스트(데이터셋/HOT 테이블)를 점진적으로 넓히고, 지식백과를 살아있는 문서로 계속 갱신할 계획임.
도움이 필요한 점
1️⃣ 메모리 파일/지식백과의 자동 갱신 체계
현재 상황: 환경·식별자·매직넘버·쿼리 패턴을 담은 지식백과를 수동으로 v1 → v2 개편하며 관리 중. 작업이 늘어날수록 문서와 실제 상태가 어긋나는 순간이 생김.
시도한 방법: 큰 변화가 있을 때마다 에이전트에게 기존 문서를 주고 전면 개편을 요청하는 방식으로 갱신.
필요한 도움: 작업 결과(새 테이블, 새 트리거, 새 에러 해법 등)가 생길 때마다 에이전트가 메모리 파일에 자동/반자동으로 반영하되, 일회성 노이즈는 걸러내는 워크플로우 설계에 대한 아이디어가 필요함. ("무엇을 장기기억으로 남기고 무엇을 버릴지"의 판단 기준)
2️⃣ LLM 제안 → 사람 승인 루프(review_queue)의 운영 노하우
현재 상황: 지식 카드 자가진화 루프를 설계 단계에서 "에이전트는 제안만, 승인은 사람"으로 정했으나, 실제 운영 시 승인 병목이나 제안 품질 관리 문제가 예상됨.
시도한 방법: 핸드오프 문서에 비-목표(에이전트의 직접 수정 금지, append-only 로그 등)를 명시하는 수준까지 진행.
필요한 도움: 비슷한 human-in-the-loop 구조를 운영해본 분들의 승인 기준 설계, 제안 품질 평가, 병목 완화 경험 공유가 필요함.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요