큰 산출물의 서브에이전트 위임 비율 측정 스크립트 만들기
2026.10.22
소개
Claude Code로 문서와 코드를 큰 단위로 만드는 분 가운데 서브에이전트에 맡기라는 규칙은 적어 두었지만 실제로 맡겨졌는지는 세어 보지 않은 분께 도움이 될 내용입니다. 세션 로그에서 코드 150줄 이상, 글 2,000자 이상의 산출물을 메인과 서브에이전트 중 어느 쪽이 썼는지 세는 스크립트를 검사부터 먼저 써서 만들었고, 그 결과로 위임 비율을 구했습니다. 측정은 2026-10-22에 했고, 로그와 설정 파일은 읽기만 했습니다.
저는 청강생입니다. 3주차 수업은 수강생 여덟 분의 사례 발표와 스터디장의 Paseo 사용법 소개로 이뤄졌습니다. 발표는 Orca로 여러 코딩 에이전트를 한 팀으로 붙인 사례, Paseo로 강의 자료 일곱 편을 에이전트 28개에게 나눠 만든 사례, 제작 AI와 검토 AI를 나눴더니 검토가 끝나지 않았다는 사례, 오래된 노트북을 서버로 삼아 휴대폰에서 이어 작업한 사례 등이었습니다. Orca가 터미널 위주였다면 Paseo는 앱 화면이고, 프로젝트 폴더 아래에 워크스페이스를 두고 워크스페이스마다 여러 에이전트를 띄웁니다. 승인 방식은 매번 묻기, 자동, 전부 허용(bypass) 중에서 고릅니다. 에이전트는 Paseo라는 도구가 있다는 것을 모르므로 도구를 켜 주고 오케스트레이션 스킬을 설치해야 합니다. 에이전트마다 모델, 사고 강도, 승인 방식, 쓰임새를 적어 두는 프로필도 소개했습니다. 마지막 당부는 작업마다 어느 모델과 강도로 충분했는지 경험을 쌓아 "나만의 스마트 라우팅"을 만들라는 것이었습니다.
지난 글에는 위임하라는 규칙만 적어서는 실제 작업을 메인이 몰아서 했을 수 있다는 댓글이 달렸습니다(킹슈민 님). 2주차 글에서는 메인의 출력 토큰 비중 95.5%를 보았는데, 그 값만으로는 위임이 실제로 일어났는지 알 수 없다고 다음 주 계획에 적어 두었습니다. 이번 글은 그 계획을 실행한 기록이며, 도중에 2주차까지의 출력 비중 집계에 오류가 있다는 것도 확인했습니다.
진행 방법
사용 도구: Claude Code, Python 3, pytest, matplotlib, 셸 명령
Step 1. 3주차 기준을 잴 항목표
발표와 지식 공유에서 제 로그와 설정 파일로 셀 수 있는 것만 골랐습니다.
기준 | 3주차에서 나온 내용 | 잴 것 |
|---|---|---|
비싼 모델은 만드는 쪽보다 검수에 | 공인중개사 강의 자료 사례에서 비싼 모델은 만드는 데 쓰지 않고 검수에 썼다고 했고, 스터디장의 사례는 리서치를 여러 개 병렬로 맡기고 글쓰기는 글을 잘 쓰는 모델에 맡겼다 | Agent 호출을 일의 종류별로 나눈 모델 인자 |
에이전트 프로필 | 에이전트마다 모델, 사고 강도, 승인 방식, 쓰임새를 저장 | 제 에이전트 정의 파일에 있는 항목 |
승인 방식 | 매번 묻기, 자동, bypass. 자동 검토 모드는 위험 점검 에이전트를 따로 불러 사용 한도를 더 쓴다 | 설정 파일의 승인 관련 키 |
끝나지 않는 검토 | 제작 AI와 검토 AI를 나눴더니 검토가 계속 이어졌다는 발표 | 검수 호출 횟수, 규칙 파일의 상한 문구 |
위임 | 3주차 과제로 소개된 "내 업무 하나를 위임하거나 반복 업무 하나를 적용" | 큰 산출물 중 서브에이전트가 쓴 비율 |
3주차 과제는 채팅 로그에 문구가 없고, 한 수강생이 발표에서 스터디장의 커리큘럼을 전하는 말로만 확인됩니다. Paseo를 설치하지 않았으므로 Paseo에 업무를 위임하는 과제는 하지 못했고, 이미 쓰는 Claude Code의 서브에이전트 위임을 측정하는 것으로 대신했습니다.
Step 2. 2주차 계획의 실행 여부
2주차 글에서 뗀 다음 주 계획의 항목마다 파일과 로그로 실행 여부를 확인했습니다.
ls /Applications | grep -i -E 'orca|paseo'; command -v orca paseo; brew list --cask | grep -i -E 'orca|paseo'
stat -f '%Sm %N' -t '%m-%d %H:%M' ~/.claude/agents/editor.md ~/.claude/rules/agent-routing.md
grep -c '^model:' ~/.claude/agents/editor.md
# (설치 확인 세 명령은 출력 없음)
# 06-08 17:34 /Users/<내 계정>/.claude/agents/editor.md
# 10-08 01:04 /Users/<내 계정>/.claude/rules/agent-routing.md
# 0
2주차 계획 | 확인 결과 |
|---|---|
Orca와 Paseo 설치 | 실행하지 않음. 설치 확인 세 명령에 출력이 없고 3주차에도 설치하지 않았습니다 |
| 실행하지 않음. 파일 수정일이 6월 8일 그대로이고 |
위임 규칙을 먼저 시험할 프로젝트 | 정하지 않음. 규칙 파일은 10월 8일 01시 04분 그대로이고 시험 프로젝트를 가리키는 파일이 없습니다 |
위임 여부 보조 스크립트 | 실행. Step 3에서 만들었습니다 |
세션 로그가 줄어든 원인 | 구간 JSON 저장은 실행했고 원인은 찾지 못했습니다. Step 6에서 다룹니다 |
| 구분하지 못함. 호출은 이전 구간 25회, 2주차 구간 1회, 3주차 구간 4회입니다 |
라우팅 기준표 첫 줄 | 4주차 작업이라 미실행. 후보 값만 Step 6에서 다시 쟀습니다 |
하루 53회 호출한 날의 유형 분류 | 실행하지 않음 |
재측정 다섯 값 | 실행. Step 6에서 같은 길이의 구간으로 다시 쟀습니다 |
Step 3. 위임 여부 보조 스크립트와 검사
큰 산출물을 "Write 도구로 쓴 코드 150줄 이상 또는 글 2,000자 이상"으로 정하고, 이 산출물을 메인과 서브에이전트 중 어느 쪽이 썼는지 셉니다. 기준값은 전역 위임 규칙의 임계값입니다. 이 값은 측정으로 정한 것이 아니라 추정이므로 Step 4에서 바꿔 가며 봅니다. 서브에이전트 기록은 경로에 subagents가 있는 파일입니다.
참값을 아는 모의 세션 로그를 먼저 만들고 검사를 쓴 뒤에 구현했습니다. 모의 로그에는 메인의 코드 200줄, 메인의 코드 100줄, 서브에이전트의 글 3,000자, 중복 기록된 호출 하나, 데이터 파일, 기간 밖 기록, Edit 호출을 넣었고 정답은 손으로 계산해 두었습니다.
cd 3주차/실습
python3 -m pytest -q -p no:cacheprovider test_delegation_audit.py   # 구현 전
python3 -m pytest -q -p no:cacheprovider                            # 구현 후, 출력 검사까지 포함
# ModuleNotFoundError: No module named 'delegation_audit'   (구현 전, 수집 단계에서 실패)
# 13 passed in 0.18s
구현 직후에는 한 건이 실패했습니다. 1/3을 반올림한 값을 비교하는 검사의 허용 오차가 잘못돼 있었고, 구현이 아니라 검사 쪽을 고쳤습니다. 실제 로그에 처음 돌렸을 때는 시각 비교에서 오류가 났습니다. 명령줄에 Z 없이 적은 시각을 UTC로 읽는 규칙이 빠져 있었습니다. 이것도 검사를 먼저 추가해 실패를 본 뒤에 고쳤습니다. 이 규칙은 2주차 측정 스크립트가 쓰던 것과 같습니다.
python3 delegation_audit.py --since 2026-10-07T16:05:00 --until 2026-10-21T15:00:00 --out ../assets/위임_규칙이후전체.json
# {"code_lines": 150, "doc_chars": 2000, "main_big": 130, "sub_big": 303, ..., "big_total": 433, "delegated_share": 0.6998}
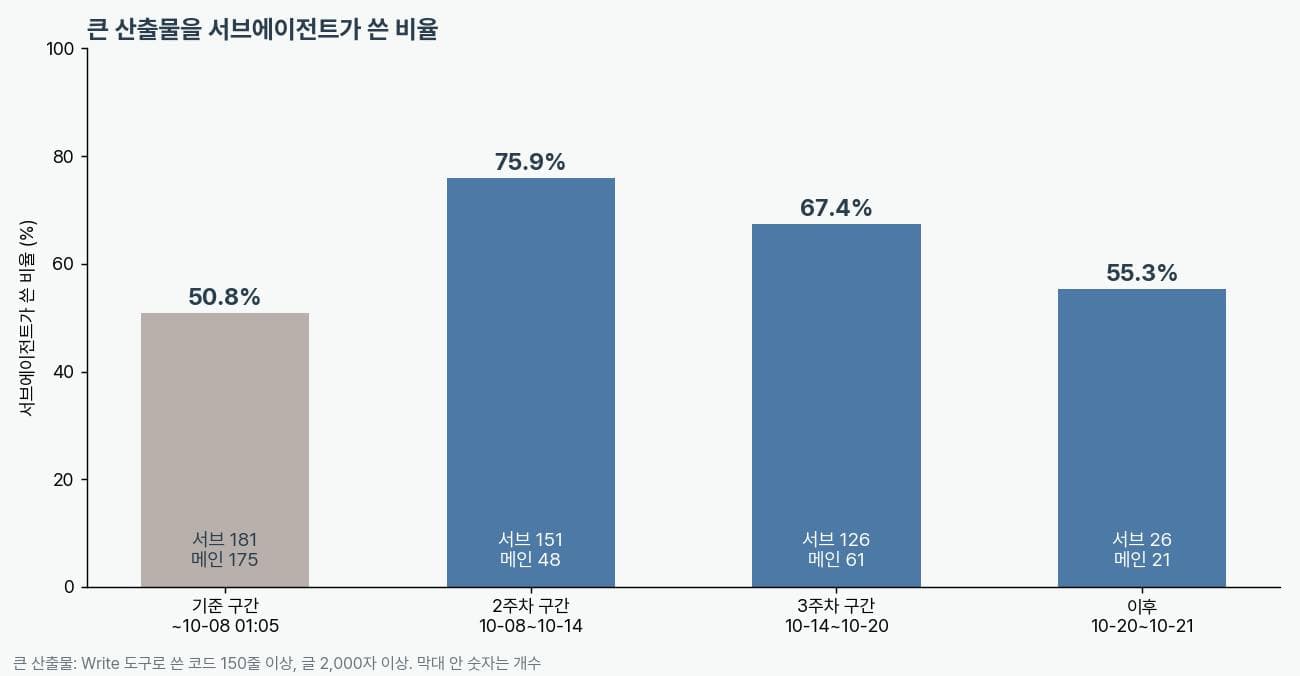
규칙 저장(10월 8일 01시 05분) 이후 14일 동안 큰 산출물 433개 중 303개(70.0%)를 서브에이전트가 썼습니다. 코드만 보면 62개 중 45개(72.6%), 글만 보면 371개 중 258개(69.5%)입니다. 글자 수로 세면 서브에이전트가 3,435,845자, 메인이 789,645자를 써서 81.3%가 서브에이전트입니다. 규칙 이전 구간(로그가 남은 8월 23일부터 10월 8일 01시까지)은 356개 중 181개(50.8%)였습니다.
한계가 둘 있습니다. Write 도구로 쓴 파일만 세므로 셸 heredoc으로 쓴 150줄 이상의 내용은 빠집니다. 따로 세어 보니 메인이 26건, 서브에이전트가 117건이었고, 이를 합치면 420/576, 즉 72.9%로 크게 달라지지 않습니다. 또 이 비율은 규칙 때문에 올랐는지를 가르지 못합니다. 규칙 이전에도 위임이 많은 날이 있었습니다.
Step 4. 임계값 민감도
규칙의 임계값이 추정이므로 코드 50, 100, 150, 300줄과 글 1,000, 2,000, 4,000자의 열두 조합에서 위임 비율을 다시 계산했습니다.
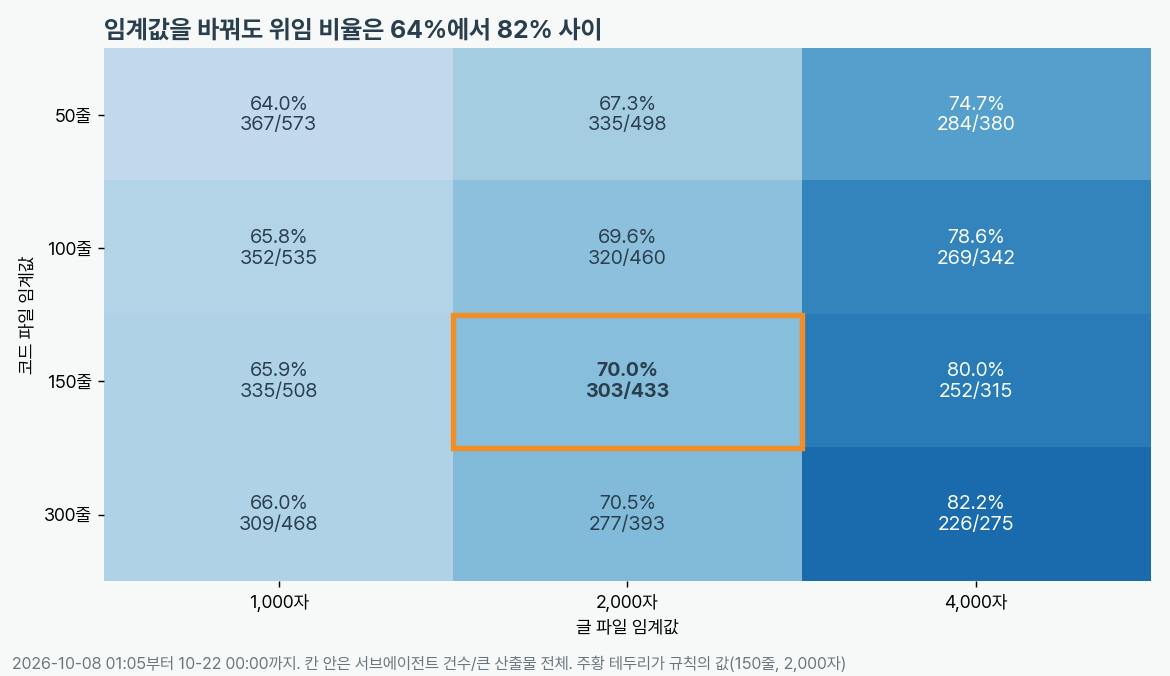
열두 조합 모두 64.0%에서 82.2% 사이였고, 어느 조합에서도 메인이 절반을 넘지 않았습니다. 임계값을 높이면 비율이 올라갑니다. 글 임계값을 1,000자에서 4,000자로 올리면 메인이 쓴 글은 156개에서 46개로, 서브에이전트가 쓴 글은 290개에서 207개로 줄어, 메인이 쓰는 글은 짧은 것이 많다는 점을 알 수 있습니다. 규칙 이전 구간도 같은 열두 조합으로 다시 계산하니 46.0%에서 66.3%였고, 같은 임계값끼리 짝지어 보면 열두 조합 모두 규칙 이후가 15.8에서 20.0%p 높았습니다.
Step 5. 날짜별 추이
규칙 저장 시각 앞뒤가 갈리는지 날짜별로 보았습니다. 날짜는 한국 시각입니다.
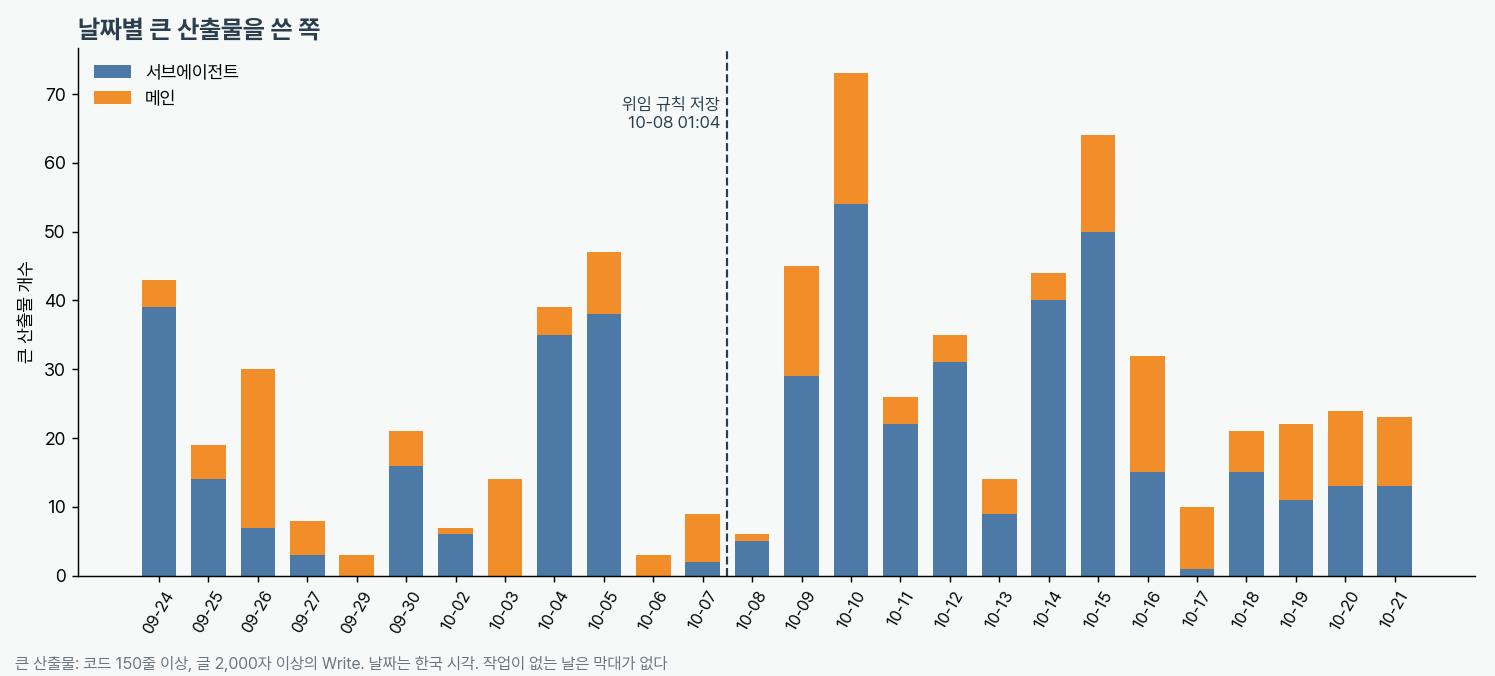
위임 비율은 날마다 크게 달라졌습니다. 규칙 이전인 10월 4일과 5일에 서브에이전트가 각각 35개와 38개를 썼고(비율 90%와 81%), 10월 3일은 메인 14개와 서브 0개였습니다. 규칙 이후에도 10월 17일은 10개 중 1개만 서브에이전트가 썼습니다. 일이 문서 대량 생성이면 서브에이전트에 맡기고 한두 개 고치는 일이면 메인이 쓰는 식으로 일의 성격이 비율을 좌우하는 것으로 보이며, 이번 측정은 작업 종류를 가르지 않아 규칙의 효과와 일의 성격을 분리하지 못합니다.
Step 6. 재측정과 출력 비중 집계의 오류
2주차 계획대로 이전 구간과 같은 길이(5일 23시간 7분)의 구간을 새로 만들어 나란히 놓았습니다. 구간 JSON은 그 자리에서 저장했습니다. 시각은 한국 기준이며 UTC로는 9시간을 뺀 값을 넣었습니다.
M=~/Documents/Study/GPTers/24기/_tools/measure_agent_routing.py
python3 $M --since 2026-10-13T15:12:00 --until 2026-10-19T15:19:00 --out 3주차/assets/재측정_20261014이후_같은길이.json
python3 $M --since 2026-10-07T16:05:00 --until 2026-10-13T15:12:00 --out 3주차/assets/재측정_2주차구간_다시.json
python3 $M --until 2026-10-07T14:10:00 --out 3주차/assets/재측정_기준구간_다시.json
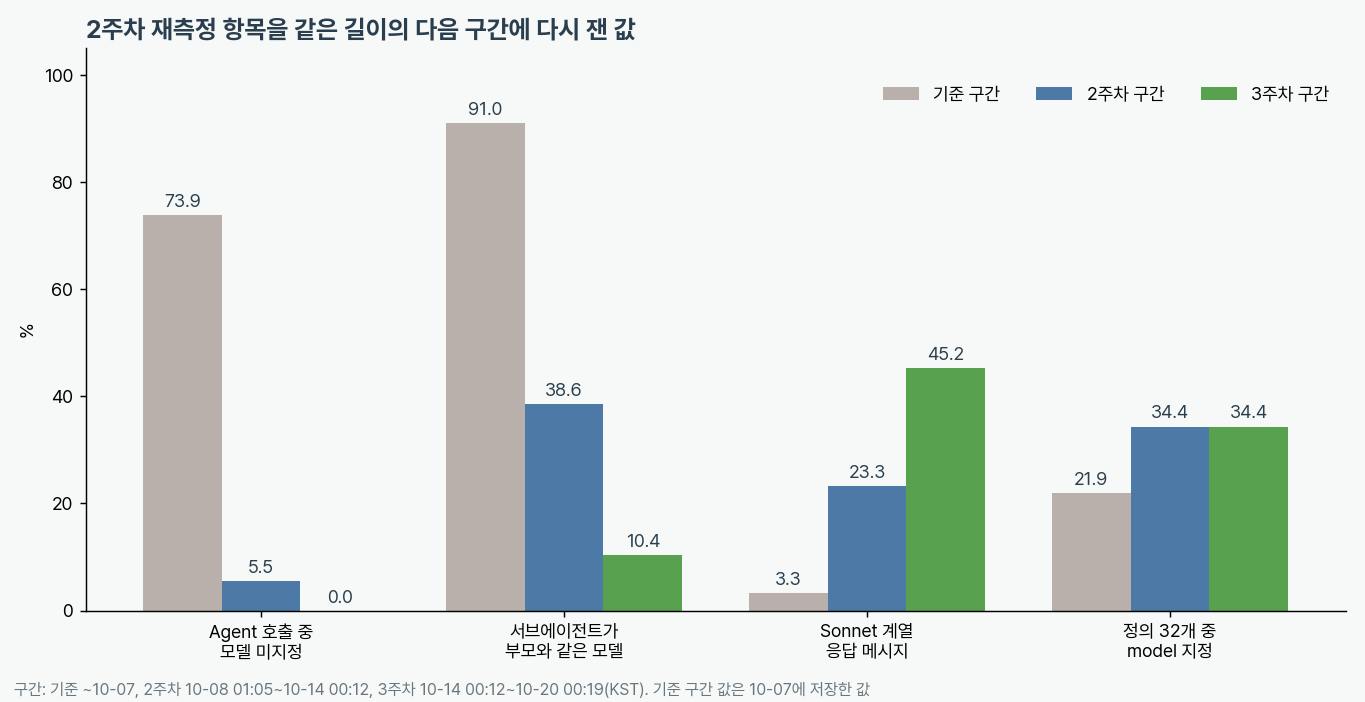
3주차 구간(10월 14일 00시 12분부터 10월 20일 00시 19분)에는 Agent 호출 121회 중 모델 미지정이 0회, sonnet 106회, opus 15회였습니다. 정의 파일의 model 지정은 32개 중 11개(opus 4, sonnet 7)로 2주차와 같습니다. 모델을 지정하는 규칙은 계속 지켜졌고, 달라진 것은 호출 쪽이었습니다.
그런데 이 재측정에서 이상한 값이 보였습니다. 2주차 구간에서 서브에이전트가 Write로 쓴 글자가 1,846,339자인데, 같은 구간 서브에이전트의 출력 토큰은 171,302개로 기록돼 있었습니다. 한글과 코드는 글자당 토큰이 1개 안팎이므로 토큰이 글자 수의 9% 수준일 수는 없습니다. 로그를 열어 보니 서브에이전트 기록은 한 메시지가 스트리밍으로 여러 줄 남고, 첫 줄의 output_tokens가 작은 값이었습니다. 1주차와 2주차 스크립트는 (message.id, requestId)가 같은 줄을 처음 본 것만 세어 서브에이전트 출력을 낮게 셌습니다. 메시지별로 가장 큰 값을 쓰도록 모의 로그 검사를 먼저 쓰고(네 건 실패를 확인), 새 집계 스크립트를 만들었습니다. Write가 든 5,000자 이상의 메시지를 표본으로 보니 출력 토큰이 글자 수의 0.76배(서브에이전트)와 0.86배(메인)로 중앙값이 나와, 가장 큰 값을 쓰는 쪽이 글자 수와 맞습니다.
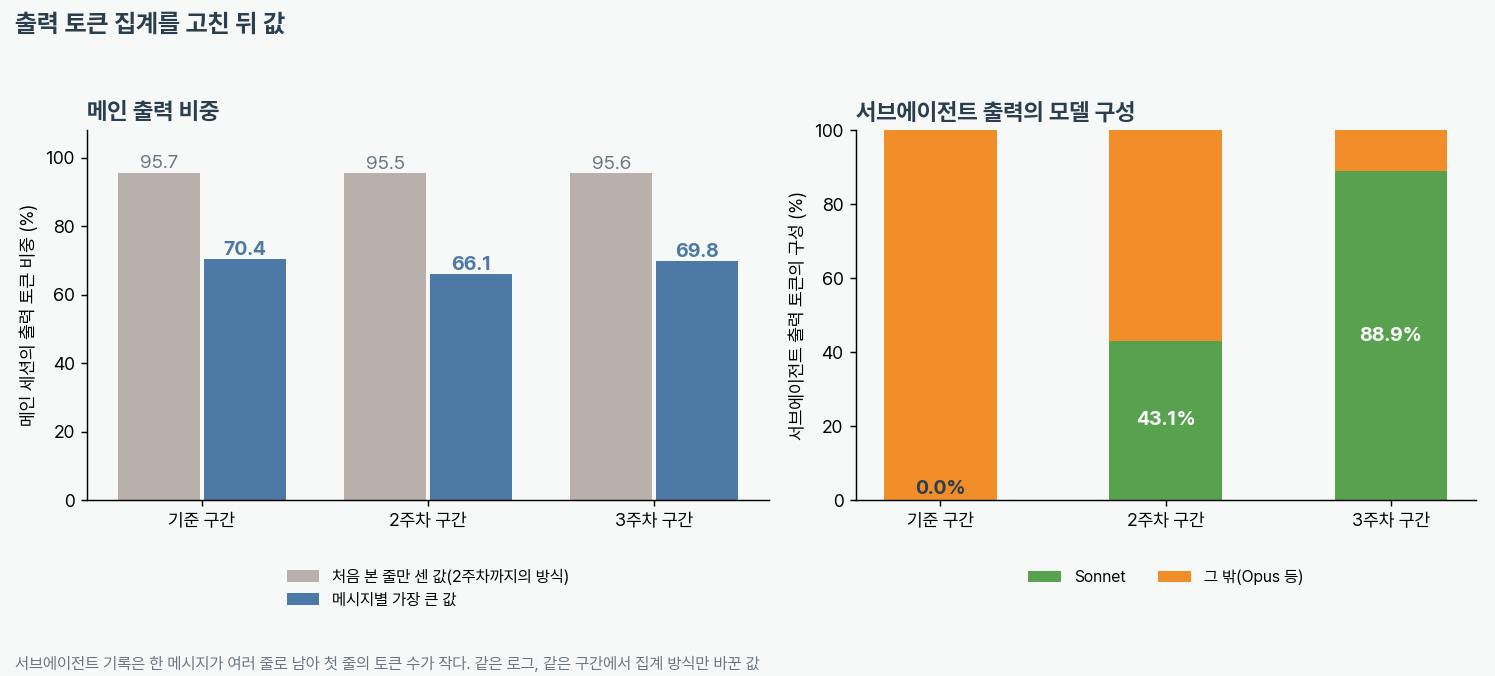
python3 output_share.py --since 2026-10-07T16:05:00 --until 2026-10-13T15:12:00 --method first   # 2주차 방식
python3 output_share.py --since 2026-10-07T16:05:00 --until 2026-10-13T15:12:00                    # 가장 큰 값
# main_share 0.9546 (서브 171,282 토큰)   main_share 0.6614 (서브 1,844,383 토큰)
고친 값은 2주차 구간 66.1%, 3주차 구간 69.8%, 기준 구간 70.4%입니다. 서브에이전트 출력 토큰 중 Sonnet 비중은 기준 구간 0.05%, 2주차 구간 43.1%, 3주차 구간 88.9%로 올랐고, 전체 출력 토큰 중 Sonnet은 3.9%, 18.5%, 30.3%입니다. 1주차 글의 "서브에이전트를 전부 Sonnet으로 바꿔도 출력 환산 금액이 2.2%만 줄어든다"는 계산과 2주차 글의 "모델을 낮춰도 메인의 출력은 그대로"라는 결론은 틀린 집계 위에 있었습니다. 단가는 이번에 새로 적용하지 않았으므로 금액 환산은 하지 않았습니다.
세션 로그가 줄어드는 문제는 더 진행됐습니다. 같은 기준 구간을 다시 만들면 응답 메시지가 10월 7일 저장값 24,146건, 10월 14일 재측정 23,559건, 오늘 22,179건이고 Agent 호출은 264회, 245회, 226회입니다. 가장 오래된 로그 파일의 수정일이 10월 14일 기록의 8월 23일에서 오늘 8월 30일로 밀렸고, 전역 설정에 보관 기간 키(cleanupPeriodDays)는 없습니다. 파일이 지워진다면 보관 기간 정리가 의심되지만, 8월 23일 날짜의 메시지가 더 새로운 파일 안에 남아 있어 원인은 확인하지 못했습니다. 비율은 거의 같게 유지됩니다(모델 미지정 73.5%, 저장값 73.9%).
Step 7. 강의 기준에 비춘 제 설정
Step 1의 항목 가운데 로그와 설정으로 확인되는 것을 마저 셌습니다. 일의 종류는 호출의 유형 이름과 작업 제목의 키워드로 가른 근사값이며 분류가 틀렸는지는 따로 검증하지 않았습니다.
python3 agent_calls_by_role.py
# 종류별_모델인자: 작성류 sonnet 19 opus 4 / 조사류 sonnet 14 opus 2 / 검수류 sonnet 2 opus 1 / 그 밖 sonnet 71 opus 8
grep -c '^description:' ~/.claude/agents/*.md | grep -c ':1'     # 32
grep -l -i -E '^(effort|thinking|reasoning)' ~/.claude/agents/*.md | wc -l     # 0
grep -n -E '최대 [0-9]+회|횟수 제한' ~/.claude/rules/agent-routing.md          # 출력 없음
강의 기준 | 제 상태 |
|---|---|
비싼 모델은 검수에 | 3주차 구간 Agent 호출 121회 중 검수류는 3회이고 |
에이전트 프로필 | 정의 파일 32개에 역할 설명은 전부 있고 |
승인 방식 | 전역 설정에 허용 목록 14개가 있고 위험 확인 건너뛰기( |
끝나지 않는 검토 | 세션당 검수류 호출은 최대 1회입니다. 규칙 파일에 검토 횟수 상한 문구는 없습니다 |
검수에 비싼 모델을 쓴다는 기준에는 제 호출이 맞지 않았습니다. 검수류가 적은 것은 제 일이 대부분 문서 생성과 자료 정리여서일 수 있고, 키워드로 가른 근사값이라 검수 호출이 더 있었을 가능성은 남습니다.
결과와 배운 점
측정 결과 (2026-10-22 기준, ~/.claude/projects jsonl 589개)
항목 | 값 |
|---|---|
큰 산출물 중 서브에이전트가 쓴 비율 (10-08 01:05~10-22 00:00) | 303 / 433 (70.0%). 규칙 이전 181 / 356 (50.8%) |
임계값 열두 조합의 위임 비율 | 64.0%에서 82.2% |
서브에이전트 출력 토큰 중 Sonnet (기준, 2주차, 3주차 구간) | 0.05%, 43.1%, 88.9% |
메인 세션의 출력 토큰 비중 (고친 값) | 2주차 구간 66.1%, 3주차 구간 69.8% (2주차까지의 값 95.5%) |
| 0 / 121회 (2주차 구간 8 / 145회) |
에이전트 정의의 | 32개 중 11개 (2주차와 같음) |
배운 점
위임은 70% 안팎으로 일어나고 있었지만 규칙 덕인지는 가르지 못했습니다. 규칙 저장 이후 비율이 규칙 이전보다 높고 임계값을 바꿔도 같은 방향이지만, 날짜별로는 0%에서 90%까지 오르내려 일의 성격이 비율을 좌우합니다. 위임 규칙의 효과를 보려면 작업 종류를 같게 맞춘 구간을 비교해야 합니다.
로그에서 이상한 값을 보면 다른 숫자와 대조해서 집계 정의부터 확인해야 했습니다. 글자 수 1.85M과 출력 토큰 0.17M이 어긋나는 것을 본 것이 계기였습니다. 두 주 동안 메인 출력 비중 95.5%를 가장 큰 문제로 놓고 글을 썼는데, 고친 값은 66.1%로 서브에이전트가 낸 출력이 생각보다 훨씬 많았습니다. 이전 글 두 편의 해당 결론도 정정이 필요합니다.
기록 형식을 모르는 채 첫 줄만 센 것이 오류의 원인이었습니다. 스트리밍 로그가 한 메시지를 여러 줄로 남긴다는 것을 확인하지 않고 중복 제거 키만 믿었습니다. 이번에는 메시지별 가장 큰 값을 쓰는 검사를 먼저 쓰고 실패를 확인한 뒤에 고쳤습니다.
강의가 말한 "작업별로 충분한 모델을 경험으로 정한다"를 제 로그로 옮기면 호출 인자 분포가 됩니다. 3주차 구간에서 Agent 호출의 87.6%(106/121)가
sonnet이었고 서브에이전트 출력 토큰의 88.9%를 Sonnet이 냈습니다. 어떤 일을 Sonnet에 맡겨도 충분했는지는 이 측정으로 알 수 없습니다. 결과를 읽고 고쳐 쓴 비율이 필요한데, 로그만으로는 셀 수 없습니다.
시행착오
처음에는 시각 비교 오류가 났습니다.
Z가 없는 시각을 UTC로 읽지 않아서였고, 검사를 추가한 뒤에 고쳤습니다.출력 토큰 집계의 첫 검사 네 건이 모두 실패했는데, 구현이 아니라 로그 한 줄의 공백을 가정한 문자열 필터 때문이었습니다. 필터를 느슨하게 고쳤습니다.
일의 종류 분류는 키워드 근사입니다. 영어 제목과 한글 제목이 섞여 있어 정확하지 않을 수 있습니다.
서브에이전트 호출 수가 하루 53회까지 오른 날의 호출 유형 분류, 4주차 기준표 첫 줄은 이번에 하지 않았습니다.
이 측정은 2026년 10월 22일 이 맥의 ~/.claude/projects 아래 jsonl 589개와 ~/.claude/agents의 정의 32개, 전역 설정과 규칙 파일을 Python과 셸로 센 결과입니다. 큰 산출물은 Write 도구로 쓴 파일만 세었고 기간은 규칙 저장 이후 14일입니다. 오늘(10월 22일)의 기록은 이 글을 쓰는 세션이 섞이므로 제외했습니다. 대화 내용은 읽지 않았고(Agent 호출의 작업 제목만 읽었습니다), 다른 기기와 앱 안의 대화는 범위 밖입니다.
도움 받은 글
24기 멀티에이전트 3주차 강의 (스터디장): Paseo의 프로젝트, 워크스페이스, 에이전트 구조, 승인 방식, 에이전트 프로필, 에이전트에게 Paseo 도구를 알려 주는 오케스트레이션 스킬, "나만의 스마트 라우팅"
24기 멀티에이전트 3주차 사례 발표: 도시아재 님의 "비싼 모델은 검수에" 배치와 28개 에이전트 구성, 뒹굴뒹굴 님의 끝나지 않는 검토 경험, 토니6 님의 총괄 에이전트와 역할 분담
제 2주차 글에 달린 킹슈민 님의 댓글: 위임을 규칙만 적어서는 실제 작업이 몰릴 수 있다는 지적
24기 멀티에이전트 1주차와 2주차 사례글 (본인): 기준값과 측정 스크립트의 출처

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
위임 비율을 감으로 넘기지 않고 로그와 테스트로 70% 안팎을 측정한 과정이 꼼꼼하네요. 특히 출력 토큰 집계 오류를 대조로 발견하고 지표 정의부터 고친 부분이 인상적입니다.