숏폼 자동화를 Claude Code로 만들어 보니: 설정 한 곳, 명령 하나, 그리고 21분 중 15분이 받아쓰기
2026.10.21
소개
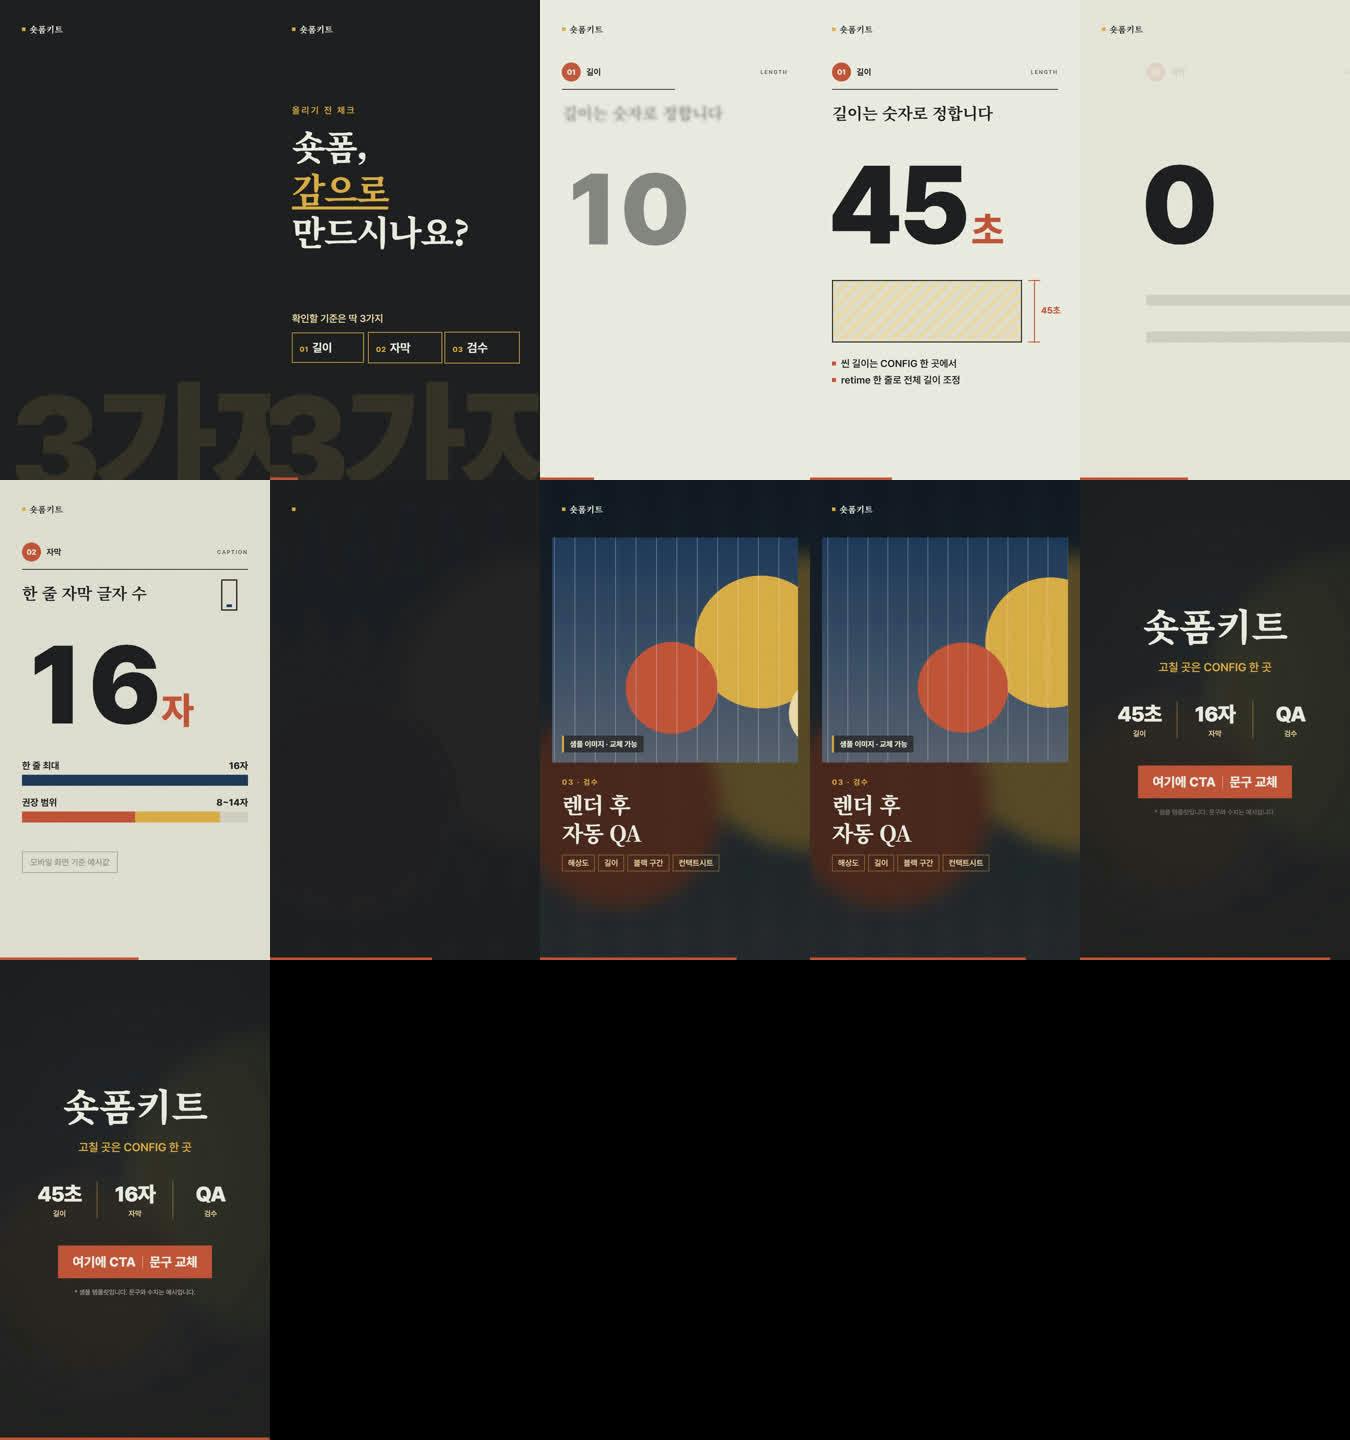
숏폼을 만들 때 시간이 새는 곳은 편집 자체보다 "글자 하나 바꾸고 다시 내보내기"의 반복이었습니다. 이 반복을 Claude Code에게 넘기려고 작은 작업 폴더를 만들었고, 롱폼 인터뷰에서 세로 숏츠를 잘라 내는 흐름까지 붙였습니다. 쓰는 도구는 HyperFrames(HTML, CSS, GSAP로 영상을 만들어 MP4로 렌더하는 CLI), FFmpeg, Python 스크립트 몇 개가 전부입니다.
이 글은 그 구조와 실패한 부분, 그리고 실제로 한 번 처음부터 끝까지 돌려 잰 시간을 정리한 것입니다.
진행 방법
1단계. 영상 하나 = 폴더 하나 = HTML 하나
videos/<영상이름>/
  index.html      VIDEO CONFIG(JSON) + 씬 HTML + CSS + GSAP 타임라인
  assets/         fonts, images, vendor(gsap)
  STORYBOARD.md   씬별 시간, 문구, 모션
  VERSIONS.md     렌더 이력 (자동 기록)
  output/         final-v1.mp4, final-v2.mp4 ... final.mp4, qa-v1/
핵심은 index.html 안의 JSON 블록 하나입니다.
<script id="video-config" type="application/json">
{ "video": {"width":1080, "height":1920, "fps":30},
  "scenes": [ {"id":"s1","label":"HOOK","duration":3.4}, ... ],
  "colors": { "bg":"#F4F1EA", ... },
  "copy":   { "hook": {"lines":["숏폼,","<em>감으로</em>","만드시나요?"]}, ... } }
</script>
문구, 색, 씬 길이는 여기서만 바꿉니다. 그래서 Claude Code에게 "훅 문구 바꿔줘"라고 하면 JSON만 고치고, HTML 구조는 건드리지 않습니다.
2단계. 씬 안 시간은 비율로
const DESIGN = { s1: 3.4, s2: 4.4, ... };   // 모션을 설계한 기준 길이
const k = sc.duration / DESIGN[sc.id];
S[sc.id] = { at: x => start + x * k, d: x => x * k };
tl.fromTo("#s1-head .line", {yPercent:110}, {yPercent:0, duration: d(0.95)}, at(0.12));
모든 트윈을 at(), d()로 쓰면 전체 길이를 20초에서 30초로 바꿔도 씬 안 리듬이 비례로 늘어납니다. 길이 변경이 명령 한 줄이 됩니다.
python tools/hf.py retime my-video --total 303단계. HTML 속성은 사람이 고치지 않기
HyperFrames는 루트와 씬의 data-start, data-duration 속성을 컴파일 시점에 읽어서 JS로 바꿀 수 없습니다. 그래서 JSON에서 속성으로 옮기는 일을 hf.py sync가 맡고, check와 render는 항상 sync부터 합니다. 처음에 정규식을 src=로 썼다가 data-config-src=까지 바뀌는 사고가 나서 (?<=\s)attr= 형태로 고쳤습니다.
4단계. 렌더 = 렌더 + 검수 + 기록
python tools/hf.py render my-video --note "훅 문구 변경"이 명령 하나가 sync → hyperframes check(실패하면 중단) → final-vN.mp4 렌더 → qa_video.py(해상도, FPS, 길이, 프레임 수, 블랙 구간, 프레임 모음) → VERSIONS.md 기록까지 합니다. 블랙 구간이 있으면 종료 코드 1이라, Claude Code가 "완료"라고 말하기 전에 걸립니다.
5단계. 롱폼 → 세로 숏츠는 FFmpeg로
구간표(JSON)에 시작, 끝, 훅 문구, 섬네일 문구만 적으면 클립마다 다음을 만듭니다.
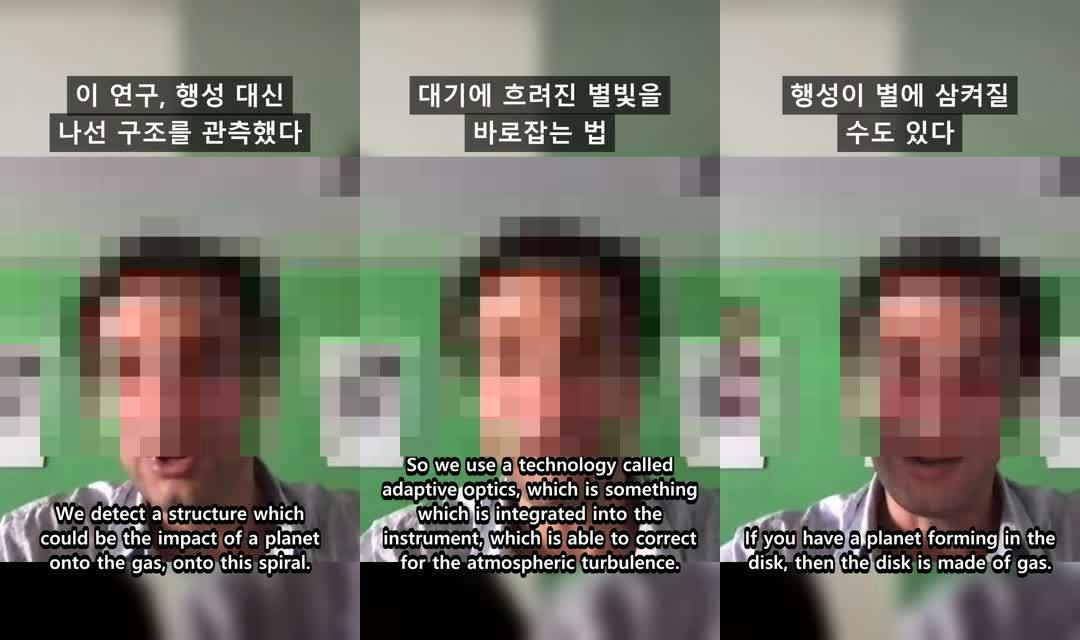
9:16 재구성: 원본을 흐림 배경 위에 겹치거나, 가운데를 잘라 채우거나, 화면 일부(화상 인터뷰의 한쪽 화자)만 잘라 흐림 배경 위에 올리기
상단 훅: 줄마다
drawtext를 따로 걸어 가운데 정렬하단 자막: SRT를 구간에 맞게 잘라 시간을 0부터 다시 매기고
subtitles필터로섬네일: 자막 넣기 전 화면에서 한 장 뽑아 큰 글자
6단계. Claude Code에게 주는 규칙 파일
폴더 루트 CLAUDE.md에 적어 둔 것 중 효과가 컸던 것:
신규, 수정, 롱폼 세 가지 흐름과 "단계 통과 전 다음 단계 금지"
수정 요청이면 항상
list로 기존 프로젝트부터 찾기(새로 만들지 않기)타임라인 1개,
fromTo만, transform 중첩 금지,Math.random금지 같은 렌더 결정론 규칙렌더가 막히면 "완료"가 아니라 막힌 지점과 시도한 것을 보고
결과와 배운 점
41분 41초짜리 영어 인터뷰를 "새로 받은 원본"이라고 치고, 숏츠 5개 묶음까지 처음부터 다시 돌려 시간을 쟀습니다(이 PC, CPU 기준).
단계 | 걸린 시간 |
|---|---|
자막 받아쓰기(faster-whisper small) | 14분 49초 |
숏츠 5개 렌더 | 2분 52초 |
자동 검수 5개 | 55초 |
눈으로 본 뒤 섬네일 2개 다시 만들기 | 1분 6초 |
전체(원본 → 묶음, 구간 고르기와 단계 사이 대기 2분 7초 포함) | 21분 49초 |
배운 점
기계 시간의 68%가 받아쓰기였습니다. 편집은 생각보다 빨랐습니다. 사람이 결과물을 보는 검수 시간은 아직 재지 못했습니다.
자동 검수는 해상도, 길이, 검은 화면은 잡지만 "섬네일 문구가 사실과 맞는지"는 못 잡습니다. 이번에도 섬네일 하나에 화자가 말하지 않은 단어(장치를 "망원경"으로)가 들어가 있었고, 다른 하나는 "클 / 수도?"처럼 어색하게 줄이 나뉘었습니다. 둘 다 프레임을 이미지로 뽑아 눈으로 보고서야 알았습니다.
초기에 두 번 크게 실패했습니다.
drawtext에 여러 줄을 한 번에 넣었더니 줄 간격이 한 줄만큼 벌어졌고, 섬네일을 완성본에서 뽑았더니 자막과 섬네일 글자가 겹쳤습니다. 줄마다 따로 그리고, 섬네일은 자막 넣기 전 화면에서 뽑는 것으로 고쳤습니다.자동 자막은 처음에 HyperFrames의
transcribe를 쓰려 했는데 whisper.cpp를 따로 빌드해야 해서 접고, faster-whisper로 SRT를 만드는 작은 스크립트를 뒀습니다. 고유명사 오인식이 많아(천체 이름 하나가 네 가지로 적힘) SRT를 한 번 읽고 고치는 단계는 뺄 수 없었습니다. 한국어는 5분 43초짜리 TTS 내레이션으로 따로 재 봤는데 3분 걸렸고, 원고와 비교한 글자 오류율은 1.5%였습니다(띄어쓰기, 문장부호 제외). 잡음 없는 목소리라 실제 사람 음성은 더 틀릴 수 있습니다.공개(CC0) 영상이라도 화면에 나온 사람의 얼굴 사용까지 허락된 것은 아니어서, 바깥에 보여 줄 때는 얼굴을 가렸습니다.
음성, 배경음악은 넣지 않았습니다. 권리 확인이 안 된 음원을 자동으로 붙이는 구조는 만들지 않기로 했습니다.
도움 받은 글
FFmpeg 필터 문서: https://ffmpeg.org/ffmpeg-filters.html
faster-whisper 저장소: https://github.com/SYSTRAN/faster-whisper
같은 방식으로 해 보신 분이 있으면 한국어 자막 받아쓰기를 어떤 모델, 어떤 설정으로 하시는지 듣고 싶습니다.
제작 과정에 AI를 활용합니다(AI 활용 작업물).

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

Calix님, "21분 중 15분이 받아쓰기"라는 제목처럼 실측 시간을 정직하게 보여주셔서 좋았어요.
영상 하나를 폴더 하나, HTML 하나로 두고 문구·색·씬 길이를 JSON 한 곳에서만 바꾸게 한 구조가 깔끔했어요. 속성을 sync가 맡게 하려고 정규식을
src=로 썼다가data-config-src=까지 바뀐 사고를 겪고 고치신 과정도 솔직해서 믿음이 갔어요. 블랙 구간이 있으면 종료 코드 1로 막아서 "완료"라고 말하기 전에 걸리게 한 장치도 따라 해보고 싶어요. 얼굴 사용 권리와 음원까지 따로 챙기신 점도 인상적이었어요.마지막 질문(한국어 받아쓰기 모델·설정)에 답해주실 분들이 나오면 좋겠네요. 꼬리 탁! 치고 응원하고 갈게요 🐈⬛