LlamaIndex + streamlit으로 문서 기반 챗봇 구현 - starter.py 코드 베이스 (작성중)
2024.08.25
배경 및 목적
LlamaIndex 기본 코드(start.py)를 토대로 streamlit으로 chatbot 만들기
참고 자료
활용 툴
Visual studio code
streamlit
실행 과정
1. LlamIndex 기본 코드
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

documents = SimpleDirectoryReader("data").load_data()
index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
response = query_engine.query("What did the author do growing up?")
print(response)
"data" 폴더 안에 있는 파일을 load
load 된 파일을 indexing
> embedding model : OpenAIEmbedding / text-embedding-ada-002"query_engine" 생성
질문(query)에 답변을 생성.
> model : OpenAI / gpt-3.5-turbo(temperature 0.1)
업그레이드 버전 코드
openai_api_key : ".env" 파일 저장 / 로드(load_dotenv)
인덱싱 결과 저장(Query your data)
처음 인덱싱 처리 후 결과를 "storage" 폴더에 저장
다음부터는 storage에 저장된 인덱스 결과를 활용
embedding model : text-embedding-3-small
openai model : gpt-4o-mini, temperature(0)
query_engine : similarity-top-k = 4
streaming 방식 출력
from dotenv import load_dotenv
from llama_index.core import (
    VectorStoreIndex,
    SimpleDirectoryReader,
    StorageContext,
    load_index_from_storage,
)
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.llms.openai import OpenAI
from llama_index.core import Settings
import os.path

# 환경 변수 로드(OPENAI_API_KEY)
load_dotenv()

# OpenAI LLM 모델 설정
Settings.llm = OpenAI(model="gpt-4o-mini", temperature=0)

# Embeded Model 설정
Settings.embed_model = OpenAIEmbedding(model="text-embedding-3-small")

# check if storage alrealy exists:
PERSIST_DIR = "./storage"

if not os.path.exists(PERSIST_DIR):
    # documents 로드
    documents = SimpleDirectoryReader("data").load_data()

    # indexing
    index = VectorStoreIndex.from_documents(documents)

    # store it for later
    index.storage_context.persist(persist_dir=PERSIST_DIR)

else:
    # load the existing index
    storage_context = StorageContext.from_defaults(persist_dir=PERSIST_DIR)
    index = load_index_from_storage(storage_context)

# Query Engine 생성
query_engine = index.as_query_engine(similarity_top_k=4, streaming=True)

# 질문에 대한 응답 생성
question = "What did the author do growing up?"
response = query_engine.query(question)
response.print_response_stream()
streamlit chatbot 구현
as_chat_engine() 사용
openai_api_key를 직접 입력 기능
인덱싱 대상 문서 선택 / 업로드 기능
업로드 파일명의 폴더를 생성하여 인덱싱 결과 저장
error 발생 시 메시지 표시.
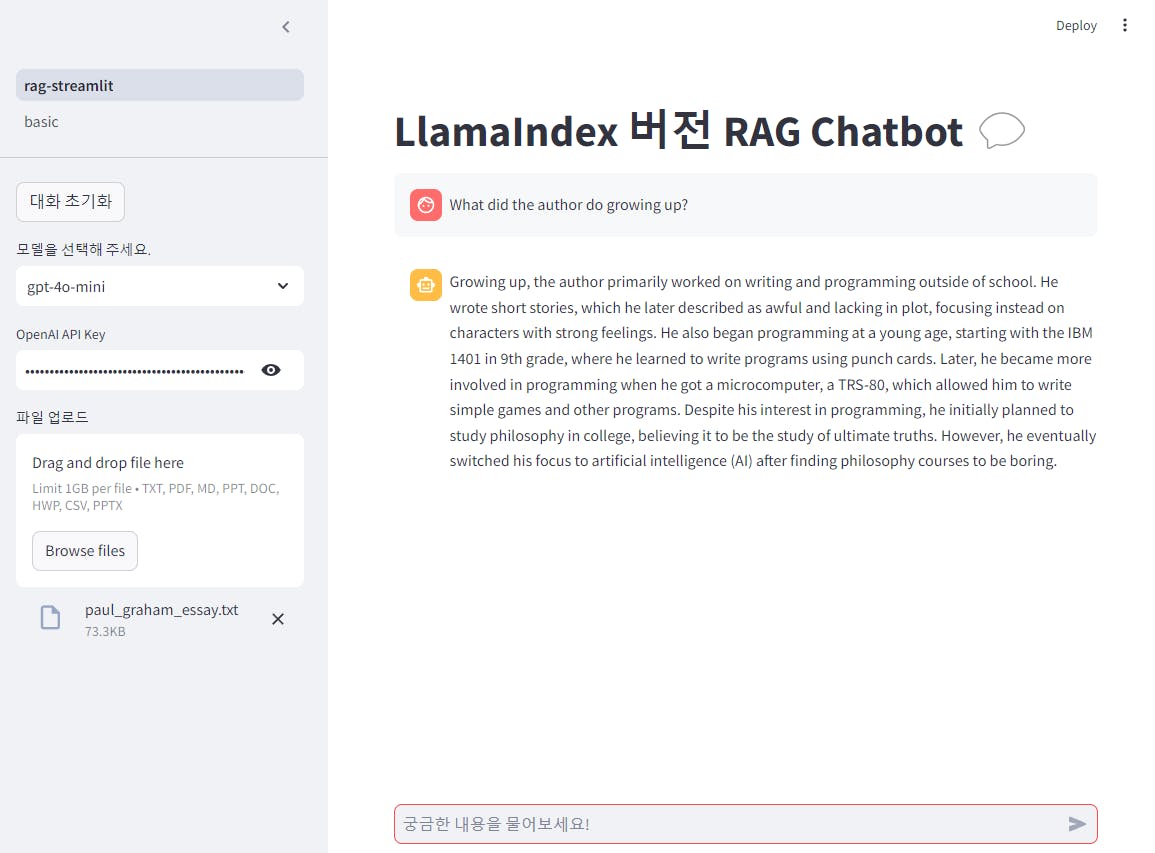
[streamlit chatbot 코드] : 시연을 했던 최종 버전
import streamlit as st
from llama_index.core import (
    VectorStoreIndex,
    SimpleDirectoryReader,
    StorageContext,
    load_index_from_storage,
)
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.llms.openai import OpenAI
from llama_index.core import Settings
import os.path
import logging, traceback

# 로깅 레벨을 ERROR로 설정(Error, Critical만 출력됨.)
logging.getLogger().setLevel(logging.ERROR)

st.title("LlamaIndex 버전 RAG Chatbot 💬")

# 처음 1번만 실행하기 위한 코드
if "messages" not in st.session_state:
    # 대화기록을 저장하기 위한 용도로 생성한다.
    st.session_state["messages"] = []

# 캐시 디렉토리 생성
if not os.path.exists("./cache"):
    os.mkdir("./cache")

# 파일 업로드 전용 폴더
if not os.path.exists("./cache/data"):
    os.mkdir("./cache/data")


# 초기화 버튼 클릭 시 실행.
def clear_chat():
    try:
        st.session_state["messages"] = []
        if "chat_engine" in st.session_state:
            del st.session_state["chat_engine"]

        if "show_warning" in st.session_state:
            del st.session_state["show_warning"]

        # cache/data 폴더에 업로드된 파일 삭제
        cache_data_dir = "./cache/data"
        if os.path.exists(cache_data_dir):
            for file_name in os.listdir(cache_data_dir):
                file_path = os.path.join(cache_data_dir, file_name)
                if os.path.isfile(file_path):
                    os.remove(file_path)

        st.session_state["chatbot_api_key"] = ""

    except Exception as e:
        st.error(f"초기화 중 오류가 발생했습니다: {e}")


# 사이드바 생성
with st.sidebar:
    # 초기화 버튼 생성
    clear_btn = st.button("대화 초기화", on_click=clear_chat)

    # LLM 선택
    selected_model = st.selectbox(
        "모델을 선택해 주세요.", ("gpt-4o-mini", "gpt-4o"), index=0
    )

    # OpneAI API Key
    openai_api_key = st.text_input(
        "OpenAI API Key", key="chatbot_api_key", type="password"
    )

    # 파일 업로드
    uploaded_file = st.file_uploader(
        "파일 업로드",
        type=["txt", "pdf", "md", "ppt", "doc", "hwp", "csv", "pptx"],
        key="uploaded_file",
    )


# 이전 대화를 출력
def print_messages():
    for chat_message in st.session_state["messages"]:
        # print(chat_message)
        st.chat_message(chat_message["role"]).write(chat_message["content"])


# 새로운 메시지를 추가
def add_to_message(role, content):
    message = {"role": role, "content": str(content)}
    st.session_state["messages"].append(message)  # Add response to message history


# 업로드 파일을 캐시 폴더에 저장
@st.cache_resource(show_spinner="업로드한 파일을 처리 중입니다...")
def load_index_data(file):

    try:

        # 업로드한 파일을 캐시 디렉토리에 저장.
        # file_content = file.read()
        file_path = f"./cache/data/{file.name}"
        with open(file_path, "wb") as f:
            f.write(file.getvalue())

        # documents 로드
        documents = SimpleDirectoryReader("./cache/data").load_data()

        return VectorStoreIndex.from_documents(documents)
    except Exception as e:
        st.error(f"파일 처리 중 오류가 발생했습니다: {str(e)}")
        logging.error(f"파일 처리 오류: {str(e)}")
        logging.error(traceback.format_exc())
        return None


if openai_api_key:
    # OpenAI LLM 모델 설정
    Settings.llm = OpenAI(model=selected_model, temperature=0, api_key=openai_api_key)

    # Embeded Model 설정
    Settings.embed_model = OpenAIEmbedding(
        mode="similarity", model="text-embedding-3-small", api_key=openai_api_key
    )
else:
    st.warning("OpenAI API 키를 입력해 주세요.")

# 이전 대화 기록 출력
print_messages()

# 사용자의 입력
user_input = st.chat_input("궁금한 내용을 물어보세요!")

# 경고 메시지를 띄우기 위한 빈 영역
warning_msg = st.empty()

if uploaded_file is not None:

    if not openai_api_key:
        st.info("Please add your OpenAI API key to continue.")
        st.stop()

    try:
        # check if storage alrealy exists:
        file_name_without_ext = os.path.splitext(uploaded_file.name)[0]
        PERSIST_DIR = f"./cache/storage/{file_name_without_ext}"

        if not os.path.exists(PERSIST_DIR):
            # indexing
            index = load_index_data(uploaded_file)
            # store it for later
            index.storage_context.persist(persist_dir=PERSIST_DIR)
        else:
            # load the existing index
            storage_context = StorageContext.from_defaults(persist_dir=PERSIST_DIR)
            index = load_index_from_storage(storage_context)

        if "chat_engine" not in st.session_state:  # Initialize the query engine
            st.session_state["chat_engine"] = index.as_chat_engine(
                chat_mode="context", verbose=True
            )
    except Exception as e:
        st.error(f"인덱스 생성 중 오류가 발생했습니다: {str(e)}")
        logging.error(f"인덱스 생성 오류: {str(e)}")
        logging.error(traceback.format_exc())
else:
    if "show_warning" not in st.session_state:
        st.session_state["show_warning"] = True  # 경고 메시지 표시 플래그
    if st.session_state["show_warning"]:
        st.warning("파일을 업로드하세요.")

# 사용자 입력을 받아서 처리하는 부분.
if user_input:

    add_to_message("user", user_input)

    # 사용자의 입력을 출력함.
    st.chat_message("user").write(user_input)

    # 스트리밍 호출
    with st.chat_message("assistant"):
        response_str = ""
        response_container = st.empty()

        try:
            # container에 토큰을 스트리밍 출력
            response = st.session_state["chat_engine"].stream_chat(user_input)

            for token in response.response_gen:
                response_str += token
                response_container.markdown(response_str)
        except Exception as e:
            response_str = f"에러가 발생했습니다. 첨부 파일이 업로드되었는지를 확인하세요.\n [error] {e}"
            response_container.markdown(response_str.replace("\n", "  \n"))
            logging.error(f"응답 생성 오류: {str(e)}")
            logging.error(traceback.format_exc())
            st.session_state["show_warning"] = False

        add_to_message("assistant", response_str)

    # Save the state of the generator
#     st.session_state["response_gen"] = response.response_gen
첨부 파일을 업로드 하면, "./cache/data" 폴더에 첨부 파일 임시 저장
"./cache/storage" 폴더 내에 첨부파일 명의 폴더를 생성하고 indexing 파일들 저장
"대화 초기화" 클릭 시 "./cache/data" 폴더 내 임시 저장 파일 삭제
다음에 동일한 첨부 파일 업로드 할 경우, 이전에 생성된 indexing 파일 저장 폴더 존재 여부 확인 -> 있으면 저장된 indexing 결과 재사용
실행 화면
결과 및 인사이트
LLamaIndex 기본 코드(starter.py)를 업그레이드 해 나가면서 LlamaIndex에 대한 조금은 이해가 된 듯 하지만, 아직 명확하게 파악이 된 것은 아닌 듯 합니다.
현재의 버전은 starter.py 코드를 베이스로 한 것이라, Component Guides와 여러 가지 examples를 참고해서 앞으로 더 고도화를 할 예정입니다.
as_chat_engine()에는 기본적으로 memory 기능이 적용되어 있는 듯 함.
txt, pdf, md, pptx 같은 텍스트 형식의 파일은 로딩이 되는 것을 확인하였으나, 이외의 형식에 대해서는 별도 확인 필요.
pptx 파일을 로드할 경우 다음을 설치해야 함. ("PptxReader" class 사용)
pip install torch transformers python-pptx Pillowstreamlit에서 200M 이상의 파일을 uploader할 경우 에러 발생하는데, config.toml 파일을 다음의 위치에 생성하면 됨.
your_project/
├── .streamlit/
│   └── config.toml
├── your_app.py
└── ...
# config.toml
[server]
maxUploadSize = 1000로그인하고 댓글을 남겨 주세요
** SimpleDirectoryReader file format(+library)
".hwp": HWPReader,
".pdf": PDFReader,
".docx": DocxReader,
".pptx": PptxReader,
".ppt": PptxReader,
".pptm": PptxReader,
".gif": ImageReader,
".jpg": ImageReader,
".png": ImageReader,
".jpeg": ImageReader,
".webp": ImageReader,
".mp3": VideoAudioReader,
".mp4": VideoAudioReader,
".csv": PandasCSVReader,
".epub": EpubReader,
".md": MarkdownReader,
".mbox": MboxReader,
".ipynb": IPYNBReader,
".xls": PandasExcelReader,
".xlsx": PandasExcelReader,

(참고)
C:\llamaindex\venv\Lib\site-packages\llama_index\core\readers\file\base.py
> def _try_loading_included_file_formats
필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


** as_chat_engine > "Chat modes"
이른아침에 님 안녕하세요!
좋은 사례 공유 너무나 감사드립니다!
as_chat_engine()에 메모리 기능이 포함돼있군요, 이번에 제가 만든 streamlit 사례에도 나중에 적용시켜 보도록 하겠습니다 (현재 채팅 형태이지만, 멀티턴이 안되서요)
설명도 감사합니다! 🙂