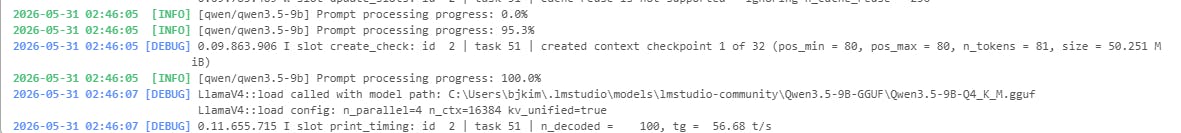
로컬 속도 56 t/s까지 올리고, 텔레그램에서 계산기 만들기까지

2026.05.31
작성일: 2026-05-31
이전 글: Hermes + 텔레그램 + Gemma 4 연동기 — 연결까지는 성공
📝 한줄 요약
Hermes + Qwen3.5-9B + 텔레그램 연결은 됐는데, LM Studio GPU 설정·Hermes platform_toolsets·compression override를 하나씩 맞춘 뒤 56 t/s까지 올리고, 텔레그램에서 HTML 계산기 파일 생성까지 성공했다.
처음에는 "연결됐으니 이제 빠르게 쓰면 되겠지?" 정도로 생각했습니다.
전날 Hermes + LM Studio + 텔레그램 연동을 끝냈습니다. 이번엔 두 가지를 동시에 노렸어요.
RTX 3070 + i7-12700K + RAM 32GB 환경에서 속도를 더 올리기
텔레그램에서 "HTML 계산기 만들어줘" — 진짜 file tool까지
결과적으로 12.7 t/s → 56.6 t/s (4.5배), 그리고 계산기 HTML 파일 생성 성공까지 갔지만, 그 사이에 함정이 한가득이었습니다.
1. 사용한 모델과 환경
항목 | 내용 |
|---|---|
PC | RTX 3070 (VRAM 8GB), i7-12700K, RAM 32GB, Windows 11 |
모델 | Qwen3.5-9B Q4_K_M (메인), Qwen3.5-0.8B Q4_K_M (드래프트모델 시도) |
실행 | LM Studio ( |
에이전트 | Hermes AI Agent (Gateway + CLI) |
메신저 | Telegram (봇 이름: 로컬유성이) |
도움 | Claude (설정·로그 분석 대화) |
2. 속도 최적화 — 12.7 t/s에서 56 t/s까지
2-1. 첫 병목: VRAM 오버플로우
nvidia-smi로 확인했을 때 VRAM 8GB 중 7.4GB가 이미 사용 중이었습니다. Qwen3.5-9B FP16은 약 18GB라 8GB VRAM에 다 안 들어가고 RAM으로 넘치는 상태 — 13 t/s의 주범이었습니다.
다행히 이미 Q4_K_M 양자화 모델(약 6.75GB)을 쓰고 있었고, GPU Offload도 max로 설정돼 있었습니다.
2-2. 진짜 문제: KV Cache가 RAM으로
LM Studio 로그(main.log)에서 발견:
Offload KV Cache to GPU: OFF  ← 이게 문제!
Num Offload Layers: max       ← 레이어는 GPU에 올라감 ✅
Model: 6.75 GB
모델 가중치는 GPU에 있는데 역시나 KV Cache가 RAM으로 가서 느렸습니다. Vram은 Vram만 가야 속도가 나오는 현실이 참 슬픕니다. ㅠㅠ 8GB의 한계란....
2-3. 바꾼 LM Studio 설정
항목 | 변경 전 | 변경 후 | 효과 |
|---|---|---|---|
GPU Offload | 32 (레이어 일부 CPU) | MAX (VRAM 한계까지) | CPU 병목 제거 |
Offload KV Cache to GPU | OFF | ON | KV Cache GPU 이동 |
Flash Attention | — | ON | 메모리 효율↑ |
Evaluation Batch Size | 512 | 1024 | 프롬프트 처리↑ |
Context Length | 65536↔2048 왔다갔다 | 2048~4096 (속도 우선) | VRAM 절약 |
VRAM 8GB 한계: Qwen3.5-9B Q4_K_M 기준 GPU Offload 슬라이더가 32에서 더 안 올라감. 6.75GB 모델 + KV Cache + 컨텍스트가 VRAM 한계입니다. 이건 정상이에요.
2-4. 속도 변화 기록
단계 | t/s | graphs reused | 비고 |
|---|---|---|---|
처음 | 12.7 | — | VRAM 오버플로우 |
KV Cache GPU ON | 23.4 | 250 | 1차 튜닝 |
GPU Offload MAX | 30.8 | 1212 | 2차 튜닝 |
캐시 warm (짧은 대화) | 56.6 | 4944 | LCP similarity 1.000 |
Hermes 재시작 후 | 19.8 | 7743 | cold cache |
텔레그램 긴 작업 후 | 11.8 | 46 | 14,284 토큰 히스토리 |
/new 후 안정 | 34.0 | 13712 | truncated = 0 |
핵심 인사이트: 56 t/s는 Speculative Decoding 때문이 아니라 KV 캐시 완벽 히트(graphs reused 높음 + LCP similarity = 1.000) 덕분이었습니다. 재시작·긴 tool 히스토리·텔레그램 세션 누적이면 다시 느려집니다. 그래도 컨택스트 누적되도 34 t/s 속도는 나와 만족이 됩니다.
2-5. Speculative Decoding — 시도했지만 Qwen3.5는 안 됨
Qwen3.5-0.8B Q4_K_M을 드래프트 모델로 받았는데 LM Studio에서 "No compatible draft models found". 만약 됬더라면 가벼운 내용처리는 저쪽으로 흘러가서 더 빨랐을텐데 말이죠..
3. Hermes "fake context" — 속도와 안정성의 줄다리기
3-1. 왜 fake가 필요한가
Hermes config.yaml:
model:
  context_length: 65536   # Hermes가 LM Studio에 "나 64K 처리 가능" 선언
  max_tokens: 2048
LM Studio 실제 Context Length: 2048~16384 (속도 위해 낮게 유지)
쪽 | 값 | 이유 |
|---|---|---|
Hermes | 65536 | compression/auxiliary 최소 64K 요구 |
LM Studio | 2048~4096 | 속도 우선 (KV Cache VRAM 절약) |
그래서 65536 fake는 유지하고, 가벼운 코딩결과물을 내기에는 4096으로는 부족할거같아 LM Studio는 이정도면 어플리케이션 하난 나오겠지 라는 생각으로 처리 가능한 값(16384)으로 설정하는 이중 구조로 셋팅했습니다.
3-2. compression 설정 — 자동 리셋 스킬 대신 이걸 씀
별도 "컨텍스트 자동 리셋 스킬"을 만들려 했지만, Hermes에 compression이 이미 내장돼 있었습니다.
compression:
  enabled: true              # ← false였다가 true로 변경
  threshold: 0.5             # 50% 차면 자동 압축
  target_ratio: 0.2          # 20%로 줄임 (공격적)
  protect_last_n: 20
  protect_first_n: 3
  hygiene_hard_message_limit: 400
  abort_on_summary_failure: false
auxiliary.compression override (필수 — 없으면 compression 에러):
auxiliary:
  compression:
    provider: auto
    model: ''
    base_url: ''
    api_key: ''
    timeout: 120
    extra_body: {}
    context_length: 65536    # ← fake override
확인 명령:
Get-Content "C:\Users\bjkim\AppData\Local\hermes\config.yaml" | Select-String "context_length"
# context_length: 65536 이 3개 나와야 함 (model + auxiliary + 기타)
context engine — truncate, window 둘 다 지원 안 됨:
Context engine 'truncate' not found — falling back to built-in compressor
Context engine 'window' not found — falling back to built-in compressor
→ engine: '' (빈값, 기본 compressor 사용)으로 두는 게 맞음.
4. tool call — "No tools available"부터 계산기 성공까지
4-1. 첫 증상: 코드가 채팅에 박힘
계산기 html로 만들어서 보내볼래?
봇이 write_file을 실제 호출하지 않고 HTML 전체를 텔레그램 메시지에 붙여넣음. (1/2), (2/2)로 잘리고 실행 불가. 확인해보니 tool 설치가 안되서....
4-2. /tools → No tools available
config.yaml에 toolsets는 넣었는데 CLI에서:
⚙️ /tools
(;_;) No tools available
hermes tools list 결과 — 전부 disabled:
✗ disabled  terminal
✗ disabled  file
✗ disabled  vision
...
4-3. 진짜 원인: platform_toolsets가 비어 있음
# toolsets에 넣어도 소용없었던 이유
toolsets:
  - hermes-cli
  - terminal
  - file
  - vision
  - skills
  - memory
  - todo

platform_toolsets:
  cli: []        # ← 비어있음! CLI에서 툴 0개
  telegram: []   # ← 비어있음! 텔레그램에서도 툴 0개
해결:
platform_toolsets:
  cli:
    - terminal
    - file
    - vision
    - skills
    - memory
    - todo
    - web
  telegram:
    - terminal
    - file
    - vision
    - skills
    - memory
    - todo
    - web
재시작 후 /tools → Total: 12 tools ヽ(^o^)ノ
4-4. tool_use_enforcement + reasoning_effort
agent:
  tool_use_enforcement: none  →  auto   # none이면 모델이 텍스트로만 답함
  reasoning_effort: 'on'      →  ''     # 'on'은 Hermes가 인식 못 함 (Unknown warning)
로그 확인:
WARNING cli: Unknown reasoning_effort 'on', using default (medium)
tool_turns=0  ← 툴이 아예 안 불림
Enable Thinking(LM Studio)은 tool call과 무관 — Hermes 쪽 reasoning_effort와 tool_use_enforcement가 핵심.
4-5. 가짜 tool call vs 진짜 tool call
구분 | 가짜 (초반) | 진짜 (설정 후) |
|---|---|---|
출력 |
| Hermes 로그에 tool 실행 기록 |
파일 | 디스크에 없음 |
|
텔레그램 | HTML이 메시지로 잘림 |
|
로컬 Qwen3.5-9B는 tool 형식을 텍스트로 흉내내기도 하지만, platform_toolsets + tool_use_enforcement: auto 맞추면 실제 file tool까지 동작합니다. 이젠 하다하다 파일로 할루시네이션을 하네요....
4-6. 최종 성공 — 계산기 HTML
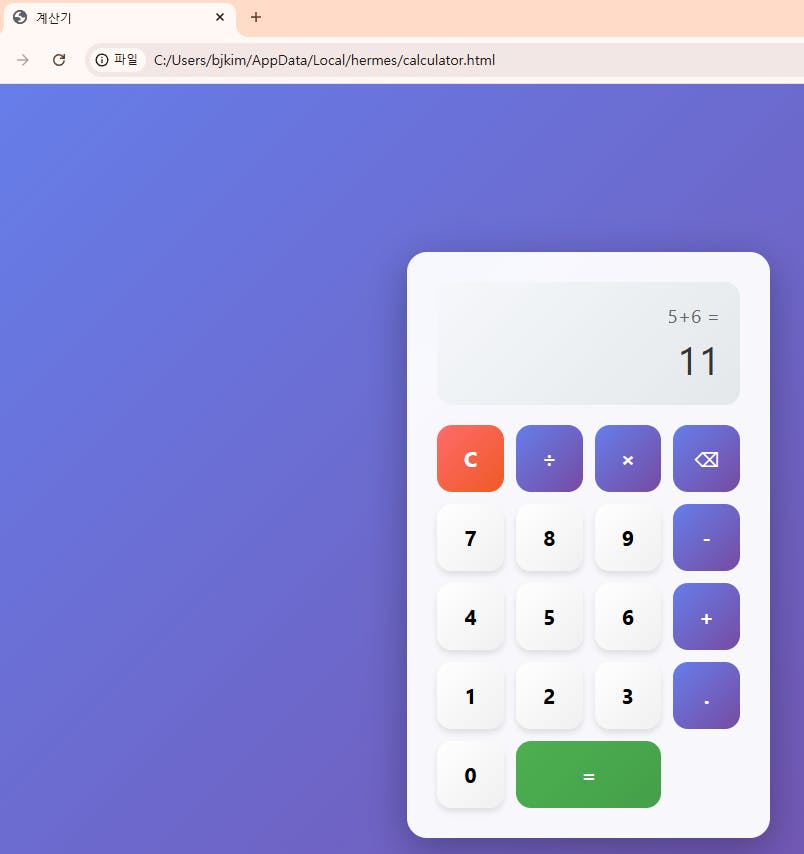
성공! ✅ calculator.html 만들어졌네요!
📖 read_file: "calculator.html"
⚠️ Response truncated due to output length limit  ← max_tokens 부족 시
max_tokens 2048 → 4096으로 늘리면 잘림 줄어듦. 작업 끝나면 /new로 tool 히스토리 정리 — 대화는 짧아도 tool 결과가 토큰을 많이 먹음.
아래는 결과물입니다... 아 이거 과거 어디서 익숙한 냄새의 보라돌이인데....
5. 속도 유지 — /new와 tool_output
5-1. 왜 /new 했는데도 느린가
/new로 대화는 초기화됐지만, file 읽기/쓰기 tool 결과가 히스토리에 쌓이면 실제 토큰은 길어집니다.
prompt eval: 14,284 tokens / 58초
graphs reused: 46  ← 거의 cold
eval: 11.83 t/s
5-2. tool_output 줄이기 (선택)
tool_output:
  max_bytes: 10000   # 기본 50000에서 축소
  max_lines: 500     # 기본 2000에서 축소
5-3. 속도 vs 안정성 트레이드오프 정리
선택 | 속도 | 안정성 | 추천 상황 |
|---|---|---|---|
LM Studio Context 2048 + fake 65536 | ★★★★★ (56 t/s) | ★★ (truncated, 에러발생 높음) | 짧은 Q&A만 |
LM Studio Context 16384 + fake 65536 | ★★★ (27~34 t/s) | ★★★★ (안정) | 텔레그램 + file tool |
compression ON + threshold 0.5 | ★★★★ | ★★★★ (자동 압축) | 현재 채택 |
6. 최종 config.yaml 핵심 (복사용)
model:
  default: qwen/qwen3.5-9b
  provider: lmstudio
  base_url: http://127.0.0.1:1234/v1
  context_length: 65536    # fake — 건드리지 않음
  max_tokens: 4096

toolsets:
  - terminal
  - file
  - vision
  - skills
  - memory
  - todo
  - web

agent:
  tool_use_enforcement: auto
  reasoning_effort: ''

compression:
  enabled: true
  threshold: 0.5
  target_ratio: 0.2
  protect_last_n: 20
  protect_first_n: 3

context:
  engine: ''

auxiliary:
  compression:
    context_length: 65536    # fake override — 필수

platform_toolsets:
  cli:
    - terminal
    - file
    - vision
    - skills
    - memory
    - todo
    - web
  telegram:
    - terminal
    - file
    - vision
    - skills
    - memory
    - todo
    - web
7. LM Studio 최종 설정 (RTX 3070 8GB)
항목 | 값 |
|---|---|
모델 | Qwen3.5-9B Q4_K_M |
GPU Offload | MAX (32 — VRAM 한계) |
Context Length | 16384 (file tool 작업 시) / 2048~4096 (속도 우선) |
Offload KV Cache to GPU | ON |
Flash Attention | ON |
Evaluation Batch Size | 1024 |
Speculative Decoding | Qwen3.5 조합 미지원 — 사용 안 함 |
8. 마무리 !!
속도 12 → 56 t/s의 핵심은 KV Cache GPU ON + GPU Offload MAX — Speculative Decoding 없이도 캐시 warm 상태면 50 t/s 넘음.
56 t/s는 "항상"이 아니라 "캐시가 맞을 때" — 재시작·긴 tool 작업·텔레그램 세션 누적이면 11~20 t/s로 떨어짐.
/new가 속도 유지의 핵심.fake context 65536은 Hermes compression 필수 —
auxiliary.compression.context_length: 65536없으면 텔레그램 봇 무응답.toolsets만 넣어도 /tools는 No tools available —
platform_toolsets.cli와.telegram에 같은 목록을 반드시 넣어야 함.가짜 tool call(
✍️ write_file:텍스트)과 진짜 tool call은 설정 차이 —tool_use_enforcement: auto+ platform_toolsets.compression threshold 0.5 = 자동 리셋 스킬 대체 — 50% 차면 요약 압축. 별도 스킬 불필요.
"성공했습니다"보다 explorer / dir — 봇 말보다 디스크에
calculator.html이 있는지가 기준.Context Length fake vs LM Studio 실제값 — 속도 vs 안정성 줄다리기. file tool 쓸 땐 LM Studio 16384, 짧은 Q&A만 할 땐 2048.
추후 진행 할 것
1. 간단한 어플리케이션 만들었으니 좀더 난도 있는 어플리케이션 만들기
1) 기존에 만들어둔 생활용 어플리케이션 중 점심메뉴추천기를 로컬모델로 업그레이드 해보기
2) 1)을 진행함에 있어 기존 구글 맵에 있는 식당DB를 가져오고 해당 DB자료들로 어플리케이션 구성
3) 기존 vercel에 배포된것을 업그레이드

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
와.... 전 확실히 계획이 없는것 같습니다... 이렇게 체계적으로 해야 맞는데
대단하십니다... 어떻게 하면 이렇게 할 수 있을까요... 귀차니즘을 던져버릴 방법을 알려주세요 ㅋㅋㅋㅋ
엇 ㅋㅋ 저 무계획인데 나름 ㅋㅋㅋ pc사양에 맞춰 최소한으로 로컬에서 해볼수잇는거 단계적으로 가서 어디까지되나 해보자가 단순목표라 ㅎㅎㅎ