유튜브 수십 편을 넣었더니, AI가 정답과 원본 장면까지 찾아줍니다 (RAG 대신 LLM Wiki + Hermes)

2026.08.06
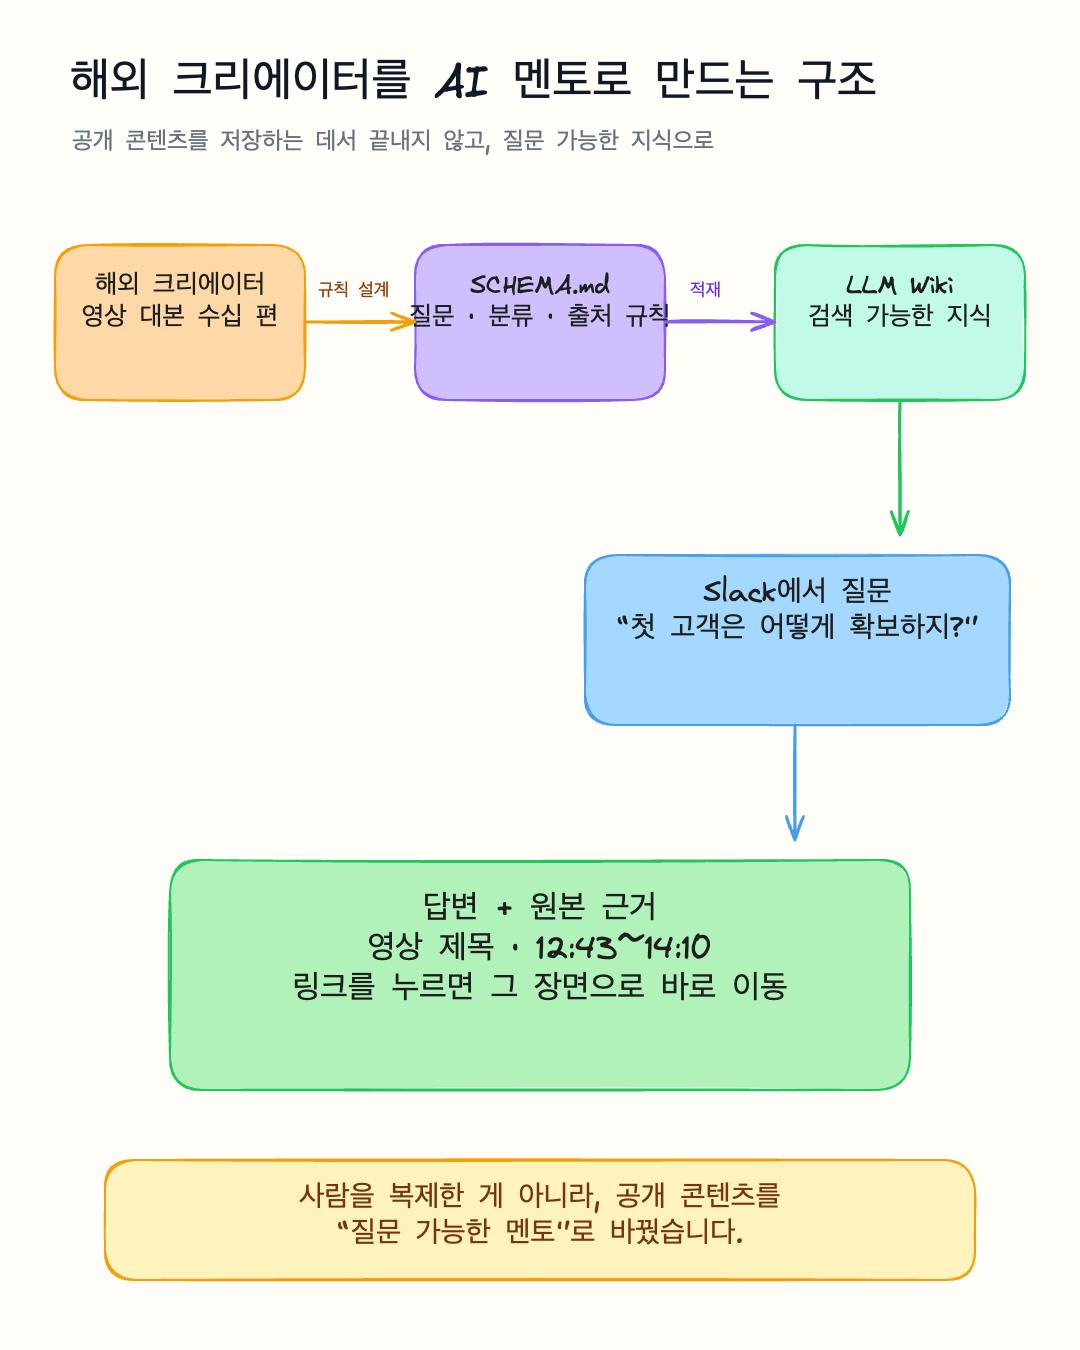
결론부터 말하면, 반복해서 보는 영상이라면 검색창보다 먼저 질문과 규칙을 만들어야 합니다.
좋아하는 해외 크리에이터의 영상이 매일 올라옵니다. 한 편에 30분 안팎입니다. 좋은 내용이라는 걸 알아도 전부 볼 수는 없습니다.
그래서 공개 영상 수십 편의 대본을 모아 LLM Wiki로 만들었습니다. Slack에 질문을 던지면 여러 영상에 흩어진 내용을 모아 답하고, 근거가 된 원본 영상의 시작·끝 시각까지 함께 보여줍니다. 링크를 누르면 그 사람이 실제로 해당 내용을 말한 장면으로 이동합니다.
데모 영상 : https://youtu.be/9nRlNkWqP_o
단순히 “RAG 대신 Markdown을 썼다”는 이야기가 아니라, 질문을 먼저 만들고, 그 질문을 기준으로 SCHEMA.md를 고치고, 한 편을 검증한 뒤 Hermes와 cron으로 넘긴 과정입니다.
공개 대본을 저장하는 데서 멈추지 않고, 질문과 원본 근거가 함께 나오는 구조로 만들었습니다.
■ 소개
▶ 시도하고자 했던 것
목표는 해외 크리에이터의 영상을 대신 봐주는 챗봇이 아니었습니다. 그 사람이 여러 영상에서 반복해서 말한 내용을 나중에 다시 물어볼 수 있는 개인용 멘토로 만드는 것이었습니다.
질문은 이런 식입니다.
> 콜드 아웃리치에 대한 이 크리에이터의 조언은 무엇인가?
답변이 요약으로만 끝나면 다시 원본을 찾아야 합니다. 그래서 다음 조건을 넣었습니다.
• 답변은 여러 영상을 종합할 것
• 어떤 영상에서 나온 내용인지 표시할 것
• 영상의 시작 시각과 끝 시각을 표시할 것
• 원문 인용을 함께 보여줄 것
• 링크를 누르면 해당 장면으로 이동할 것
여기서 기존에 익숙한 RAG 구조를 바로 만들지 않았습니다. 먼저 이 데이터에 실제로 어떤 질문을 던질지 확인했습니다. 질문이 무엇인지 모른 채 아키텍처부터 만들면, 나중에 쓰지 않는 분류 체계와 필드가 늘어납니다.
▶ 왜 LLM Wiki였나
RAG는 질문이 들어온 뒤 원문에서 관련 조각을 검색해 답을 만듭니다. 원문 확인이 중요하고 질문이 예측하기 어려운 경우에 잘 맞습니다.
이번 데이터는 조금 달랐습니다. 영상 수는 많지만, 반복해서 묻는 주제는 한정적이었습니다. 한 번 정리한 개념을 다시 사용할 가능성이 높았고, 사람이 읽을 수 있는 Markdown 파일로 결과를 확인하고 싶었습니다.
그래서 수집 시점에 LLM이 대본을 읽고 개념 페이지로 정리하게 했습니다. 원본 대본은 raw/에 그대로 두고, 사람이 읽을 수 있는 개념 페이지는 concepts/에 저장했습니다. SCHEMA.md는 파일 이름, 태그, 출처, 페이지 생성 기준을 정하는 규칙서 역할을 했습니다.
벡터 DB와 embedding을 쓰지 않은 이유는 “RAG가 필요 없어서”가 아닙니다. 이 실습의 데이터 규모와 재사용 방식에서는 먼저 파일과 규칙으로 검증하는 편이 짧았기 때문입니다. 데이터가 훨씬 커지거나 질문 범위가 넓어지면 검색 계층을 추가할 수 있습니다.
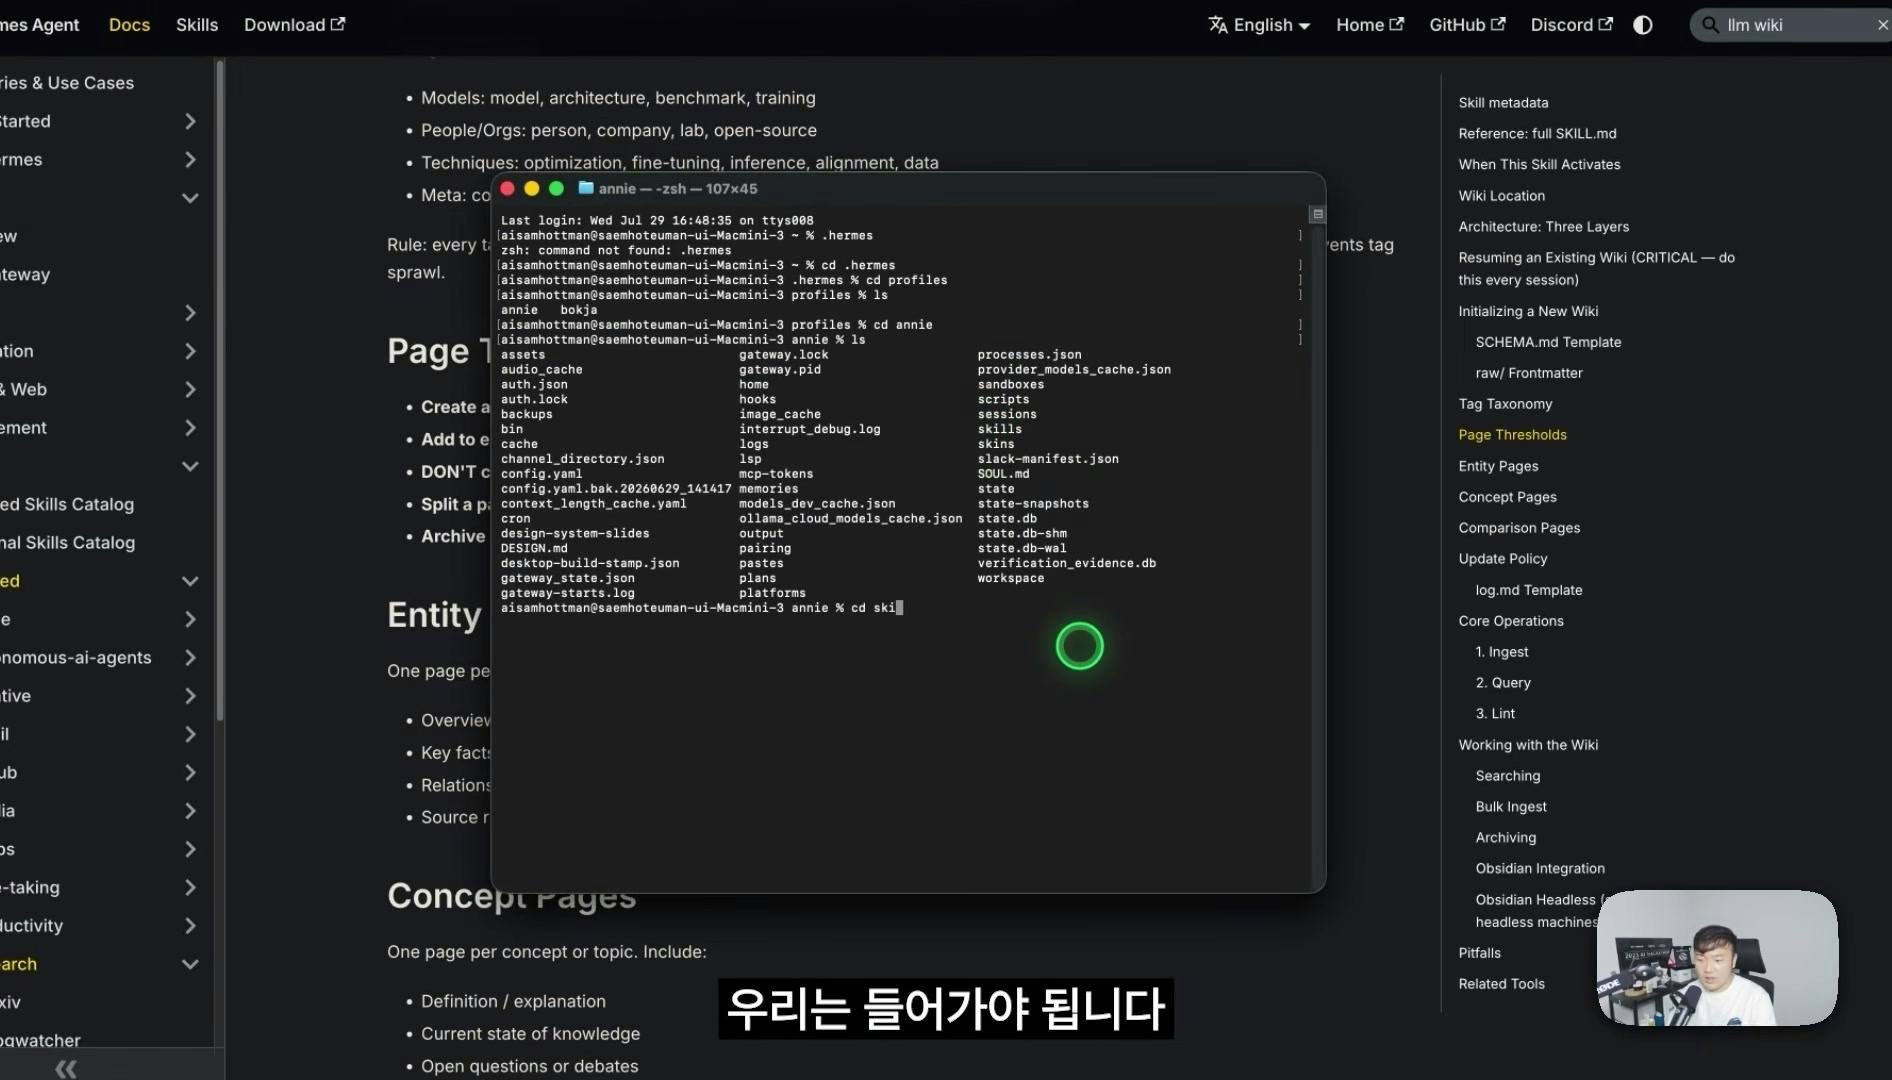
Hermes에 이미 포함된 LLM Wiki Skill을 확인한 뒤, 같은 규칙으로 위키를 이어받게 했습니다.
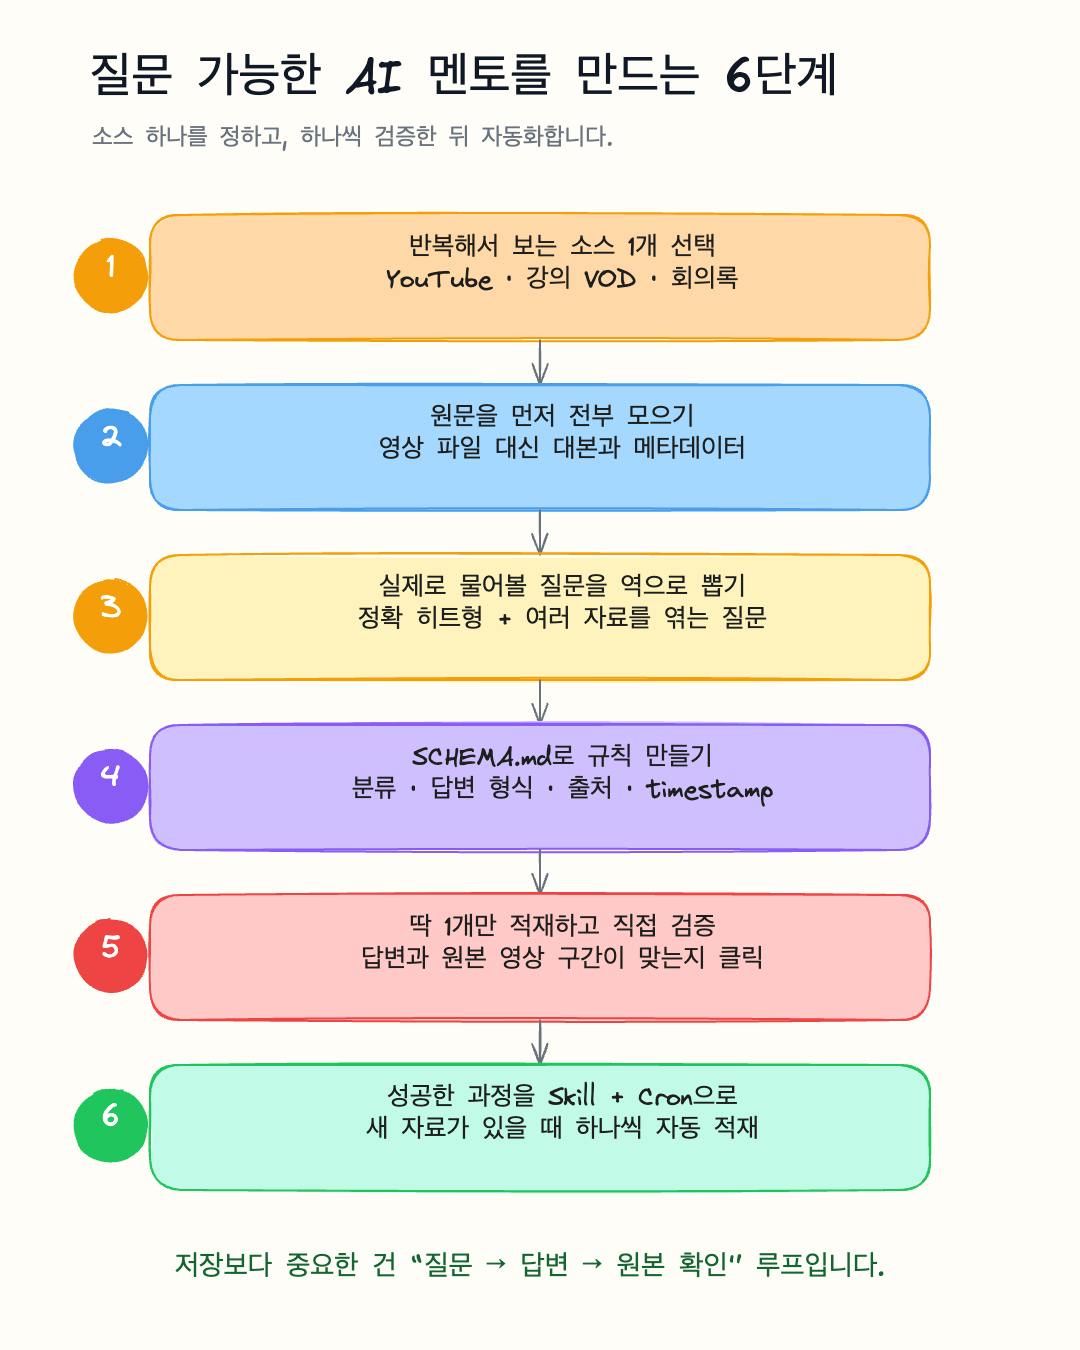
소스 하나를 선택하고 한 편씩 검증한 뒤 자동화하는 순서입니다.
■ 진행 방법
▶ 1. 대본과 메타데이터부터 모았습니다
처음부터 영상 파일을 전부 받지 않았습니다. yt-dlp로 영상 제목, URL, 길이, video ID와 자막을 모았습니다. 이 단계의 목적은 영상을 보는 것이 아니라, 앞으로 질문할 수 있는 지식의 범위를 파악하는 것이었습니다.
실습 자료 기준으로 해외 채널의 영상 42개를 수집했습니다. 영상마다 대본과 메타데이터를 나란히 두었습니다. 영상에 따라 인트로와 아웃트로가 섞여 있었기 때문에, 위키에 넣을 때 제거할 노이즈도 먼저 확인했습니다.
영상 파일보다 먼저 제목, URL, 길이, video ID를 모아 지식의 범위를 확인했습니다.
이때 사용한 수집 프롬프트는 다음과 같습니다.
yt-dlp를 사용해서 이 유튜브 채널의 영상을 수집할 준비를 해줘.

1. Shorts는 제외해.
2. 영상의 제목, 영상 ID, URL, 업로드 날짜, 러닝타임을 JSON으로 저장해.
3. 각 영상의 자막과 메타데이터를 yt-data/transcript/sub/ 아래에 저장해.
4. 영상 파일은 다운로드하지 말고 자막만 받아.
5. 자동 자막이 없는 영상은 실패로 기록하고 내용을 추정하지 마.
6. 나중에 영상별 원본 링크와 타임스탬프를 연결할 수 있도록 video ID와 자막의 시간 정보를 보존해.
여기서 중요한 것은 대본을 먼저 “검색 가능한 조각”으로 만드는 것이 아니었습니다. 어떤 질문을 해야 쓸모가 생기는지 확인할 수 있는 상태로 만드는 것이었습니다.
▶ 2. 질문을 역으로 뽑았습니다
대본을 모은 뒤 “이 위키에 무엇을 물어볼까?”를 AI에게 역으로 물었습니다. 질문이 먼저 있어야 필요한 분류와 출처 필드를 정할 수 있기 때문입니다.
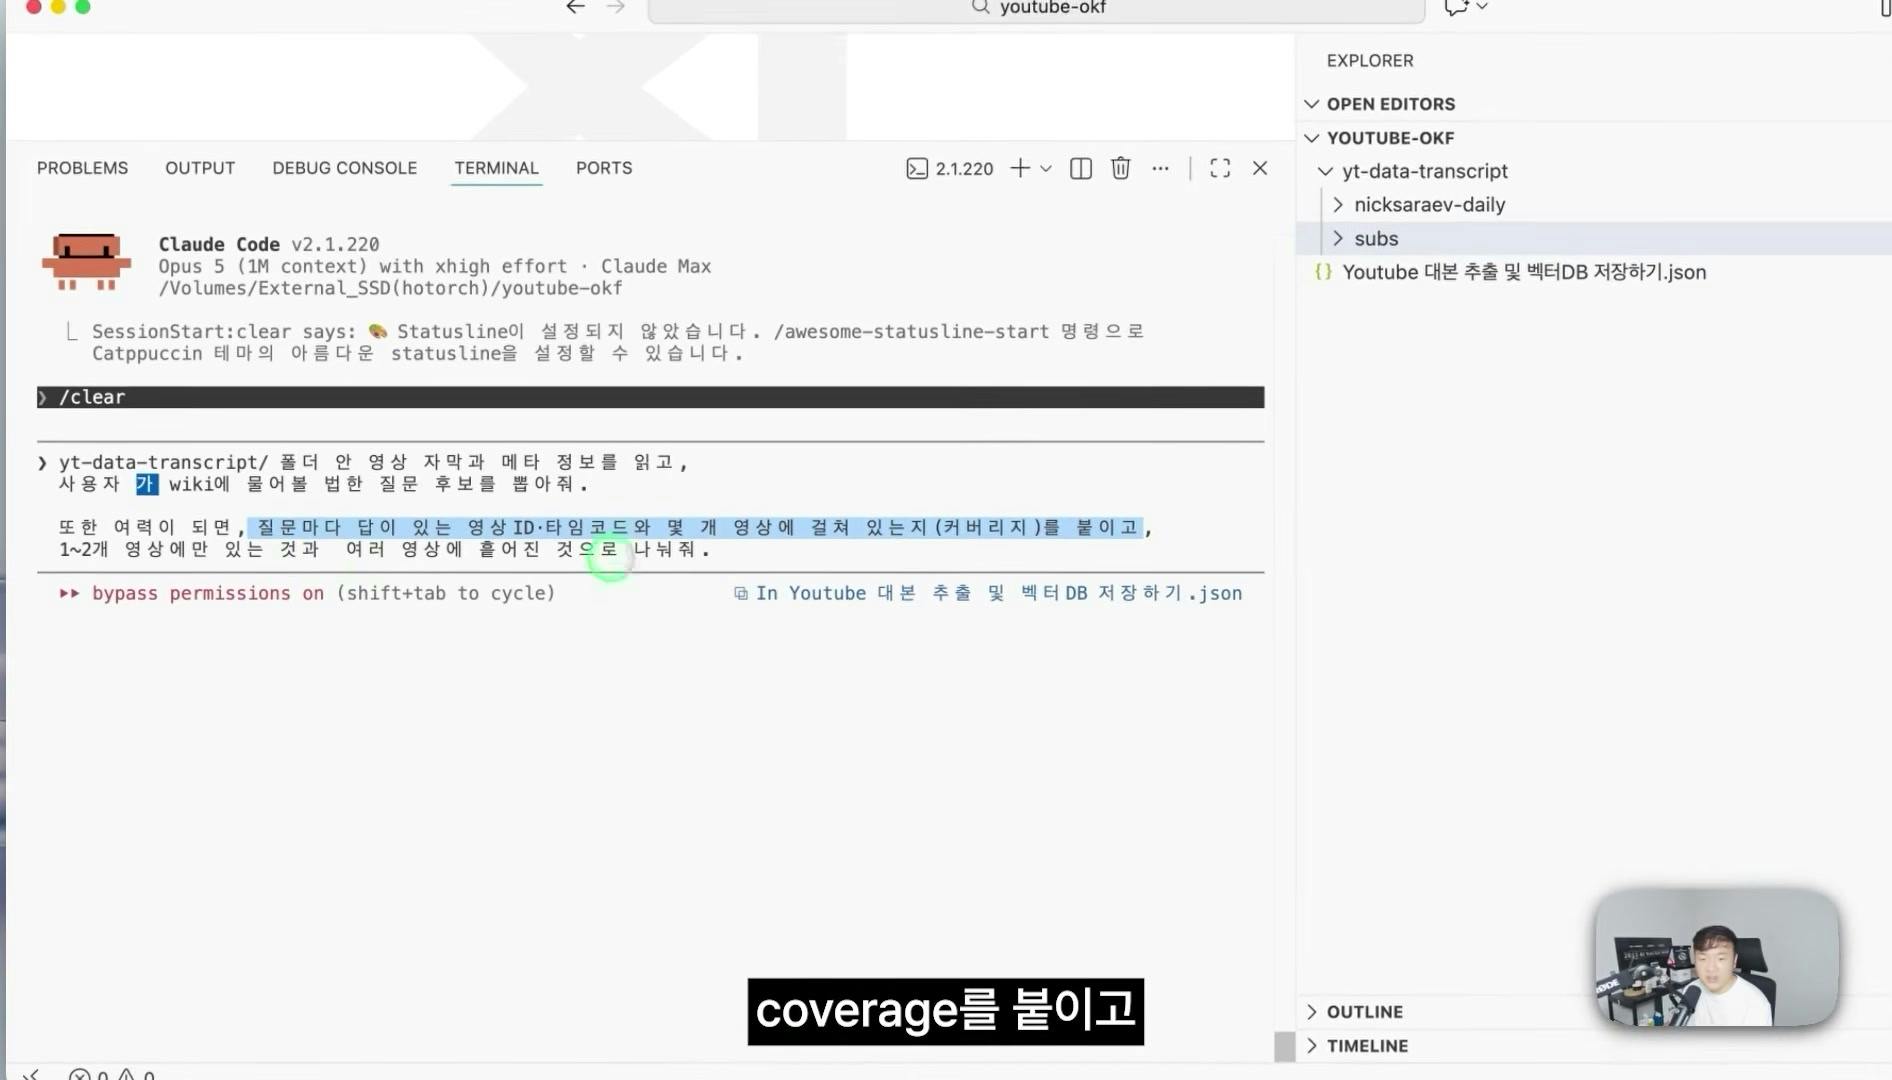
아키텍처를 정하기 전에 실제로 물어볼 질문을 먼저 뽑았습니다.
실제로 사용한 질문 추출 프롬프트는 다음과 같습니다.
yt-data-transcript/ 폴더 안의 영상 자막과 메타 정보를 모두 읽어줘.

이 자료를 위키에 넣는다고 했을 때, 사용자가 실제로 물어볼 법한 질문 후보를 뽑아줘.

질문은 다음 두 유형으로 나눠줘.

1. 한 영상에서 답을 찾을 수 있는 정확 히트형 질문
2. 여러 영상을 읽고 답을 종합해야 하는 교차 검색형 질문

가능하면 질문마다 다음 정보도 붙여줘.

• 답이 있는 영상 ID
• 답이 있는 자막의 시작·끝 타임코드
• 몇 개 영상에 걸쳐 있는지 coverage
• 한두 개 영상에만 있는 질문인지, 여러 영상에 흩어진 질문인지

대본에 답이 없는 질문은 억지로 만들지 말고, 실제 자막에 근거가 있는 질문만 남겨줘.
이 단계에서 AI가 뽑은 질문을 그대로 확정하지 않았습니다. 혼자 쓰는 위키라면 AI가 뽑은 질문을 검토하는 것으로 충분할 수 있습니다. 팀이나 회사에서 쓸 위키라면 실제 사용자가 이 질문을 할지 한 번 더 합의해야 합니다.
▶ 3. 질문에서 SCHEMA.md를 역산했습니다
질문 목록을 만든 뒤 LLM Wiki Skill의 규칙을 읽혔습니다. 그리고 질문에 필요한 Domain과 Tag Taxonomy를 채워 SCHEMA.md를 만들게 했습니다.
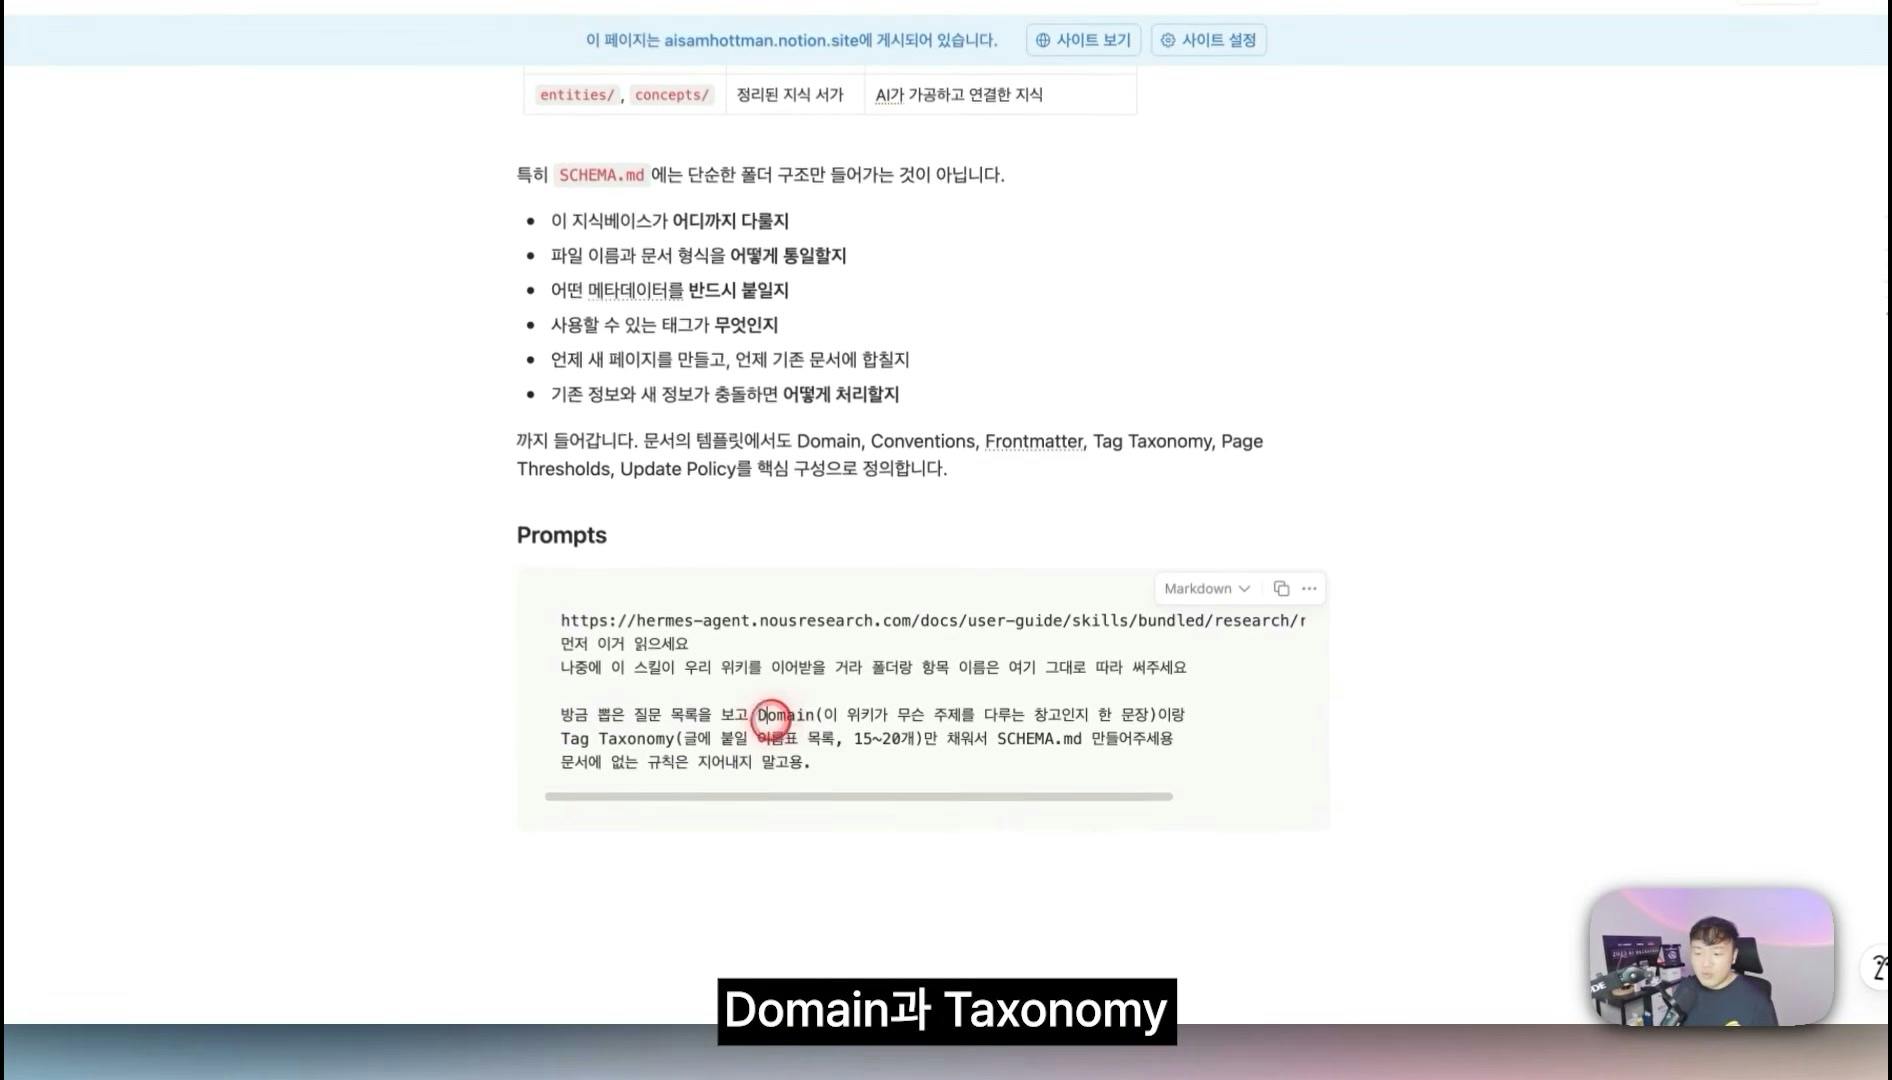
질문 목록을 기준으로 Domain과 Tag Taxonomy를 채웠습니다. 출처: 샘 호트만 : AI 엔지니어의 시선, [10:30].
사용한 프롬프트는 다음과 같습니다.
먼저 아래 LLM Wiki Skill의 내용을 읽어줘.

이후에 이 Skill이 우리가 만든 위키를 이어받을 예정이다.
그러므로 폴더 이름과 필드 이름은 Skill에서 정한 형식을 그대로 따라줘.

방금 만든 질문 목록을 기준으로 wiki/SCHEMA.md를 만들어줘.

이번 단계에서는 다음 두 가지를 우선 채워줘.

1. Domain
   이 위키가 어떤 주제를 다루는 지식 창고인지 한 문장으로 써줘.

2. Tag Taxonomy
   질문 목록에서 반복되는 주제를 기준으로 15~20개의 태그 후보를 만들어줘.
   비슷한 태그는 하나로 합치고, 실제 자료에 없는 태그는 만들지 마.

문서에 없는 규칙을 임의로 추가하지 말고,
지금 확인할 수 있는 질문과 대본을 근거로 작성해줘.
처음의 SCHEMA.md는 길지 않았습니다. 도메인과 태그 분류 정도만 있었습니다. 그런데 답변에 원본 영상의 시작·끝 시각과 링크를 보여 달라고 요구하자, 출처 형식과 질문 처리 방식이 규칙으로 추가됐습니다.
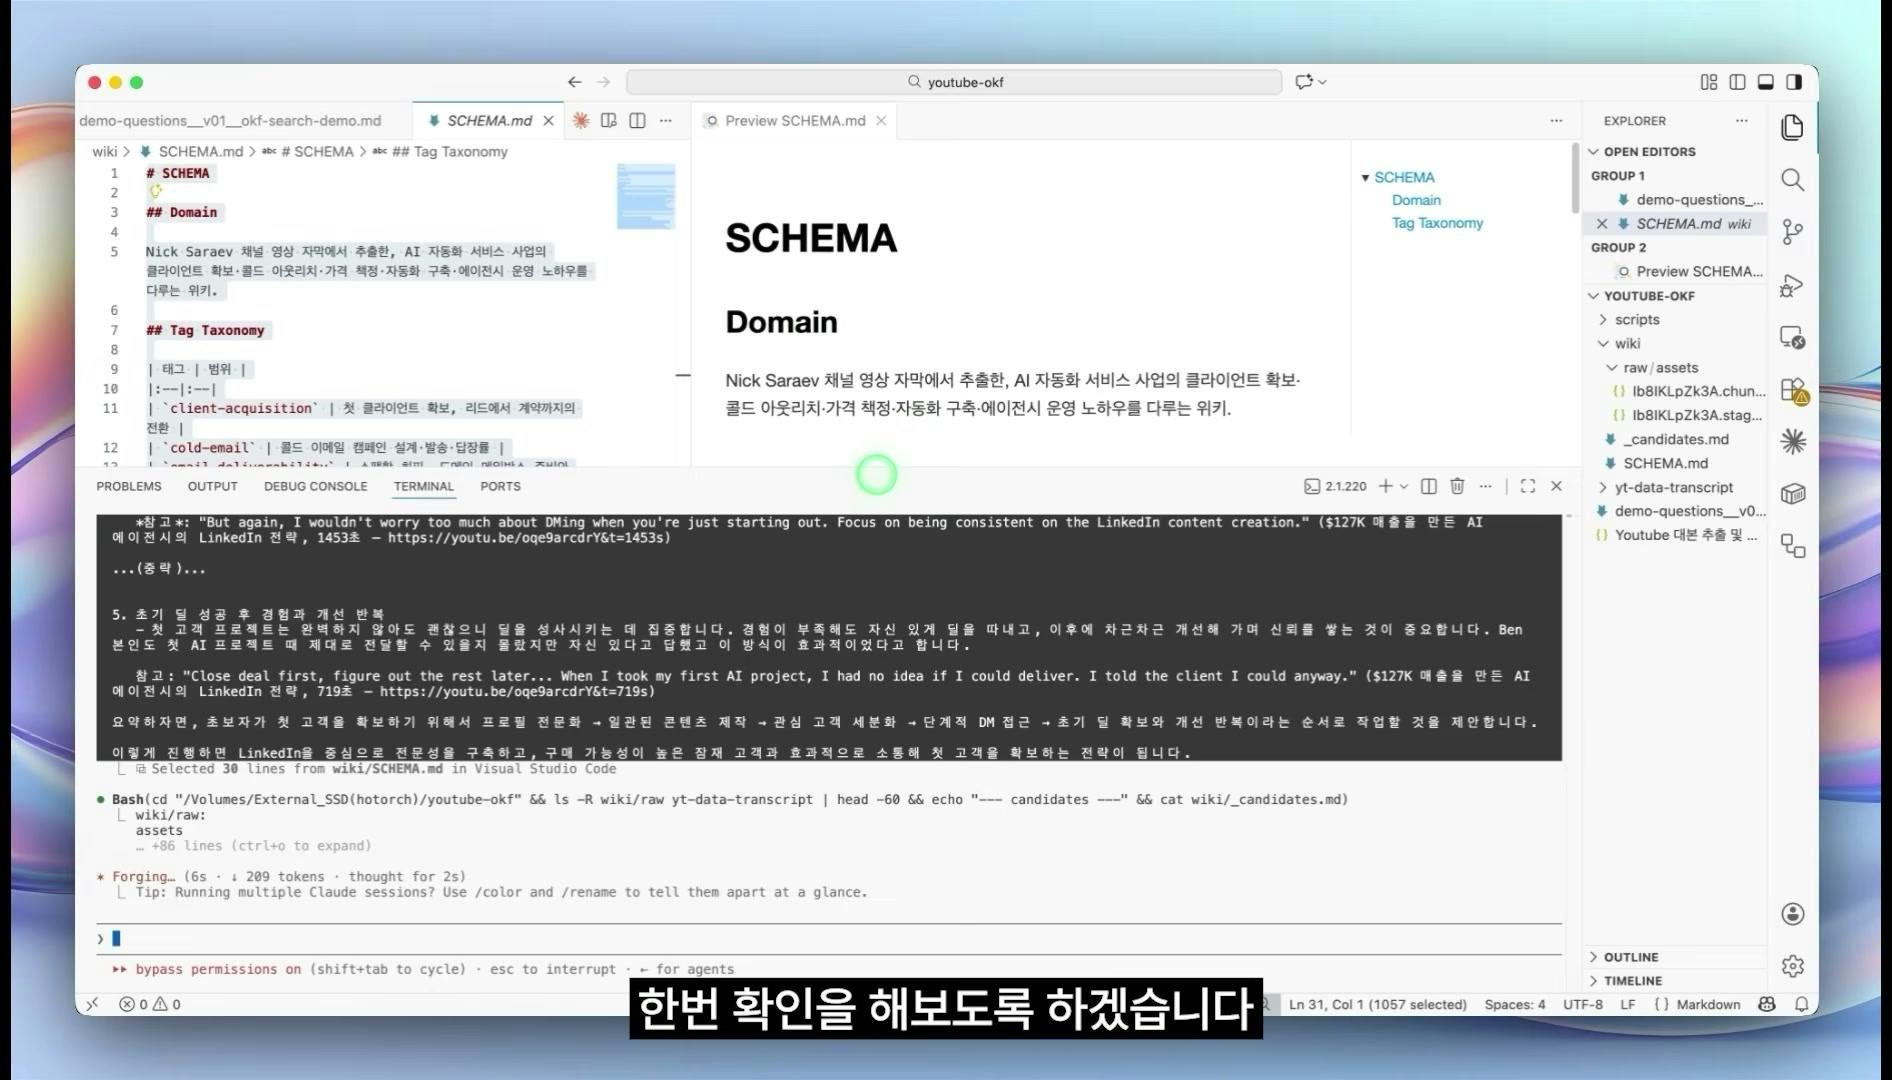
처음부터 완성된 규칙서를 만들지 않고, 단일 영상 테스트에 필요한 규칙부터 확인했습니다. 출처: 샘 호트만 : AI 엔지니어의 시선, [14:30].
▶ 4. 영상 한 편만 넣고 검증했습니다
다음 단계에서 바로 수십 편을 적재하지 않았습니다. 영상 한 편만 처리하게 하고, 개념 페이지와 원본 대본의 연결을 확인했습니다.
개념 페이지는 사람이 읽을 수 있는 요약이고, 원본 대본은 근거입니다. 이 둘이 연결되지 않으면 그럴듯한 요약만 남습니다.
---
title: cold email
description: 콜드 이메일을 이용해 초기 고객을 확보하는 방법
resource: https://youtu.be/<video_id>?t=<start_sec>
video_id: <video_id>
start_sec: 506
end_sec: 798
tags: [cold-email, client-acquisition]
---

# 콜드 이메일

요약 내용...

■ 출처

• 원본 영상: 08:26~13:18
• 원문: raw/transcripts/<video_id>.md#t506
실제 검증 프롬프트는 다음과 같습니다.
지금 만든 SCHEMA.md 기준으로 아직 처리하지 않은 유튜브 자막 영상 1개만 위키에 넣어줘.

LLM Wiki Skill에서 정한 가장 단순한 방식을 따라줘.
원본 자막은 raw에 보존하고, 필요한 개념 페이지는 concepts에 만들어줘.

답변이나 개념 페이지에는 반드시 다음 출처 정보를 남겨줘.

• 영상 제목
• 원본 유튜브 링크
• 해당 내용을 말한 시작 시각과 끝 시각
• 원문 인용
• 원문 자막 파일로 이동할 수 있는 링크

처리가 끝나면 다음을 알려줘.

1. 새로 만든 페이지
2. 수정한 페이지
3. SCHEMA.md에 추가가 필요한 규칙 후보
4. 출처 링크와 타임스탬프가 실제 대본 구간과 맞는지 검사 결과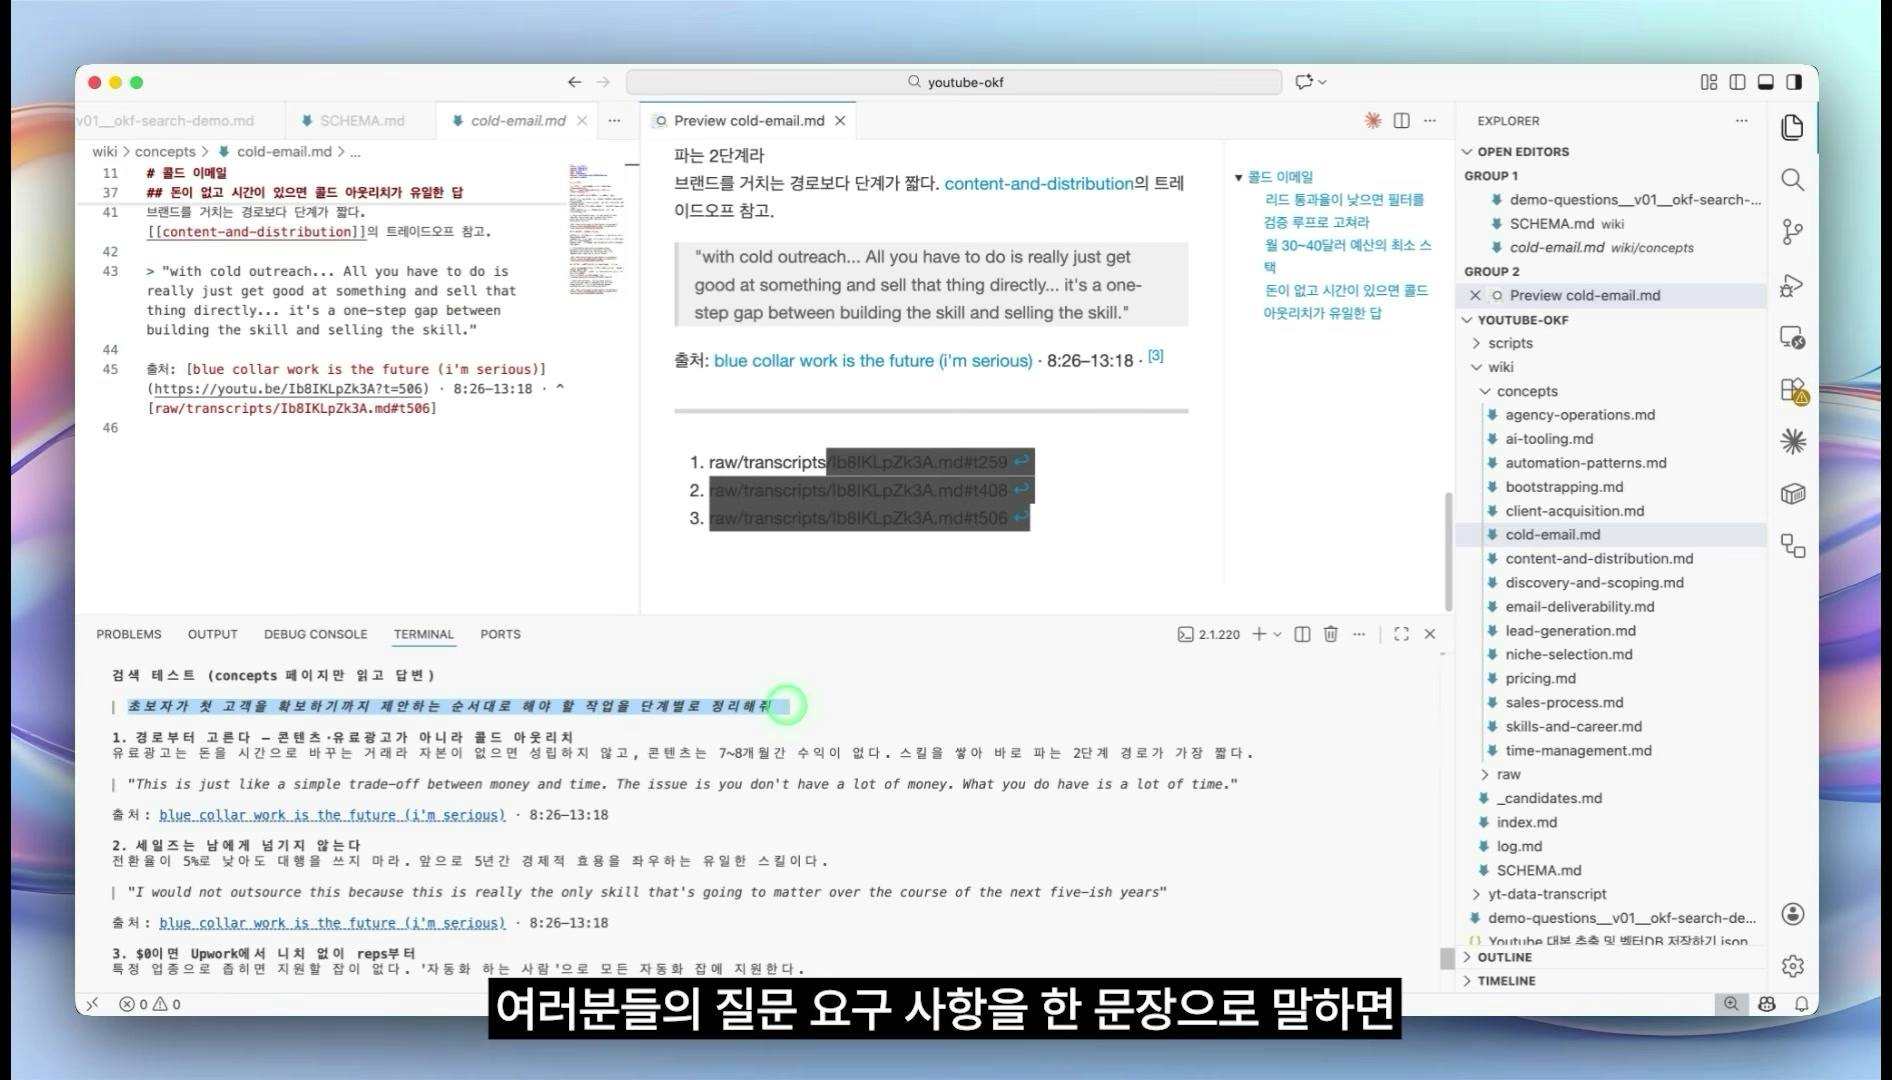
개념 페이지는 요약이고, raw/transcripts의 원문 링크가 근거입니다. 출처: 샘 호트만 : AI 엔지니어의 시선, [16:20].
▶ 5. 타임스탬프를 직접 눌러봤습니다
이 프로젝트에서 가장 중요한 검증은 “답변이 그럴듯한가”가 아니었습니다. 답변에 붙은 시각을 눌렀을 때, 실제 영상이 그 이야기를 하고 있는가였습니다.
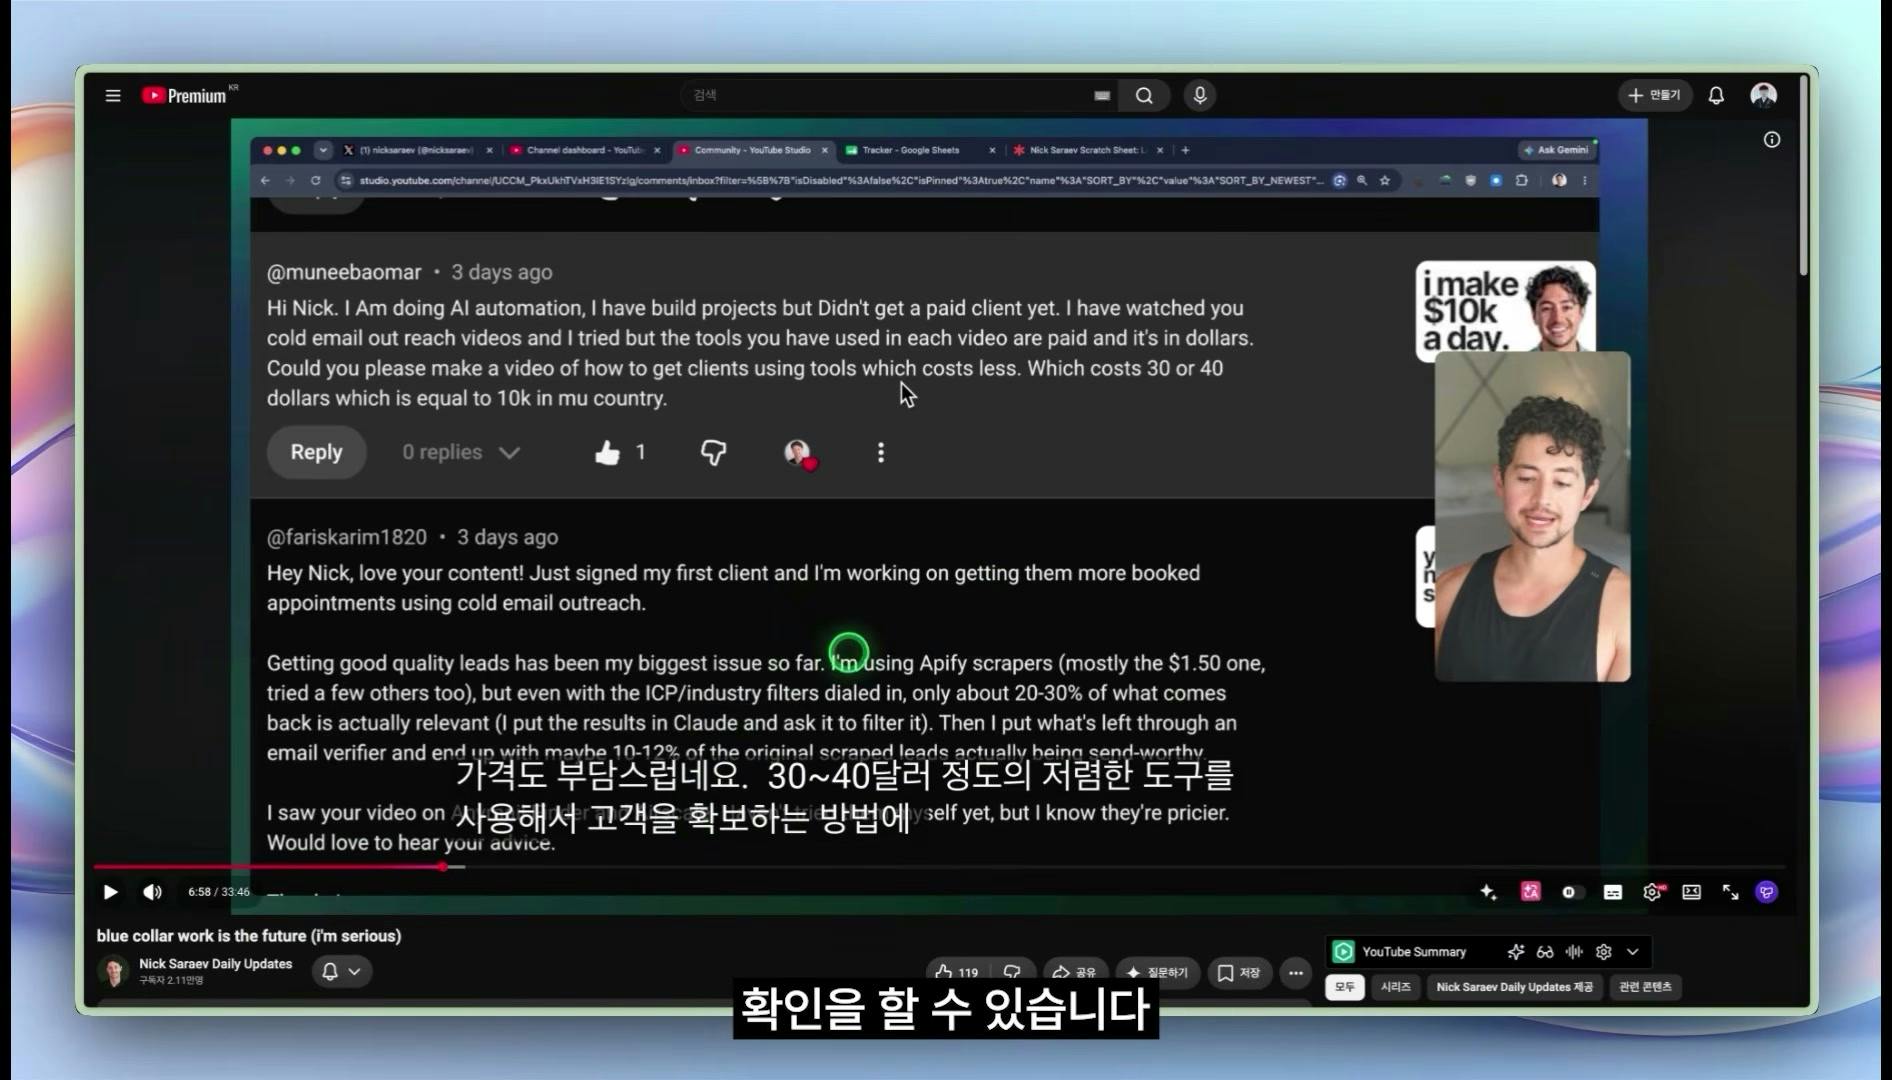
답변에 붙은 시간이 실제 내용과 맞는지 직접 눌러 확인했습니다.
이 검증에서 타임스탬프가 맞지 않으면 프롬프트를 더 길게 쓰지 않았습니다. SCHEMA.md에 출처 규칙을 한 줄 추가하는 방식으로 고쳤습니다.
이 방식은 프롬프트를 매번 다시 쓰는 것보다 유지하기 쉽습니다. 한 번 발견한 오류를 다음 실행에도 적용할 수 있기 때문입니다.
▶ 6. 성공한 한 사이클을 Skill로 만들었습니다
영상 한 편에서 성공한 수집·전처리·적재·검증 사이클을 반복 가능한 Skill로 정리했습니다. 이때 역할을 나눴습니다.
• Python: 자막 수집, 파일 변환, 중복 확인처럼 같은 입력이면 같은 결과가 나와야 하는 일
• LLM: 개념 분류, 기존 페이지와의 연결, 요약처럼 의미를 해석해야 하는 일
• 사람: 태그 사전 확정, 출처 정확도 확인, 최종 배포 여부
LLM에게 파일 중복 여부와 같은 결정론적 작업까지 맡기면 결과가 흔들립니다. 반대로 사람이 매일 복사·붙여넣기를 하면 자동화의 의미가 줄어듭니다.
영상 1개에서 Skill로 넘길 때 사용한 프롬프트는 다음과 같습니다.
영상 1개에서 성공한 수집과 위키 적재 과정을 반복 가능한 Skill로 정리해줘.

지금 만든 자막 수집 스크립트와 위키 폴더를 그대로 사용해.
새 영상이 없으면 아무것도 처리하지 않게 해.
처리 전에 이미 적재된 video ID와 비교해서 중복을 막아.
원본 자막은 raw에 보존하고, 개념 페이지는 기존 SCHEMA.md 규칙을 따라 업데이트해.

실행이 끝나면 다음을 보고해.

• 새로 처리한 영상 수
• 새로 만든 페이지
• 수정한 페이지
• SCHEMA.md 변경 후보
• 자막 누락, 중복, 출처 링크, 타임스탬프 검사 결과
▶ 7. Hermes와 Slack으로 넘기고 cron을 걸었습니다
Claude Code에서 만든 Skill, Python 스크립트, 위키 폴더를 Hermes의 Annie 프로필로 옮겼습니다. Hermes에서는 파일을 직접 열어보는 대신 Slack 스레드에서 질문하고 결과를 받도록 연결했습니다.
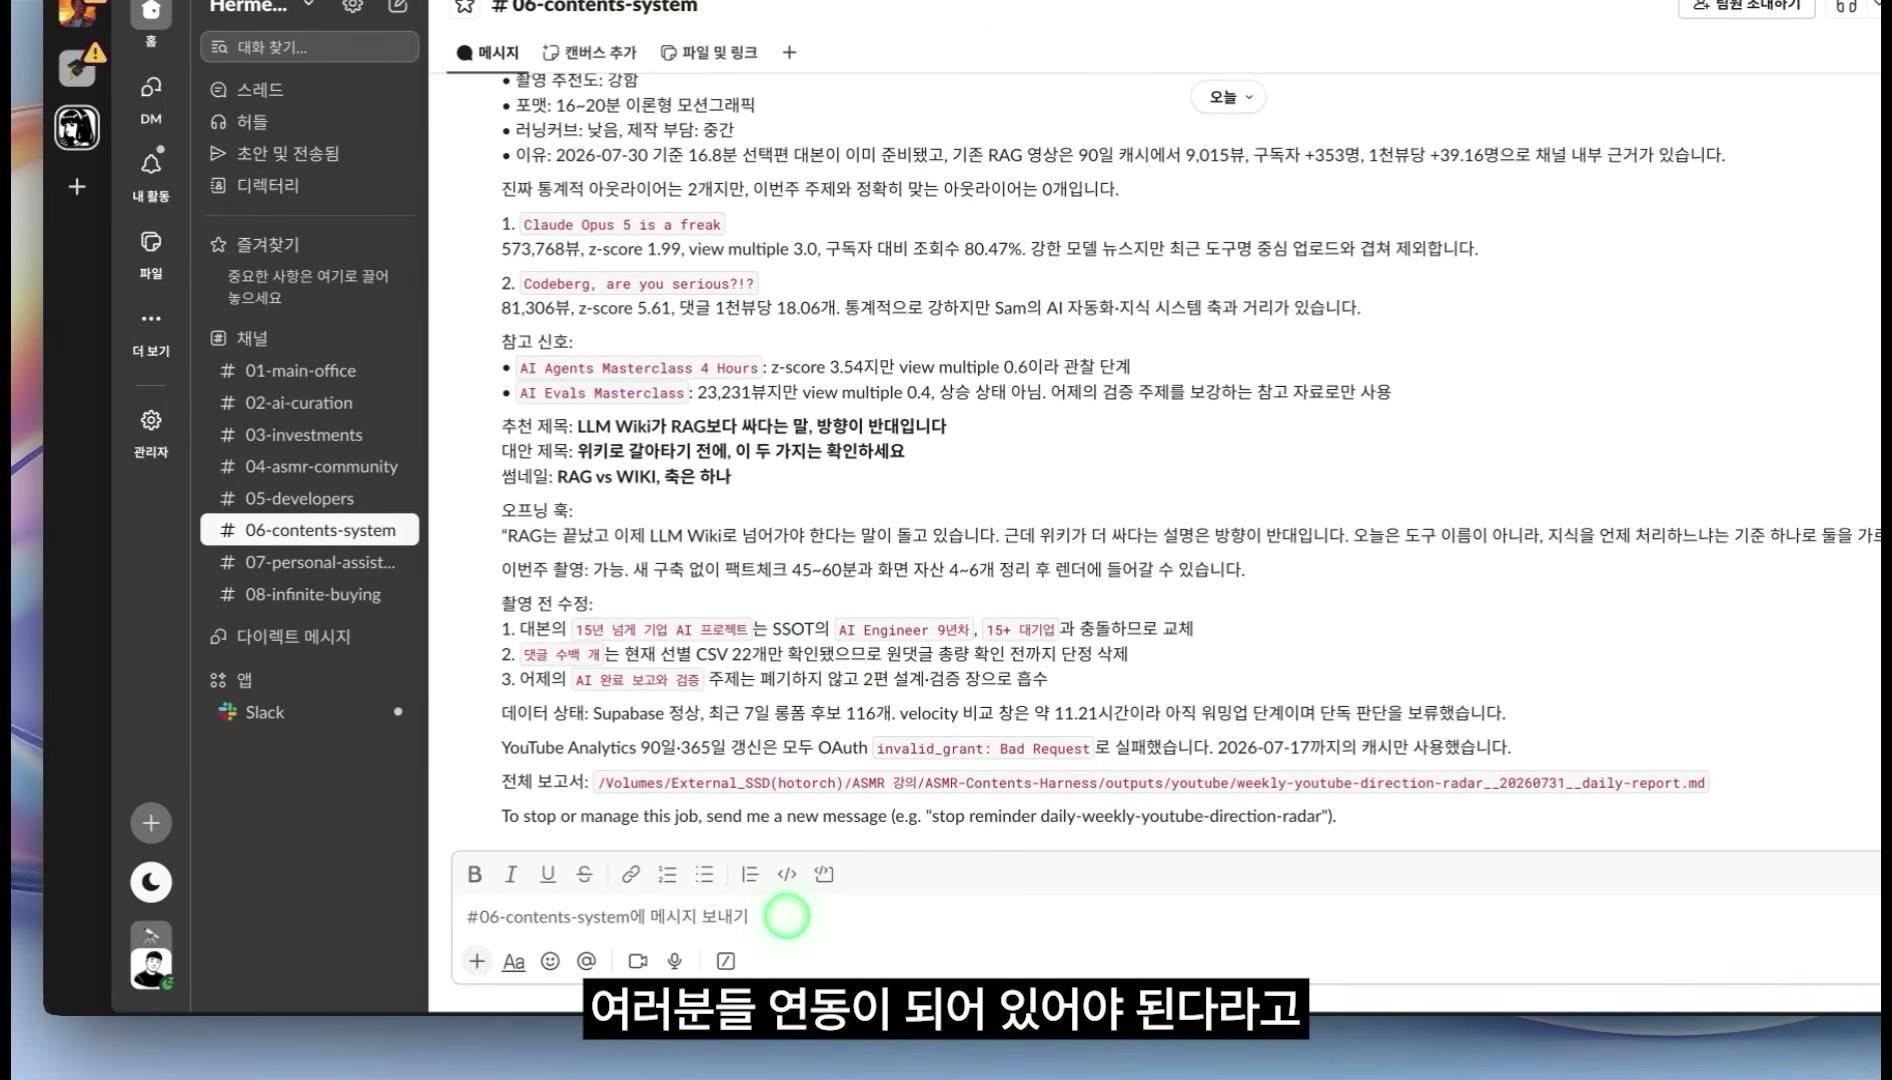
검증된 한 사이클을 Skill로 굳힌 뒤 Hermes 프로필로 옮겼습니다.
Hermes에 위키 질문을 던진 뒤에는 답변뿐 아니라 여러 원본 영상의 출처가 함께 나왔습니다.
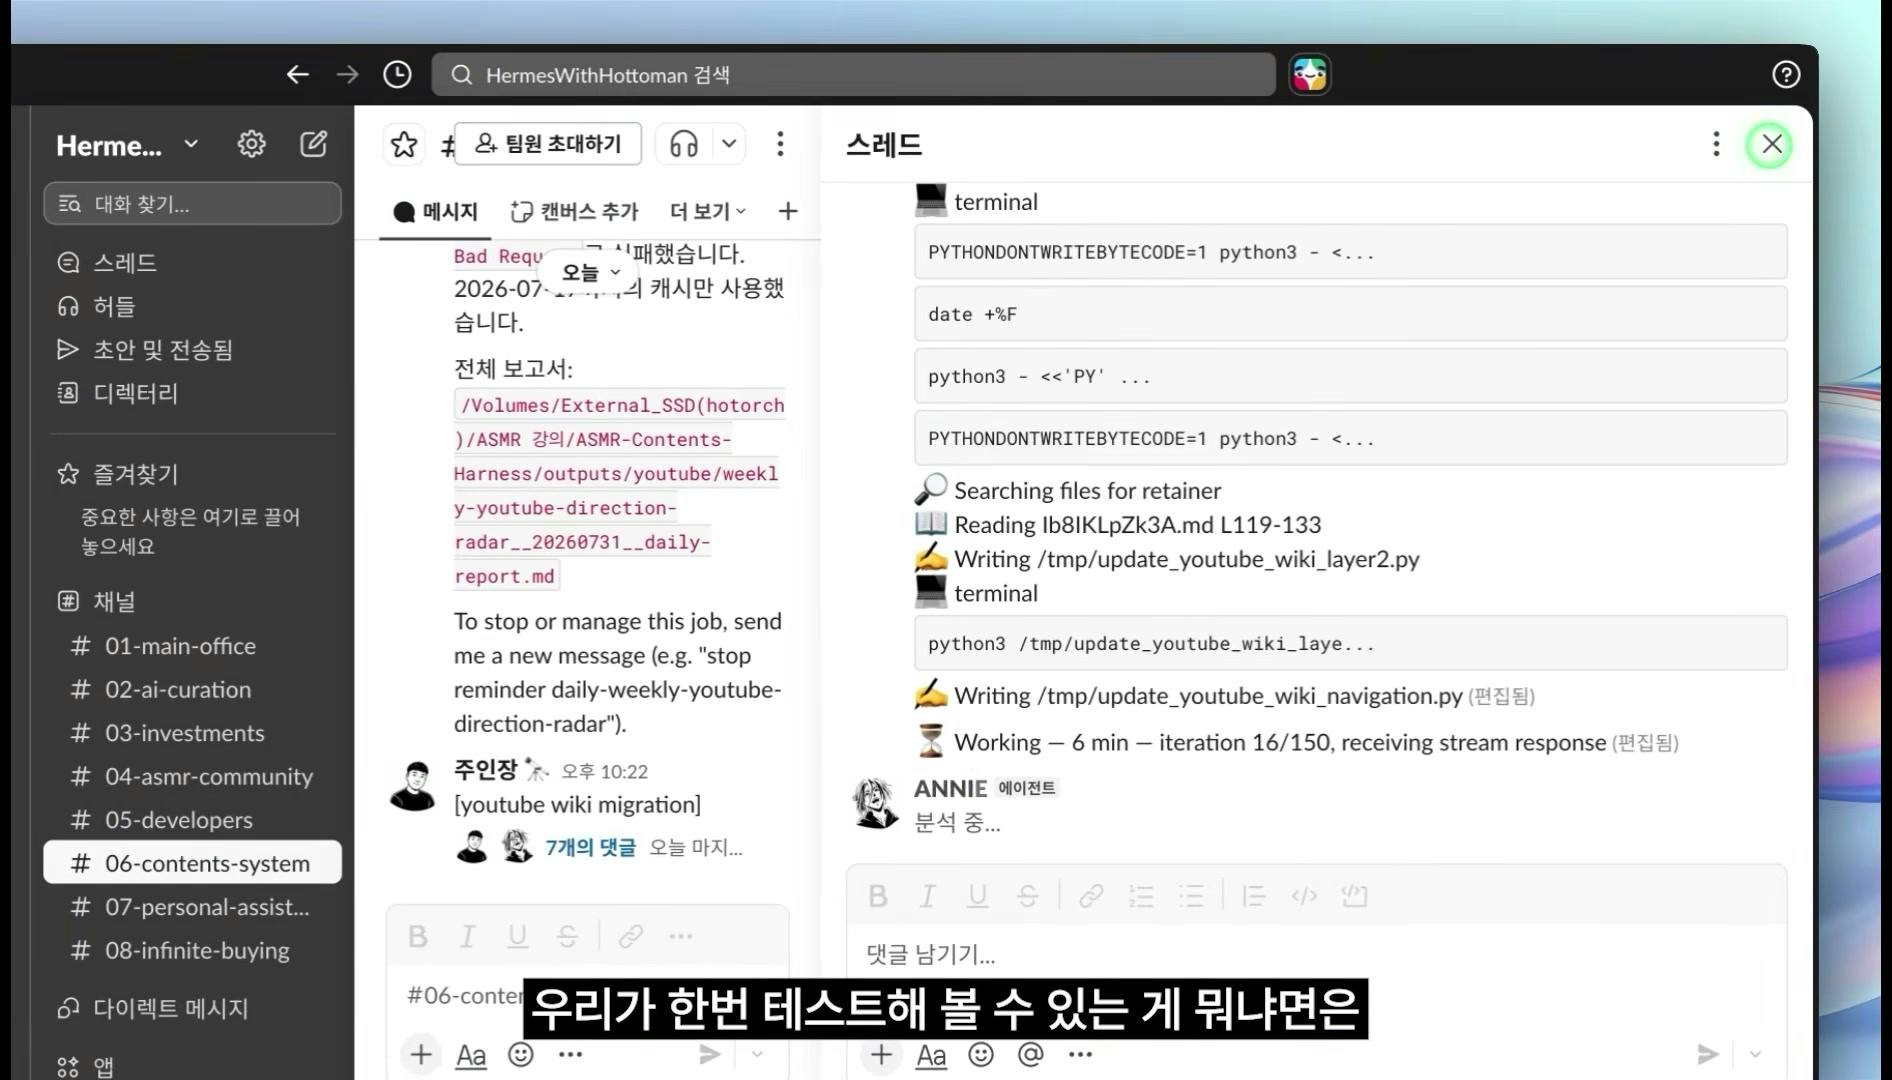
Slack에서는 답변과 함께 여러 영상의 원본 구간을 확인할 수 있습니다.
마지막으로 새 영상이 있을 때만 하루에 한 편을 적재하도록 cron을 설정했습니다.
방금 테스트한 youtube-wiki-ingest 작업을 매일 한국시간 새벽 1시에 자동으로 실행해줘.

새 영상이 있으면 한 개만 위키에 넣고,
새 영상이 없으면 아무 파일도 변경하지 마.

실행 후에는 다음 내용을 지금 대화 중인 Slack 채널에 알려줘.

• 새로 확인한 영상
• 적재한 영상 수
• 새로 만든 페이지
• 수정한 페이지
• SCHEMA.md 변경 후보
• 검사 결과와 오류가 있으면 그 원인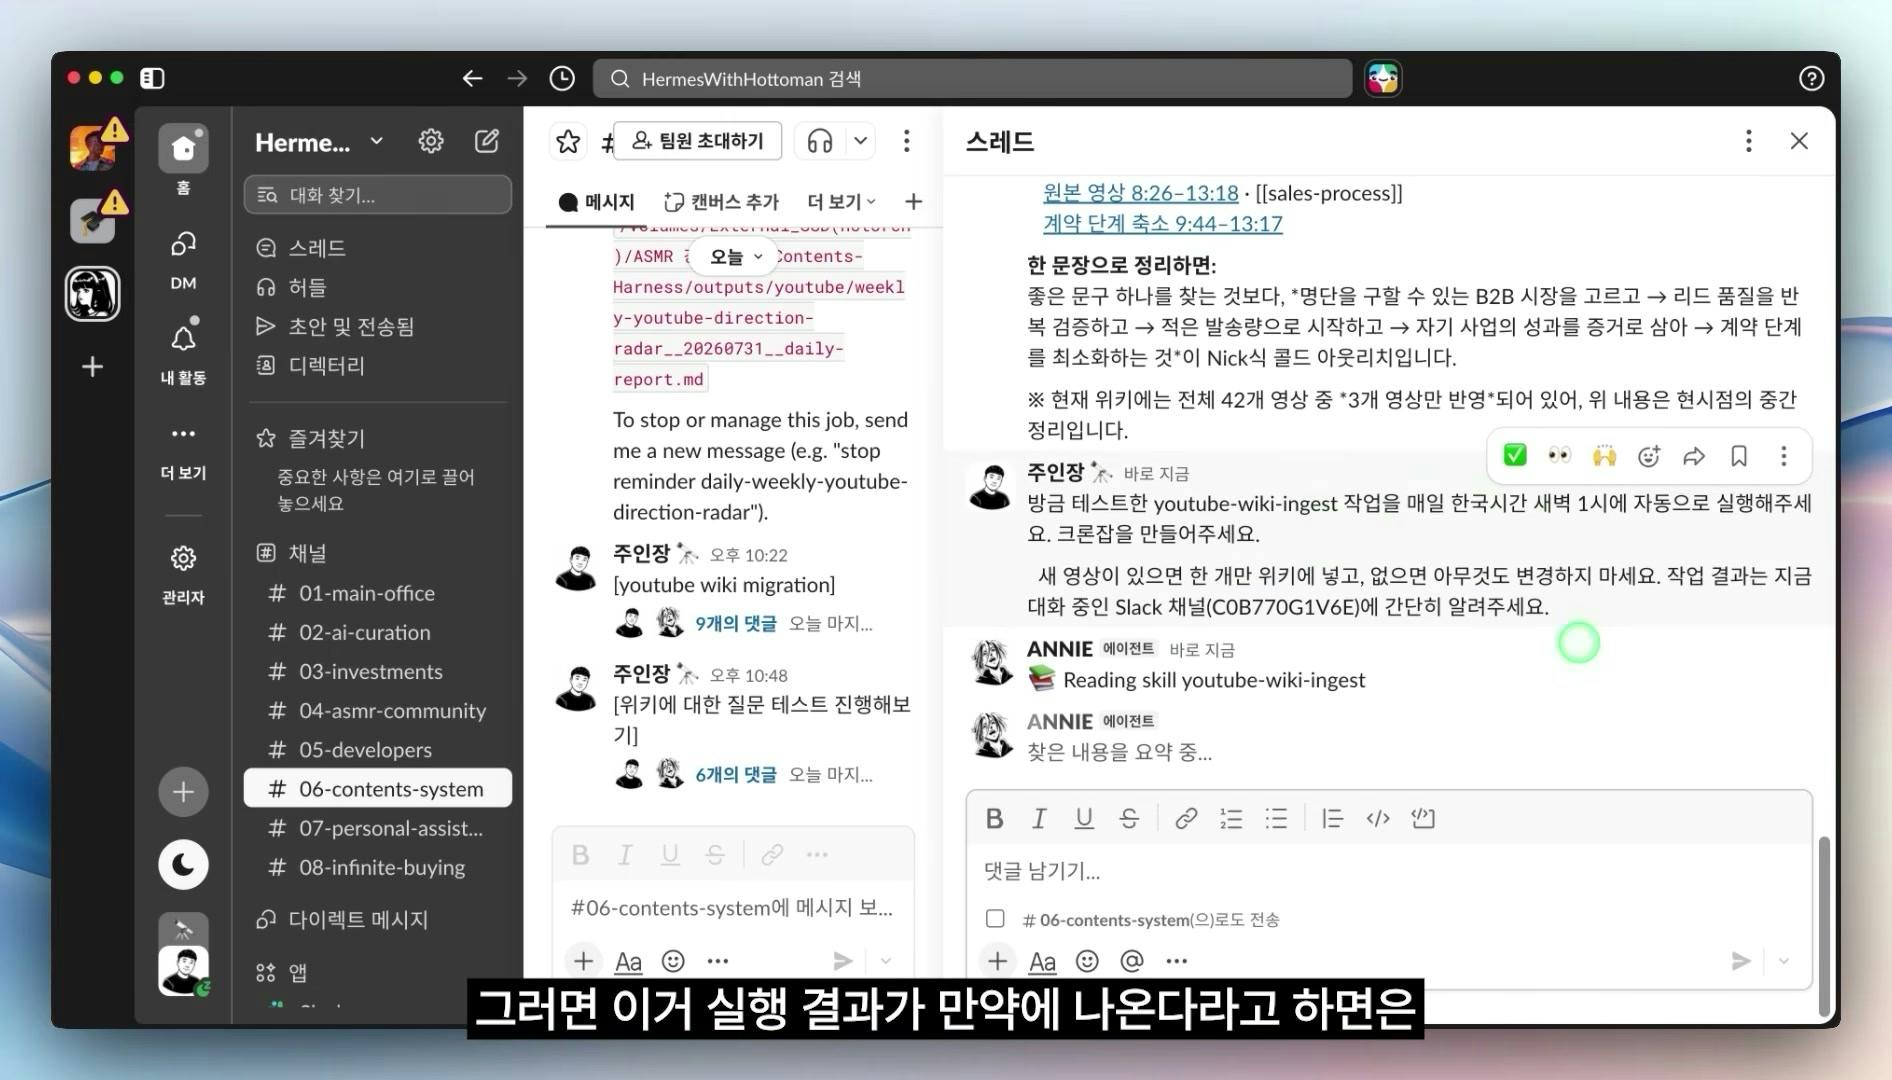
새 영상이 있을 때만 한 편씩 처리하고, 없으면 아무것도 바꾸지 않게 했습니다.
한 번에 30~40편을 넣지 않고 한 편씩 넣은 이유도 여기에 있습니다. 자동화가 잘못되었을 때 어디서 틀렸는지 찾으려면 변경 폭이 작아야 합니다.
■ 결과와 배운 점
▶ 답변보다 원본 확인이 더 중요했습니다
최종 결과는 다음과 같습니다.
• 유튜브 대본 수십 편을 Markdown 기반 위키로 정리
• Slack에서 자연어 질문 가능
• 여러 영상의 내용을 묶어서 답변
• 답변마다 영상 제목, 원본 링크, 시작·끝 시각 제공
• 링크를 눌러 해당 장면 확인
• 새 영상이 있으면 하루에 한 편씩 자동 적재
• Obsidian에서 개념 페이지와 링크 구조 확인
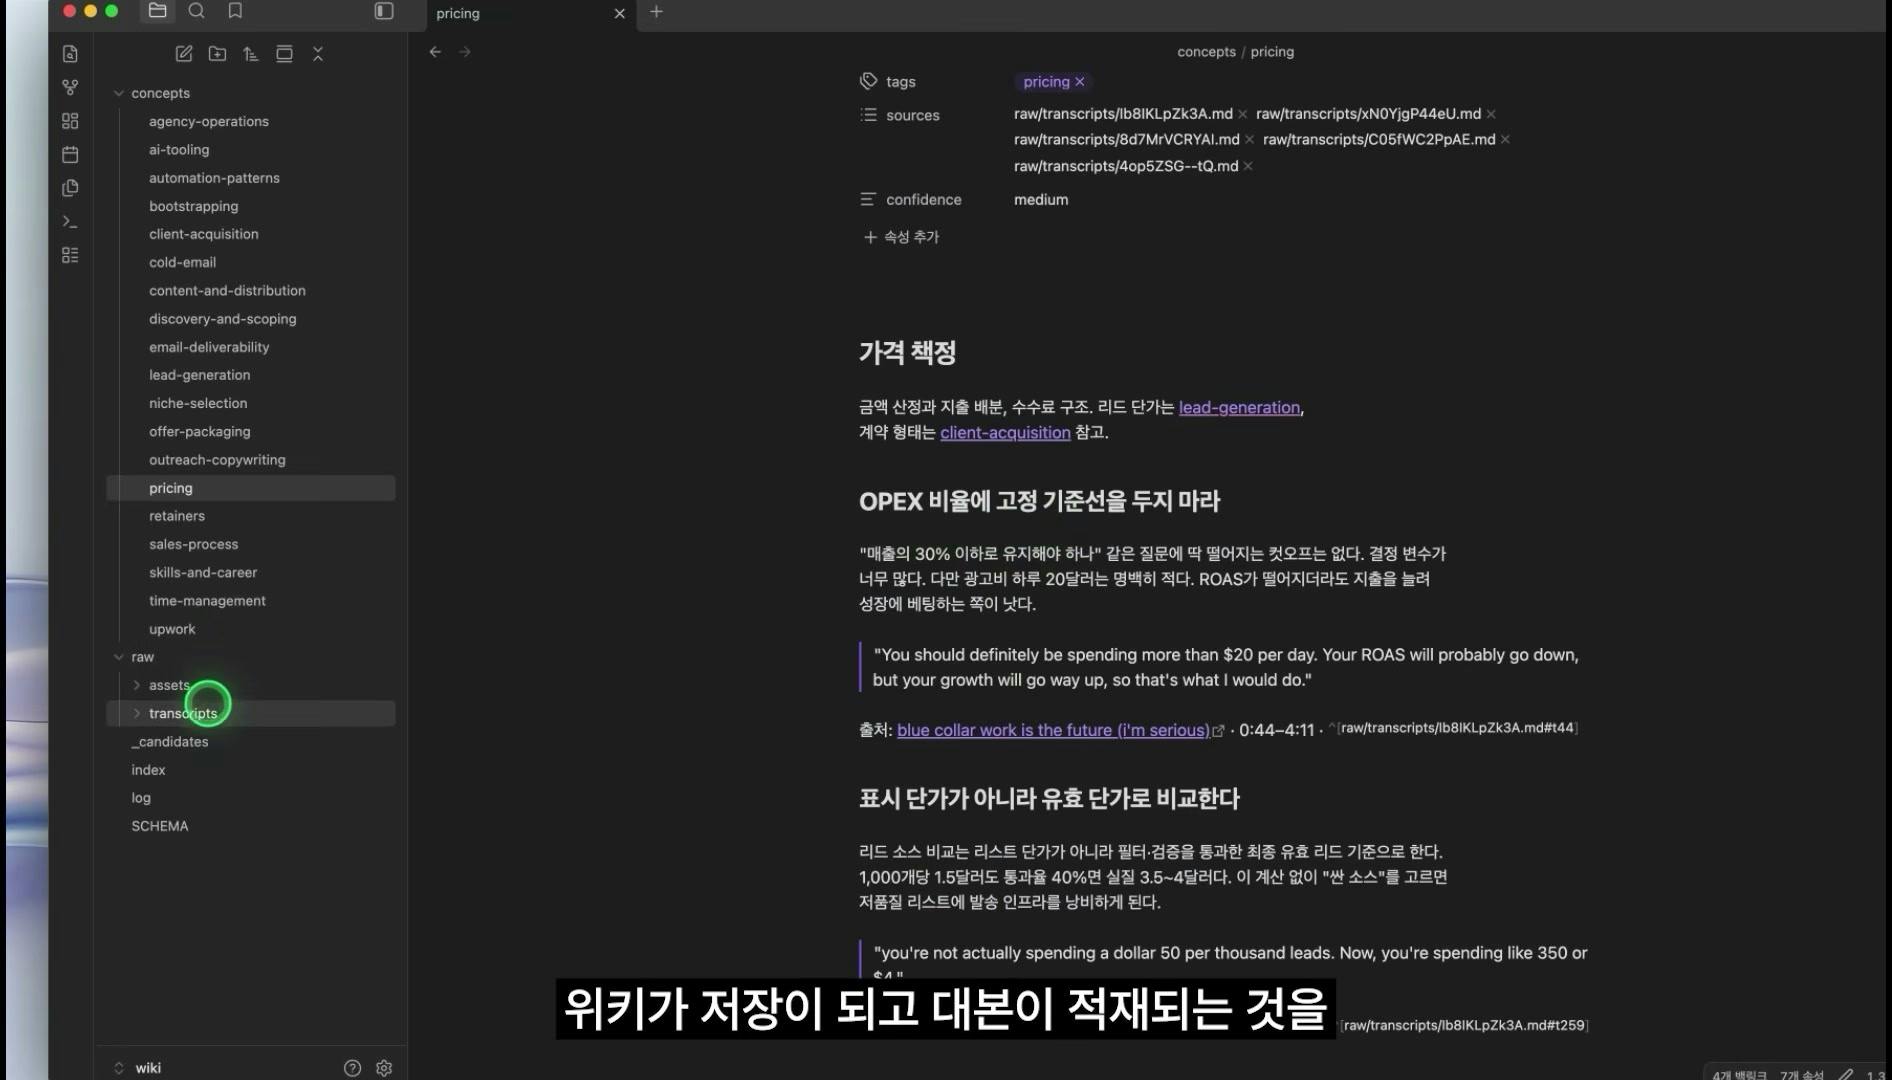
같은 위키 폴더를 Obsidian Vault로 열어 개념과 원문을 함께 탐색했습니다.
가장 큰 변화는 “영상이 쌓인다”에서 “질문할 수 있는 지식이 쌓인다”로 바뀐 점입니다. 저장만 하면 다시 찾는 비용은 그대로 남습니다. 질문, 답변, 원본 확인이 이어지는 루프가 만들어져야 재사용이 생깁니다.
▶ SCHEMA.md는 문서 양식이 아니라 운영 규칙입니다
처음에는 Domain과 Tag Taxonomy만 있었습니다. 이후 요구 사항이 추가되면서 다음 규칙이 생겼습니다.
• 개념 페이지는 원문 자막을 근거로 작성
• 출처에는 영상 ID와 시작·끝 시각 포함
• 원문 인용을 함께 표시
• 영상 전체가 아니라 해당 구간을 가리키는 링크 사용
• 새 태그는 임의로 만들지 않고 사람이 승인
• 적재 전 기존 index와 log를 확인
AI가 잘못한 결과를 보고 매번 긴 프롬프트를 다시 만드는 대신, 다음부터 같은 오류가 반복되지 않도록 SCHEMA.md에 규칙을 추가했습니다. 위키의 품질은 자료 양보다 규칙이 어떻게 쌓이는지에 더 크게 좌우됩니다.
▶ 시행착오 1. 아키텍처부터 만들려고 했습니다
처음에는 RAG인지 LLM Wiki인지부터 고르려고 했습니다. 그런데 데이터에 어떤 질문이 들어올지 모르는 상태에서 구조를 정하면, 실제로 쓰지 않는 필드가 생깁니다.
대본을 먼저 모으고, 질문 후보를 뽑고, 질문에 필요한 출처 필드를 역산하는 순서가 훨씬 짧았습니다.
▶ 시행착오 2. LLM과 Python의 경계를 섞을 뻔했습니다
자막 파일 변환, 중복 확인, ID 기록은 코드가 맡는 편이 안정적입니다. 개념 분류와 페이지 연결은 LLM이 맡는 편이 자연스럽습니다.
이 경계를 섞으면 파일 중복 여부를 LLM이 매번 판단하고, 사람이 결과를 다시 정리하는 구조가 됩니다. 자동화가 아니라 역할 분담을 먼저 정해야 했습니다.
▶ 시행착오 3. 타임스탬프를 나중에 붙이려 했습니다
원문 링크와 시간 정보를 마지막에 붙이면, 이미 만들어진 요약을 다시 추적해야 합니다. 처음부터 자막 구간과 video ID를 함께 저장하고, 출처 형식을 SCHEMA.md에 넣는 편이 맞았습니다.
▶ 시행착오 4. Skill과 Hermes의 저장 경로가 달랐습니다
촬영 환경에서는 외장 SSD의 프로젝트 폴더에서 Claude Code로 Skill과 Python 파일을 만들었습니다. Hermes는 기본 프로필 경로를 사용했기 때문에 파일을 옮길 때 경로가 달라졌습니다.
이 부분은 그대로 복사하면 안 됩니다. 각자 Hermes 프로필 위치와 위키 저장 위치를 먼저 확인하고, 프롬프트의 경로는 자신의 환경에 맞게 바꿔야 합니다.
▶ 나만의 꿀팁
1. 데이터가 작을 때 검색 인프라부터 만들지 않습니다. 질문 목록과 파일 구조가 먼저입니다.
2. AI에게 질문 후보를 뽑게 하되 최종 질문은 직접 지웁니다. 실제로 다시 물어볼 말투가 남아야 합니다.
3. 한 편만 처리하고 링크를 눌러봅니다. 이 검증을 통과한 뒤에 Skill로 굳힙니다.
4. 문제가 생길 때마다 프롬프트를 길게 만들지 말고 SCHEMA.md에 규칙을 한 줄 추가합니다.
5. cron은 마지막에 겁니다. 검증하지 않은 과정을 반복하면 오류가 자동으로 쌓입니다.
▶ 도움이 필요한 부분
현재는 개인용 지식 창고로는 충분하지만, 회사 문서에 적용하려면 다음을 더 검토해야 합니다.
• 부서별 문서 권한을 어떻게 분리할 것인가
• 원문이 수정되거나 폐기됐을 때 관련 개념 페이지를 어떻게 갱신할 것인가
• 타임스탬프 정확도와 답변 품질을 어떤 평가셋으로 점검할 것인가
• 어느 시점에 Markdown 위에 BM25, Vector Search, RAG를 추가할 것인가
특히 사내 규정, 법률, 금융처럼 틀린 답의 비용이 큰 데이터는 LLM Wiki만으로 끝내기 어렵습니다. 원문 검색과 정리된 지식이 모두 필요하면 하이브리드 구조가 더 현실적입니다.
▶ 앞으로의 계획
먼저 처리하지 못한 영상은 한 번에 몰아넣지 않고 조금씩 추가할 예정입니다. 이후에는 같은 구조를 회의록, 고객 상담 기록, 강의 VOD, 사내 문서에 적용해 보려고 합니다.
개인용으로는 LLM Wiki가 가볍게 시작하기 좋습니다. 하지만 조직에서 사용하려면 원본 보존, 권한, 승인, 변경 이력까지 포함한 운영 규칙이 필요합니다. 도구 선택보다 먼저 “반복해서 물어볼 질문은 무엇인가”를 적는 이유입니다.
이 구조를 직접 적용해 본다면, 먼저 반복해서 다시 찾는 자료 하나와 실제 질문 세 개를 정한 뒤 댓글에 결과를 남겨주세요.
■ 도움 받은 글
• 원본 영상 (https://www.youtube.com/watch?v=aI5nyQKhl9o): 이 글에서 다룬 LLM Wiki와 Hermes 구축 실습
• Andrej Karpathy, LLM Wiki 제안 (https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f): LLM을 지식베이스 편집자와 컴파일러처럼 사용하는 발상
• Google Cloud, Open Knowledge Format (https://cloud.google.com/blog/products/data-analytics/how-the-open-knowledge-format-can-improve-data-sharing): Markdown과 YAML 기반 지식 포맷을 교환 규격으로 다루는 사례
• Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (https://arxiv.org/abs/2005.11401): RAG의 기본 개념을 확인하기 위한 논문
• Hermes 내장 llm-wiki Skill: ~/.hermes/skills/research/llm-wiki/SKILL.md
참고로 이 글에 들어간 화면 캡처는 영상 원본에서 직접 추출한 프레임이며, 캡처 시각을 캡션에 표시했습니다.
로그인하고 댓글을 남겨 주세요

아웅 좋아좋아 깃빨꽃아놔야징 ㅎㅎㅎ^^

와~ 수십 개의 유튜브 영상을 한꺼번에 넣는 자동화도 흥미로웠지만, 저는 일단 영상 하나로 먼저 검증해 보는 과정이 더 인상 깊었어요.
특히 오류가 생길 때마다 프롬프트만 고치는 게 아니라 SCHEMA.md에 규칙으로 남겨 다음 실행이 더 똑똑해지게 만든다는 점! 아하~ 이게 진짜 시스템을 키워가는 방법이구나 싶었습니다.
Python, LLM, 사람이 잘하는 일을 각각 나눠 맡기는 방식도 많이 배워갑니다.
이렇게 하나씩 쌓이다 보면 정말 ‘나만의 AI 멘토’가 만들어지겠는데요? 다음 이야기도 기대하며 저도 열심히 따라가 볼게요~
검색 기능보다 ‘무엇을 물어볼 것인가’를 먼저 정하고, 거기서 필요한 출처와 시간 표시를 거꾸로 만든 순서가 좋았습니다. 답을 받은 자리에서 원본 영상의 정확한 장면으로 돌아갈 수 있으니 여러 영상을 섞은 요약도 덜 불안하겠네요. 하루 한 편씩 쌓인 위키가 질문 습관을 바꾸는 모습도 자연스럽게 이어질 것 같습니다.
검색 인프라를 먼저 세우지 않고 질문 후보를 뽑은 뒤 그 질문에서 SCHEMA.md를 역산하신 순서가 이 글의 핵심으로 읽혔습니다. 질문이 무엇인지 모른 채 구조를 정하면 쓰지 않는 필드가 늘어난다는 지적에 특히 공감했습니다.
검증 기준을 답변이 그럴듯한가가 아니라 붙어 있는 시각을 눌렀을 때 실제로 그 이야기를 하고 있는가로 잡으신 점이 좋았습니다. 어긋났을 때 프롬프트를 길게 고치는 대신 SCHEMA.md에 규칙 한 줄을 추가하신 방식은 다음 실행에도 그대로 남는다는 점에서 유지비가 훨씬 낮겠네요. SCHEMA.md를 문서 양식이 아니라 운영 규칙으로 보신 정리도 기억에 남습니다.
파이썬은 같은 입력이면 같은 결과가 나와야 하는 일, LLM은 의미를 해석하는 일, 사람은 태그 확정과 출처 확인을 맡는다는 역할 구분도 참고가 됐습니다. 중복 확인처럼 결정론적인 판단을 LLM에 맡기면 결과가 흔들린다는 관찰이 현실적이었습니다.
수십 편을 한 번에 넣지 않고 한 편으로 검증한 뒤 Skill로 굳히고 cron은 마지막에 거신 순서도 인상 깊었습니다. 변경 폭이 작아야 어디서 틀렸는지 찾을 수 있다는 이유가 분명했고, 새 영상이 없으면 아무 파일도 바꾸지 않게 하신 조건도 좋았습니다. 저장 경로가 환경마다 다르니 그대로 복사하지 말라고 짚어주신 점도 친절했습니다.
부서별 권한 분리, 원문이 수정되거나 폐기됐을 때의 갱신, 타임스탬프 정확도를 볼 평가셋, 그리고 어느 시점에 검색 계층을 얹을지 같은 남은 질문들도 흥미롭습니다. 회의록이나 강의 VOD로 확장하시는 다음 이야기도 기대하며 응원하겠습니다!

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


유튜브 좋아요 누르고~~!! 30분 영상 풀시청 잘했습니다~!