[1DAY N8N] N8N 시작하기 #4일차
박정기
2025.03.02
이번 15기 AI 스터디에 앞서, 1DAY N8N,
즉 하루에 1개의 N8N 컬럼을 작성하고자 합니다.
지피터스 15기 문과생도 n8n 스터디 신청링크
HTTP 노드로 HTML 가져오기
오늘은 짧게 http 노드로 할 수 있는 정적 크롤링 하는 법에 대해서 알려드리려고 합니다.
node 검색에 http 라고 검색하시면 다음과 같이 나옵니다
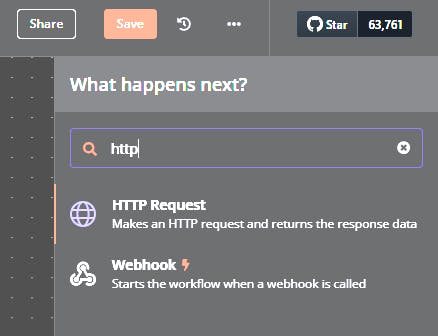
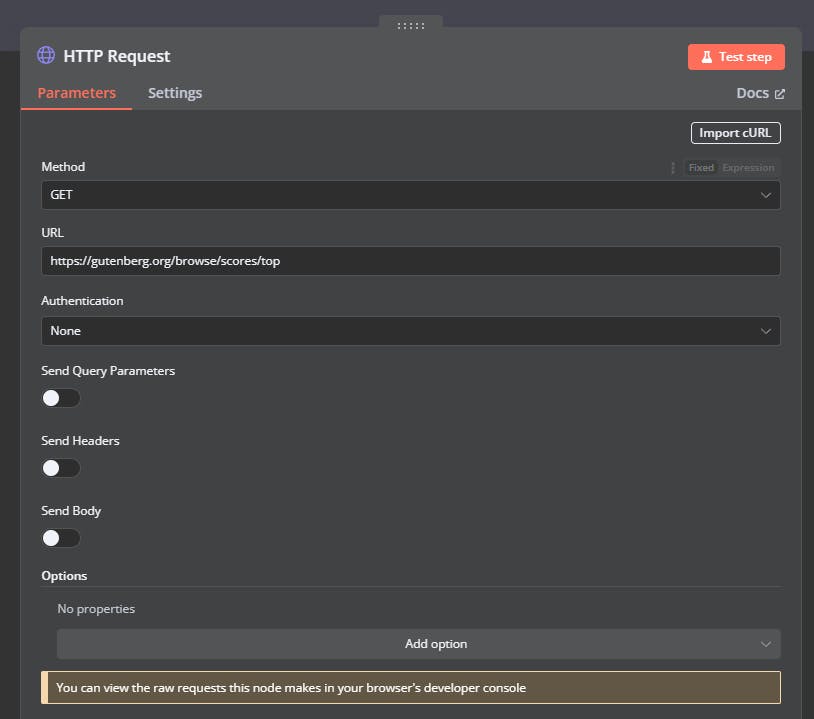
이 노드를 선택하고 오늘은 전세게 무료 도서관인 구텐베르그에서 top100에 대한 데이터를 가져와보도록 하겠습니다.
https://gutenberg.org/browse/scores/top
위 사이트가 전세계 무료 전자 도서관이고,
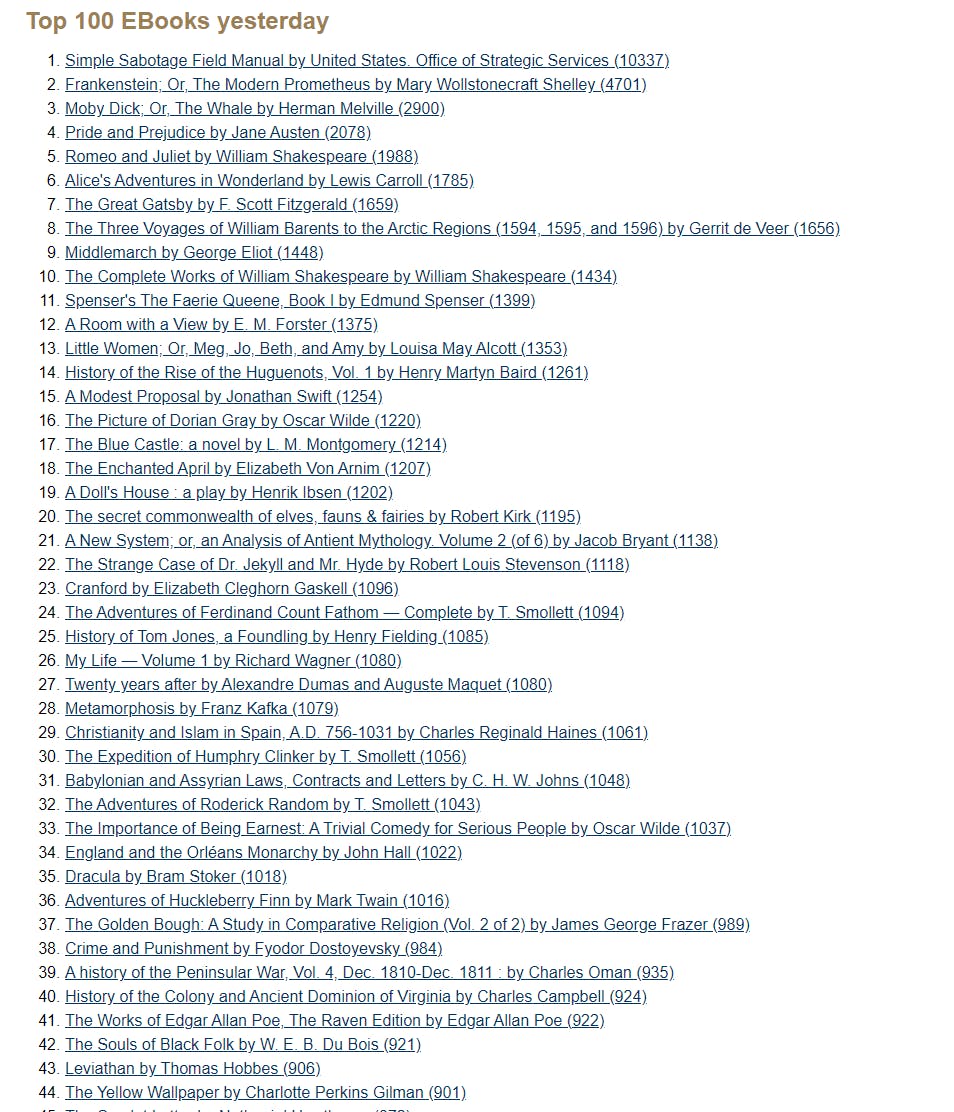
이 값들을 제목과 링크를 가져오는 것 중에 제목만 가져오는 부분을 오늘 해보겠습니다.
HTTP 노드에서 GET을 하여 링크를 가져오면,
결과가 이렇게 나옵니다.
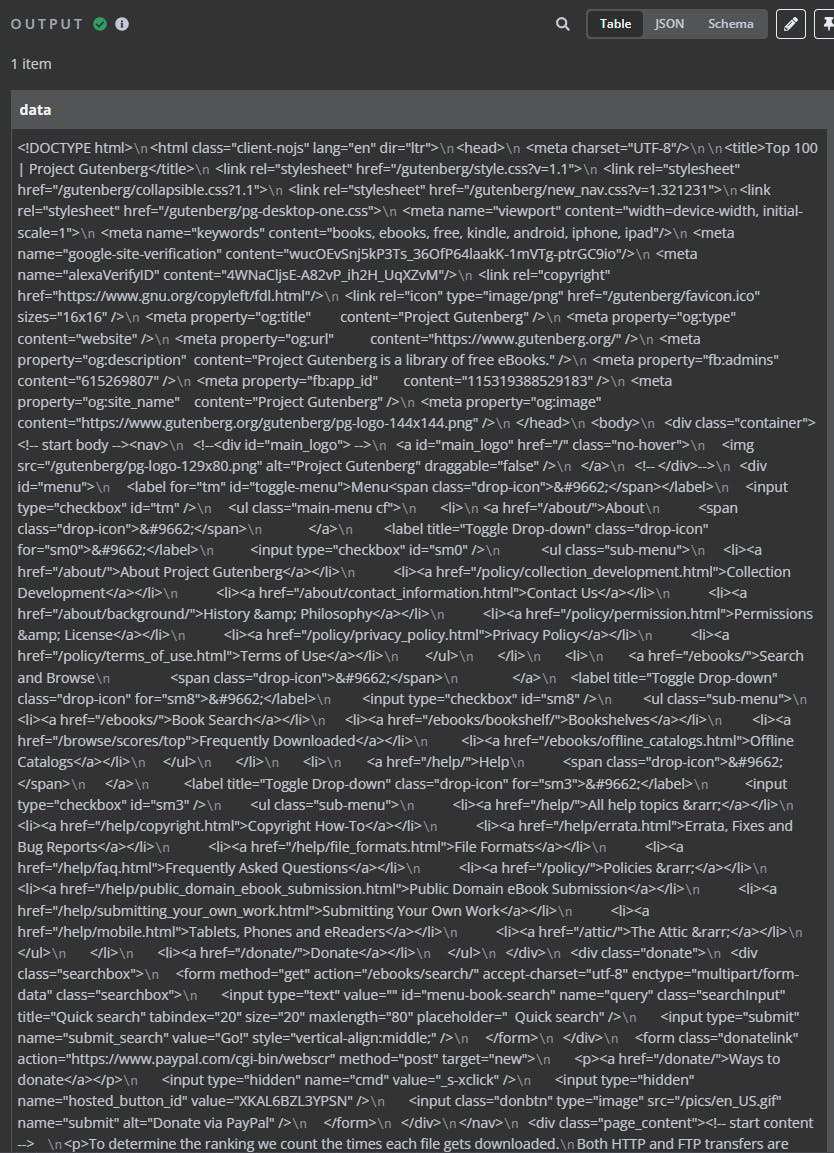
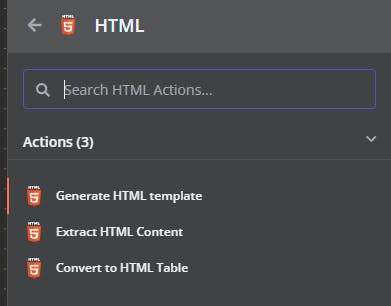
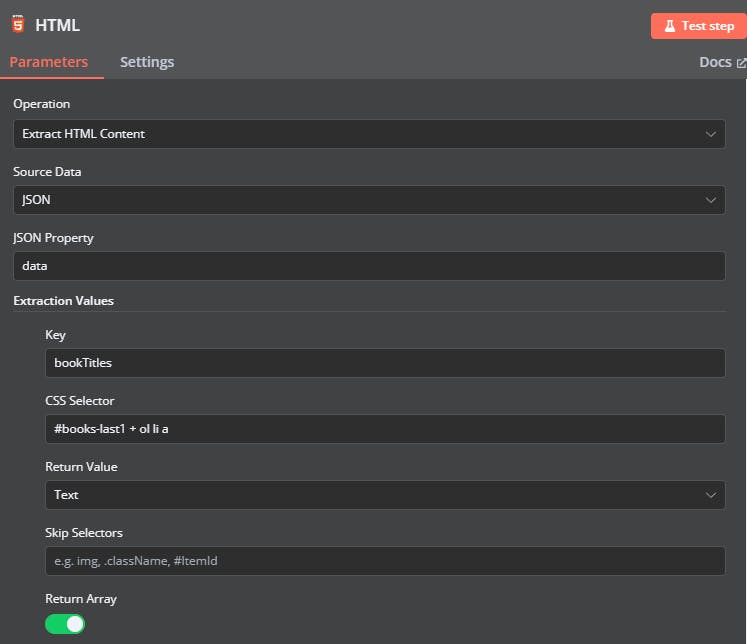
여기서 제목만 파싱을 해오면 되는데 이때 html 노드를 검색하여 Extract 하는 메소드를 선택합니다.
chatGPT o3-mini-high를 이용하여 html 결과를 넣고 옵션을 어떻게 넣어야 하는지 물어봅니다.
이렇게 옵션을 넣으라고 GPT가 알려줘서 넣어보
이렇게 제목을 가져올 수 있었습니다.
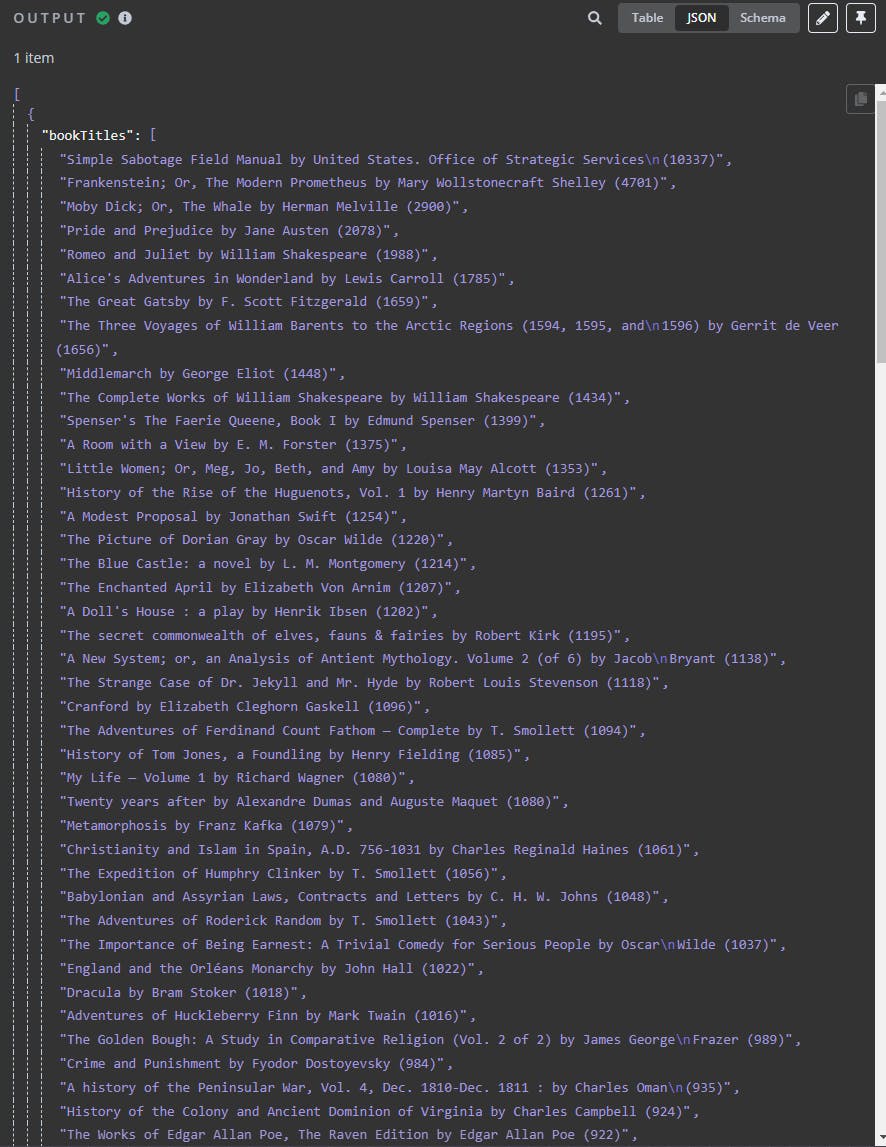
결론 : HTTP 노드로 정적 크롤링이 가능하고, HTML Extract로 원하는 데이터를 가져올 수 있다.
다음시간에 링크까지 가져올 수 있도록 하겠습니다. 그러면 N바!
1일차를 보고 싶으신 분들은 -> https://www.gpters.org/nocode/post/day-1-who-want-BcjXsCdW3KRQxp0/edit

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
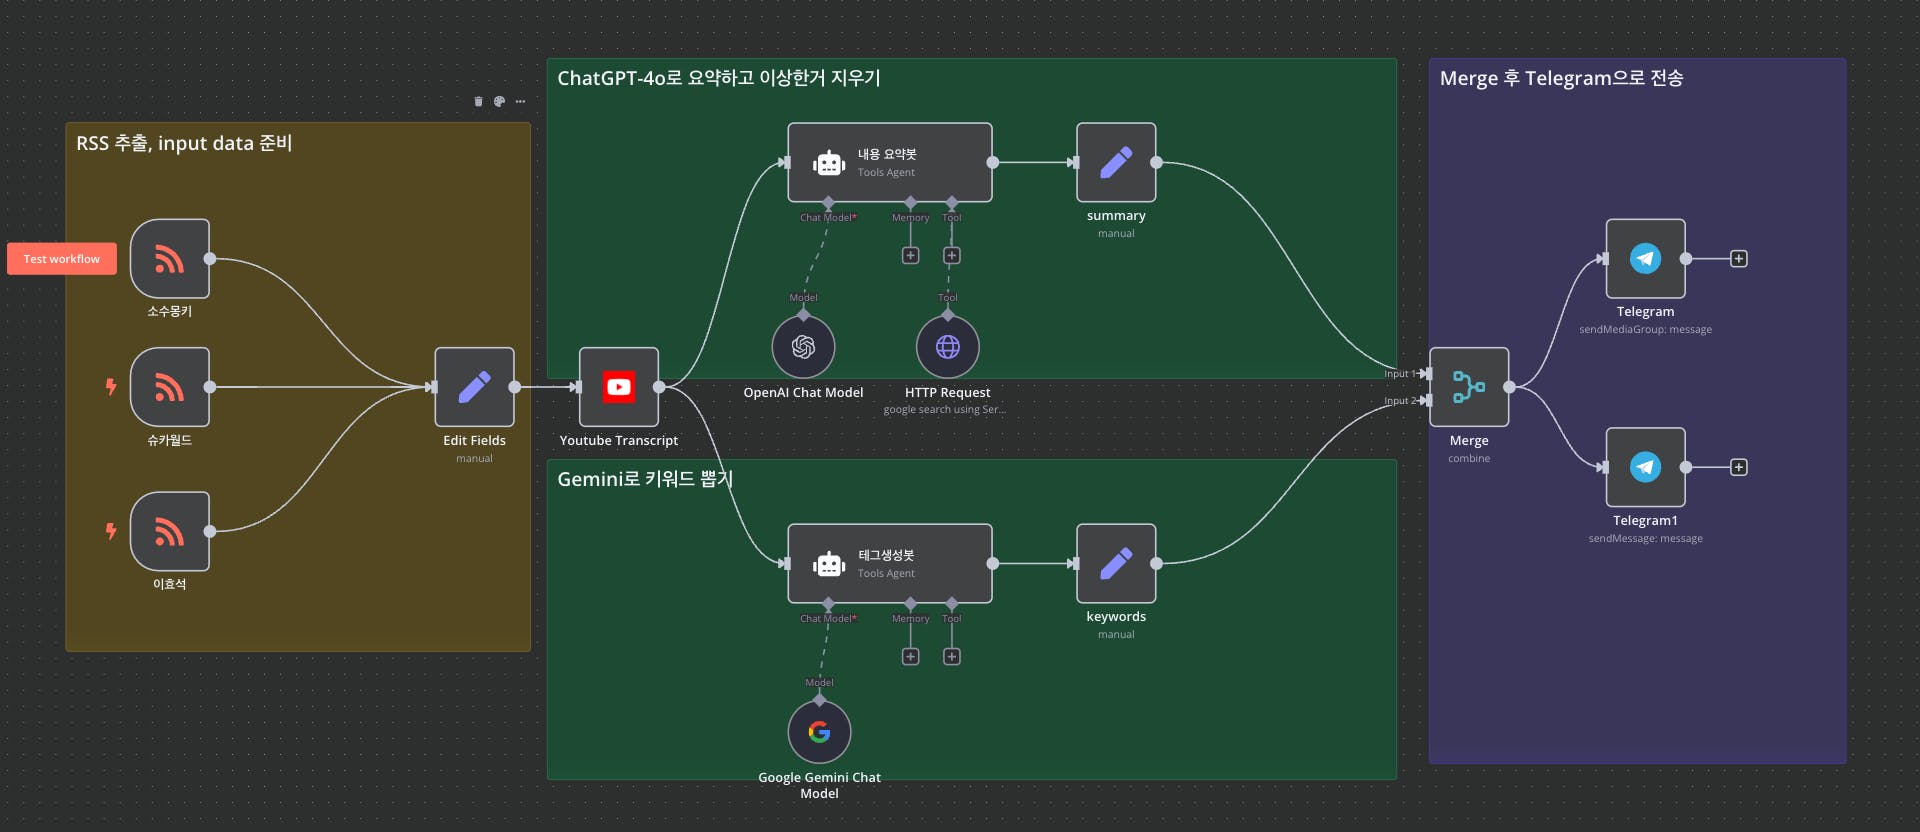
따라하는 중예요. 밑에 return array를 활성화 안 해서 삽질 몇 번 했네요. 사소하거나 무심결에 당연하다고 여기고 넘어가는 것들 땜에 간단한 예제도 스무스하게 가는 경우가 별로 없더라고요.
동적 크롤링도 다뤄주시면 좋겠어요. 지피터스 게시판에서 검색한 후 크롤링하려니 안 되더라구요. GPT나 퍼플렉시티에 동적 크롤링을 n8n에서 하는 방법을 찾아보니, Puppeteer나 Playwright를 쓰라는데, 이해가 잘 안되서요.