논문 "이론적 배경" 쓸 때마다 PDF 다시 안 열어도 되게 — 근거가 페이지 인용까지 딸려 나오는 지식베이스
2026.08.05
소개
연구주제인 예비교사 레지던시(preservice teacher residency)에 대해, 1주차에 Claude Code로 ERIC 논문 219편을 서베이하는 워크스페이스를 이미 만들었습니다. 수치·인용이 전부 원문 페이지로 되짚어지는, 검증(3중 검증) 통과한 요약 42건이 쌓여 있는 상태입니다.
그런데 논문 이론적 배경(문헌고찰)을 쓸 때마다:
"레지던시 잔류율이 비교군 따라 달라진다는 그 근거, 어느 논문 몇 쪽이었더라?" → 다시 PDF 탐험
요약은 있는데 정작 인용할 때 페이지 번호를 못 찾아 85쪽짜리 PDF를 또 열기
검증된 근거인데도 재사용이 안 되고 매번 처음부터 찾기
그래서 2주차 과제(워크스페이스에 PKM 얹기)를 계기로 목표를 다음과 같이 잡았습니다.
"논문 이론적 배경에 쓸 검증된 근거를, 페이지 인용까지 붙여서 즉시 검색·반환하게 만들자. 새 논문이 들어오면 지식도 자동으로 갱신되게."
논문 정보를 "편하게 꺼내 쓰는 것" 이 핵심입니다.
진행 방법
도구: Claude Code (터미널)
모델: Claude Opus 4.8
특이사항: 외부 서비스·계정 없이 로컬 wiki(markdown 노트 + 파이썬 표준 라이브러리)로만 구성.
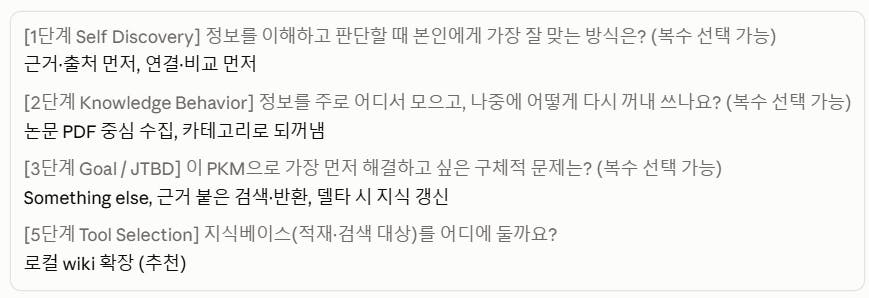
1"질문 먼저, 수행은 나중에" — 8단계로 PKM을 설계하게 시켰습니다.
무작정 만들지 말고, 제가 답해야 할 것부터 물어보게 했습니다.
그랬더니 Claude가 과제의 8단계(Self Discovery → Knowledge Behavior → Goal → Architecture → Tool → Workflow → KPI → Iteration) 중 제가 답해야 하는 개인 항목만 골라 객관식으로 물어봤습니다. 인지 스타일, 지식 흐름, 목적(JTBD)을 고르고 나니 나머지 설계는 알아서 진행됐습니다.
목적(JTBD)에서 "직접 입력"으로 제가 적은 한 줄이 시스템 전체의 방향을 정했습니다:
이론적배경에서 사용할 근거 요약을 재사용하고 싶다.2검색·반환·채점 도구를 직접 만들게 했습니다
문서엔 wiki 도구가 있다고 적혀 있었는데 실제 파일은 미설치였습니다. 그래서 문서화된 규격 그대로 자립형 파이썬 도구 4종을 만들었습니다.
wiki_query.py— 한글 bigram + 영어 단어 BM25 검색, 근거 문장 + 출처를 함께 반환 (매치 없으면 억지 답 대신 물러남)wiki_index.py— 링크 그래프 감사(고립·끊긴링크·stale·MOC 제안)wiki_grade.py— gold 문항으로 검색 품질 채점(KPI)promote_drafts.py— 검증요약 42건을 노트로 일괄 승격
실제 검색 실행
python 20-knowledge-base/wiki/wiki_query.py --workspace . "레지던시 잔류율은 비교 대상에 따라 어떻게 달라지나"반환 예시 (근거 문장 + 페이지 인용까지 자동으로)
[1] 레지던시 잔류 효과는 '무엇과 비교하느냐'에 좌우된다 (Teacher Education Quarterly, 2023)
    출처: Teacher Education Quarterly · ERIC:EJ1375612 (Burstein, Sears & Wilcoxen, 2023), p.10-14
    근거: "레지던시가 잔류를 높인다"는 무엇과 비교하느냐에 따라 성립하기도 하고 안 하기도 한다
3검색 순위 품질을 튜닝한 핵심 코드
제목에 질의어가 있으면 그 노트가 '그 주제에 관한' 것으로 보고 가산점을 주고, 우연히 단어 하나만 겹치는 노트는 걸러냅니다(아래 시행착오 참고).
# 랭킹 튜닝: 제목 aboutness 가산 + 최소 매치 토큰 하한
TITLE_BOOST = 2.5   # 질의어가 노트 '제목'에 있으면 그 idf만큼 가산
FLOOR_QLEN  = 4     # 긴 질의인데 매치 토큰 1개뿐이면 우연매치로 보고 제외

def bm25_rank(query, notes, k1=1.5, b=0.75):
    ...
    for n, d, ttoks in zip(notes, docs, title_toks):
        matched = qterms & set(tf)
        if len(matched) < floor:          # 우연 매치 차단
            continue
        s = sum(idf[t]*(tf[t]*(k1+1))/(tf[t]+k1*(1-b+b*dl/avgdl)) for t in matched)
        s += TITLE_BOOST * sum(idf[t] for t in (qterms & ttoks))   # 제목 aboutness
        scored.append((s, n))
결과와 배운 점
KPI (실제 채점 결과) — KB를 3단계로 키우며 매번 회귀 확인:
단계 | 노트 풀 | gold | Top-1 정확도 | Recall@3 | 근거 무결성 |
|---|---|---|---|---|---|
① 최초 | 6 | 5문항 | 80% | 100% | 100% |
② 랭킹 개선 + 충돌 검증 | 9 | 8문항 | 100% | 100% | 100% |
③ 본격 확장 | 51 (근거 45) | 15문항 | 100% (15/15) | 100% | 100% |
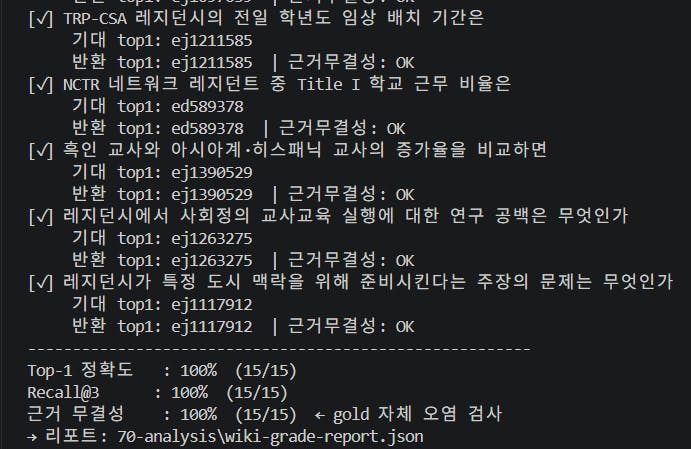
카테고리당 비슷한 논문이 10~12편씩 쌓였는데도 정확도 100%가 유지됐어요. 고립 노트 0·끊긴 링크 0.
과정 중 시행착오
시행착오 1 — 개념 노트가 검색 2위로 밀림
"레지던시 잔류율은 비교 대상에 따라…"로 검색했더니, 정작 그 개념을 담은 노트가 2위였어요. 본문에 "잔류율"·"비교집단"이라는 표면 단어를 우연히 더 가진 다른 노트가 1위를 차지한 거죠. → 제목 aboutness 가산을 넣어 "그 질문에 관한" 노트가 이기게 고쳤습니다.
시행착오 2 — 엉뚱한 단어 하나로 우연 매치
테스트로 "블록체인 암호화폐 투자"를 검색했더니, 어떤 노트에 있던 "투자"라는 단어 하나 때문에 무관한 노트가 딸려 나왔어요. → 매치 토큰 하한을 걸어 이제 0건 반환(억지 답 대신 물러남).
시행착오 3 — "6개 노트에만 잘 맞는 거 아냐?" (과적합 의심)
노트 6개에서만 튜닝하면 과적합이라, 제가 갖고 있던 옵시디언 볼트의 원본 논문 3편을 일부러 '같은 카테고리 함정'으로 넣어봤어요. 그런데도 100%가 유지되는 걸 확인하고 나서야 확장했습니다.
배운 점 & 나만의 꿀팁
"수행 전에 나한테 먼저 질문해"가 최고의 프롬프트. 무작정 만들게 두지 말고 8단계로 나를 인터뷰하게 하니 결과물이 내 목적에 딱 맞았어요.
품질을 숫자로 재게 만들어라. gold 문항 + 채점기(
wiki_grade.py)를 만드니, 고칠 때마다 "좋아졌는지/나빠졌는지"가 바로 숫자로 나와서 감이 아니라 근거로 개선했어요.일부러 함정(distractor)을 넣어 검증. 잘 되는 것만 테스트하면 과적합을 못 봅니다.
AI가 "모르면 물러나게" 설계. 매치 없으면 억지 답 대신 0건 반환 — 환각을 구조로 막았어요.
도움이 필요한 부분
옵시디언 볼트에 미검증 원본 논문이 20편+ 더 있는데, ERIC 코퍼스와 중복 제거하면서 검증 등급을 붙여 넣는 깔끔한 방법을 고민 중이에요.
노트가 수백 개로 커지면 지금의 단어 기반 검색만으론 부족할 텐데, 임베딩(의미 검색)을 보조 신호로만 얹고 근거 대조는 글자 그대로 유지하는 균형점을 어떻게 잡을지 조언 받고 싶어요.
앞으로의 계획
ERIC에 새 논문이 뜨면(델타) 관련 노트를 자동 갱신(Compiled Truth는 REWRITE, 이력은 append)하는 배선 완성
임베딩 유니온 검색을 옵션으로 추가
이 PKM 구조를 레지던시 말고 다른 연구 주제에도 재사용할 수 있게 템플릿화
재사용 가능한 프롬프트
프롬프트 1 — 무작정 만들지 말고 나부터 인터뷰하게 하기
[과제/문서]를 수행하기 전에, 내가 답해야 하는 질문들만 골라 하나씩 물어봐줘.
다 답하면 그 답과 [내 워크스페이스] 실측을 바탕으로 나머지는 네가 설계·수행해줘.
프롬프트 2 — 검색 품질을 숫자로 재는 채점기 만들기
gold 질문셋(질문 + 기대 1위 문서 + 기대 근거 문구)을 만들어서,
검색 결과를 Top-1 정확도 / Recall@k / 근거 무결성으로 채점하는 스크립트를 만들어줘.
근거 문구는 반드시 원문에 글자 그대로 있어야 통과(fail-closed).
프롬프트 3 — 과적합 방지, 함정을 넣어 검증
지금 잘 되는 건 데이터가 적어서일 수 있어. 같은 카테고리의 헷갈리는 사례를 몇 개
일부러 추가해서, 그래도 정답을 1위로 골라내는지 다시 채점해줘.
도움 받은 글 (옵션)
스터디장님의 강의와 유인물

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


wiki_query.py에TITLE_BOOST = 2.5로 "그 질문에 관한" 노트가 우연 매치 노트를 이기게 하고,FLOOR_QLEN = 4로 매치 토큰 하한을 걸어 억지 답 대신 0건 반환하게 설계한 부분이 인상 깊었어요. 환각을 프롬프트가 아니라 코드 구조로 막은 거잖아요. 노트 51개로 확장한 뒤에도 Top-1 정확도 15/15를 유지한 것도 인상 깊었고요. "일부러 함정(distractor)을 넣어 과적합을 검증한다"는 접근도 배워갑니다 — 잘 되는 것만 테스트하면 과적합을 못 본다는 말이 맞아요. 꼬리 탁! 치고 응원하고 갈게요 🐈⬛