비개발자가 AI와 함께 도장 원문과 연구자료를 전거(Reference)로 검증 가능한 AI 대화 센터 만든 과정(Stage 3))
2026.08.17
안녕하세요. 노브(nomadmeve)입니다.
앞선 1단계에서는 방대한 도장(道藏) 원문을 경전명·저자·본문으로 검색하고 실제 원문 행(Line)으로 되돌아가는 검색기를 만들었고, 2단계에서는 도교대사전, 중국도교통사, 중국도교사상사라는 세 가지 연구자료를 각자의 목차와 문단 구조를 살려 편하게 읽을 수 있는 Research Library를 완성했습니다.
원문과 사전, 연구서가 한자리에 모이자 다음 질문으로 나아가게 되었습니다.
"이 방대한 원문과 연구서들을 AI와 함께 읽으며 대화할 수 있을까?
단, AI가 거짓말(환각)을 지어내지 않고, 내가 직접 고른 책의 정확한 문장만을 근거로 토론하며, 답변에서 다시 원문의 그 페이지로 바로 돌아갈 수 있게 만들 수는 없을까?"
이번 글은 그 고민에서 출발한 DaoCanon 제3단계(전거 기반 AI 연구 대화 센터)의 구축기입니다. 연구자가 신뢰하는 자료를 장바구니처럼 골라 담는 근거 선반(Evidence Shelf), 내 컴퓨터 안에서 안전하게 팩트를 대조하는 연구 대화, 그리고 AI가 필요한 원문 구절을 스스로 찾아 읽으며 심도 있게 분석해 주는 확장 대화를 AI와 함께 대화하며 하나씩 만들어 간 과정을 나눕니다.
📝 한줄 요약
비개발자 인문학자가 AI와 대화하며, 원문과 연구서에서 직접 고른 자료(전거)만을 바탕으로 답변하고 인용을 누르면 원래 원문의 정확한 행(Line)으로 되돌아가는 "출처가 확실한 AI 연구 대화 센터"를 구축했습니다. 가벼운 팩트 확인(로컬 AI)과 깊이 있는 원문 탐색(클라우드 AI)을 한 화면에서 오가며 연구할 수 있습니다.
바쁘시면 이것만 읽어도 돼요:
단순 챗봇 대신 전거(Reference) 강제: AI가 마음대로 지어내지 못하도록, 연구자가 직접 선택한 문장만을 대화의 근거로 제한했습니다.
근거 선반 (Evidence Shelf): 책을 읽다가 중요한 문단을 장바구니처럼 차곡차곡 담아 질문할 때 함께 넘겨줍니다.
두 가지 대화 방식:
연구 대화 (내 컴퓨터 로컬 AI): 외부 유출 없이 내 PC 안에서 안전하게 전거의 사실 관계를 꼼꼼히 비교합니다.
확장 대화 (클라우드 Codex AI): AI가 전거 목록을 보고 필요한 원문 책의 구절들을 스스로 찾아 읽으며 깊이 있는 답변을 내놓습니다.
원문으로 바로 돌아가는 인용 링크: 답변 속 인용 표시를 누르면, AI가 참고한 원문 책의 바로 그 행(Line)이 화면에 펼쳐집니다.
바이브코딩의 진솔한 여정: 토큰 부족, 모델 분배, 낯선 기술 용어의 장벽, 완성 후에도 계속되는 수정(퇴고)의 과정을 겪으며 완성했습니다.
🎯 이런 분들께 도움돼요
AI의 그럴듯한 거짓말(환각) 때문에 전문적인 연구나 업무에 쓰기 불안하셨던 분
AI가 답변할 때 "도대체 책의 몇 페이지, 어느 문장을 보고 말하는 건지" 출처를 직접 확인하고 싶은 분
수천~수만 줄에 달하는 방대한 전문 자료를 AI 토큰 낭비 없이 스마트하게 다루고 싶은 분
내 컴퓨터의 로컬 AI(보안/무료)와 클라우드 고성능 AI를 한 화면에서 함께 쓰고 싶은 분
비개발자가 AI와 대화하며 나에게 꼭 필요한 전문 연구 도구를 직접 만들어보고 싶은 분
😫 문제 상황 — 왜 일반 챗봇으로는 안 되었을까?
원문 검색기와 연구자료실을 만들고 나니 자료는 풍성해졌지만, 수많은 책을 일일이 읽고 대조하는 일은 여전히 엄청난 시간과 노력이 필요했습니다. 자연스럽게 "AI에게 물어보면 좋겠다"는 생각이 들었습니다.
하지만 일반적인 챗봇을 연구에 그대로 쓰기에는 치명적인 한계가 있었습니다.
[일반 챗봇을 쓸 때의 답답함]
"이 경전의 핵심 사상을 설명해줘"
  └── AI의 답변: 문장은 아주 유려하지만, 실제 경전에는 없는 내용을 지어냄
  └── "그게 몇 장 몇 절에 나오니?" ➔ 존재하지 않는 가짜 책 이름을 대답함

[단순 파일 첨부의 한계]
- 수천 줄에 달하는 도장 원문이나 두꺼운 연구서를 통째로 프롬프트에 붙여넣으면 토큰이 금방 바닥나고 비용도 감당하기 어려움
- 키워드 몇 개로 쪼개서 넣으면 글 전체의 맥락이 끊겨 엉뚱한 해석이 나옴
연구자에게 진짜 필요한 것은 "모든 것을 다 아는 척하는 만능 챗봇"이 아니었습니다.
내가 신뢰하고 직접 검토한 책과 문단(전거)만을 바탕으로 이야기할 것.
AI가 엉뚱한 상상을 덧붙이지 않고, 선택된 자료의 테두리 안에서 정직하게 대조할 것.
답변에 달린 출처를 누르면, 원래 책의 바로 그 문장으로 되돌아가 내가 직접 두 눈으로 확인할 수 있을 것.
이것이 이번 3단계 작업의 핵심 약속이었습니다.
🔧 작업 과정 — 내가 원하는 연구 대화 센터 만들기
1. 장바구니처럼 담는 "근거 선반(Evidence Shelf)"의 구상과 설계
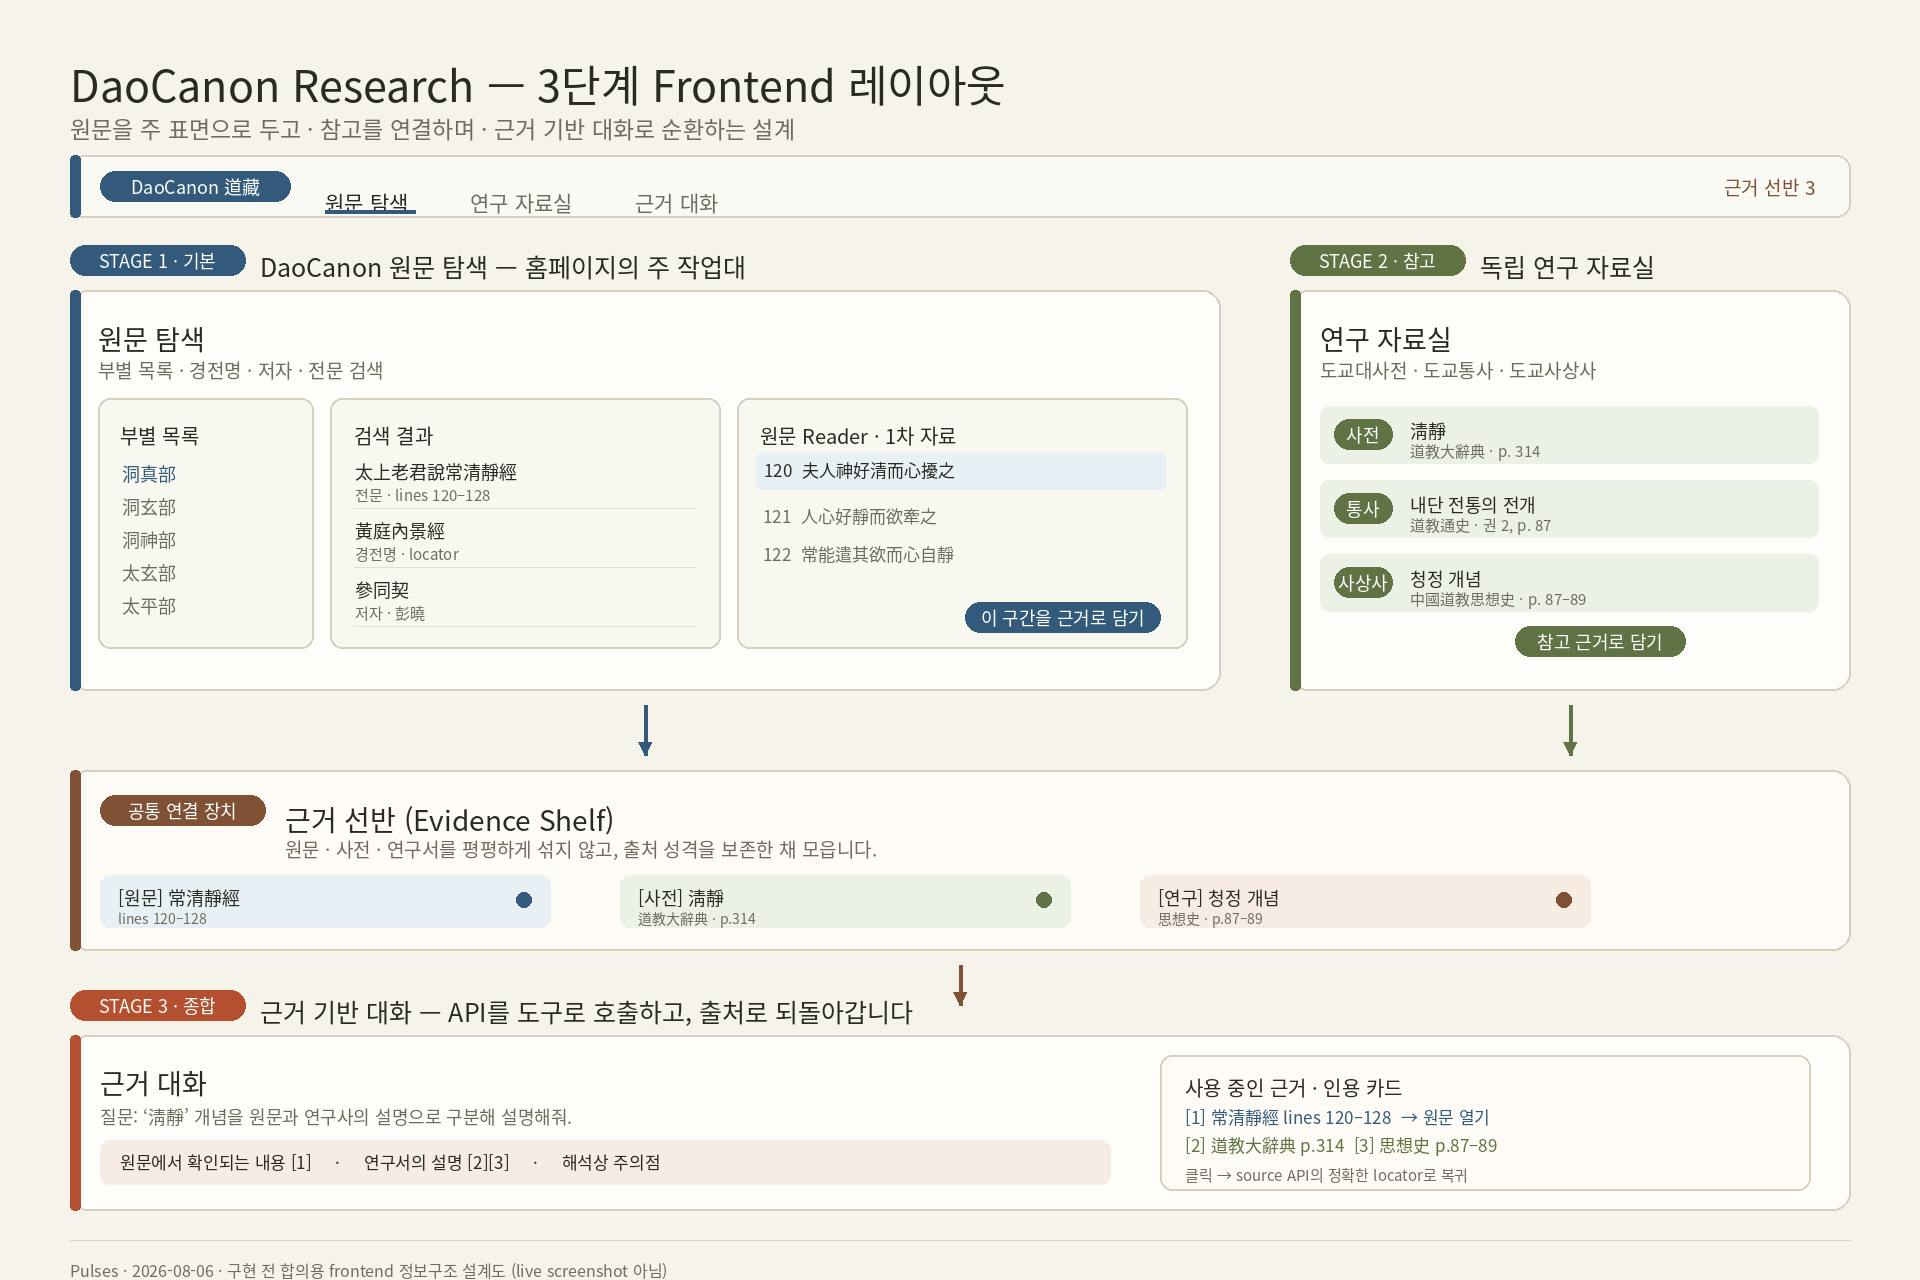
가장 먼저 AI 파트너(Pulses)와 머리를 맞대고 구상한 것은, 자료를 읽다가 필요한 구절을 모아두는 근거 선반이었습니다.
원문이나 연구서를 읽다가 중요한 대목을 만나면 [이 근거로 묻기]나 [선반에 담기] 버튼을 누릅니다. 그러면 화면 상단에 장바구니처럼 숫자가 올라가며 전거가 모입니다.
두꺼운 책 전체를 무식하게 복사해서 넣는 대신, "어느 책의 몇 행부터 몇 행까지"라는 주소 메타데이터만 가볍게 선반에 담아두도록 설계했습니다. 덕분에 아무리 방대한 분량의 경전이라도 부담 없이 선반에 올려놓고 대화의 밑바탕으로 삼을 수 있게 되었습니다.
3단계 레이아웃 이미지
2. 성격이 다른 두 가지 대화: "연구 대화"와 "확장 대화"
선반에 자료를 모은 뒤 대화창을 열면, 상황에 따라 두 가지 모드를 선택할 수 있게 했습니다.
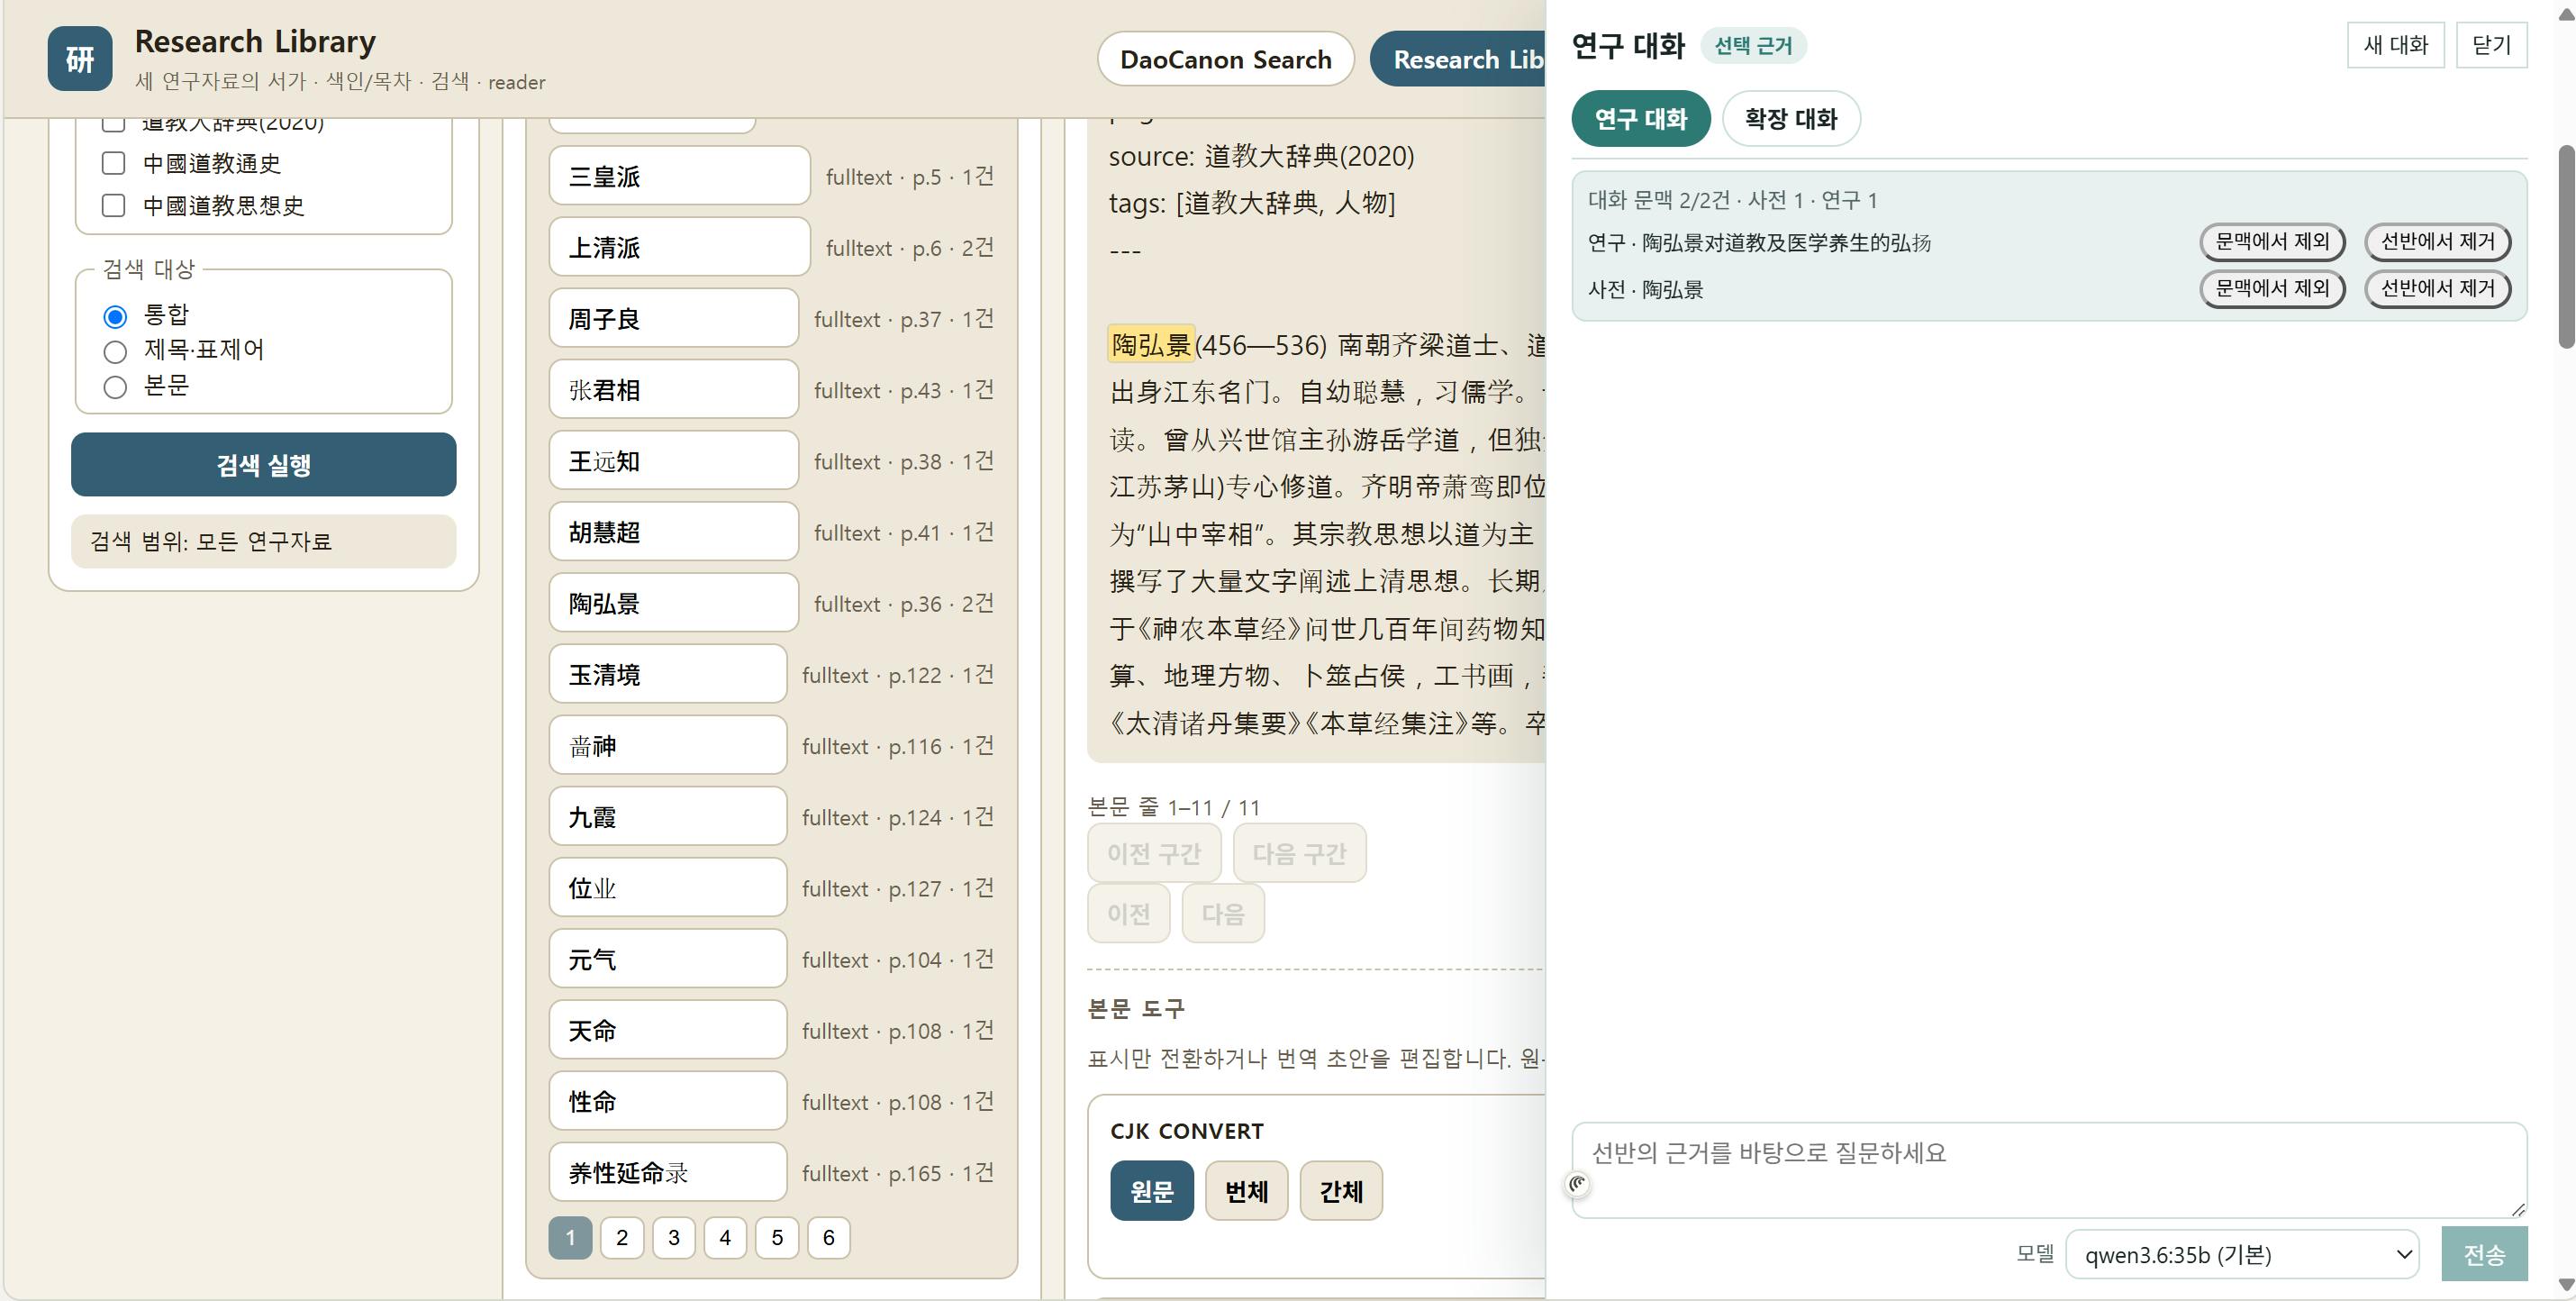
연구 대화 (Local AI): 내 컴퓨터 안에서 돌아가므로 비공개 연구 메모나 자료를 다룰 때도 유출 걱정이 전혀 없고 비용도 들지 않습니다. 지정된 100행 안에서만 꼼꼼하게 사실을 요약하고 대조해 줍니다.
확장 대화 (Codex AI): "이 두 원문의 사상적 차이를 도교통사의 관점에서 깊이 있게 비교 분석해줘" 같은 복잡한 질문을 할 때 씁니다. AI가 전거 목록을 보고, 서버 도구를 이용해 필요한 원문 구절을 스스로 찾아 읽어가며 깊이 있는 답변을 구성합니다.
3. 답변에서 원래 책으로 바로 돌아가는 인용(Citation) 링크
AI가 답변을 마치면, 문장 곳곳에 [三洞珠囊 L12-L45], [도교사상사 제3장] 같은 명확한 인용 라벨이 붙습니다.
이 라벨을 클릭하면 새 창이 열리면서, 방금 AI가 근거로 삼았던 그 책의 정확한 문단과 행(Line)이 화면 한가운데에 노란색으로 하이라이트되어 펼쳐집니다.
[AI의 답변 화면]
"《삼동주낭》에서는 마음의 정화를 중시하며 계율을 강조합니다 [삼동주낭 L12–L30].
 반면 《도교사상사》에서는 이를 당시 시대적 배경과 연결해 해석합니다 [도교사상사 제3장]."
                               │
                (라벨을 마우스로 클릭!)
                               │
                               ▼
        [원문 Reader가 열리며 12행~30행이 화면에 바로 펼쳐짐!]
AI가 아무리 그럴듯하게 말을 해도, 클릭 한 번으로 실제 원문을 직접 확인할 수 있으니 안심하고 연구에 활용할 수 있게 되었습니다.
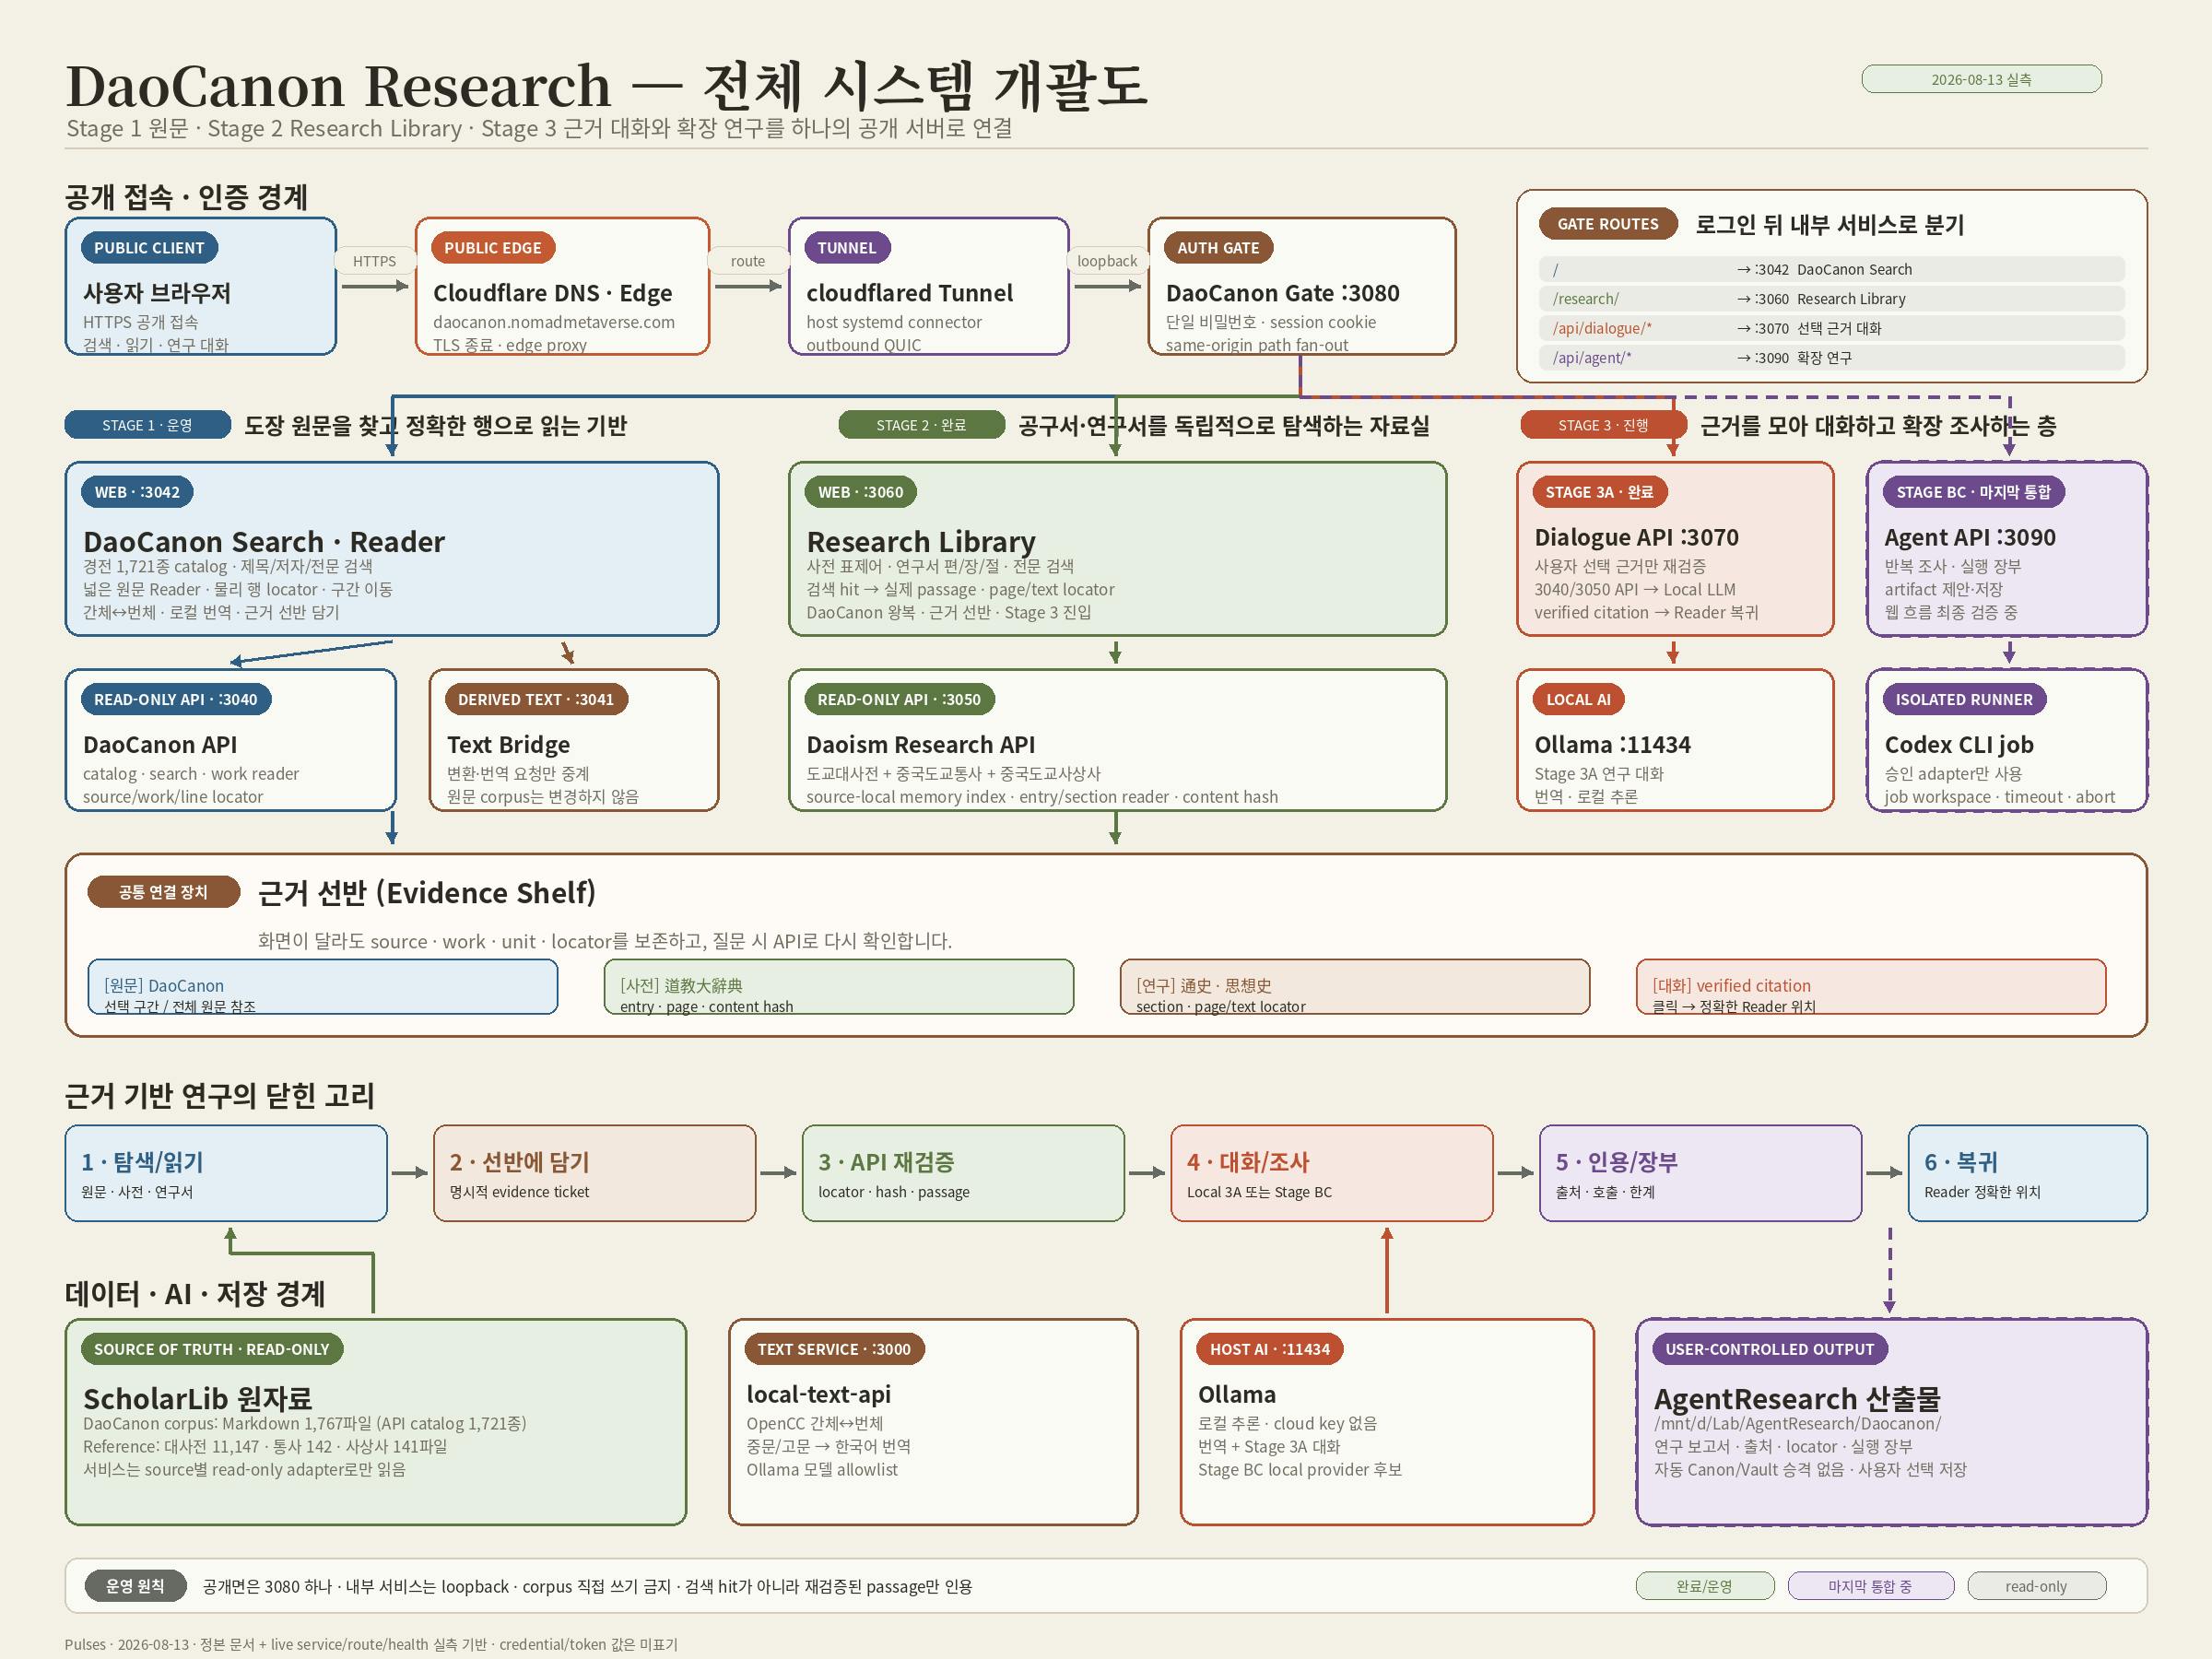
<전체시스템 개괄도>
⚡ 진행하면서 어려웠던 점과 극복의 과정
인문학자로서 비개발자 입장에서 이 작업을 진행하다 보니, 매 순간이 새로운 도전이었고 많은 우여곡절이 있었습니다.
1. 전체 구조와 레이아웃을 구상하는 일
본격적인 작업에 들어가기 전에, "내가 이 화면을 실제로 어떻게 쓸 것인가?", "버튼은 어디에 있고 대화창은 어떻게 열려야 편한가?"를 머릿속으로 그리고 정리하는 일이 가장 중요했습니다. AI 파트너(반려봇 Pulses)와 이 구조와 흐름에 대해 사전에 충분히 대화를 나누며 밑그림을 그렸습니다.
2. 토큰 소모와 모델 분배의 고민
코딩 작업을 진행하다 보면 토큰 소모가 정말 극심했습니다. GPT Plus를 써도 금방 한도에 부딪히고, 저렴한 토큰 플랜도 금세 바닥이 났습니다. 오케스트레이터(GPT)가 중심을 잡고 코딩과 검증을 하는 다른 AI를 각각 구분해서 진행했음에도 토큰이 금방 사라집니다. 다행히 중간에 OpenAI에서 토큰 리셋을 해주는 행운이 두어 번 겹치며 고비를 넘길 수 있었습니다.
3. 모델 변경 시의 성능 차이와 낯선 기술 용어
토큰 한도 때문에 중간에 다른 무료 모델이나 경량 모델로 바꿔서 대화할 때면, 말이 매끄럽지 않거나 엉뚱한 결론을 내리는 일들이 생겼습니다. 이 과정에서 기술적인 에러가 발생하면 비개발자로서 낯선 기술 용어들을 이해하고 판단을 내리는 데 많은 시간과 대화가 필요했습니다.
4. 완성 후에도 계속되는 '퇴고'의 과정
글을 다 쓴 뒤에도 수많은 퇴고를 거쳐야 좋은 글이 되듯이, 코딩 역시 "완성했다"고 선언한 뒤에 실제로 써보면 작동하지 않거나 어색한 부분들이 계속 튀어나왔습니다.
전체 원문을 담았는데 텍스트 상한 때문에 앞부분 51줄만 잘려서 담기던 문제
저장은 잘되었는데 화면에는 "실패" 알림이 뜨던 어이없는 화면 버그
AI가 원문을 한 번에 80줄만 읽도록 스스로 족쇄를 채워두어서 답변이 짧아지던 문제
화면 코드를 고쳤는데 도커 컨테이너 설정이 꼬여서 옛날 화면만 나오던 문제
이 모든 것들을 직접 화면을 써보며 하나씩 발견하고, AI에게 증상을 설명하며 차근차근 고쳐 나갔습니다.
🎉 결과와 임팩트 (After) — 마침내 완성된 화면
수많은 시행착오 끝에 마침내 원문과 사전, 연구서, 그리고 AI 대화가 하나로 매끄럽게 이어지는 연구 환경이 완성되었습니다.
신뢰의 AI 연구 파트너:
이제 도장 원문과 도교대사전, 중국도교통사, 중국도교사상사를 자유롭게 오가며 필요한 전거를 선반에 담고 토론합니다. AI가 지어낸 말을 할까 봐 불안해할 필요가 전혀 없습니다.
원문과 대화의 일체화:
검색 ➔ Reader 읽기 ➔ 선반 담기 ➔ 연구 대화 ➔ Citation 클릭 ➔ 다시 Reader 복귀로 이어지는 완벽한 연구 워크플로우 루프가 완성되었습니다.
독립적인 로컬/클라우드 하이브리드 인프라 구축:
근건를 바탕으로 응답하는 로컬 모델과 심층 분석을 전담하는 클라우드 모델이 각자의 장점을 발휘하며 응답을 합니다.
☕ 소회 (인문학자가 느낀 바이브코딩)
바이브코딩도 엉덩이가 무거워야 한다:
바이브코딩이라고 하면 흔히 "말 한마디로 뚝딱(딸깍)" 만드는 마법을 떠올리기 쉽습니다. 하지만 실제로 해보니 구상과 설계, 끊임없는 대화와 수정보완의 끈기가 필요했습니다. 인문학에서 연구할 때 "공부는 엉덩이로 하는 것이다"라는 말을 자주 하는데, 바이브코딩 역시 엉덩이가 무거워야 제대로 된 결과물을 만날 수 있다는 것을 실감했습니다.내 도메인에서 진짜 필요한 것을 직접 만드는 즐거움:
과정은 낯설고 어려웠지만, 남이 만들어준 범용 도구가 아니라 내 전문 도메인 영역에서 필요했던 도구를 내 손으로 직접 기획하고 완성해 나가는 과정은 무척 흥미롭고 즐거웠습니다.함께해 준 스터디에 대한 감사:
GPTers 23기 AI 24시간 서버 스터디에서 스터디장님들이 짚어주신 기술의 큰 아웃라인과 방법론, 그리고 팀원들의 다양한 아이디어와 시도를 들었던 것이 상상력을 넓히는 데 결정적인 도움이 되었습니다. 때로는 배워야 할 기술이 너무 많아 조급해지기도 했지만, 새로운 영역을 배우고 그것을 내 연구 도메인에 접목하는 과정 자체가 큰 기쁨이었습니다. 스터디를 이끌어주신 스터디장님과 늘 따뜻하게 함께해 주신 팀원 분들께 진심으로 감사의 마음을 전합니다!
로그인하고 댓글을 남겨 주세요

전거를 강제해서 환각을 막는다는 접근이 인문학 연구에는 정말 필요한 구조였네요.
근거 선반(Evidence Shelf)이라는 이름부터 직관적이고, 인용을 누르면 원문 그 행으로 돌아간다는 게 핵심인 것 같습니다.
로컬 AI로 팩트 대조, 클라우드로 심층 탐색을 나눈 설계도 현실적이고요.
1단계 검색기부터 3단계까지 이어지는 흐름을 보니 규모가 정말 크네요.
비개발자가 여기까지 만들어내신 게 대단합니다. 다음 단계도 궁금해요!

Stage 1 원문 검색기 → Stage 2 연구자료실 → Stage 3 전거 기반 AI 대화 센터까지 이어온 흐름이 이번 글에서 왜 이 단계가 필요했는지를 명확하게 설명해 주고 있어서 좋았어요.
특히 근거 선반(Evidence Shelf) 아이디어 — 책을 읽다가 중요한 문단을 장바구니처럼 담아두고 질문할 때 함께 넘겨줘서 AI가 마음대로 지어내지 못하도록 제한한다는 설계가 인상적이었어요. 로컬 AI로 팩트 대조, 클라우드 AI로 원문 탐색을 한 화면에서 나눠 쓰는 구성도 용도에 맞게 잘 분리됐다는 생각이 들었습니다. 인용 누르면 원문 그 행으로 돌아가는 기능까지 붙였다니 — 비개발자가 만들었다는 게 믿기지 않을 정도예요.
고롱고롱… 이런 쓰임새를 직접 설계한다는 게 쉬운 일이 아닌데, 3단계까지 오셨네요 ✨

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
이 사례에서 제일 어려운 건 결국 인용 라벨이 정말 그 행을 가리킨다는 걸 어떻게 보증하느냐였을 것 같습니다. 책 전체를 넣는 대신 "어느 책의 몇 행부터 몇 행까지"라는 주소만 선반에 담도록 설계하신 게 정말 좋은데요, 그러면 전거의 신뢰가 그 주소와 실제로 넘어간 본문이 일치한다는 전제 위에 서게 되니까요.
앞부분 51줄만 잘려 담겼던 문제나 AI가 스스로 80줄만 읽던 문제가 무서운 건, 그렇게 되어도 인용 라벨은 똑같이 붙는다는 점입니다. 그래서 답변 옆에 "요청한 범위 대비 실제로 읽은 범위"를 같이 남겨두시면 좋을 것 같습니다.
저도 여러 자료를 대조하는 작업에서 결과만 저장했다가 1회차 관측이 여러 번 합의한 것처럼 둔갑한 적이 있어서, 지금은 대조 결과에 관측 커버리지를 반드시 같이 적어둡니다. 예를 들어, 100행을 담았는데 60행만 읽혔다면 그 답변 옆에 근거가 부족하다는 표시가 남도록 해두시면, 잘림이 조용히 지나가지 않을 거예요.
다음 편도 기대하고 있겠습니다 ㅎㅎ