나만 이거 안됐나? 3편 — GPT 없이 내 생활 데이터로 굴러가는 AI 비서 완성
2026.05.29
📝 한줄 요약
AI가 매일 아침 날씨·가계부·건강 데이터를 직접 읽어서 대화로 답해주는 완전 로컬 개인비서를 만들었다. 클라우드 없이, GPT 없이.
바쁘시면 이것만 읽어도 돼요:
크론이 매일 날씨·가계부·건강 데이터를 파일로 저장 → AI가 그 파일을 읽어서 대답하는 구조
고난이도 추론은 못 해도, 내 데이터 안에서 묻는 건 정확히 답함(RAG)
gemma가 실시간 DB 조회를 못 한다는 걸 알고 나서 오히려 단순한 구조가 더 잘 돌아갔음
미세먼지 답변 한 줄이 나왔을 때 — 그게 수십 시간 세팅의 보상이었음
세팅이 맞으면 작은 모델도 충분히 쓸 만하다
🎯 이런 분들께 도움돼요
"AI가 내 일상 데이터를 알고 대화했으면 좋겠다"는 분
GPT·클로드 구독 없이 로컬 AI를 진짜로 써보고 싶은 분
크론·브리핑·알림까지 다 만들어놨는데 AI가 그 내용을 모르는 상황에 처한 분
😫 문제 상황 (Before)
1편에서 해를매쓰(AI 비서)를 Discord에 붙였고, 2편에서 GPT를 완전히 걷어냈다. 여기까지는 잘 됐다.
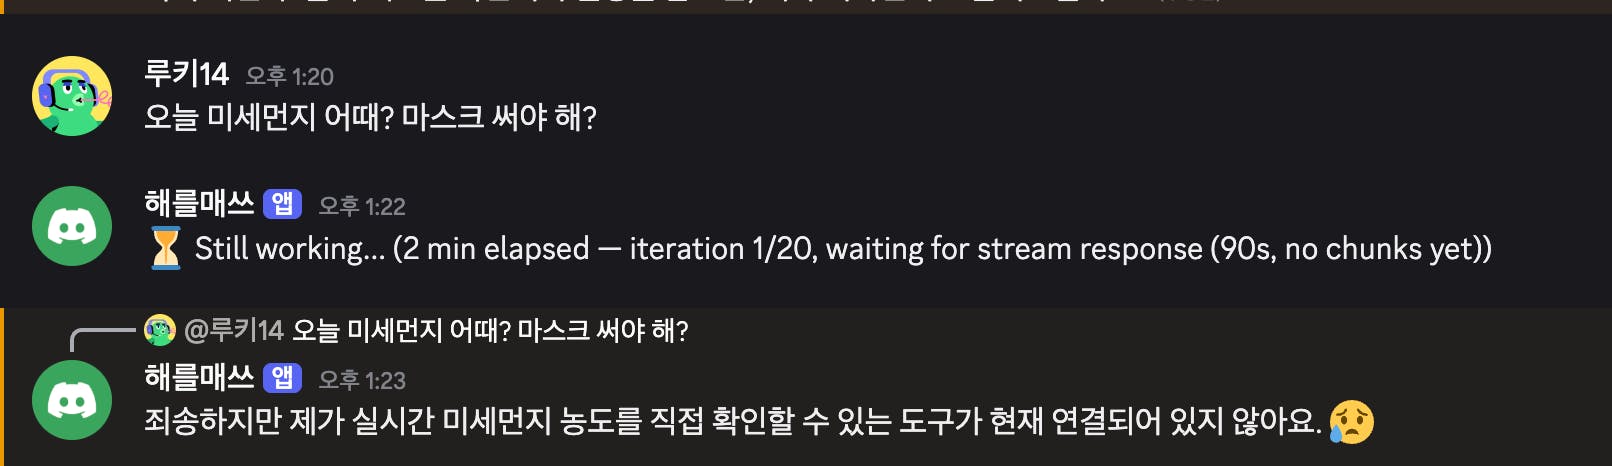
그런데 이상한 게 있었다. 매일 아침 크론이 날씨·가계부를 Discord에 브리핑으로 쏴주는데, 해를매쓰한테 "오늘 미세먼지 어때?"라고 물으면 전혀 엉뚱한 답이 나왔다.
오늘 미세먼지 어때?"죄송합니다, 현재 미세먼지 정보를 확인하기 어렵습니다."
방금 브리핑에서 다 보내줬는데. AI는 그걸 못 읽고 있었다.
원인을 파보니 구조적인 문제였다. 크론이 Discord에 메시지를 보낼 때는 봇(webhook) 이름으로 발송되는데, AI는 사람이 보낸 메시지만 대화 기록으로 읽는다. 같은 채널 안에 있어도 봇이 보낸 메시지는 AI 눈에 보이지 않는 것이다.
즉, 크론 데이터와 AI 대화는 구조적으로 완전히 분리돼 있었다.
🛠️ 사용한 도구
도구: Claude Code
모델: claude-sonnet-4-6
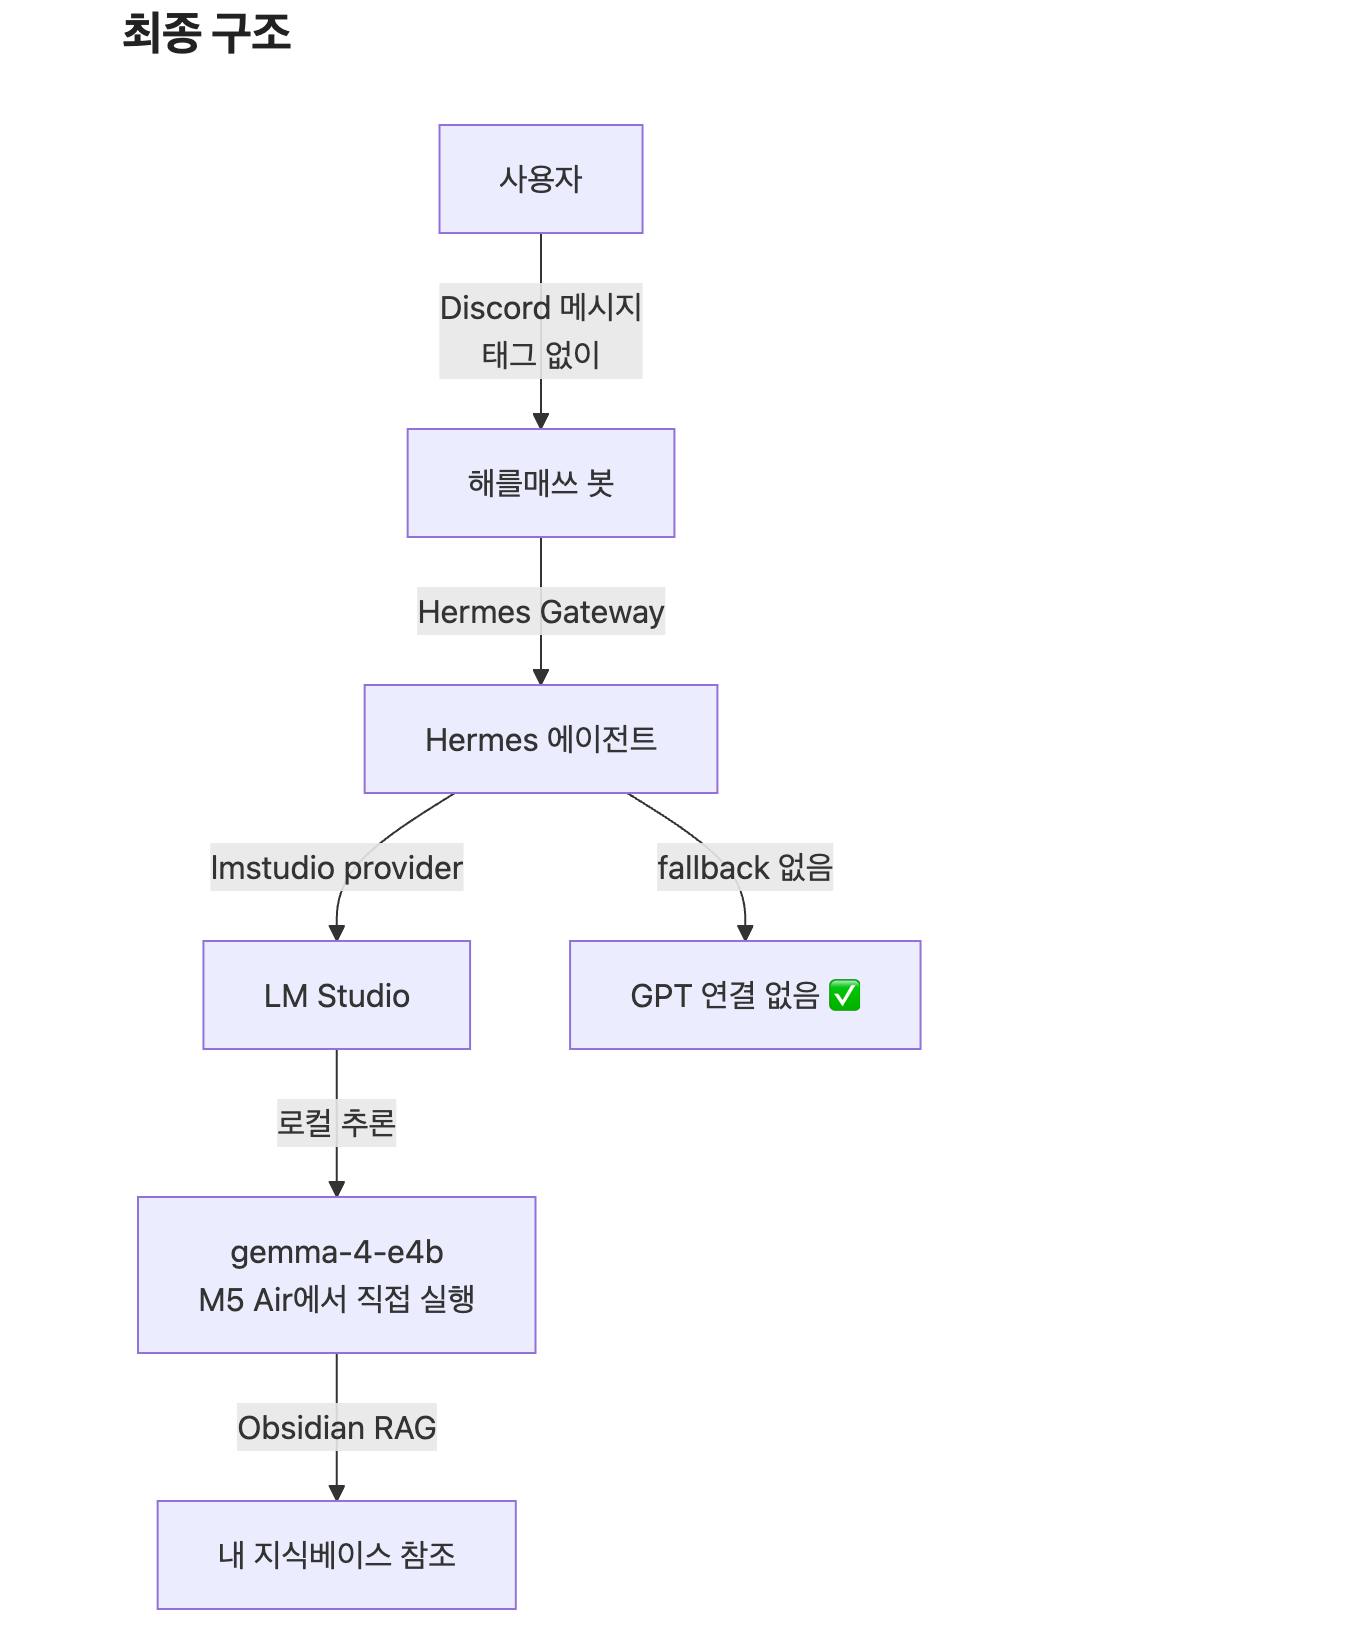
로컬 AI: Hermes + gemma-4-e4b (LM Studio, 4B 파라미터)
데이터 소스: Open-Meteo(날씨), Supabase(가계부·건강), Google Calendar
🔧 작업 과정
크론 데이터가 AI한테 안 보인다는 걸 알았을 때
처음엔 단순하게 생각했다. 크론이 Discord에 메시지를 보내니까 AI도 읽겠지. 그런데 아니었다.
크론 브리핑에서 불러온 데이터를 가지고 대화를 이어갈 수는 없는건가??
날씨가 가계부 모든 곳이 거기서 불러오는 크론의 데이터를 해를매쓰가 인지하지 못해서 따로 놀고 있네
Claude Code가 코드를 뜯어보고 원인을 설명해줬다. 크론이 Discord에 메시지를 보낼 때는 사람이 아니라 봇(webhook)으로 발송되고, AI는 사람이 보낸 메시지만 대화 기록으로 인식한다. 구조 자체가 분리돼 있는 것이었다.
해결 방향을 같이 고민했다.
rag로 할 수 있는건 옵시디언 뿐인가?
크론에 대한 부분들이 옵시디언으로 다 쌓이면 좋을 것 같고
결론은 단순했다. 크론 데이터를 파일로 저장하고, AI가 그 파일을 읽게 하자.
핵심 아이디어 — 오늘의컨텍스트.md
AI가 매일 읽을 "브리핑 파일" 하나를 만들기로 했다. 매일 새벽 6시 30분에 크론이 실행되면서:
Open-Meteo API로 날씨(현재 기온, 체감온도, 미세먼지, UV, 강수확률)
Google Calendar로 오늘/내일/이번 주 일정
Supabase에서 이달 가계부 현황, 오늘 지출, 최근 3일 내역
자산 현황, 정기구독 목록
건강 데이터 (체중, 수면, 수분, 운동, 오늘 식사 기록)
…이 모든 걸 마크다운 파일 하나(오늘의컨텍스트.md)에 담아서 Obsidian에 저장한다.
그리고 해를매쓰의 system_prompt(AI 사전 지시)에 이 파일 전체를 매일 자동으로 주입한다.
세개 다 만들어주고 크론에서 가져오는 데이터들을 가지고 대화를 계속 이어갈 수 있게끔
기초 세팅을 잘 해주면 좋겠어
Claude Code가 today-context-update.py 스크립트와 Obsidian 저장 구조, 크론 잡을 한 번에 짜줬다.
gemma가 실시간 조회를 못 한다는 걸 알고 방향을 틀었을 때
처음엔 더 똑똑하게 만들고 싶었다. AI가 직접 가계부 DB를 실시간으로 조회하면 더 좋지 않을까? 그런데 gemma-4-e4b는 도구 호출(tool call)을 안정적으로 하지 못했다. 지시를 줘도 제대로 실행을 못 하거나 엉뚱하게 해석했다.
일단은 스냅샷 RAG 형태로 가야할 것 같아
gemma가 아직 그정도 수준이 안되는 것 같아
이 작업도 지금 욕심을 가지고 하는 수준일 수 있어
실시간 쿼리 대신, 매일 아침 한 번 데이터를 긁어서 파일로 저장하고 AI가 그걸 읽는 방식으로 확정했다. 더 단순하지만 오히려 더 안정적이었다.
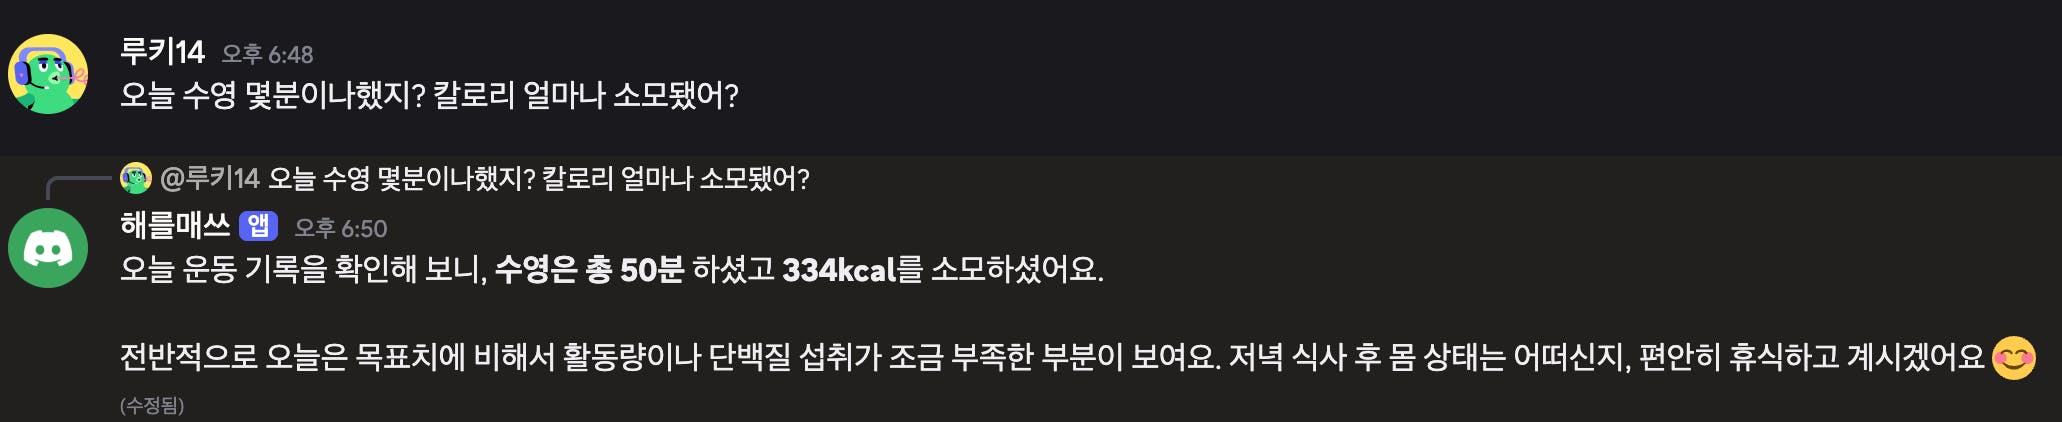
미세먼지 답변이 처음 나왔을 때
세팅을 마치고 처음으로 질문을 던졌다.
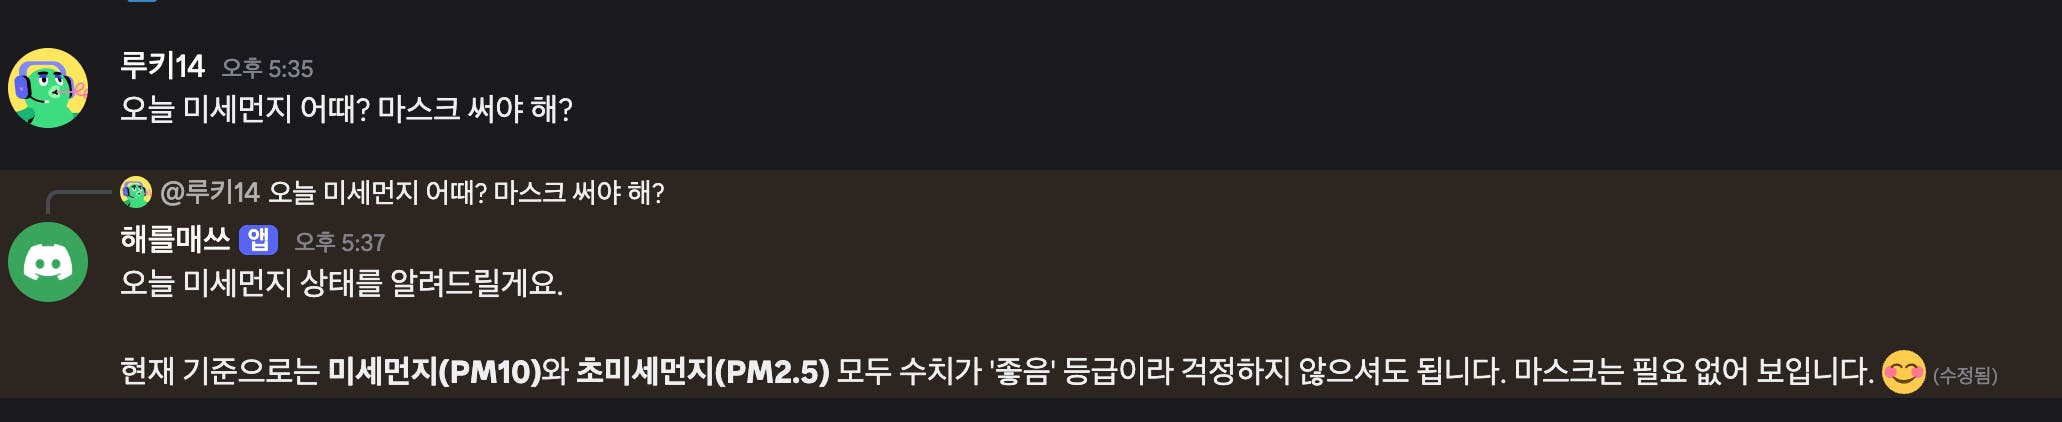
파일에 있던 실제 데이터와 정확히 일치했다.
고난이도 추론을 한 게 아니다. 미리 저장해둔 파일 안에서 답을 찾은 것이다. 그런데 그게 되기까지 구조 설계, 스크립트 작성, 파이프라인 연결, 테스트에 수십 시간이 걸렸다. 그래서 그 한 줄이 더 인상적이었다.
해를매쓰 페르소나와 정직 규칙 추가
데이터 연결이 됐으니, 이제 말투도 손봤다.
해를매쓰의 페르소나를 넣어줬으면 좋겠어
매우 친절한 승무원같은 사람으로
캐릭터 설정을 system_prompt에 추가했다. 동시에 정직 규칙도 넣었다 — 모르는 건 모른다고 말하고, "API가 없어서요"같은 기술적 변명은 쓰지 않는다는 원칙.
응답 속도 문제 — 24,000 토큰짜리 괴물 발견
그런데 답변이 너무 느렸다. 질문 하나에 2분 넘게 걸렸다.
답변이 조금 더 빠르게 올 수는 없을까? 지금 많이 느려서 좀 답답해원인을 파보니 황당했다. AI가 매 대화마다 읽어야 하는 사전 지시(system_prompt)가 24,201 토큰이었다. SOUL.md(생활 데이터) 약 2,000 토큰은 필요한 내용이었는데, 나머지 22,000 토큰이 전부 "이런 스킬도 있어요" 목록이었다. Discord 봇한테는 전혀 필요 없는 기능 목록 96개가 매번 주입되고 있었던 것이다.
config 파일에 Discord 플랫폼에서는 스킬 목록을 주입하지 않도록 설정했더니 system_prompt가 24,201 → 1,467 토큰으로 줄었다. 94% 감소.
✅ 결과 (After)
Before vs After
항목 | Before | After |
|---|---|---|
크론 데이터 인식 | 불가 (구조적 분리) | 매일 자동 반영 |
답변 가능 범위 | 모름 / 지어냄 | 날씨·가계부·건강·일정 |
답변 속도 | 2분+ | 체감 빠름 (토큰 94% 감소) |
운영 비용 | GPT API 종량제 | 완전 로컬, 무료 |
대화 가능한 범위
오늘/내일/이번 주 날씨, 미세먼지, UV
이달 가계부 현황, 오늘 지출, 최근 3일 내역
자산 현황, 정기구독 목록
오늘 운동, 수면, 수분, 칼로리/단백질 섭취량
오늘/내일/이번 주 일정
할 수 없는 범위 (의도된 한계)
과거 특정 날짜 데이터 (스냅샷에 없으면 모름)
실시간 주가, 뉴스 등 외부 실시간 정보
복잡한 추론·분석 (4B 모델 한계)
💬 이 과정에서 배운 AI 활용 팁
효과적이었던 것
작은 모델은 틀을 좁혀줄수록 잘한다 — 뭐든 알아서 하라고 하면 망함. 읽을 파일과 답할 범위를 명확히 줄수록 정확도가 올라감
못 하는 걸 빨리 인정하고 구조를 바꾸는 게 낫다 — gemma의 실시간 조회 한계를 일찍 인정하고 스냅샷 RAG로 전환한 게 전체 완성을 앞당겼음
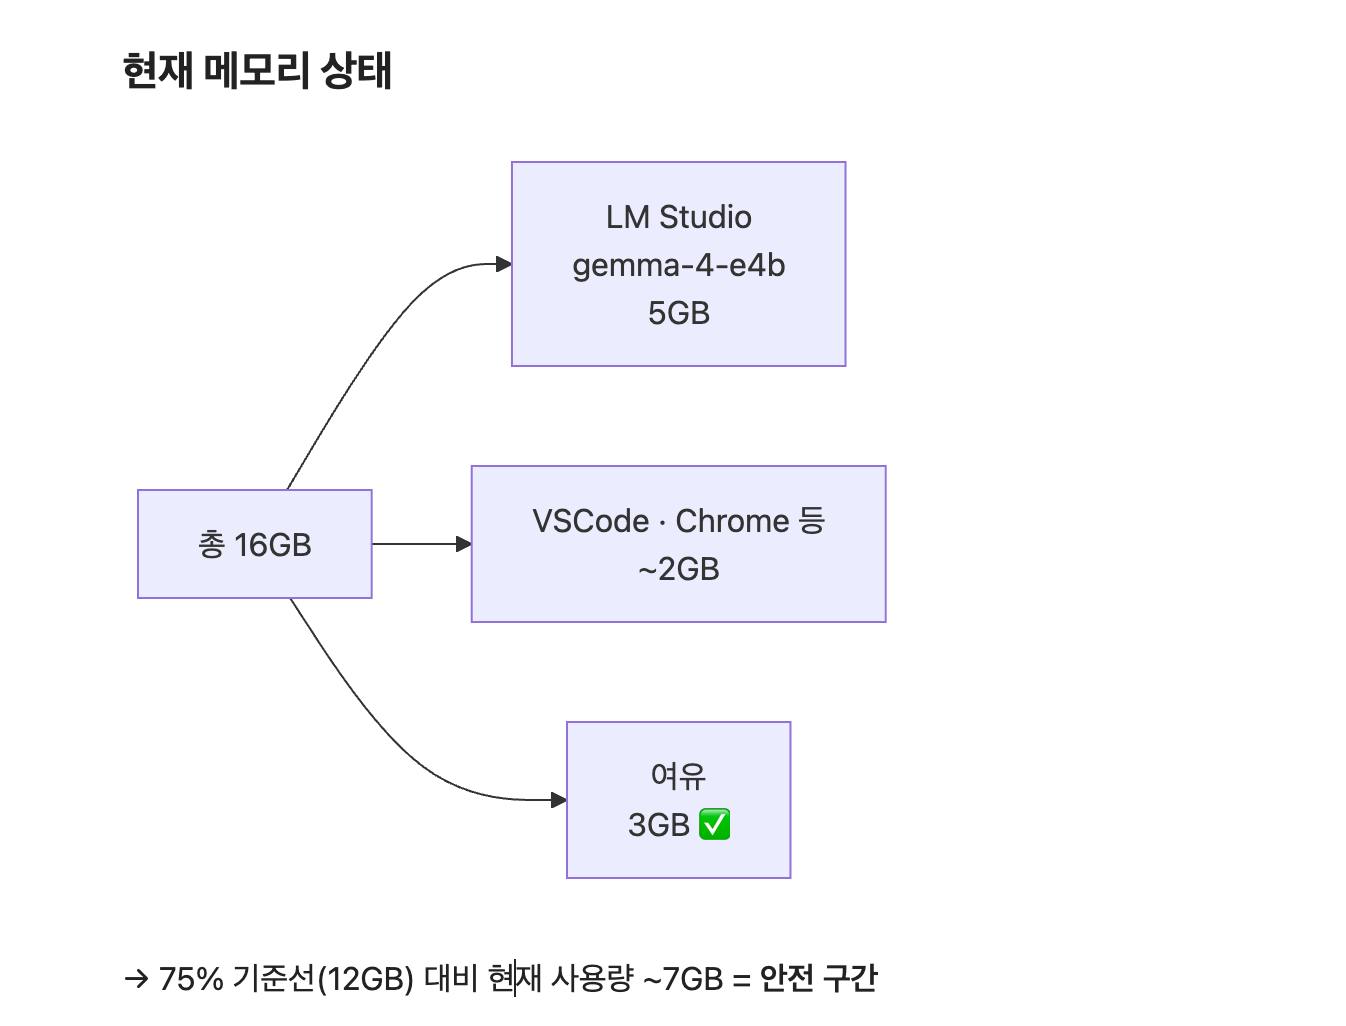
설정은 내 PC 기준에 맞게해야하고 그 수치는 직접 찾아야 한다 — 각자의 PC환경이 제각각이기 때문에 각자에 맞는 최적의 config를 세팅하고 어떤 모델과 어떤 세팅이 잘 돌아가는지 직접 체크해야한다. 물론 ai가 도와준다!
한 줄씩 검증하기 — 파이프라인 전체를 한 번에 테스트하려 하지 말고 파일이 생겼는지 → 내용이 맞는지 → AI가 읽는지를 단계별로 확인
이렇게 하면 안 돼요
"더 똑똑하게" 욕심 내다가 기초 무너짐 — 실시간 쿼리·스킬화 욕심을 버리고 단순한 파일 읽기로 갔을 때 오히려 안정됐음
속도 문제를 모델 탓만 하지 말기 — 24,000 토큰짜리 불필요한 목록이 속도를 잡아먹고 있었음. 구조를 먼저 점검해야 함
조금 느려도 되요 — AI의 빠른 답변에 익숙해진 우리들... 그냥 챗봇 비서와 카카오톡 한다고 생각하면 1~2분정도는 기다려줄 수 있어요. 답변이 조금 느리다면 상대방이 아직 카톡을 확인을 못했다고 생각하면 정신건강에 좋습니다. ^^ 그래도 조금만... 조금씩이라도 더 빨라지길 바래봅니다.ㅎㅎㅎ
🌍 다른 업무에 적용한다면?
매일 반복해서 확인하는 데이터가 있다면 → 파일로 저장하고 AI한테 읽게 하면 됨
고객 문의 답변, 재고 현황, 팀 일정 등 "정해진 범위 안에서 자주 묻는 것"은 이 구조가 딱 맞음
🚀 앞으로의 계획
Discord에서 실제로 더 다양한 질문을 해보면서 스냅샷 범위 조정
gemma 다음 버전이 나오면 tool call 능력 재테스트 → 실시간 쿼리 가능해지면 전환 고려


필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
한계를 알아야 합니다
저도... 계속 한계치 이상을 시켜서 앵무새처럼 같은 말을 반복하는 때가 있는데...!
이런 사례글이 도움이 되는것같아요 ㅎㅎㅎ