PDF 원문은 raw에, 해석은 wiki/output에: 경쟁 약물 인텔리전스 파이프라인 만들기
2026.05.24
소개
임상 및 약물 개발 데이터를 다루다 보면, 동일한 파이프라인(예: Medicenna의 MDNA11)에 대한 발표 자료가 학회 Poster, Final Slides, Publication Hub, Scientific Presentations 등으로 사방에 파편화되는 문제를 겪게 됩니다.
단순히 자료를 '읽는 것'을 넘어, 나중에 다시 찾고, 과거 데이터와 비교하며, 하나의 연속된 역사(History)로 연결하는 자산화 과정이 필요했습니다. 이를 위해 원문은 그대로 보관하되 정리와 해석은 별도의 레이어로 철저히 분리하는 구조를 설계하고, Hermes 에이전트를 활용해 이를 지속 가능한 인텔리전스 파이프라인으로 구축하는 시도를 진행했습니다.
일회성 수집에 그치지 않고, 웹 환경의 제약을 넘어 약물 개발의 히스토리를 끊김 없이 이어갈 수 있는 지식 관리 인프라를 만드는 것이 이번 프로젝트의 궁극적인 목표였습니다.
진행 방법
이번 파이프라인 구축을 위해 Hermes 에이전트와 구조화된 폴더 아키텍처, 그리고 데이터 오염을 방지하는 메타데이터 관리 방식을 활용했습니다.
인프라 및 환경 구축: 사용자가 수집한 소스를 체계적으로 분류하고 에이전트가 접근할 수 있도록
raw / wiki / inventory / output으로 이어지는 4단계 폴더 아키텍처를 수립했습니다.데이터 수집 및 예외 처리: R 페이지(Publications/Presentations) 크롤링 시 발생한 'Access Denied(curl 응답 실패)' 문제를 우회하기 위해, 수동 다운로드한 학회 poster PDF를
raw/papers에 직접 적재하는 방식으로 전환했습니다.원문 보관(Raw Layer) 최적화: 원본 PDF의 텍스트 추출 가능 여부를 확인한 뒤, 원문 데이터의 오염을 막기 위해 본문은 전혀 건드리지 않고 파일명과 일치하는
.md형태의 sidecar note를 생성했습니다.에이전트 스킬 자산화: 이번 사례글 작성 및 파이프라인 운영에 사용된 Hermes 스킬들을 Downloads 폴더에서 개인용 스킬 디렉토리로 이동시켜, 향후 유사한 타깃 약물 추적 시 즉시 재사용할 수 있도록 자산화했습니다.
[원문 증거] raw/ (PDF + sidecar 메타노트)
    │
    ▼
[추적 대상] inventory/
    │
    ▼
[정리된 지식] wiki/ (타임라인 및 히스토리 연결)
    │
    ▼
[최종 결과물] output/ (사람이 읽는 해석층)
결과와 배운 점
[결과 및 배운 점]
웹 크롤링이 차단되는 환경에서도 PDF 원문만 확보되면 파이프라인이 중단 없이 돌아갈 수 있다는 점을 확인했습니다. 제목과 핵심 문구가 정상적으로 추출되는 것을 보며, 결국 핵심은 '완벽한 자동 수집'이 아니라 '확보한 원문을 어떻게 다루는가'에 있다는 것을 배웠습니다.
가장 크게 배운 점은 데이터 레이어의 명확한 역할 분담입니다.
raw는 글을 쓰는 곳이 아니라 원문 증거를 지키는 곳이어야 하고,sidecar는 요약문이 아니라 출처 URL, 캡처 날짜, 문서 타입 등을 적어두는 위치표(메타 카드) 역할을 할 때 가장 가볍고 오래간다는 것입니다.
처음에는 무조건 많은 자료를 긁어모으는 자동화에 매몰될 뻔했으나, 구조를 분리하고 나니 특정 프로그램의 과거 발표와 최신 슬라이드를 시간순(Chronological)으로 이어서 볼 수 있는 단단한 기반이 생겼습니다.
처음부터 완벽한 구조를 이해하고 시작한 것은 아니었지만, 일단 굴려보면서 구조를 몸으로 익히는 과정이 중요했습니다. 다음 단계는 이렇게 쌓인 raw와 sidecar를 바탕으로, 본격적인 LLM-wiki 지식 정제 층을 두텁게 구축하는 것입니다.
[해결하고 싶은 내용]
raw 파일의 저장을 어떻게 하는 것이 효율적인지 고민하고 있습니다. 아무래도 pdf 파일이 계속 필요할 것 같은데 계속 로컬에 저장하는 방식보다 클라우드 등을 통해 더 좋은 방식이 있을 것 같은데 더 찾아봐야 될 것 같습니다.
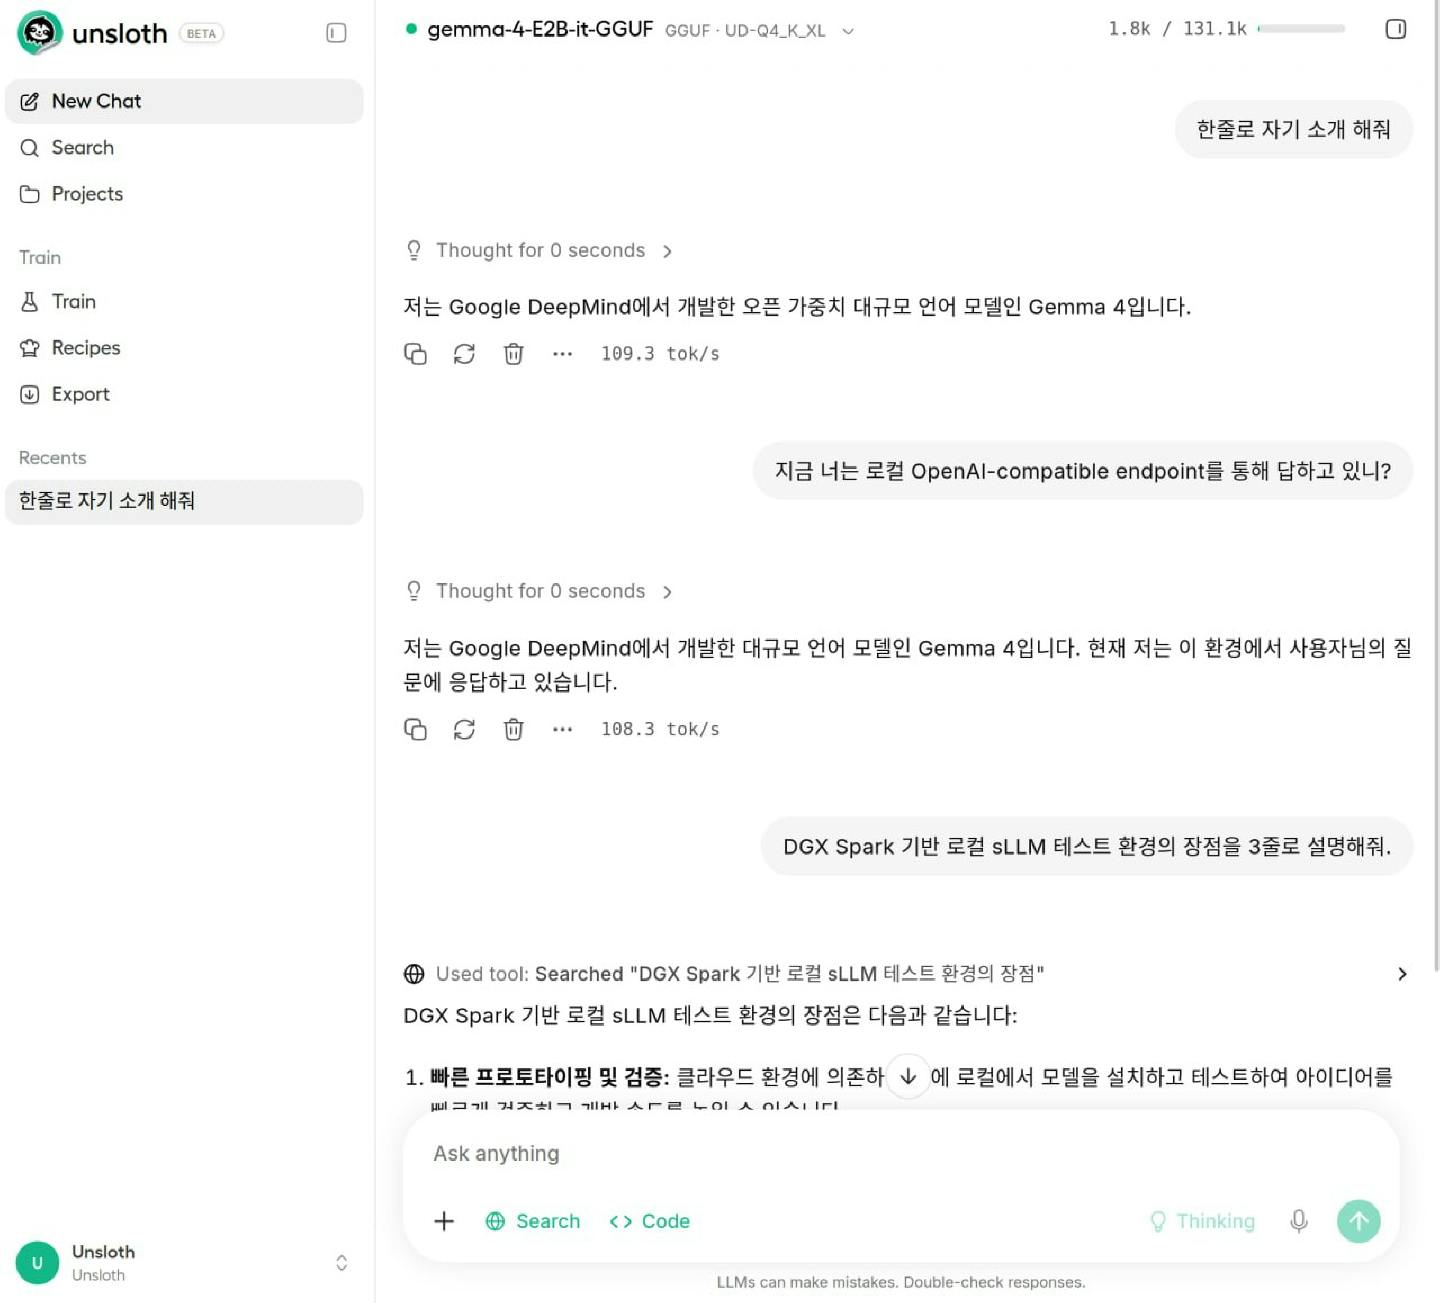
Hermes에서 사용되고 있는 토큰 사용량이 어느 정도인지 실시간으로 확인해보고 싶습니다.
나와 비슷하게 판단하는 봇을 사용하기 위해서 가장 좋은 방식은 나의 말투와 나의 대응방식을 익혔으면 좋겠다고 생각했습니다. 사내 메일이 반출이 안되는 시스템이라 이걸 어떻게 archiving하는 것이 좋을지, 저와 같이 외부 반출이나 confidential 데이터를 다루는 경우 어떻게 하시는지 궁금합니다.
[다음 계획]
현재는 경쟁 약물 하나만 예시로 해봤다면, 앞으로 몇 가지의 경쟁 약물 데이터를 더 모아서 구조화된 LLM wiki를 만들고 싶습니다.
하나의 결론을 내기 위해서 여러 가지의 데이터를 다 참고하고 결정하는 저와 닮은 봇을 만들기 위해서, 더 견고하게 구조화하고, 결정 알고리즘을 정교화하는 과정이 필요할 것 같습니다.
도움 받은 글 (옵션)
지피터스 리서치하네스 온오프모임 정규세션 자료 - Giacomo

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


ssuv님, 원문과 해석 레이어를 분리하신 점이 이 글의 가장 중요한 포인트로 보였습니다. 경쟁 약물 자료처럼 시간이 지나면서 발표 자료, 포스터, 슬라이드, publication 자료가 흩어지는 영역에서는
raw / inventory / wiki / output의 역할을 나눠두는 것만으로도 나중에 다시 검증할 수 있는 기반이 생긴다고 느꼈습니다. 특히 Access Denied가 났을 때 크롤링을 억지로 밀어붙이지 않고, 수동으로 확보한 PDF를 raw에 두고 sidecar note로 출처와 문서 타입을 남긴 흐름이 좋았습니다. “완벽한 자동 수집”보다 “확보한 원문을 오염시키지 않고 오래 추적하는 구조”가 더 중요하다는 배움이 잘 드러났습니다. 다만 임상·약물 개발 자료와 사내 메일처럼 confidential 가능성이 있는 데이터는, 에이전트가 더 잘 배우게 만드는 것보다 먼저 데이터 경계를 정하는 것이 안전해 보입니다. 공개 자료, 내부 참고 가능 자료, 외부 반출 금지 자료를 나누고, 어떤 자료는 AI 입력에 넣지 않을지부터 정해두면 이후 파이프라인이 훨씬 안정적일 것 같습니다. 다음 단계에서는 경쟁 약물 하나의 공개 PDF 1건만 샘플로 삼아,자료 등급 / 저장 위치 / sidecar에 남길 메타데이터 / AI에게 넣지 않을 항목을 한 장짜리 규칙으로 만들어보시면 좋겠습니다. 그 규칙이 생기면 클라우드 저장이나 LLM-WIKI 확장도 더 안전하게 판단할 수 있을 것 같습니다.