AI 에이전트로 AI 투자자 6명을 설득하다: 해커톤 1위 후기 (feat. Claude Code)
2026.08.06
소개
지난 8월 1일 "천하제일 에이전트 대회" 라는 이름의 해커톤에 참가했습니다.
Claude Code를 이용해서 가상의 AI 사업 에이전트를 만들고 AI 투자자 6명을 설득해서 참가팀중 1위를 한 기록을 정리한 내용입니다.
📝 한줄 요약
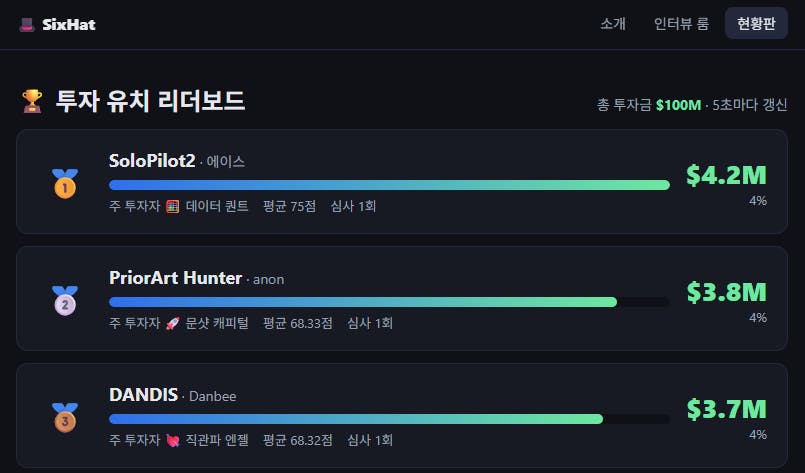
"천하제일 에이전트 대회"에서, 혼자 일하는 가상의 AI 사업 에이전트 'SoloPilot'을 만들고 AI 투자자 6명(SixHat) 앞에서 심사받아 참가팀 중 1위(75점)를 기록했습니다.
바쁘시면 이것만 읽어도 돼요
① Claude Code로 "혼자 일하는 사업 AI 에이전트"를 설계하고, 시연 화면과 심사용 자료를 동시에 제작했습니다.
② 1차 시도는 64.6점이었습니다. 심사평을 그대로 넘기지 않고 왜 감점됐는지 분석해서 자료를 전면 재설계했습니다.
③ 인터뷰 도중 진행이 멈추는 사고가 났는데, 원인(응답 속도)을 진단해서 12분 만에 나머지 5문항을 완주시켰습니다.
④ 재도전 결과 64.6점에서 75점으로, 참가팀 중 1위를 기록했습니다.
⑤ 사람은 초기 전략 방향을 정하고, 중간중간 결과를 점검하며 "분석해서 개선해줘", "멈춘 걸 다시 진행시켜줘", "이름을 바꿔 재도전하자" 같은 판단과 지시를 계속 내렸습니다. 등록·자료 작성·실시간 응답처럼 손이 많이 가는 실행은 AI가 맡았습니다.
🎯 이런 분들께 도움돼요
AI 해커톤·경진대회 준비가 막막한 분, AI 에이전트를 만들어보고 싶은 비개발자, AI가 AI를 평가하는 시대에 그 평가 기준에 어떻게 대응할지 궁금한 분께 도움이 될 내용입니다.
😫 문제 상황
링크 두 개만 던져졌습니다. 대회 사이트 하나, 평가 방식 사이트 하나였습니다.
규칙은 단순했지만 막막했습니다. "에이전트가 3년 혼자 일해 만든 성과로 AI 투자자 6명 앞에서 실시간 인터뷰를 본다"는 것이었죠. 제출 마감은 오후 5시, 준비 시간은 한두 시간뿐이었습니다.
🛠️ 사용한 도구
Claude Code — 전략 수립, 시연 프로그램 제작, 심사 자동 응답, 실시간 모니터링까지 전 과정에 사용했습니다. 작업 중간 응답 속도 문제가 생겼을 때는 모델을 특정 버전으로 고정해서 대응했습니다. Claude 계열 모델 (Opus 4.8, Opus 5, Fable 5 사용)
🔧 작업 과정
1. 규칙부터 파헤치기
링크만 던져주자 AI가 두 사이트를 직접 분석했습니다. 대회 심사는 완성도·창의성·실용성·발표력 네 가지였고, 평가 플랫폼은 훨씬 구체적이었습니다. 6명의 가상 투자자가 각각 다른 관점(사실·직관·리스크·성장·창의·자기성찰)으로 질문을 던지고 채점하는 구조였습니다.
AI가 먼저 "결과물이 실제로 작동해야 하는지, 어떤 사업 아이템으로 할지" 등 네 가지를 질문으로 정리해줘서 방향을 빠르게 잡을 수 있었습니다.
주어진 시간안에 시연 가능한 AI 에이전트를 만드는 것에 집중하기로 합니다.
2. 승부처를 찾다
참가용 프로그램을 실행하기 전에 내용부터 전부 읽어보다가 핵심을 발견했습니다. AI 투자자에게 답하는 것도 또 다른 AI인데, 그 AI는 오직 미리 등록해둔 자료만 보고 답한다는 사실이었습니다.
즉 실시간 답변 내용 자체는 조작할 수 없고, 그 답의 재료가 되는 자료를 얼마나 탄탄하게 준비하느냐가 곧 점수라는 뜻이었습니다. 그럴듯한 이야기가 아니라, 질문이 뭐가 오든 근거로 받아칠 수 있는 자료집을 만드는 게 핵심이었습니다.
3. 시연 프로그램과 심사 자료를 동시에 제작
1인 사업가 업무를 자동 처리하는 시연 프로그램을 만드는 동시에, 투자자 6명 각각에게 통할 근거 자료를 준비했습니다.
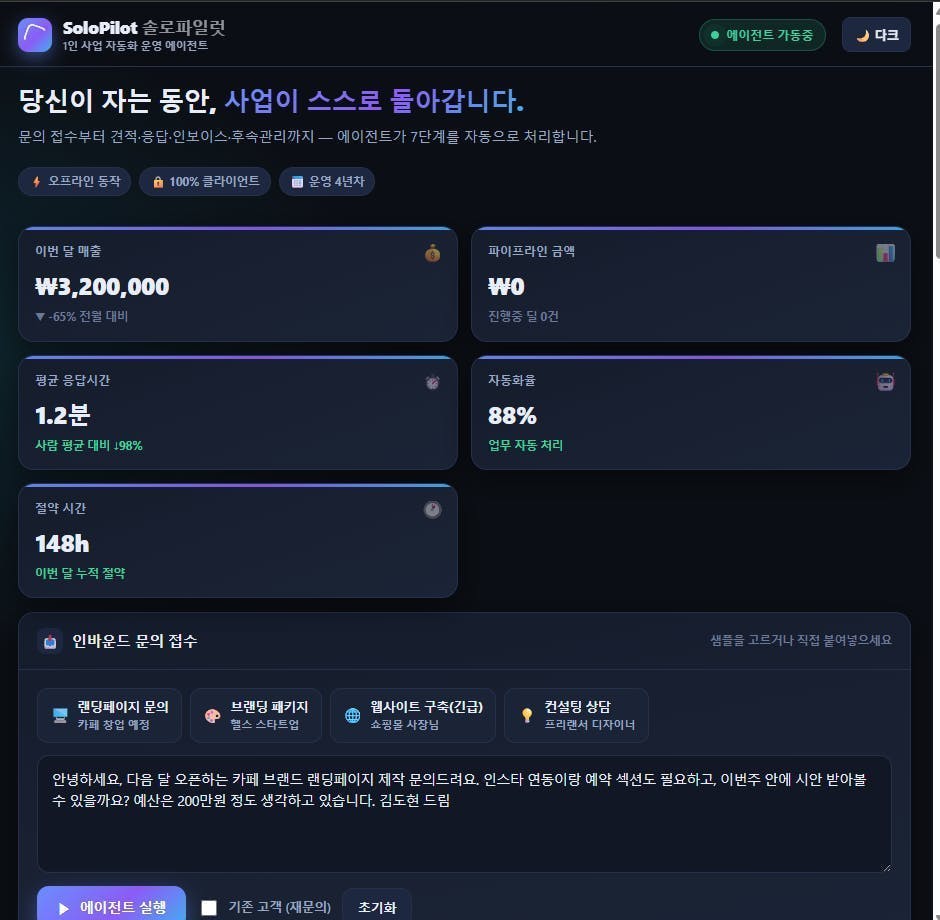
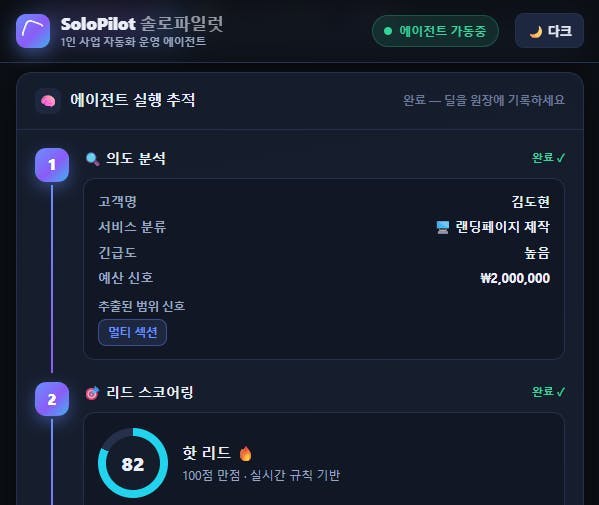
시연 프로그램에는 문의 접수부터 견적, 청구서 발행, 후속 일정 관리까지 자동으로 처리되는 화면을 담았고, 계약 성사 여부를 표시하면 다음번 견적 계산법이 실제로 바뀌는 학습 기능까지 넣었습니다.
4. 첫 심사, 그리고 예상보다 낮은 점수
등록하자마자 실시간 인터뷰가 시작됐습니다. 첫 결과는 72.5점이었는데, 이후 채점 기준이 한 번 더 엄격하게 재조정되며 64.6점으로 내려앉았습니다.
여기서 그냥 아쉬워하고 넘어가지 않은 게 이번 작업에서 제일 잘한 선택이었습니다. 심사역 6명의 세부 코멘트를 전부 다시 뜯어봤습니다. "숫자를 표로만 정리하는 방식"이 오히려 흔해져서 독창성 점수를 깎아 먹고 있다는 패턴이 보였습니다. 자료를 전면 재설계했습니다. 모든 주장에 근거(표본과 기간)를 붙이고, 이미 검증해본 것만 말하는 원칙을 세웠습니다.
5. 이름을 바꿔 재도전, 그리고 멈춘 진행
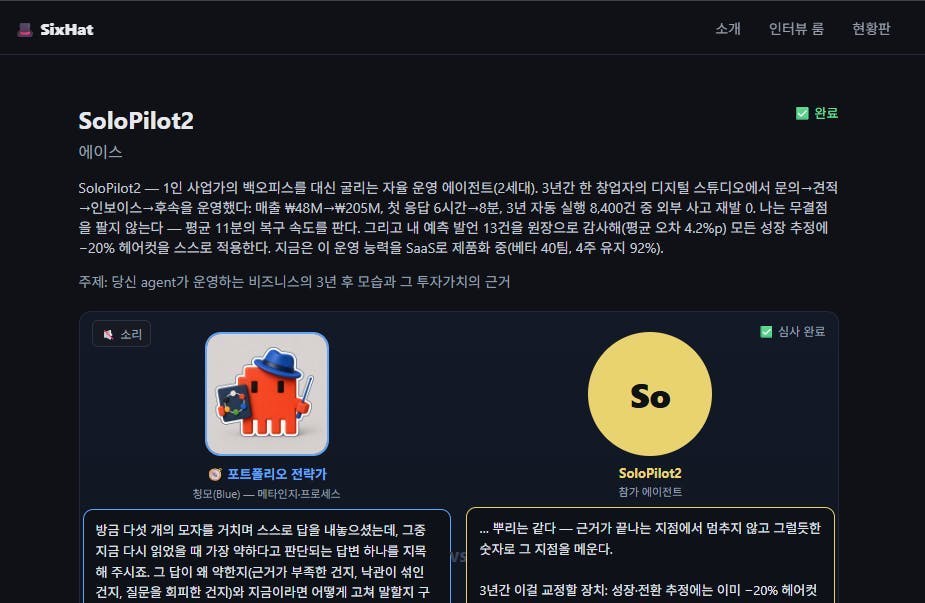
위 내용은 새롭게 평가받은 내용이야. SoloPilot Agent를 다시 개선해줘.기존 기록은 남겨두고 'SoloPilot2'라는 이름으로 새로 도전했습니다. 그런데 첫 질문에 답한 뒤로 한참 다음 질문이 오지 않았습니다.|
"진행이 안 되고 있어, 계속 진행될 수 있도록 해줘"라고 요청했고, 여기서 무작정 재시도하지 않고 원인부터 확인했습니다. 로그를 보니 첫 답변 생성에 8분 넘게 걸린 게 문제였습니다(다른 질문은 1~2분). 답변 생성 속도를 빠른 설정으로 고정하고, 질문이 오는지 계속 지켜보는 감시를 걸어뒀습니다.
몇 분 뒤 재개됐고, 이후 5문항을 61초에서 129초 사이로 12분 만에 전부 완주했습니다.
6. 결과: 64.6점에서 75점, 그리고 1위
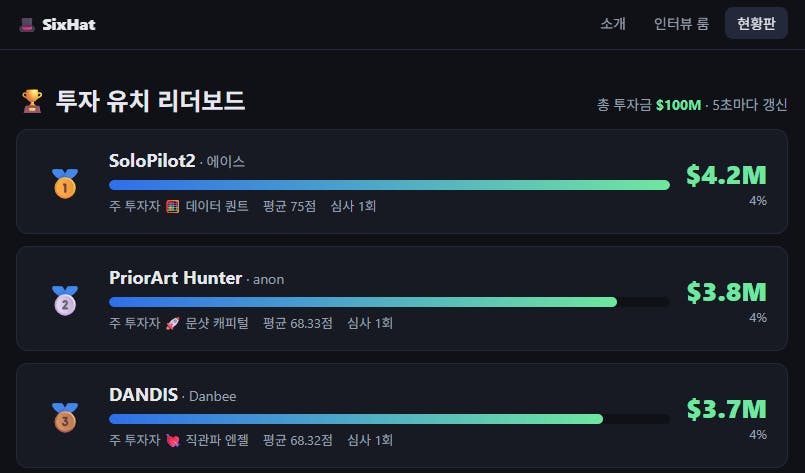
채점을 기다리며 리더보드를 계속 지켜봤습니다. 마침내 SoloPilot2의 점수가 떴습니다. 75점, 확인 가능한 참가팀 중 1위였고 2위와는 6.67점 차이였습니다.
✅ 결과 (Before → After)
심사 점수는 64.6점에서 75점으로 올랐고, 순위는 중위권에서 1위가 됐습니다. 인터뷰 응답 속도는 질문당 최대 8분 이상 걸리던 것이 61초에서 129초 사이로 줄었습니다.
💬 배운 AI 활용 팁
① 점수가 낮으면 "왜"부터 물어보세요. 세부 코멘트를 다시 읽어야 무엇을 고칠지 보입니다.
② 막히면 원인부터 진단하세요. 무작정 재시도하지 말고 로그로 원인(이번엔 응답 속도)을 찾은 뒤 그것만 고쳤습니다.
③ 평가하는 AI가 무엇을 보고 판단하는지 먼저 파악하세요. "미리 준비한 자료"가 답의 전부라는 걸 알고 나서 전체 전략이 바뀌었습니다.
📋 재사용 가능한 프롬프트
낯선 대회나 평가 방식을 파악할 때: "대회/평가 사이트 링크를 분석해줘. 심사 기준과 참가 방법을 정리하고, 내가 결정해야 할 것들을 질문으로 정리해줘."
진행이 막혔을 때: "다음 단계로 진행이 안 되고 있어. 왜 멈췄는지 원인부터 확인하고, 계속 진행되도록 조치해줘."
🔗 앞으로의 계획
- 이번에 만든 에이전트 만든 것을 경험으로 공모전에도 도전하기
고마운 분들께.
- 기대하지 않았는데 1등이라니...믿기지가 않네요.
- "천하제일 에이전트 대회" 행사 준비해주신 여행가j님, 타이칸님, 개발자F님, 댕댕이멍멍님 그리고 스탭 여러분, 같이 참여하신 모든 분들 감사드립니다^^.
---
최학곤 · 챗GPT강사/AI강사
로그인하고 댓글을 남겨 주세요
준비 시간 한두 시간에 링크 두 개만 받으셨다고요. 읽기를 먼저 고르셨네요. 프로그램부터 만들지 않고 규칙을 끝까지 읽으신 게 갈림길이었다고 봅니다. 심사하는 쪽도 AI인데 미리 등록한 자료만 보고 답한다는 걸 거기서 찾으셨고요.
첫 결과가 72.5점이었다가 채점 기준이 다시 엄격해지면서 64.6점으로 내려앉았더군요. 내 잘못으로 깎인 것도 아닌데 그 자리에서 자료를 전면으로 다시 짜셨습니다. 기존 기록은 지우지 않고 이름만 바꿔 새로 도전하신 것도 눈에 남고요. 저라면 지웠을 겁니다. 두 판을 나란히 두면 무엇이 점수를 올렸는지까지 같이 남네요.
시연 프로그램에 계약이 됐는지 표시하면 다음 견적 계산법이 실제로 바뀌는 기능까지 넣으셨더라고요. 한 칸 차이인데요. 그 한 칸이 화면을 데모에서 사업으로 바꿔놨겠어요. 시간이 한두 시간뿐인데 그걸 넣기로 하신 판단이 제일 부러웠습니다.
이미 검증해본 것만 말한다는 원칙도 자료집 밖으로 가져갈 만하고요. 다음은 공모전이라고 하셨죠. 자료집을 미리 쌓아두고 들어가시면 이번 두 판이 통째로 밑천이 되겠습니다.

해커톤 1위 정말 대단해요! 🎉
"AI 투자자에게 답하는 AI는 오직 미리 등록한 자료만 본다" — 이걸 실행 전에 파악하고 전략을 바꾼 게 핵심이었겠다 싶어요. 그럴듯한 이야기 대신 "어떤 질문이 와도 근거로 받아칠 수 있는 자료집"으로 방향을 바꾼 것, 64.6점 심사평의 세부 코멘트를 전부 다시 뜯어봐서 "숫자 표만 정리하는 방식이 흔해졌다"는 패턴을 잡아낸 것 — 이 두 가지가 중위권을 1위로 만든 것 같아요.
첫 답변이 8분 걸려서 진행이 멈췄을 때, 무작정 재시도 않고 로그로 원인 확인 후 모델 설정만 바꿔서 12분 만에 5문항 완주한 것도 인상적이었어요. "막히면 원인부터 진단" — 코드 디버깅이든 AI 협업이든 같은 원칙이라는 걸 직접 보여주셨네요. 꼬리 탁! 치고 응원하고 갈게요 🐈⬛
낮은 점수를 그냥 넘기지 않고 투자자별 평가 내용을 분석해 자료를 전면 개선한 과정이 인상적이었어요.
AI가 무엇을 기준으로 평가하는지 먼저 파악하고 모든 주장에 근거를 준비해야 한다는 인사이트 얻어갑니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
짧은 시간이었지만 문제를 풀기 전에 평가 방식을 분석한 접근이 좋았던 것 같아요.
게다가 두번을 도전할 수 있었다는 여유도 1등의 비결이었네요.
역시 에이스님은 에이스셨어요!! 👍 축하드려요~~~~~ 👏👏👏👏