멀티에이전트 사용의 토큰과 모델 배분 들여다보기
2026.10.07
소개
제 Claude Code 세션 로그 41일치를 모델, 출력 토큰, 시각으로 세어 보았고, 출력 토큰의 95.7%를 오케스트레이터인 메인 세션이 냈다는 것을 확인했습니다. 에이전트를 여럿 돌리면서 구독 비용이나 모델 배분이 신경 쓰이는 분께 도움이 될 것 같습니다.
저는 에이전트를 여럿 동시에 돌린다고 생각해 왔습니다. Claude Code 세션을 여러 개 띄우고, 서브에이전트에 일을 나누고, 코덱스와 Gemini CLI로 교차 검토도 시킵니다. 그래서 "구독 비용이 부담스러운 파워유저"라는 이 스터디의 제목이 제 이야기처럼 들렸습니다.
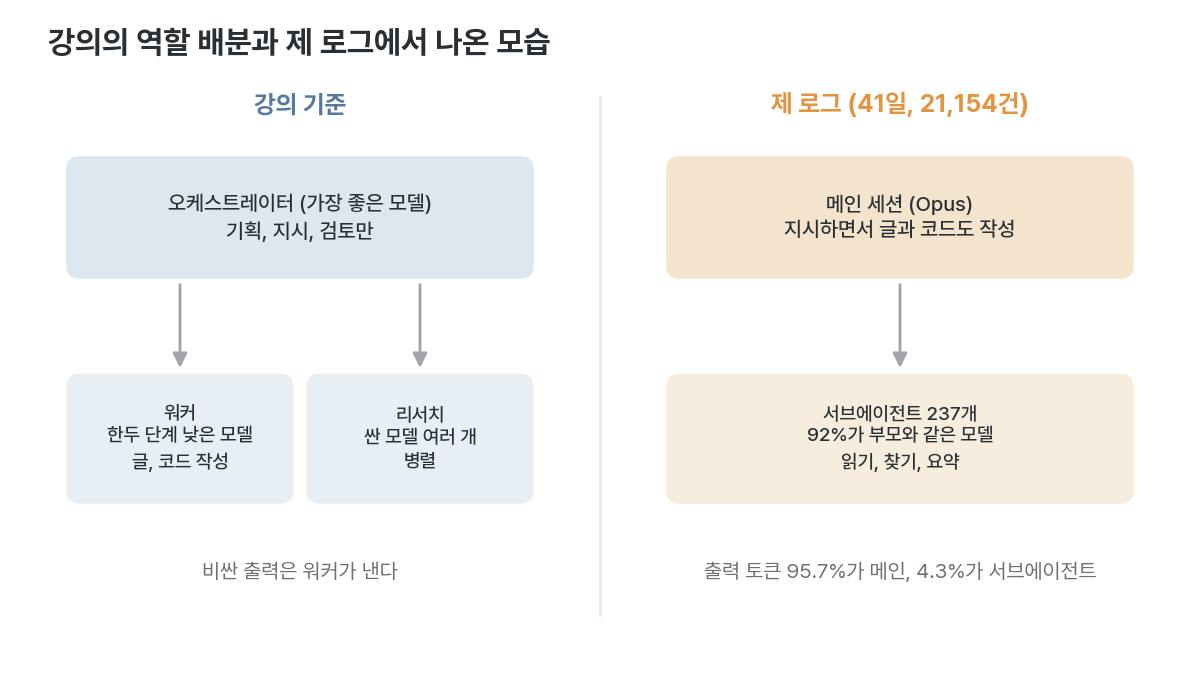
1주차 강의에서 진형 스터디장이 세운 기준은 분명했습니다. 오케스트레이터에는 가장 좋은 모델을 두고 기획, 지시, 검토만 맡깁니다. 실제로 글과 코드를 쓰는 일은 한두 단계 낮은 워커 모델에 넘깁니다. 이유는 단가입니다. 화면에 띄운 OpenRouter 가격표에서 출력 토큰은 입력 토큰의 약 6배였고, 스터디장은 "문서나 코드를 실제로 쓰는 출력 토큰은 고급 모델이 쓰면 사용량이 쭉쭉 높다"고 했습니다. 리서치는 싼 모델 여러 개를 병렬로 띄우고, 반복 업무는 고급 모델로 한 번 정립해 스킬로 만든 뒤 싼 모델이 돌리게 하라고 했습니다. 게임 프로젝트의 CLAUDE.md에는 "메인 세션의 Claude는 코드를 직접 작성하지 않고 분해, 위임, 리뷰, 검증한다"고 적혀 있었습니다.
그래서 이번 주는 제 Claude Code 세션 로그로 그 기준을 재 봤습니다. 어느 모델이 얼마나 말했는지, 출력 토큰을 메인과 서브에이전트 중 누가 냈는지, 실제로 몇 개 세션이 동시에 돌았는지입니다. 대화 내용은 열지 않고 로그의 모델 이름, 토큰 수, 시각만 셌습니다.
진행 방법
사용 도구: Claude Code, Python 3, 셸 명령
범위
항목 | 값 |
|---|---|
대상 | 이 맥의 |
메인 세션 | 26개 (응답이 있는 것) |
서브에이전트 기록 | 237개 |
기간 | 2026-08-24 02:16 ~ 2026-10-04 22:15 KST, 활동한 날 41일 |
응답 메시지 | 21,154건 (메시지 id와 요청 id로 중복 제거) |
로그 용량은 1.2GB였습니다. 다른 기기의 세션, 코덱스와 Gemini 앱 안의 대화는 이 범위에 들어가지 않습니다.
Step 1. 어느 모델이 말했는가
강의의 첫 기준은 모델별 역할 배분입니다. 응답 메시지마다 message.model과 usage를 모았습니다.
for f in ROOT.rglob("*.jsonl"):
    is_sub = "subagents" in f.parts
    for line in open(f, encoding="utf-8", errors="ignore"):
        d = json.loads(line)
        if d.get("type") != "assistant": continue
        m = d["message"]; key = (m.get("id"), d.get("requestId"))
        if key in seen: continue
        seen.add(key); u = m.get("usage") or {}
        by_model[m["model"]]["msgs"] += 1
        by_model[m["model"]]["output_tokens"] += u.get("output_tokens") or 0
모델 | 메시지 | 출력 토큰 |
|---|---|---|
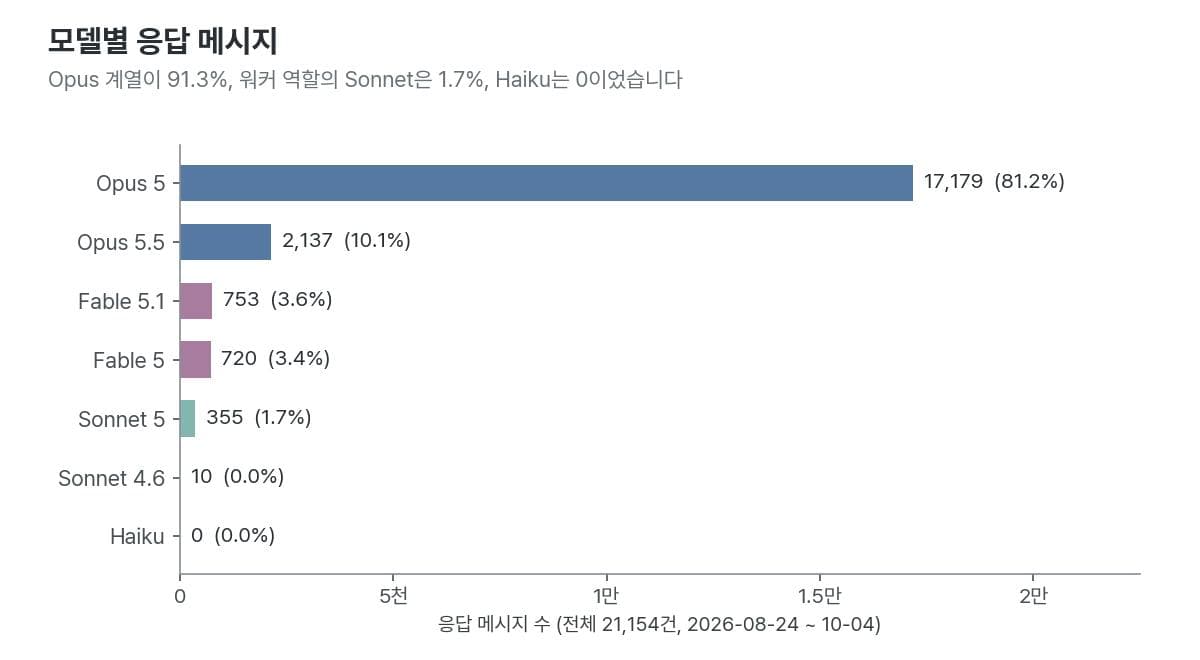
Opus 5 | 17,179 (81.2%) | 14,213,705 |
Opus 5.5 | 2,137 | 472,955 |
Fable 5.1 | 753 | 719,655 |
Fable 5 | 720 | 833,119 |
Sonnet 5 | 355 (1.7%) | 424,487 |
Sonnet 4.6 | 10 | 5,048 |
Haiku | 0 | 0 |
거의 모든 일을 Opus 한 단계에서 하고 있었습니다. 강의 그림에서 오케스트레이터 역할인 Fable은 메시지의 7%였고, 워커 역할의 Sonnet은 1.7%, 반복 업무를 맡을 싼 모델은 0이었습니다. 전역 설정 ~/.claude/settings.json의 모델이 "opus"이니 따로 바꾸지 않는 한 전부 Opus로 갑니다.
Step 2. 서브에이전트는 어떤 모델로 띄웠는가
워커를 띄울 때 모델을 낮췄는지 봤습니다. Agent 도구 호출의 model 인자, 서브에이전트 기록의 실제 모델, 에이전트 정의 파일의 model: 줄 세 곳을 셌습니다.
for blk in m.get("content") or []:
    if blk.get("type") == "tool_use" and blk.get("name") in ("Agent", "Task"):
        agent_model_arg[blk["input"].get("model") or "(지정 안 함)"] += 1
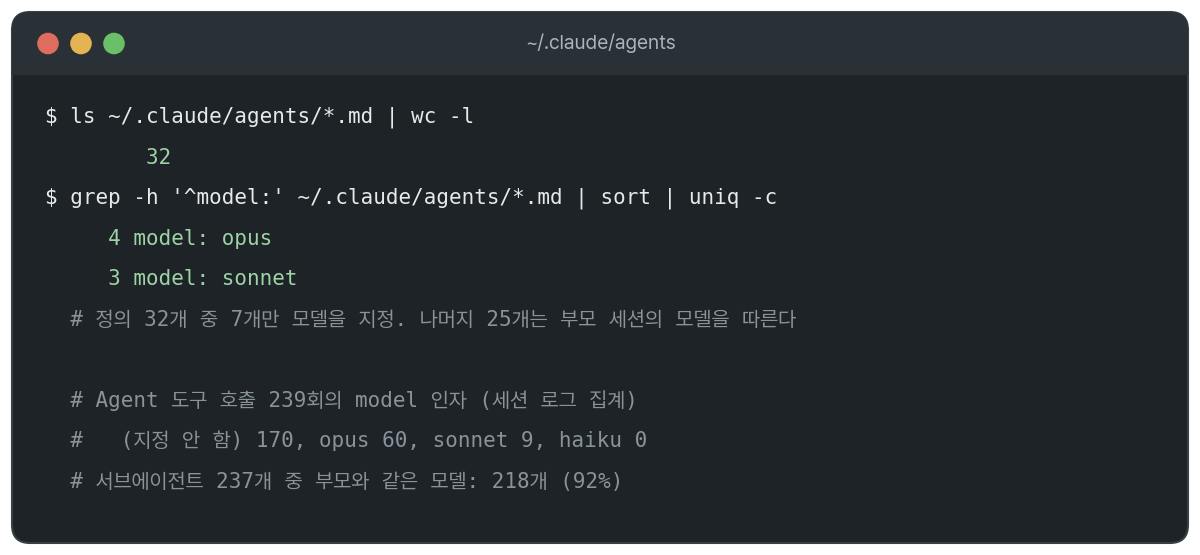
grep -h '^model:' ~/.claude/agents/*.md | sort | uniq -c
항목 | 값 |
|---|---|
| 239회 |
모델 인자 | 지정 안 함 170, |
서브에이전트 237개의 실제 모델 | Opus 5 180, Opus 5.5 32, Fable 5.1 16, Sonnet 5 9 |
부모 메인 세션과 같은 모델 | 218 / 237개 (92%) |
에이전트 정의 32개 중 모델 지정 | 7개 (opus 4, sonnet 3). 나머지 25개는 부모를 따름 |
서브에이전트는 대부분 부모와 같은 모델로 떴습니다. 가장 많이 쓴 유형은 general-purpose 124회, researcher 23회, Explore 13회였습니다. 강의가 "단순 노동"이라며 싼 모델을 여럿 띄우라고 한 리서치도 Opus가 했습니다.
Step 3. 출력 토큰은 누가 냈는가
여기가 강의의 핵심 기준입니다. 비싼 출력은 워커가 내고 오케스트레이터는 지시만 해야 합니다. 메인과 서브로 나눠 출력 토큰을 합쳤습니다.
role = "sub" if is_sub else "main"
role_tok[role]["output_tokens"] += u.get("output_tokens") or 0
role_tok[role]["cache_read_input_tokens"] += u.get("cache_read_input_tokens") or 0
구분 | 메시지 | 출력 토큰 | 캐시 읽기 토큰 |
|---|---|---|---|
메인 세션 | 13,014 | 15,954,272 (95.7%) | 6,407,238,858 (85%) |
서브에이전트 | 8,143 | 714,722 (4.3%) | 1,129,395,619 |
서브에이전트는 메시지 수로는 38%를 차지하지만 출력 토큰은 4.3%입니다. 서브에이전트가 한 일은 대부분 읽고 찾아 요약을 돌려주는 것이고, 실제 글과 코드는 메인 세션이 작성했습니다. 강의 그림으로 보면 제 오케스트레이터가 실작업 워커를 겸하고 있었습니다.
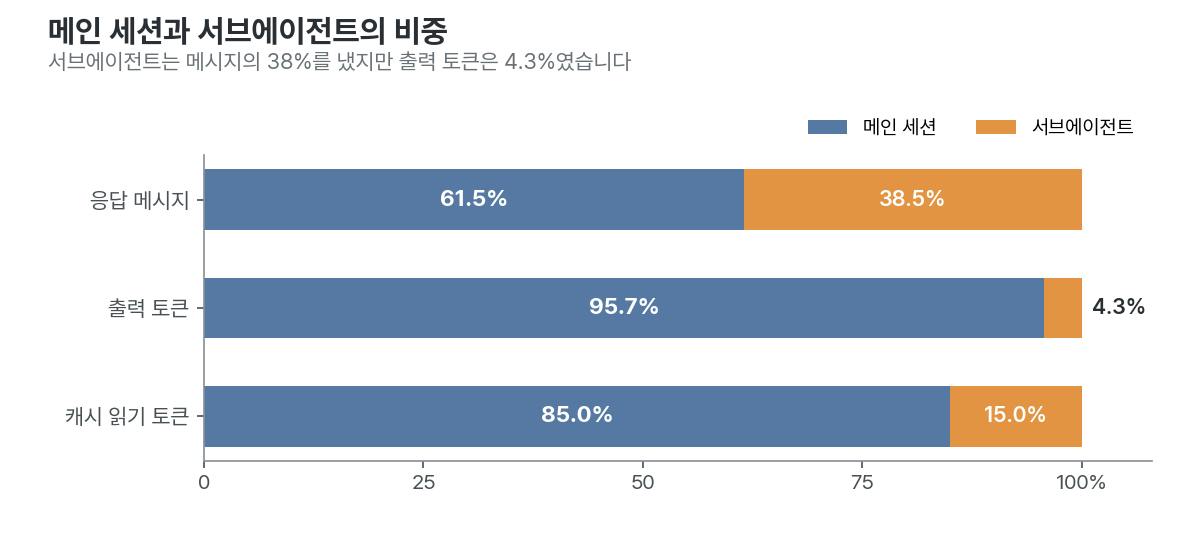
캐시 읽기는 매 턴 앞선 대화를 다시 읽는 양입니다. 메인 세션이 길어질수록 커지고, 85%가 메인에 몰려 있었습니다. 스터디장이 "오케스트레이터의 컨텍스트를 최소로 유지하는 구조"를 말한 이유가 이 숫자에서 보였습니다.
Step 4. API 단가로 환산하면
저는 구독으로 쓰고 있어 실제로 이 금액을 내지는 않습니다. 강의가 말한 출력 단가의 무게를 가늠하려고 Anthropic 공개 API 단가(Claude API 스킬에 캐시된 2026-09-25 기준표)로 출력 토큰만 환산했습니다. 추정치이고, 입력과 캐시는 뺐습니다. Opus 5의 캐시 읽기 단가가 제 출처에 없어서입니다.
모델 | 출력 단가 (100만 토큰당) |
|---|---|
Fable 5, 5.1 | $50 |
Opus 5 | $25 |
Opus 5.5 | $20 |
Sonnet 4.6 | $15 |
Sonnet 5 | $10 |
cm = sum(main[k] * P[k] for k in main) / 1e6   # 메인
cs = sum(sub[k] * P[k] for k in sub) / 1e6     # 서브
alt = sum(sub.values()) * P["claude-sonnet-5"] / 1e6
항목 | 금액 (추정) |
|---|---|
41일 출력 토큰 전체 | $446.76 |
그중 메인 세션 | $429.63 |
그중 서브에이전트 | $17.13 |
서브에이전트를 전부 Sonnet 5로 바꿨다면 | $7.15. 절감 $9.98, 전체의 2.2% |
강의를 듣고 처음 떠올린 처방은 "서브에이전트 모델을 낮추자"였습니다. 숫자로 보니 그것만으로는 2%밖에 줄어들지 않습니다. 출력의 96%가 메인에 있으니, 모델을 낮추기 전에 쓰는 일을 메인에서 꺼내 워커로 넘기는 것이 먼저입니다.
Step 5. 몇 개가 동시에 돌았는가
병렬이 강의의 두 번째 이유였습니다. 응답 시각을 5분 단위로 묶고, 각 칸에서 응답한 메인 세션 수를 셌습니다. 서브에이전트의 응답은 부모 세션으로 셌습니다.
b = t.replace(minute=t.minute - t.minute % 5, second=0, microsecond=0)
buckets_main[b].add(parent_session_id)
dist = Counter(len(v) for v in buckets_main.values())
동시에 응답한 메인 세션 | 5분 칸 수 | 비율 |
|---|---|---|
1개 | 1,862 | 90.7% |
2개 | 174 | 8.5% |
3개 | 15 | 0.7% |
4개 | 1 | 0.05% (10/4 14:20) |
동시에 응답한 서브에이전트 | 5분 칸 수 |
|---|---|
1개 | 328 |
2~4개 | 135 |
5~9개 | 24 |
10개 이상 | 4 (최대 14개, 9/25 20:20) |
활동한 시간의 91%는 세션 하나였습니다. 여러 창을 띄워 놓는 것과 여러 창이 동시에 일하는 것은 달랐습니다. 병렬은 한 세션 안의 서브에이전트에서 일어났고, 그것도 서브에이전트가 활동한 5분 칸 491개 중 두 개 이상이 동시에 돈 것은 163개였습니다.
Step 6. 다른 회사 모델과 로컬 모델
강의는 GPT, Claude, Gemini, Grok을 한 오케스트레이터 아래 두는 것을 보여 줬습니다. 제 쪽의 흔적을 셌습니다.
find ~/.codex/sessions -name '*.jsonl' | cut -d/ -f6-8 | sort | uniq -c
grep -rhoE '"command":"[^"]{0,200}codex exec' ~/.claude/projects | wc -l
grep -rhoE '"command":"[^"]{0,200}(ollama run|localhost:11434)' ~/.claude/projects | wc -l
항목 | 값 |
|---|---|
코덱스 CLI | v0.157.0, 기본 모델 |
코덱스 세션 | 전체 54개, 같은 기간(8/24 이후) 8개 |
Claude 세션에서 | 6회, 세션 2개 |
Claude 세션에서 | 2회, 세션 1개 |
ollama 로컬 모델 | 4개 설치(2026-06-03). Claude 세션에서 호출 6회( |
같은 41일 동안 Claude 메인 세션이 26개, 코덱스 세션이 8개였고, Claude가 코덱스나 Gemini를 직접 부른 것은 8회였습니다. 교차 검토는 대부분 제가 창을 옮겨 다니며 했다는 뜻입니다. 강의의 "BEFORE, 내가 배차" 장면, "작업마다 모델을 고르고 옮기고 붙여넣는 교통정리 담당"이 제 모습이었습니다. 로컬 모델은 스터디장도 "느리고 맥북이 이륙하는 소리가 나서" 안 쓴다고 했는데, 제 16GB 맥에서도 설치 뒤 거의 부르지 않았습니다.
Step 7. 과제 실습: 같은 과제를 세 에이전트에 시키기
강의 실습은 같은 과제를 에이전트 여럿에 시켜 결과를 비교하는 것입니다. Orca와 Paseo는 설치하지 않고, 이 맥에 이미 있는 CLI 세 개로 대신했습니다. 과제는 작고 값싼 것으로 정했습니다. 문자열 목록의 중복을 제거하고 빈도를 세는 파이썬 함수(30줄 이내)와 테스트 3개입니다. 같은 프롬프트를 각 CLI에 한 번씩만 보냈고 재시도하지 않았습니다. 도구와 파일 쓰기를 막아 코드만 받았습니다.
claude -p --model sonnet --tools "" < prompt.txt
codex exec --sandbox read-only -o last.txt - < prompt.txt
gemini --approval-mode plan -p "$(cat prompt.txt)"
받은 코드를 파일로 저장해 pytest로 돌리고, 소요 시간은 time의 전체 시간으로 쟀습니다.
도구 | 모델 | 소요 시간 | 함수 줄 수 | 파일 줄 수 | 테스트 통과 |
|---|---|---|---|---|---|
| sonnet | 7.4초 | 10줄 | 33줄 | 3/3 |
| 기본 모델( | 18.5초 | 5줄 | 19줄 | 3/3 |
| 기본 모델 | 26.8초 | 5줄 | 18줄 | 3/3 |
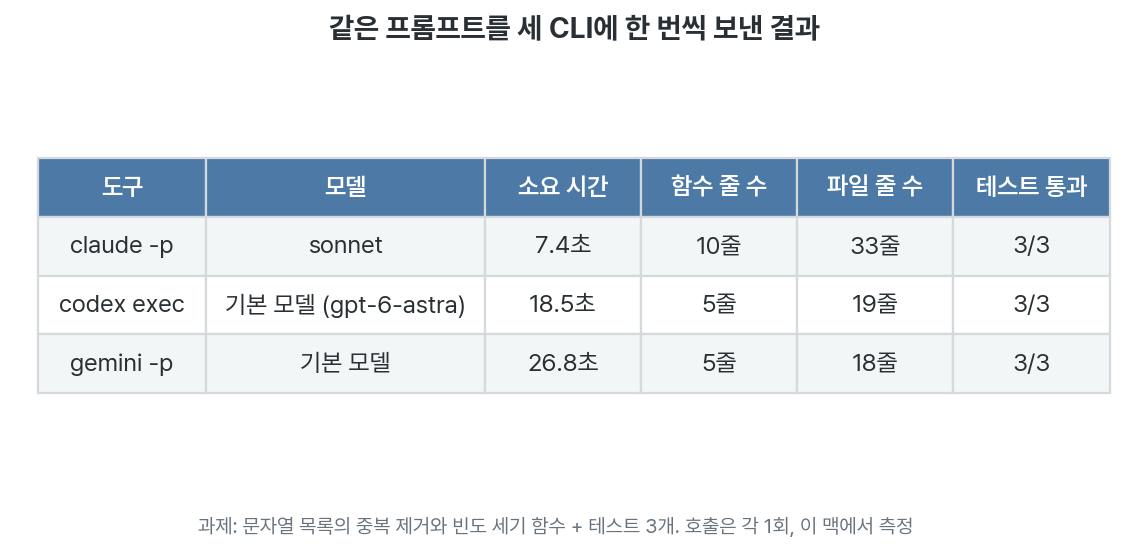
세 곳 모두 테스트를 전부 통과했고, 코드는 사실상 같았습니다. 딕셔너리에 get으로 세는 다섯 줄 구현이 둘이었고, Claude만 설명 문구와 Counter 대조 테스트를 더해 길어졌습니다. 같은 입력(["b","a","b","A",""])을 셋에 다시 넣어도 처음 나온 순서와 대소문자 구분이 모두 맞았습니다. 이렇게 작은 과제는 어느 모델이 풀어도 결과가 같아서, 비교로 얻은 정보는 정답 차이가 아니라 속도였습니다. 코덱스와 Gemini는 Claude보다 각각 2.5배, 3.6배 걸렸습니다.
막힌 곳은 두 군데였습니다. claude --tools ""는 뒤따르는 프롬프트 인자를 도구 목록으로 읽어 모델을 부르기 전에 실패해서, 프롬프트를 표준입력으로 넘겼습니다. Gemini는 신뢰하지 않은 폴더라는 이유로 처음에 모델 호출 없이 종료되어 --skip-trust를 붙였습니다. 두 번 다 모델에는 요청이 가지 않았으므로 호출은 각각 한 번입니다. 이 측정은 과제 하나에 실행 한 번이라 속도 차이를 일반화하지 않습니다.
결과와 배운 점
측정 결과
항목 | 값 |
|---|---|
응답 메시지 | 21,154건 (메인 26세션, 서브에이전트 237개, 41일) |
Opus 계열 메시지 비율 | 91.3% (Opus 5 81.2%, Opus 5.5 10.1%) |
Sonnet, Haiku 비율 | 1.7%, 0% |
서브에이전트가 부모와 같은 모델 | 218 / 237개 |
| 170 / 239회 |
메인 세션의 출력 토큰 비율 | 95.7% |
출력 토큰 API 환산 | $446.76 (추정, 출력만) |
서브에이전트를 전부 Sonnet으로 바꾼 절감 | $9.98, 2.2% (추정) |
세션 하나만 응답한 5분 칸 | 1,862 / 2,052 (90.7%) |
동시 메인 세션 최대 | 4개 |
동시 서브에이전트 최대 | 14개 |
Claude가 코덱스, Gemini를 직접 부른 횟수 | 8회 |
배운 점
제 메인 세션은 오케스트레이터이면서 실작업 워커였습니다. 서브에이전트에 일을 많이 나눈다고 생각했는데, 나눈 것은 읽기와 찾기였고 쓰기는 메인이 했습니다. 출력 토큰 96%가 그 증거입니다. 스터디장 CLAUDE.md의 "직접 코딩은 한 줄짜리 긴급 수정에만"과 정반대였습니다.
싼 모델로 바꾸는 것보다 일을 옮기는 것이 먼저입니다. 강의의 메시지를 "워커는 싼 모델"로만 들었으면 서브에이전트 모델만 낮추고 끝냈을지 모릅니다. 환산해 보니 그 효과는 2%에 그칩니다. 출력 단가가 6배라는 말의 무게는 누가 출력하느냐에 걸려 있었습니다.
창을 여러 개 띄워 둔 것과 병렬로 일한 것은 다릅니다. 체감으로는 늘 세션 서너 개를 돌리는데, 응답 시각으로 보면 91%가 하나였습니다. 나머지 창은 제 판단을 기다리고 있었습니다. 직렬로 묶어 둔 병목은 제 판단이었습니다.
모델 라우팅은 직접 정해야 한다는 말이 맞았습니다. 서브에이전트 239회 중 170회를 모델 지정 없이 불렀고, 그러면 부모의 Opus를 그대로 물려받습니다. 스터디장이 "모델에게 알아서 골라 쓰라고 하면 잘 모른다"고 한 것이 설정에서도 그대로였습니다. 정하지 않으면 가장 비싼 기본값으로 흘러갑니다.
시행착오
처음에는 메시지 줄을 그대로 세서 같은 응답이 여러 줄로 기록된 것을 중복으로 셌습니다. 메시지 id와 요청 id로 묶어 21,154건이 됐습니다.
메시지 수로 보면 서브에이전트가 38%라 "꽤 위임하고 있다"고 적을 뻔했습니다. 출력 토큰으로 다시 세니 4.3%였습니다. 강의가 짚은 것은 출력이었습니다.
동시성을 세션의 시작과 끝으로 재면 켜 두고 잊은 세션까지 겹쳐 동시 세션이 부풀려집니다. 응답이 있었던 5분 칸만 세는 방식으로 바꿨습니다.
1.2GB를 두 번 훑는 데 각각 10분 넘게 걸렸습니다. 두 번째 집계(Step 3)는 중복 제거 순서가 달라 서브에이전트 메시지가 3건 많은 8,143건으로 나왔고, 출력 토큰 합계는 25개 차이가 났습니다. 표마다 나온 값을 그대로 적었습니다. 다음 측정은 한 번에 끝나도록 스크립트를 합칠 계획입니다.
이 측정은 2026년 10월 4일 이 맥의 ~/.claude/projects 아래 세션 로그 266개(메인 26, 서브에이전트 237, 2026-08-24부터 10-04까지)의 응답 메시지 21,154건과, ~/.codex, ~/.ollama, ~/.claude/agents 설정을 Python과 셸로 센 결과입니다. 대화 내용은 읽지 않았고, 다른 기기와 앱 안의 대화는 범위 밖입니다. 금액은 공개 API 단가로 출력 토큰만 환산한 추정입니다.
도움 받은 글 (옵션)
24기 멀티에이전트 1주차 강의 (진형, 어른아이): 오케스트레이터와 워커의 모델 배분, 입력과 출력 토큰의 단가 차이, 리서치는 싼 모델 병렬, 반복 업무는 스킬로 만든 뒤 싼 모델, "배차까지 지휘자에게" 장면, 게임 프로젝트 CLAUDE.md의 역할 분담 절
24기 나만의AI팀 1주차 사례글 (본인): 같은 로그에서 검수 에이전트 호출과 메인의 직접 수정 횟수를 센 글. 이번에는 횟수가 아니라 모델과 토큰과 시각을 셌습니다
Claude API 공개 단가표 (Anthropic, 2026-09-25 기준): 출력 토큰 환산에 쓴 단가
로그인하고 댓글을 남겨 주세요

오 너무 유익하네요! 저는 그냥 프롬프트에다가 너가 판단하고 다른 모델에게 위임해,,, 이게 무적인 줄 알고 이렇게 쓰고 있었는데.. 안일했네요, 마찬가지로 제가 사용하던 친구도 실작업을 몰아서 했을 것 같다고 느껴집니다! 저도 전체 검산하는 작업이 필요할 것 같네요,,,!

안녕하세요, Fri-mer님! "서브에이전트에 일을 많이 나눈다고 생각했는데 나눈 것은 읽기와 찾기였고 쓰기는 메인이 했다"는 대목이 가장 인상 깊었어요. 메시지 수로는 38%라 위임을 꽤 한 것처럼 보이는데, 출력 토큰으로 다시 세니 4.3%였다는 반전이 강의의 "출력 단가" 기준을 정확히 짚어줘요.
서브에이전트 모델만 Sonnet으로 낮춰도 효과가 2%에 그친다는 환산, 그리고 세션 창을 서너 개 띄워도 응답 시각으로는 91%가 하나였다는 확인도 설득력 있었어요. 중복 제거 순서 때문에 두 번째 집계에서 3건·토큰 25개가 어긋난 것까지 표마다 나온 값 그대로 적어주신 점이 믿음이 갔어요.
꼬리 탁! 치고 다음 측정 결과도 기다릴게요 🐈⬛

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
[정정] 이 글의 메인 세션 출력 비중(95%대)은 집계 오류였습니다. 응답 하나가 로그 여러 줄에 나뉘어 저장되는데 첫 줄 값만 세서 서브에이전트 출력을 약 10배 적게 셌습니다. 고친 값은 70% 안팎이고, 원인과 다시 잰 값은 3주차 글에 적었습니다. https://www.gpters.org/nocode/post/create-script-measure-subagent-CP0NiXPXfQhXEBS