서브에이전트 모델 지정 규칙 적용 전후의 로그 비교
2026.10.15
소개
1주차 뒤에 적용한 개선 세 가지(에이전트 정의 4개의 model: sonnet, 전역 규칙 agent-routing.md, 재측정 스크립트)가 실제 세션 로그에서 어떤 값으로 나오는지, 1주차와 같은 스크립트로 다시 재서 기준값과 나란히 놓았습니다. 서브에이전트 모델을 낮추라는 말을 규칙 문서로 적어 두기만 하고 지켜지는지는 확인하지 않은 분께 도움이 될 것 같습니다.
2주차는 수강생 아홉 명의 사례 발표와 스터디장의 Orca 지식 공유로 채워졌습니다. 지식 공유에서 스터디장은 가장 좋은 비싼 모델을 오케스트레이터로 두고, 사용자는 일을 누가 맡을지 워커만 정해 주면 된다고 했습니다. 이 역할 분담은 프로젝트 폴더의 agent.md에 지침으로 적어 둘 수 있습니다. 예로 든 문구는 백엔드와 로직은 Codex가, 프런트엔드 디자인은 Opus가 맡도록 하는 것이었습니다. Orca 안의 에이전트는 자기가 Orca에서 돌고 있다는 사실을 모르기 때문에 "Orca로 띄워라"를 요청에 적거나 agent.md에 규칙으로 넣어야 한다는 설명도 있었습니다. 비용에 대해서는 오케스트레이터가 비싼 만큼 조금 더 들 수 있으나 그 모델이 일까지 다 하는 것보다는 사용량 면에서 이득이었다는 경험담이었고, 수치는 나오지 않았습니다. 자막과 채팅에서 새 과제 안내는 확인되지 않았고, 이번 주 발표 자체가 1주차 사례글을 발표하는 시간이었습니다.
저는 청강생입니다. 1주차 사례글에서 제 Claude Code 세션 로그의 출력 토큰 95.7%를 메인 세션이 냈고 서브에이전트 호출의 71%(239회 중 170회)가 모델을 지정하지 않았다는 것을 확인한 뒤, 정의 파일과 전역 규칙을 고치고 측정 스크립트를 남겼습니다. 이번 글은 그 개선 뒤의 값을 같은 스크립트로 재서 비교한 기록입니다. 측정은 2026-10-14에 했고, 로그와 정의 파일과 규칙 파일은 읽기만 했습니다. Orca와 Paseo는 이번에도 설치하지 않았습니다.
진행 방법
사용 도구: Claude Code, Python 3, 셸 명령
Step 1. 2주차 기준을 잴 항목표
발표와 지식 공유에서 로그로 셀 수 있는 것만 골랐습니다.
기준 | 2주차에서 나온 내용 | 잴 것 |
|---|---|---|
오케스트레이터는 가장 좋은 모델, 워커는 낮은 모델 | 비싼 모델은 프롬프트 작성과 배분을 맡고 일은 워커가 한다. 품질은 오르고 사용량은 줄었다는 경험담 | 서브에이전트 호출의 모델 지정 비율, 서브에이전트가 쓴 모델, 메인의 출력 토큰 비율 |
역할 분담을 지침 파일로 고정 |
| 에이전트 정의의 |
작성 에이전트와 검토 에이전트를 나눔 | 류양환 님과 어른아이J 님이 구현과 검토를 다른 에이전트에 맡겼고, 합의가 아니라 재현 가능한 시험 결과를 완료 근거로 삼았다 | 이번 글에서는 재지 않음. 호출 유형별 수만 확인 |
환경을 먼저 통일 | 킹슈민 님과 캘리별 님은 막힌 곳이 도구가 아니라 Git과 WSL 환경이었다 | 이번 글에서는 재지 않음 |
Step 2. 개선 세 가지가 파일로 남아 있는지 확인
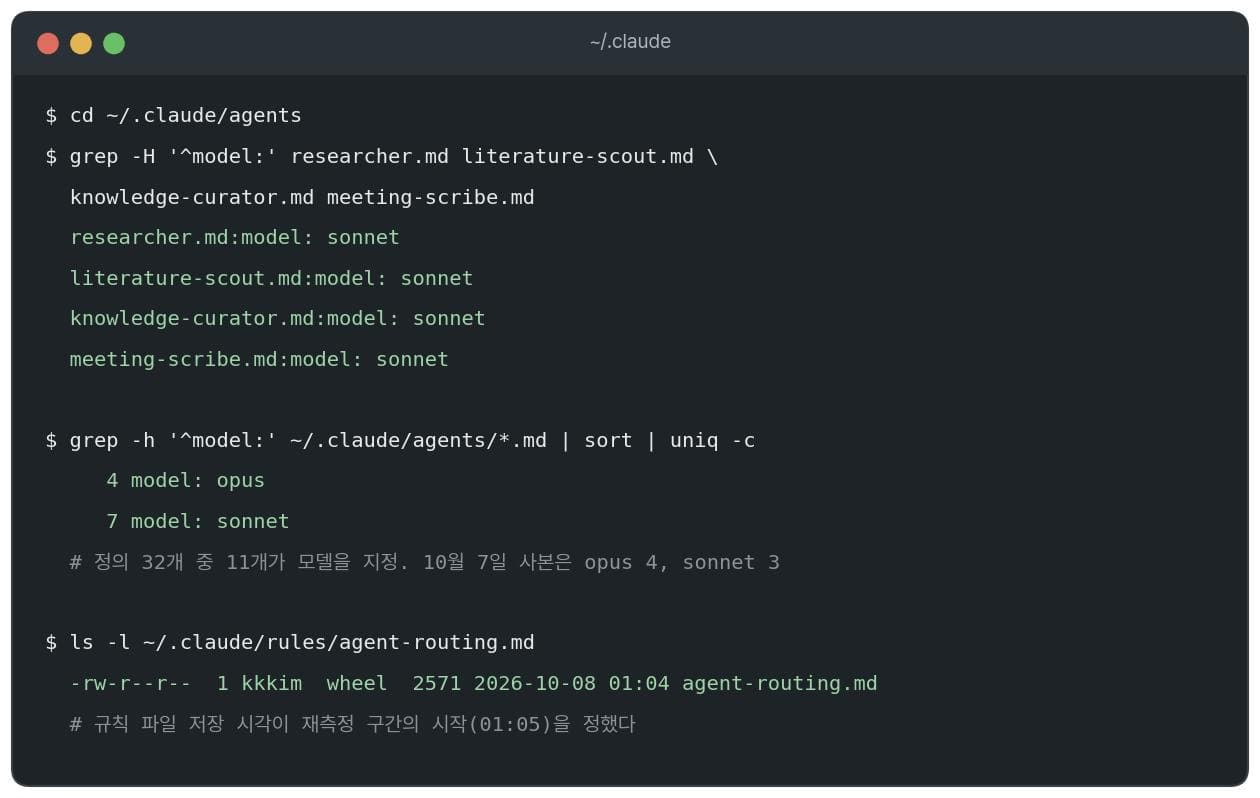
세 가지가 지금도 그대로 있는지부터 확인했습니다. 정의 파일의 model 줄은 10월 7일에 떠 둔 사본과 지금 것을 같은 명령으로 비교했습니다.
cd ~/.claude/agents
grep -H '^model:' researcher.md literature-scout.md knowledge-curator.md meeting-scribe.md
grep -h '^model:' ~/.claude/agents/*.md | sort | uniq -c
ls -l ~/.claude/rules/agent-routing.md
정의 4개는 모두 model: sonnet입니다. 10월 7일 사본에서는 네 개 모두 model 줄이 없었고, 정의 32개 중 모델을 지정한 것은 7개(opus 4, sonnet 3)였습니다. 지금은 11개(opus 4, sonnet 7)입니다. 규칙 파일은 10월 8일 01시 04분에 저장되었습니다. 내장 에이전트 Explore는 정의 파일이 없어서 호출할 때 model을 적어야 하고, 규칙 파일이 그 점을 안내합니다. 규칙 파일의 임계값 세 가지(코드 약 150줄, 글 약 2,000자, 수정 약 50줄)는 측정으로 정한 값이 아니라 추정입니다.
Step 3. 재측정 구간과 명령
세 가지가 모두 갖춰진 시각은 규칙 파일을 저장한 10월 8일 01시 04분입니다. 그 직후인 01시 05분부터 재측정 시각(10월 14일 00시 12분)까지를 이후 구간으로 잡았습니다. 스크립트의 --since와 --until은 UTC 기준이라 한국 시각에서 9시간을 뺀 값을 넣었습니다.
cd ~/Documents/Study/GPTers/24기/_tools
python3 measure_agent_routing.py --since 2026-10-07T16:05:00 --out 재측정_20261008이후.json
python3 measure_agent_routing.py --until 2026-10-07T14:10:00 --out 재측정_기준구간_20261007까지.json
항목 | 값 |
|---|---|
대상 | 이 맥의 |
이후 구간 | 2026-10-08 01:05 ~ 10-14 00:12 KST, 응답 메시지 6,956건(메인 3,764, 서브에이전트 3,192), Agent 호출 145회 |
비교할 기준값 | 1주차 뒤인 10월 7일 23시 10분에 저장한 값. 응답 메시지 24,146건, Agent 호출 264회 |
읽은 것 | 모델 이름, 출력 토큰, 시각, Agent 호출의 |
두 번째 명령은 기준값을 지금 다시 만들어 본 것입니다. 이유는 Step 4에서 설명합니다.
Step 4. 기준값과 재측정값 비교
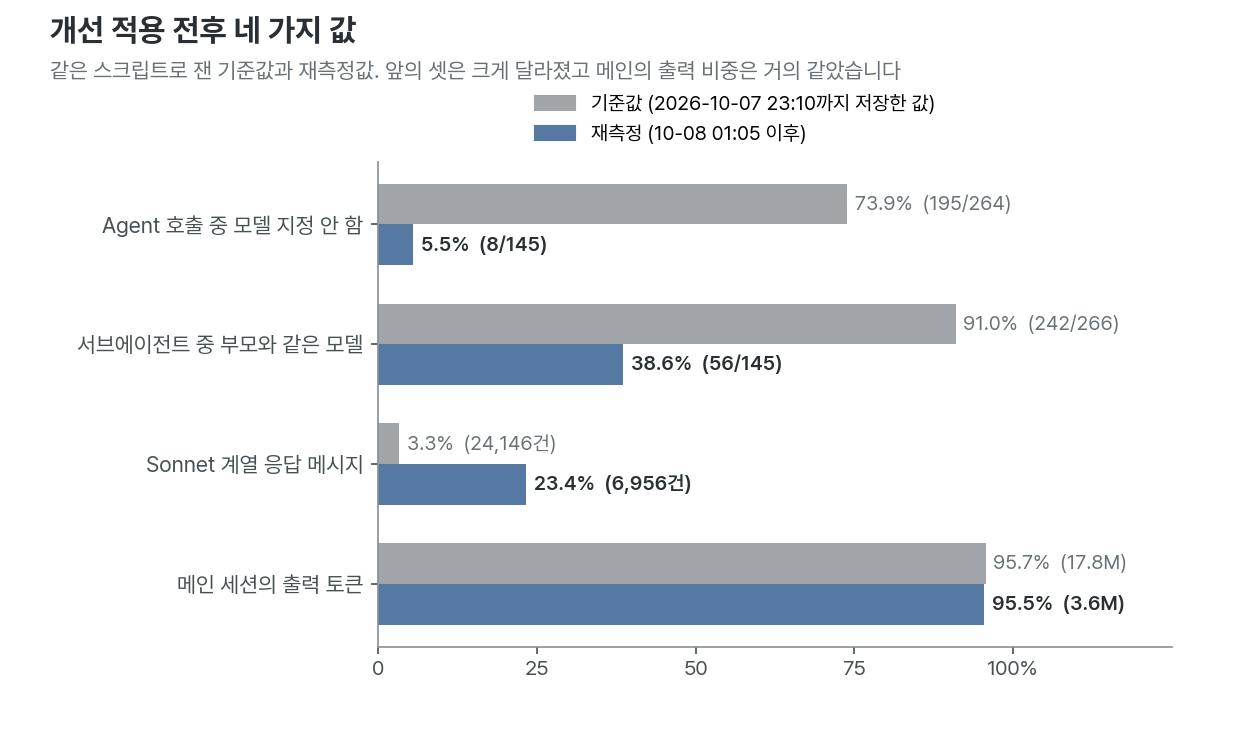
네 값을 같은 스크립트가 낸 JSON에서 읽어 나란히 놓았습니다.
python3 -c "import json;d=json.load(open('재측정_20261008이후.json'));print(d['agent_calls'], d['agent_model_arg'], d['main_output_share'], d['sonnet_haiku_msg_share'], d['sub_same_model_as_parent'])"
# 145 {'sonnet': 83, 'opus': 54, '(지정 안 함)': 8} 0.9546 0.2336 [56, 145]
항목 | 기준값(10월 7일 23시까지) | 재측정(10월 8일 01시 이후) |
|---|---|---|
| 264회 | 145회 |
모델 지정 안 함 | 195회 (73.9%) | 8회 (5.5%) |
| 9회 | 83회 |
| 60회 | 54회 |
서브에이전트가 부모와 같은 모델 | 242 / 266 (91.0%) | 56 / 145 (38.6%) |
Sonnet 계열 응답 메시지 | 3.31% | 23.36% |
메인 세션의 출력 토큰 | 95.69% | 95.46% |
서브에이전트의 출력 토큰 | 4.31% | 4.54% |
앞의 셋은 크게 달라졌고 메인 세션의 출력 비중은 0.2%p 낮아지는 데 그쳤습니다. 비교에는 한 가지 단서가 있습니다. 기준값을 지금 같은 구간으로 다시 만들면(두 번째 명령) 응답 메시지 23,559건, Agent 호출 245회로 저장한 값보다 적습니다. 그사이 로그 일부가 디스크에서 사라진 것으로 보이는데 원인은 확인하지 못했습니다. 비율은 거의 그대로여서(모델 미지정 74.3%, 부모와 같은 모델 92.7%, Sonnet 메시지 3.26%, 메인 출력 95.64%) 비교에는 저장한 기준값을 그대로 썼지만, sonnet 지정은 저장값 9회가 다시 만든 값에서는 3회라서 이 한 칸은 신뢰도가 낮습니다.
Step 5. 모델이 지정된 호출의 유형
달라진 것이 정의 파일 덕인지 호출할 때 적은 인자 덕인지 갈라 보려고, 이후 구간의 Agent 호출을 유형(subagent_type)별로 나눠 model 인자를 셌습니다. 서브에이전트 기록 옆의 meta.json에 있는 agentType을 쓰는 보조 스크립트(24기멀티에이전트_2주차_측정.py)로 집계했습니다.
/opt/anaconda3/envs/rag/bin/python3 -I 24기멀티에이전트_2주차_측정.py
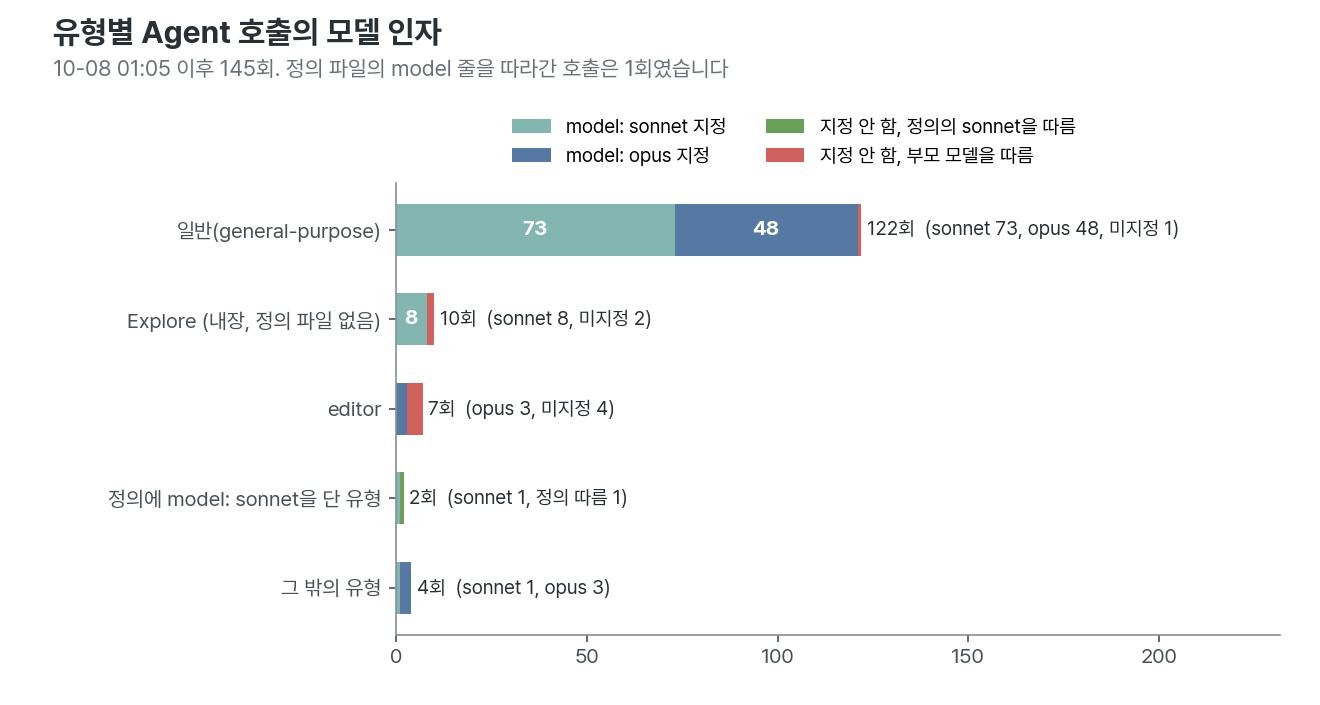
Agent 호출의 84%(122회)가 일반 유형이었고, 이 가운데 73회에 sonnet을 적었습니다. 정의 4개에 model: sonnet을 넣었지만 이후 구간에 그 유형을 부른 것은 researcher 1회와 knowledge-curator 1회뿐이었습니다. knowledge-curator는 호출할 때 sonnet도 같이 적었고, 인자 없이 불러 정의의 sonnet을 따라간 것은 researcher 1회입니다. 정의 수정은 제 호출 패턴에서는 거의 쓰이지 않은 길이었고, 달라진 값의 대부분은 호출 때 model을 적은 데서 나왔습니다. 1주차 계획에서 말한 researcher는 이전 구간 25회(미지정 15, opus 7, sonnet 3)에서 이후 1회로 줄었습니다. Explore는 이전 13회가 모두 미지정이었고 이후는 10회 중 8회에 sonnet을 적었습니다. 지정을 빠뜨린 8회는 Explore 2회, editor 4회, 일반 유형 1회, researcher 1회입니다(researcher는 정의가 sonnet).
Step 6. 날짜별 호출 추이
규칙 저장 시각을 기준으로 앞뒤가 갈리는지 날짜별로 보았습니다. 날짜는 한국 시각입니다.
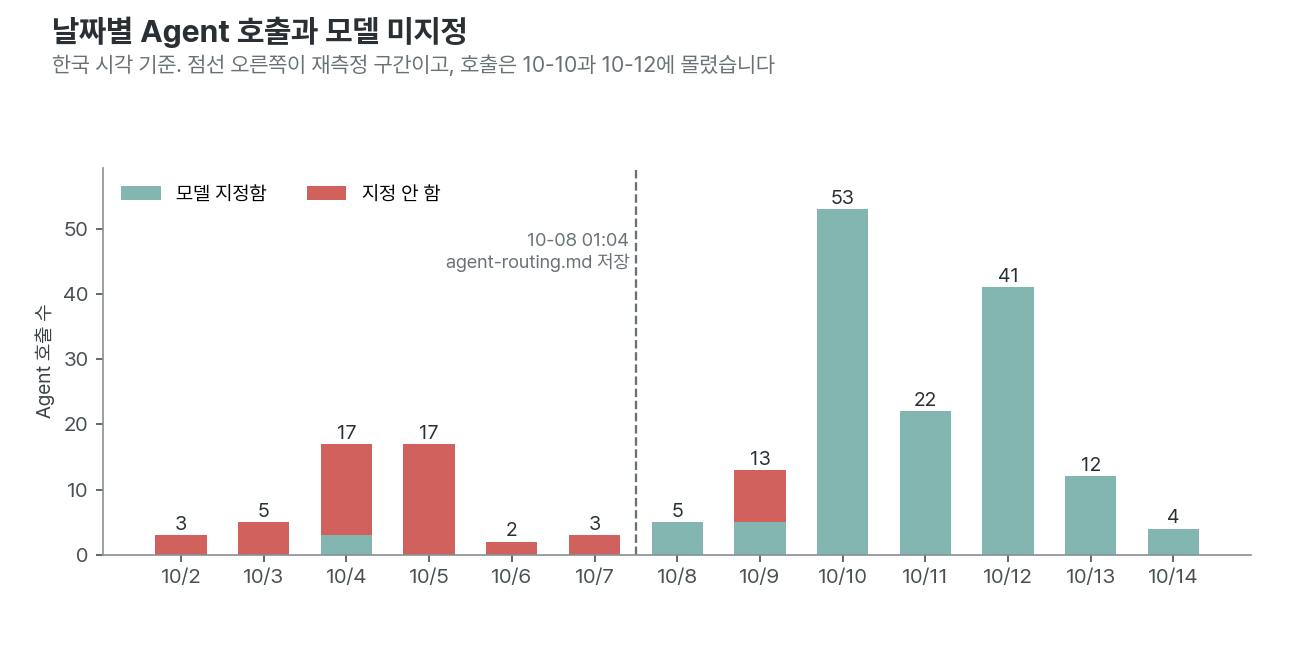
멀10월 4일과 5일에 17회씩 부르면서 미지정이 14회와 17회였던 것이 이전 구간의 모습입니다. 이후에는 10월 9일에 13회 중 8회가 미지정이었고, 10월 10일부터 14일까지는 한 번도 빠뜨리지 않았습니다. 10월 9일의 8회는 Explore 2회, editor 4회, researcher 1회, 일반 유형 1회였습니다. 호출 수가 10월 10일 53회와 12일 41회에 몰려 있어 이 값을 평소 작업의 값으로 읽기는 어렵습니다. 이후 145회 가운데 128회(88%)가 10월 10일부터 13일 사이입니다. 서브에이전트 기록의 작업 설명(제목)에 "사례글", "강의정리", "주차"가 들어간 개수만 세어 보니, 이후 145개 중 30개(21%)가 문서 작성 일이었고 이전 255개 중에는 22개(9%)였습니다. 이 집계에는 이 글을 쓰는 세션의 호출도 들어 있습니다.
Step 7. 출력 토큰과 서브에이전트 모델의 구성
1주차에서 가장 크게 나왔던 값이 메인의 출력 토큰 95.7%였습니다. 모델 지정은 서브에이전트 쪽 조치이고, 메인의 출력을 줄이는 장치는 긴 산출물을 위임한다는 규칙입니다. 두 값을 나란히 보았습니다.
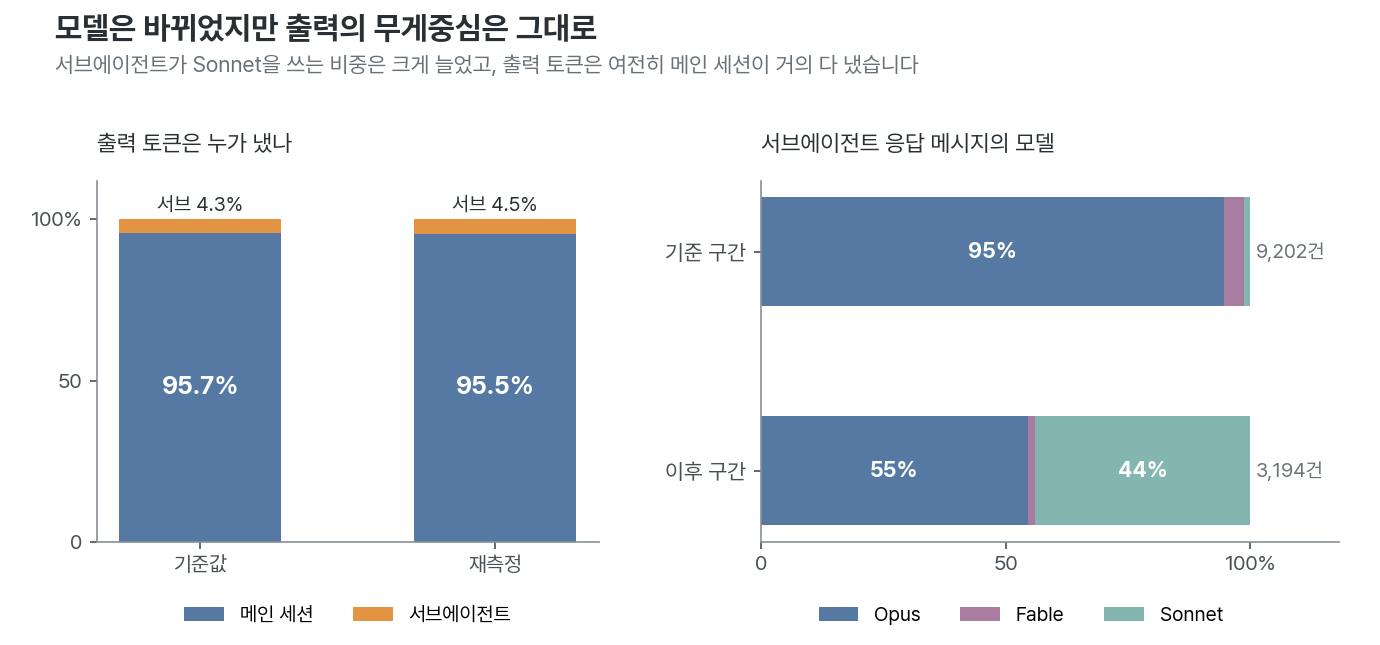
서브에이전트 응답 메시지 안에서 Sonnet의 비중은 1.4%(9,202건 중 126건)에서 44.1%(3,194건 중 1,408건)로 올랐습니다. 반면 출력 토큰은 메인이 95.5%를 내서 1주차의 95.7%와 사실상 같습니다. 1주차에서 서브에이전트를 전부 Sonnet으로 바꿔도 출력 환산 금액이 2.2%만 줄어든다고 계산했는데, 서브에이전트의 출력 토큰 비중이 4.3%에서 4.5%로 머문 이번 값과 앞뒤가 맞습니다. 이번 글에서는 금액을 새로 환산하지 않았습니다. 이후 구간에 많이 나온 Sonnet 5.5가 1주차에 쓴 출력 단가표에 없기 때문입니다.
Step 8. 1주차 계획 네 항목의 실행 여부
1주차에 적어 둔 다음 주 계획 네 항목을 정의 파일, 로그, 설치 목록으로 확인했습니다.
ls /Applications | grep -i -E 'orca|paseo'; command -v orca paseo; brew list --cask | grep -i -E 'orca|paseo'
# 세 명령 모두 출력 없음
1주차 계획 | 확인 결과 |
|---|---|
| 실행. 정의 4개에 |
긴 산출물은 서브에이전트에 맡기고 메인은 검토 | 규칙은 적용(전역, 10월 8일 01시 04분). 재측정 숫자인 메인의 출력 비중은 95.7%에서 95.5%로 변화 없음 |
Orca나 Paseo에 Claude Code와 코덱스를 붙여 보기 | 설치하지 않음. Claude 세션의 |
같은 스크립트로 10월 11일에 다시 재고 4주차 기준표의 첫 줄로 쓰기 | 10월 11일에는 재지 않았고 10월 14일에 쟀다. 기준표는 4주차에 만든다 |
결과와 배운 점
측정 결과 (2026-10-14 00시 12분 기준, ~/.claude/projects jsonl 450개, 이후 구간은 2026-10-08 01:05부터)
항목 | 값 |
|---|---|
에이전트 정의의 | 7개에서 11개로 늘어남 (정의 32개 중) |
| 195 / 264회 (73.9%)에서 8 / 145회 (5.5%)로 |
서브에이전트가 부모와 같은 모델 | 242 / 266 (91.0%)에서 56 / 145 (38.6%)로 |
서브에이전트 응답 메시지 중 Sonnet | 1.4%에서 44.1%로 |
메인 세션의 출력 토큰 | 95.69%에서 95.46%로 |
정의의 | 이후 145회 중 1회 |
배운 점
호출 때 모델을 적게 하는 규칙은 로그에서 확인되는 값으로 나타났습니다. 모델 미지정 비율이 73.9%에서 5.5%로 내려갔고, 서브에이전트 응답 메시지의 44.1%가 Sonnet이 되었습니다. 다만 규칙 때문인지는 이번 측정으로 가를 수 없습니다. 이후 구간에는 대조할 구간이 없고, 호출의 88%가 문서 작성 작업이 많았던 나흘에 몰려 있으며, 이 측정에는 이 글을 쓰는 세션도 들어 있습니다. 이번 글은 규칙 이후 값이 이렇게 나왔다는 기록으로 남깁니다.
정의 파일의
model줄은 가장 손쉬운 조치였지만 제 호출에서는 거의 쓰이지 않았습니다. 정의가sonnet이라 인자 없이 불러도sonnet으로 도는 호출은 이후 145회 중 1회였습니다. 제 서브에이전트 호출은 대부분 일반 유형이어서, 정의 파일보다 호출 때 적는 인자와 전역 규칙이 값을 좌우했습니다. 정의를 고칠지 규칙을 쓸지 정할 때 어떤 유형을 가장 많이 부르는지부터 세어 보는 것이 순서입니다.모델을 낮춰도 메인의 출력은 그대로였습니다. 1주차에서 "모델을 낮추기 전에 쓰는 일을 메인에서 꺼내는 것이 먼저"라고 적었는데, 이번에 위임 규칙까지 적용한 뒤에도 메인의 출력 비중은 95.5%였습니다. 규칙 문장만으로 위임의 양은 움직이지 않았다는 값입니다. 스터디장이 말한 "오케스트레이터는 프롬프트만 쓰고 워커가 일한다"는 구조에는 아직 못 미칩니다.
저장한 기준값은 다시 만들 수 있는지 확인해야 했습니다. 같은 구간을 다시 재니 응답 메시지가 24,146건에서 23,559건으로, Agent 호출이 264회에서 245회로 줄어 있었습니다. 세션 로그는 시간이 지나면 일부가 사라질 수 있어, 비교는 저장한 값을 쓰되 비율로만 읽었습니다. 다음 측정부터는 구간 JSON을 그 시점에 저장해 두고 이전 구간을 다시 만들지 않으려고 합니다.
시행착오
재측정 스크립트의 첫 판은 Agent 호출을 23회로 세었습니다(실제 239회). 사례글 구간을 재현해 값이 맞는지 확인하고서야 알아챘고, 그 재현값을 따로 저장해 두었습니다.
--since에 날짜만 적으면 UTC 자정, 즉 한국 시각 오전 9시가 경계가 됩니다. 규칙 저장 시각(01시 04분) 뒤부터 재려고 시각까지 적어 넣었습니다.규칙 파일의 임계값 150줄, 2,000자, 50줄은 측정이 아니라 제 추정입니다. 이후 구간에서 이 임계값을 넘는 산출물 중 위임된 비율은 재지 않았습니다.
서브에이전트가 부모와 같은 모델인 비율은 분모가 서로 다릅니다(266개와 145개). 두 구간의 서브에이전트 수가 달라서 비율만 비교했습니다.
이 측정은 2026년 10월 14일 이 맥의 ~/.claude/projects 아래 jsonl 450개 가운데 2026-10-08 01:05부터 10-14 00:12까지의 응답 메시지 6,956건과 Agent 호출 145회, ~/.claude/agents의 정의 32개와 ~/.claude/rules/agent-routing.md를 Python과 셸로 센 결과입니다. 기준값은 10월 7일 23시 10분에 같은 스크립트로 저장한 값(응답 메시지 24,146건, Agent 호출 264회)입니다. 대화 내용은 읽지 않았고, 다른 기기와 앱 안의 대화는 범위 밖입니다. 이후 구간은 엿새 남짓이고 대조 구간이 없어서 규칙의 효과를 단정하지 않습니다.
도움 받은 글 (옵션)
24기 멀티에이전트 2주차 강의 (진형 스터디장): 오케스트레이터는 가장 좋은 모델에 두고 워커만 정한다는 설명,
agent.md에 Orca 사용과 역할 분담(백엔드 Codex, 프런트엔드 Opus)을 적어 두는 방법, 에이전트는 자신이 Orca 안에서 도는지 모르므로 명시해야 한다는 설명24기 멀티에이전트 2주차 사례 발표: 류양환 님의 작성 에이전트와 검토 에이전트 분리, 어른아이J 님의 "모델의 동의가 아니라 재현 가능한 시험 결과를 완료 근거로" 원칙, 킹슈민 님과 캘리별 님의 Git과 WSL 환경 막힘
지피터스 뽀짝이 요약본: 발표 내용의 이름과 도구명 확인
24기 멀티에이전트 1주차 사례글 (본인): 기준값과 측정 스크립트의 출처

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
[정정] 이 글의 메인 세션 출력 비중(95%대)은 집계 오류였습니다. 응답 하나가 로그 여러 줄에 나뉘어 저장되는데 첫 줄 값만 세서 서브에이전트 출력을 약 10배 적게 셌습니다. 고친 값은 70% 안팎이고, 원인과 다시 잰 값은 3주차 글에 적었습니다. https://www.gpters.org/nocode/post/create-script-measure-subagent-CP0NiXPXfQhXEBS