비개발자와 AI가 세 도교 연구자료를 하나의 Research Library로 만든 과정(Stage2)
2026.08.13
안녕하세요. 노브(nomadmeve)입니다.
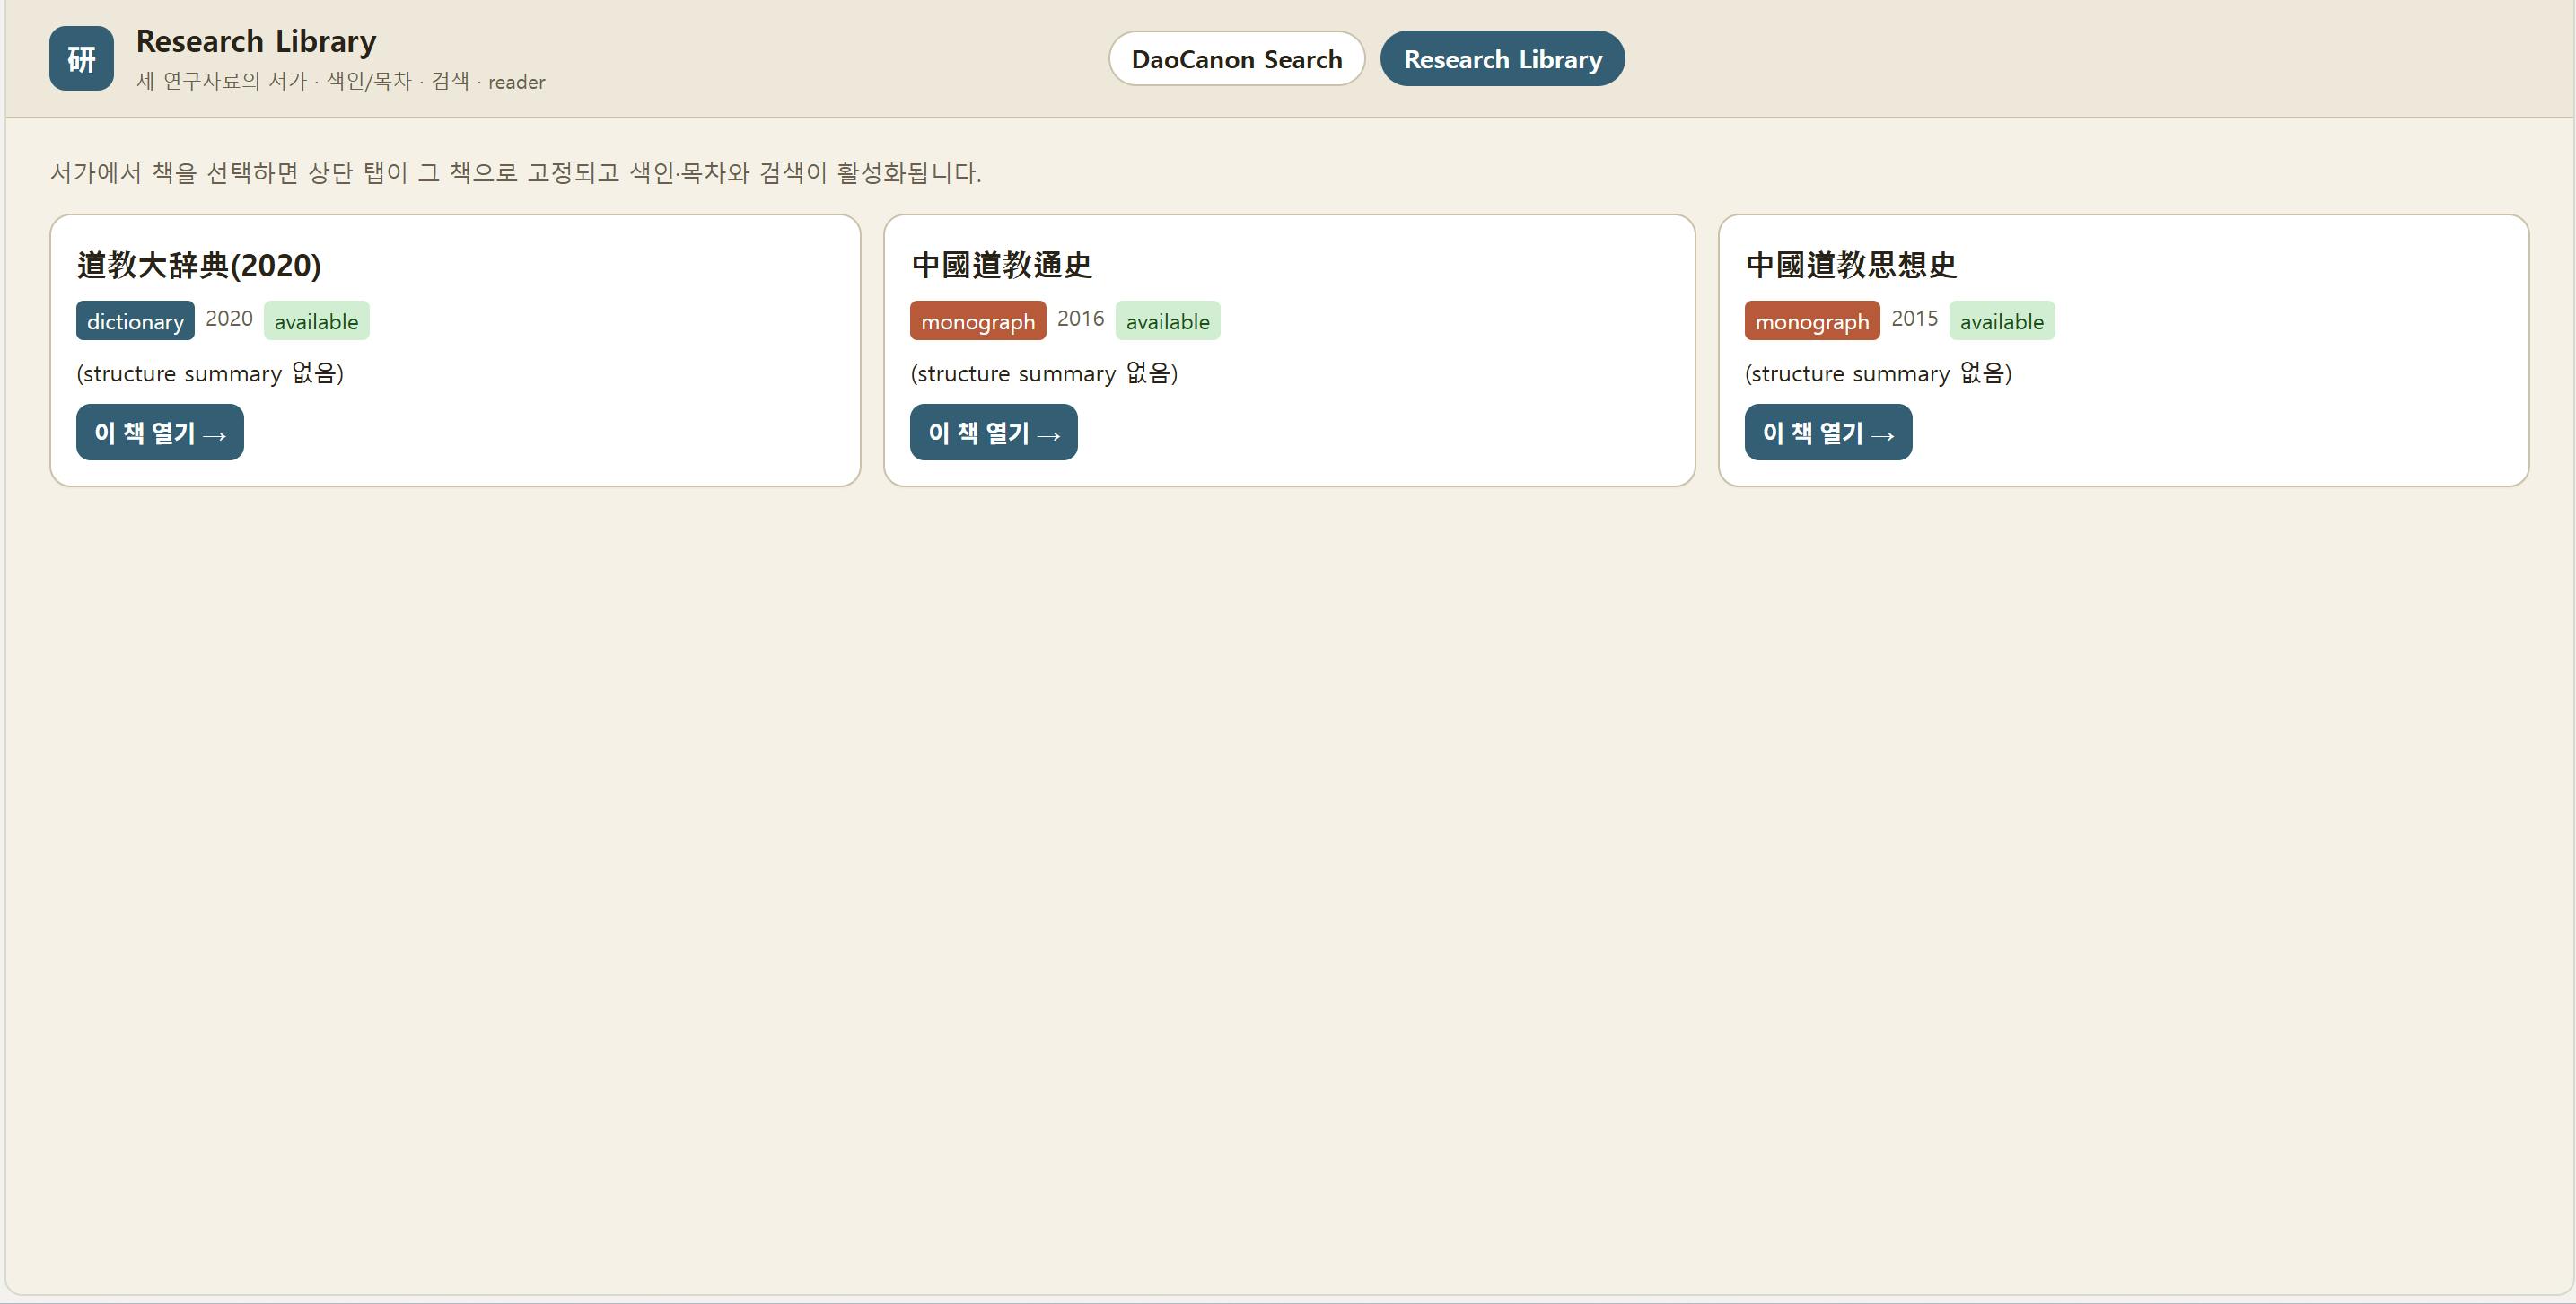
앞선 DaoCanon 1단계에서는 도장 원문을 경전명·저자·본문으로 찾고, 검색 결과에서 실제 원문 행으로 돌아가는 도구를 만들었습니다. 원문 검색이 가능해지자 다음 질문이 생겼습니다. 도교대사전, 중국도교통사, 중국도교사상사처럼 성격이 서로 다른 연구자료도 한곳에서 읽고 찾을 수 있을까?
이번 글은 그 질문에서 출발한 DaoCanon 제2단계 기록입니다. 핵심은 자료를 AI에게 바로 요약하게 하는 데 있지 않았습니다. 먼저 세 자료가 가진 고유한 구조를 보존한 채, 검색 결과에서 실제 항목과 문단으로 돌아갈 수 있는 Research Library를 만드는 일이었습니다.
📝 한줄 요약
비개발자가 AI와 대화하며 도교대사전·중국도교통사·중국도교사상사 세 자료를 하나의 연구자료실에서 탐색·검색·Reader로 읽을 수 있게 만들었습니다. 다만 자료를 억지로 같은 형식으로 맞추지 않고, 사전은 표제어 중심으로, 연구서는 권·편·장·절과 실제 문단 중심으로 읽게 했습니다.
바쁘시면 이것만 읽어도 돼요:
원문 검색 1단계를 바꾸지 않고, 별도 Research API와 Research Web을 덧붙였습니다.
사전과 연구서를 한 종류의 검색 결과로 평평하게 만들지 않았습니다.
검색 결과가 있다는 것에 그치지 않고, 검색어가 실제로 있는 문단을 Reader에서 바로 보이게 했습니다.
자료 구조가 이상한 것은 화면에서 임시로 가리지 않고, 원자료를 살펴보고 source metadata를 바로잡았습니다.
🎯 이런 분들께 도움돼요
여러 종류의 인문학 자료를 한 연구 환경에서 활용하고 싶은 분
AI와 대화하면서도 원문·출처·페이지·문단 위치를 놓치고 싶지 않은 분
비개발자가 검색·Reader 같은 연구 도구를 직접 기획하고 검증해 보고 싶은 분
“검색이 된다”와 “찾은 곳이 화면에 바로 보인다”의 차이가 궁금한 분
AI가 만든 화면을 직접 사용하며 고쳐 가는 과정을 알고 싶은 분
😫 문제 상황 — 자료는 늘었는데, 한 방식으로 읽을 수는 없었다
1단계 DaoCanon은 도장 원문을 찾는 도구였습니다. 그런데 연구에 실제로 활용하려면 원문만으로는 부족했습니다. 표제어를 빠르게 확인하는 도교대사전, 시대와 논의를 따라 읽는 중국도교통사와 중국도교사상사도 함께 오가야 했습니다.
처음에는 “자료를 더 넣고 검색창 하나를 늘리면 되지 않을까?”라고 생각할 수 있습니다. 하지만 세 자료는 읽는 단위부터 달랐습니다.
도교대사전
→ 분류 → 하위 분류 → 표제어 → 항목

중국도교통사
→ 권 → 장 → 절 → 본문 문단

중국도교사상사
→ 권 → 편 → 장 → 절 → 본문 문단
사전의 표제어와 연구서의 긴 논의를 같은 방식으로 취급하면, 둘 다 읽기 어려워집니다. 그래서 AI와의 대화도 “검색 기능을 더하자”에서 멈추지 않고, 각 자료를 어떻게 탐색하고 어디까지 되돌아가야 하는가를 먼저 정하는 과정이 되었습니다.
제가 초기에 범위를 이렇게 정했습니다.
우선 3종(도교대사전, 통사/사상사)으로 시작하자구나.이 한 문장이 중요했습니다. 모든 참고문헌과 AI 대화 기능까지 한꺼번에 넣는 대신, 성격이 다른 세 자료가 실제로 잘 읽히는지를 먼저 확인하는 범위가 생겼기 때문입니다.
🛠️ 함께 사용한 도구
AI 에이전트: Hermes Agent의 Pulses
구현·검증 협업: 구현 worker, Codex, 독립 AI review lane
서버와 화면: JavaScript / Node.js 기반 Research API와 Research Web
연구자료: 읽기 전용 도교대사전·중국도교통사·중국도교사상사 corpus
검증: 자동 테스트, 실제 브라우저, 공개 인증 화면, 독립 검토
여기서 AI는 결과를 한 번에 만들어 주는 버튼이 아니었습니다. Pulses가 자료 구조와 구현 범위를 나누고, 구현 worker의 결과를 테스트·브라우저로 다시 확인했습니다. 저는 실제 화면을 읽다가 이상한 구조와 불편한 동작을 발견하면 그대로 전달했습니다.
🔧 작업 과정
1. “자료를 더 넣기” 전에, 자료마다 다른 읽는 단위를 지켰다
Research Library의 첫 결정은 backend를 하나로 합치는 것이 아니었습니다. 기존 DaoCanon Search는 그대로 보존하고, 연구자료 전용 API와 Web을 별도로 만들었습니다.
기존 DaoCanon Search
→ 도장 원문 검색과 Reader를 계속 담당

Research Library
→ 도교대사전·통사·사상사의 구조 탐색·검색·Reader를 담당
브라우저 화면에서는 DaoCanon Search | Research Library를 오갈 수 있게 했습니다. 하지만 내부에서는 원문 corpus와 연구자료 corpus의 수명, 탐색 방식, 장애 범위를 분리했습니다.
이 과정에서 배운 것은 “한 화면으로 보인다”와 “모든 것을 하나의 서비스에 넣는다”는 다른 말이라는 점입니다. 브라우저 상에서 두 화면을 자연스럽게 오가되, 한쪽을 고치기 위해 다른쪽을 불필요하게 멈추지 않도록 설계했습니다.
2. 검색 결과가 아니라 실제 Reader 위치까지 연결했다
Research Library에서 가장 중요한 사용자 경험은 다음 흐름이었습니다.
연구 자료실 진입
→ 자료 선택
→ 색인·목차 또는 검색
→ 실제 항목·절 선택
→ Reader에서 원문 확인
그런데 실제로 사용해 보니, 연구서 검색 결과를 눌렀을 때 Reader가 검색어가 있는 곳이 아니라 그 절의 첫 문단부터 열리는 문제가 보였습니다. 검색어는 존재하지만 사용자가 다시 스크롤해서 찾아야 하는 상태였습니다.
제가 화면을 보고 이렇게 말했습니다.
음영표시를 해서 스크롤해서 보면 알 수 있지만,
‘Daocanon’처럼 바로 표제어가 있는 부분으로 보여주었으면 해.
이 관찰은 작은 화면 수정처럼 보였지만, 검색 결과의 위치 정보가 Reader까지 전달되는지 확인하는 작업으로 이어졌습니다. 조사해 보니 API에는 검색어가 있는 실제 행 위치가 있었지만, Web이 Reader를 열 때 그 정보를 버리고 있었습니다.
수정 뒤에는 연구서 검색 결과를 열면, Reader가 검색어가 포함된 문단 구간을 바로 열고 해당 글자를 표시합니다. 제목 검색이나 목차 탐색처럼 특정 행 위치가 없는 경우에는 기존처럼 해당 단원의 시작에서 읽습니다.
여기서의 교훈은 단순했습니다. 검색 결과가 반환되는 것과, 사용자가 찾은 내용이 화면에 보이는 것은 다릅니다.
3. 긴 원문이 느릴 때, API가 아니라 브라우저를 먼저 측정했다
Reader가 길어지자 화면이 점차 무거워지는 문제가 나타났습니다. 처음에는 자료가 크거나 API가 느려서 그렇다고 생각하기 쉽습니다. 하지만 실제로 측정해 보니 API 응답은 약 2~8ms로 빨랐고, 문제는 브라우저 화면 쪽에 있었습니다.
긴 원문을 표시하는 과정에서 글자가 너무 많은 DOM node로 나뉘었고, 번역 입력란에 Reader 전체 원문까지 자동으로 들어가면서 화면 렌더링 부담이 커졌습니다.
16,289자 Reader
→ 글자 단위 DOM node가 대량 생성
→ 브라우저 CPU 사용량 증가
→ 화면 반응 저하
그래서 해결도 “서버 시간을 더 늘리는 것”이 아니었습니다.
문자열은 한 덩어리 TextNode로 표시
Reader는 필요한 범위만 나누어 읽기
번역 입력란은 빈 상태에서 시작
사용자가 필요한 원문만 명시적으로 붙여 넣기
원문·표시 변환·번역 입력·번역 결과의 상태를 분리
4. 화면의 구조 오류를 발견했을 때, AI 역할을 구분해서 진행했다
공개 화면을 읽던 중, 중국도교사상사에서 장이 다른 편에도 중복되어 보이고 편의 표시 순서가 뒤바뀐 것을 발견했습니다.
1권 제4장이 제1편과 제2편에 함께 보임
4권 제36장이 제5편과 제6편에 함께 보임
4권 제5편·제6편의 표시 순서가 뒤바뀜
이 문제는 화면에서 예외 처리를 넣으면 잠시 가릴 수 있었습니다. 그러나 실제 원인은 일부 원본 파일의 오래된 frontmatter와 파일 발견 순서에 있었습니다.
여기서 자료 원문은 원본 corpus를 맡은 별도의 AI를 통해 수정했습니다. 작업에 따라 AI의 역할을 구분했습니다. 수정 뒤에는 파일 존재·metadata·본문·hash·API·Reader를 다시 확인했습니다. 이후 화면 쪽의 임시 우회도 제거했습니다.
이 경험을 통해 비개발자인 저는 “화면이 이상하다”는 관찰도 충분히 중요한 출발점이라는 것을 배웠습니다. 다만 고치는 방식은 임시 화면 처방이 아니라, 문제가 생긴 층과 그 자료의 책임자를 구분하는 일이어야 했습니다.
5. 원문을 바꾸지 않는 읽기 보조를 Research Library에도 옮겼다
1단계에서 정한 원칙은 제2단계에서도 유지했습니다.
표시는 바꿀 수 있다.
번역은 이해를 도울 수 있다.
그러나 원문·locator·content hash·검색 근거는 바꾸지 않는다.
Reader에는 원문 | 번체 | 간체 표시 전환을 두었습니다. 이 기능은 보이는 글자만 바꾸고, 원문 자료와 검색 근거는 건드리지 않습니다.
한국어 번역도 Reader 원문을 자동으로 바꾸거나 저장하는 방식이 아닙니다. 사용자가 필요한 문단을 붙여 넣으면 최대 4,000자 범위에서 별도 결과로 보여 줍니다. 긴 원문을 자동으로 번역창에 넣지 않게 한 것도, 사용자가 무엇을 번역할지 직접 선택하도록 하기 위해서였습니다.
또 사용자가 A 문서를 읽으며 번역을 요청한 뒤 B 문서로 이동했을 때, 늦게 도착한 A의 번역 결과가 B 화면을 덮어쓰지 않도록 막았습니다. 이런 안전장치는 눈에 잘 보이지 않지만, 연구 도구가 오래 쓸 수 있으려면 꼭 필요한 부분이었습니다.
<완성된 형태>
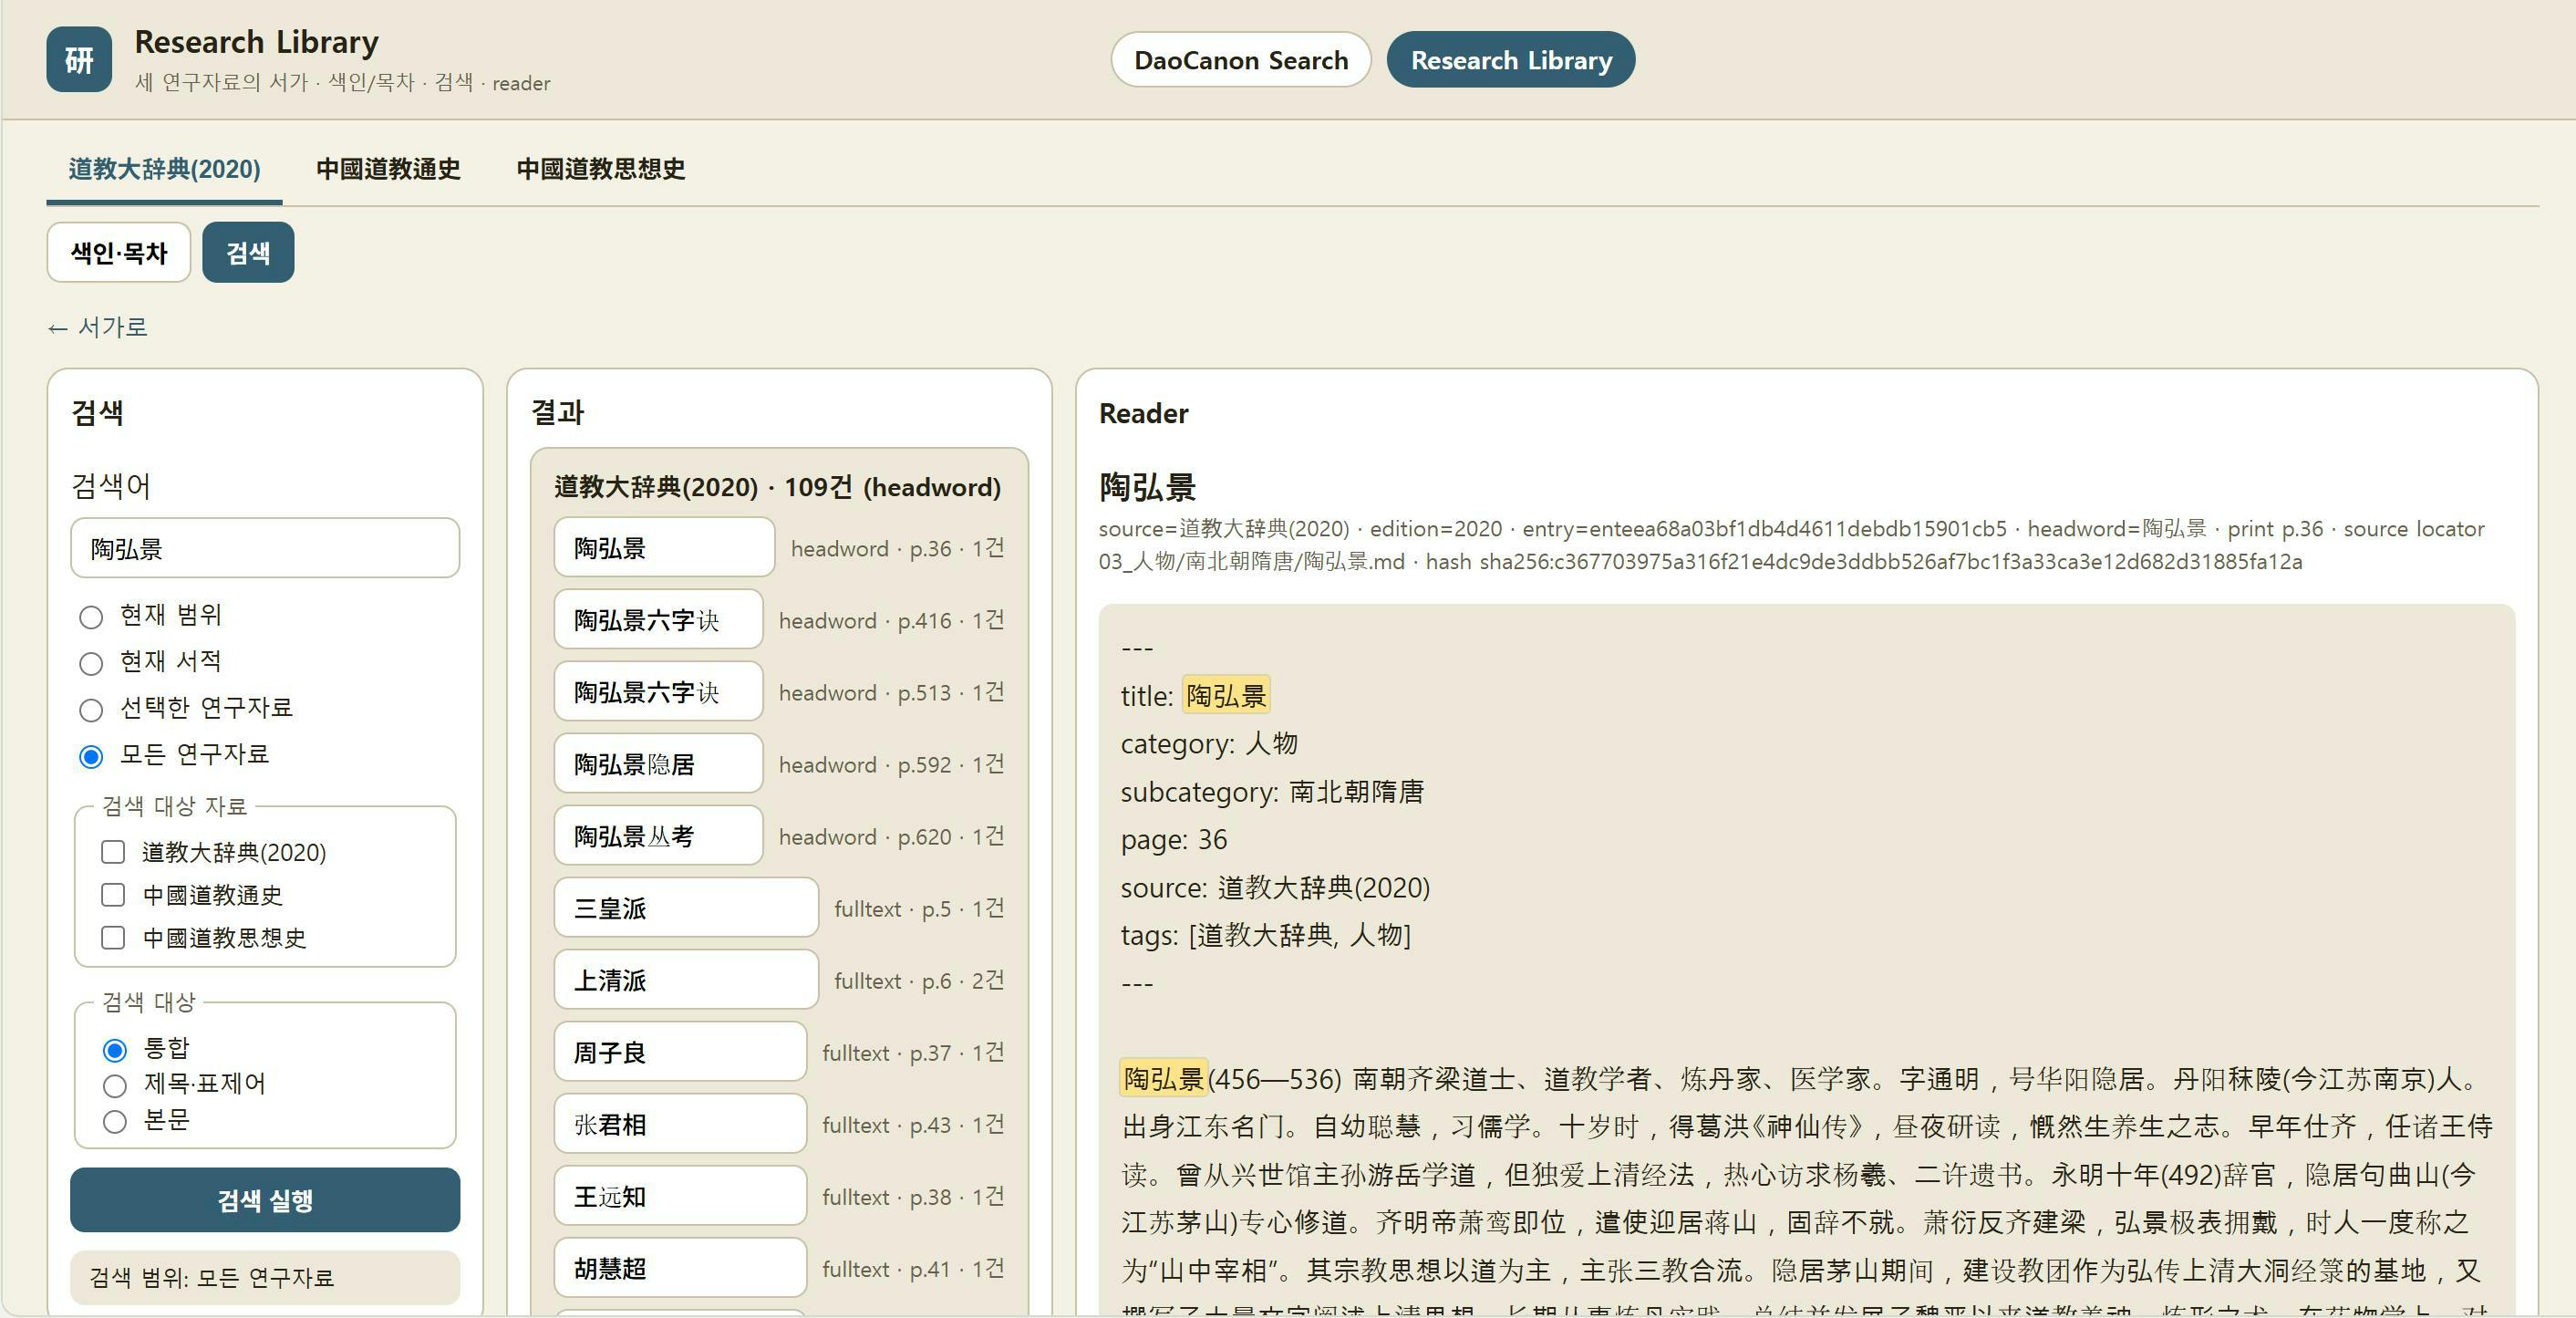
✅ 결과 — 세 자료를 한데 섞지 않고, 하나의 연구 여정으로 만들었다
Before / After
구분 | Before | After |
|---|---|---|
연구자료 활용 | 자료 폴더와 파일을 따로 열어 봄 | Research Library에서 세 자료를 선택·탐색 |
사전 읽기 | 파일 단위로 찾음 | 분류 → 하위 분류 → 표제어 → Reader |
연구서 읽기 | 긴 본문에서 위치를 다시 찾아야 함 | 권·편·장·절 → 검색 적중 passage → Reader |
검색 결과 | 결과 목록만 확인 | 실제 검색어가 있는 문단을 즉시 표시 |
긴 Reader | 화면이 무거워질 위험 | bounded Reader와 안정된 DOM 구조 |
자료 구조 오류 | 화면에서만 임시 보정할 가능성 | 원본 담당 AI 수정 후 API·Web 재검증 |
변환·번역 | 원문과 섞일 위험 | 원문 불변의 읽기 보조로 분리 |
공개 접근 | Stage 1 중심 | 같은 로그인으로 Search와 Research Library 왕복 |
실제로 남은 결과물
도교대사전·중국도교통사·중국도교사상사 세 자료의 독립 Research API
자료별 구조를 보존한 Research Library
색인·목차·범위 검색·Reader 흐름
검색 결과에서 실제 적중 문단으로 이동하는 Reader
긴 passage를 안전하게 읽기 위한 bounded Reader
원문/번체/간체 표시 변환
명시적 붙여넣기 기반의 로컬 한국어 번역 보조
기존 DaoCanon Search와 같은 인증 상태로 오가는 공개 연구 화면
💬 이 과정에서 배운 AI 활용 팁
효과적이었던 것
자료의 성격을 먼저 말하기
“세 자료를 넣고 싶다”보다 “사전은 표제어, 연구서는 권·장·절로 읽어야 한다”라고 말하자 AI가 더 적절한 구조를 제안할 수 있었습니다.
화면에서 본 불편을 그대로 전달하기
“검색 결과가 있지만 바로 찾은 문단이 보이지 않는다”는 말은 target passage와 viewport 검증까지 이어졌습니다.
테스트와 실제 사용을 구분하기
테스트가 통과해도 화면 구조, 긴 글의 반응, 검색어가 보이는 위치는 실제 브라우저에서 다시 확인해야 했습니다.
문제의 층을 나누기
API가 느린지, 브라우저가 느린지, 원본 자료의 metadata가 틀렸는지를 분리하면 엉뚱한 곳을 오래 고치지 않게 됩니다.
AI 완료 보고를 그대로 끝으로 삼지 않기
구현 worker의 보고보다 코드·테스트·브라우저·사용자 관찰을 함께 보는 편이 안전했습니다.
이렇게 하면 안 됐습니다
서로 다른 자료를 한 검색 형식으로 억지로 통일하기
사전의 표제어성과 연구서의 논의 구조가 모두 흐려질 수 있습니다.
검색 결과가 나오면 Reader 경험도 끝났다고 생각하기
검색어가 실제로 화면 안에 보이는지까지 확인해야 합니다.
화면의 구조 오류를 frontend에서만 숨기기
원본 metadata 문제라면 책임 있는 원본 수정과 재검증이 필요합니다.
“느리다”는 말을 timeout 하나로 해결하기
네트워크·API·DOM·CPU 중 어디가 병목인지 측정해야 합니다. (AI가 측정)
🌍 다른 연구·업무에 적용한다면?
이 방식은 도교 연구자료에만 한정되지 않습니다.
사전·백과사전과 연구서를 함께 쓰는 인문학 연구
법령 원문과 해설서를 함께 보는 법률 리서치
매뉴얼·기술문서·장애 보고서를 오가는 운영 지식베이스
여러 아카이브를 하나의 화면에서 찾되, 각 자료의 출처와 위치는 보존해야 하는 프로젝트
공통 원칙은 같습니다. 모든 자료를 하나로 뭉개기보다, 각 자료의 읽는 단위와 출처 위치를 지키면서 사용자의 탐색 여정을 연결하는 것입니다.
🚀 다음 단계와 경계
제2단계는 세 자료를 탐색·검색·Reader로 읽는 연구자료실을 완성한 단계입니다. 이후에는 선택한 근거를 어떻게 모으고, 어떤 조건에서 AI 대화가 그 근거를 사용하게 할지 별도 단계로 다룰 예정입니다.
다만 그 다음 단계는 이 글의 완료 범위가 아닙니다. 먼저 제2단계에서 만든 검색·Reader·locator의 신뢰선을 독립적으로 유지하는 것이 우선입니다.
이번 제2단계에서 가장 크게 남은 것은 “AI가 도교 연구자료실을 만들어 주었다”는 말보다, 비개발자인 제가 자료의 성격과 화면에서 느낀 불편을 말하면 그것이 구조·기능·검증 항목으로 번역될 수 있다는 경험입니다.
바이브코딩은 한 번의 ‘딸깍’으로 끝나지 않았습니다. 연구처럼 자료를 읽고, 어디가 이상한지 관찰하고, 질문하고, 작은 수정 뒤 다시 확인하는 과정이 필요했습니다. 다만 그 과정을 거치면서 내가 실제로 쓰고 싶은 연구 도구를 내 도메인 언어로 만들어 갈 수 있다는 점이 가장 흥미로웠습니다.
이제 남은 마지막 3단계는 원문과 연구서 관련 자료를 바탕으로 대화하며 연구를 할 수 있는 AI 대화창입니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요