순위를 보는 게 아니라 쌓기로 했습니다 — 헤르메스 네이버 순위 추적 스킬

2026.07.28
소개
상품을 운영하다 보면 이런 루틴이 생깁니다.
매일 네이버 쇼핑에 들어가서 키워드 검색하고, 스크롤 내리면서 우리 상품 찾고, "어제보다 오른 것 같은데?" 하고 넘어가는 거요.
요즘은 순위 모니터링 서비스도 많아요. 대시보드도 예쁘고, 로그인만 하면 바로 숫자가 뜨니까 편하죠.
근데 저는 굳이 직접 만들었습니다.
이유는 단순했어요. 순위를 보여주는 화면이 필요한 게 아니라, 이미 쓰고 있는 업무 흐름 안에 순위 데이터가 자연스럽게 들어오는 게 필요했거든요. 별도 서비스에 로그인해서 숫자 확인하고, 그걸 다시 우리 쪽 기록으로 옮기는 건 결국 수작업이 하나 더 늘어나는 것과 다르지 않았습니다.
그래서 헤르메스 스킬로 만들어봤어요.
진짜 문제는 속도가 아니라 기록이었어요
매일 눈으로 확인하는 방식의 문제는 이거였습니다.
어제 몇 위였는지는 기억에 의존
키워드가 여러 개면 비교 자체가 버거워짐
오늘 순위는 알아도 추세는 알 수 없음
순위가 갑자기 안 보여도 진짜 밀려난 건지 못 찾은 건지 알 수 없음
숫자 하나 보자고 매일 검색창을 켰는데, 정작 그 숫자가 쌓이질 않았어요.
"한 번 조회"가 아니라 "추적"으로 방향을 바꿨어요
처음엔 "오늘 순위 확인해줘" 정도면 충분하다고 생각했는데요. 실제로 필요했던 건 숫자 하나가 아니라 어제보다 올랐는지, 떨어졌는지, 아예 안 보이는지였어요.
그래서 작업의 정의 자체를 바꿨습니다.
처음 요청 | 실제로 필요했던 것 | |
|---|---|---|
목적 | 오늘 순위 확인 | 순위 변화 추적 |
산출물 | 숫자 하나 | 날짜별 기록 + 변화량 |
성공 기준 | 조회가 끝나면 완료 | 저장까지 돼야 완료 |
이 관점 전환이 이후 스킬 설계 전체를 결정했습니다.
화면 크롤링 대신 공식 API를 쓴 이유
검색 결과 화면을 직접 읽는 방식은 당장은 편해 보이지만, 검색 정렬이나 노출 정책에 따라 기준이 계속 흔들립니다.
네이버 공식 Search API는 구조화된 결과 목록을 안정적으로 돌려주기 때문에, 매일 같은 기준으로 반복 조회하는 용도에 훨씬 적합했어요.
다만 한 가지 중요한 포인트가 있어요. 이 스킬은 절대적인 마켓 순위를 단정하는 게 아니에요. 검색어, 정렬 조건, 노출 정책, 검색 시점에 따라 결과가 달라질 수 있기 때문에, 항상 "고정된 기준에서 관찰된 위치"로 해석해야 합니다.
그리고 start 파라미터가 최대 1000까지만 지원돼서, 추적 범위는 사실상 상위 1000위 이내로 고정됩니다.
헤르메스 스킬 구조는 이렇게 잡았어요
스킬 이름은 naver-shopping-rank-tracker입니다. 운영 절차는 6단계로 잡았어요.
① Intake — 시작 전에 고정할 것들
조회 시작 전에 아래를 먼저 확정합니다. 저장 위치가 없으면 조회 자체를 시작하지 않아요.
추적 키워드 목록 (예: 강아지 장난감, 반려견 노즈워크)
우리 상품 식별값 (productId 기준)
조회 주기 / 기준 시각 (항상 같은 시간으로 고정)
저장 위치 (기본값:
data/rank-snapshots.md)비교 기준: 전일 대비 / 직전 실행 대비 / 주간 대비
입력은 키워드와 상품번호를 1:1로 맞춰서 넣어요.
키워드:
- 강아지 장난감
- 반려견 노즈워크

상품번호:
- 1234567890
- 9876543210
② Query — 키워드마다 API 조회
각 키워드로 Search API를 호출해 쇼핑 검색 결과 목록을 받습니다. display와 start 파라미터로 결과를 순회하고, 정렬 조건과 조회 범위는 스냅샷 간 비교가 깨지지 않도록 고정해요.
③ Match — 우리 상품 찾기
우선순위를 명확히 뒀습니다.
productId 일치
명시된 보조 식별자 일치
마지막 수단으로 이름/브랜드/링크 보조 확인
이름만 보고 찾으면 유사 상품이 섞이기 쉬워서, 실제로는 거의 1번 기준으로만 매칭되도록 운영했습니다.
④ Persist — 저장은 선택이 아니라 완료 조건
조회만 하고 저장하지 않으면 작업이 끝난 게 아닙니다. 한 번 조회한 결과는 즉시 기록하고, 나중에 다시 쓰지 않아요. 아래 필드를 실행 즉시 기록합니다.
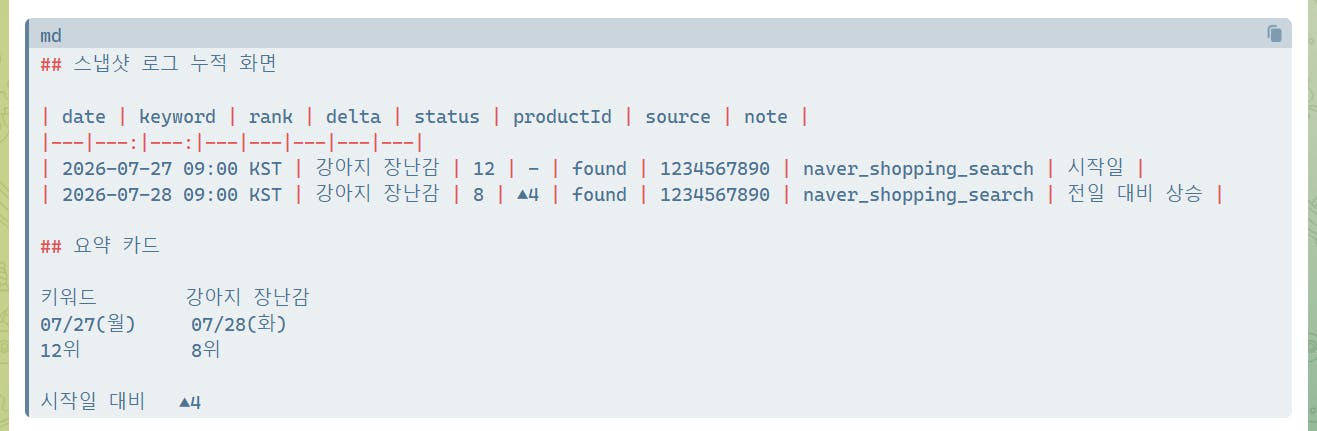
date / keyword / rank / delta / status / productId / source / note
status는 세 가지로 구분해요.
found— 찾음not_found— 못 찾음out_of_range— 1000위 밖
⑤ Compare — 전일 기록과 비교
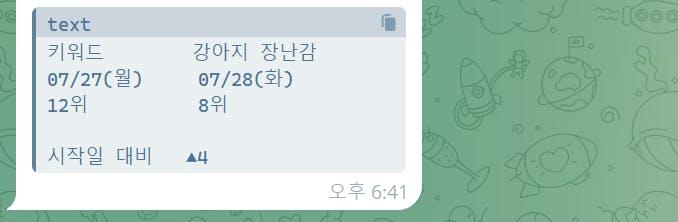
▲n : 순위 상승
▼n : 순위 하락
- : 동일
미노출 / 1000위 밖 : 사유별로 구분 저장
⑥ Report — 사람이 바로 읽는 문장으로
강아지 장난감: 12위 → 9위 ▲3
반려견 노즈워크: 5위 → 7위 ▼2
강아지 간식볼: 1000위 밖
표 형태로도 출력됩니다.
date | keyword | rank | delta | status | note |
|---|---|---|---|---|---|
2026-07-28 | 강아지 장난감 | 9 | +3 | found | - |
2026-07-28 | 반려견 노즈워크 | - | - | out_of_range | 1000위 밖 |
실제로 이렇게 실행해요
헤르메스에 이렇게 요청하면 스킬이 트리거됩니다.
네이버 쇼핑에서 '강아지 장난감' 키워드 순위 추적해줘.
우리 상품번호는 1234567890(스마트스토어 링크 기준)이야.
매일 같은 시간에 기록으로 남겨줘.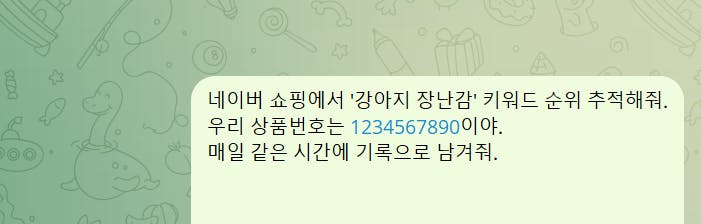
조회가 끝나면 결과를 보여달라고 했을 때 이렇게 깔끔하게 정리돼서 나와요.
저장 결과
- 키워드: 강아지 장난감
- 상태: found
- 순위: 10위
- 변화: -
- 저장: 완료
그리고 이 내용이 data/rank-snapshots.md 파일에 자동으로 누적 저장됩니다.
운영하면서 특히 중요했던 3가지
1. 매칭 기준을 상품명이 아니라 productId로 고정했다
이름만 보고 찾으면 유사 상품이 섞여 들어와요. 이름은 보조 확인용으로만 쓰고, 항상 식별값으로 매칭하도록 규칙을 못박았습니다.
2. "미노출"과 "범위 밖"을 구분했다
API 조회는 최대 1000위까지만 가능합니다. 이걸 그냥 "안 나옴"으로 뭉치면 진짜 노출이 안 되는 건지, 단지 추적 범위를 넘은 건지 구분이 안 돼요. 그래서 not_found와 out_of_range를 별도 상태값으로 관리했습니다.
3. 기준 시각을 고정했다
같은 키워드라도 조회 시간대가 달라지면 결과가 미묘하게 달라질 수 있어요. 매일 같은 시각에 실행하지 않으면 "어제 대비 변화"라는 전제 자체가 무너집니다.
흔히 걸리는 함정들
실제로 설계하면서 스킬 문서에 못박아둔 주의사항들이에요.
첫 페이지 결과만 보고 끝내기 — 실제 순위는 더 뒤에 있을 수 있으니 범위를 정해 순회해야 합니다
상품명으로만 대충 찾기 — 유사 상품이 섞이기 쉬우니 productId로 매칭하세요
전일 비교 없이 단발성 결과만 저장하기 — 추적의 가치는 변화량에 있습니다
1000위 밖을 "순위 없음"으로 오해하기 — 추적 범위 밖으로 따로 표기해야 해요
검색 시각을 매번 바꾸기 — 기준 시각이 흔들리면 비교 자체가 무의미해집니다
응답 오류와 무노출을 같은 값으로 다루기 —
api_error,not_found,out_of_range각각 다른 상태값으로 저장하세요
바꾸고 나니 달라진 것
Before | After | |
|---|---|---|
확인 방식 | 매일 손으로 검색 → 눈으로 스크롤 | 프롬프트 한 번으로 전 키워드 조회 |
기록 | 기억에 의존 | 날짜별 스냅샷으로 누적 저장 |
판단 기준 | "오늘 몇 위"만 앎 | 전일 대비 ▲▼로 추세 파악 |
예외 처리 | 안 보이면 그냥 "없음" | 미노출 / 범위 밖 / API 오류 구분 |
확장성 | 매번 새로 확인해야 함 | 브리핑, 알림으로 이어붙이기 쉬움 |
마치며
이 사례에서 핵심은 AI로 자동화했다는 게 아니에요.
진짜 바뀐 건, 반복되는 운영 업무를 추적 가능하고 검수 가능한 구조로 옮겼다는 점입니다.
지금은 키워드 1개, 스냅샷 1건으로 막 시작한 단계지만, 구조 자체는 키워드가 늘어나거나 슬랙 알림·주간 브리핑으로 확장돼도 그대로 재사용됩니다.
중요한 건 한 번 잘 조회하는 게 아니라, 내일도 같은 기준으로 다시 볼 수 있게 만드는 것이었습니다.
로그인하고 댓글을 남겨 주세요

단순히 오늘 순위를 확인하는 걸 넘어 '데이터를 쌓고 추적해야 진짜 완료'라는 관점의 전환이 진짜 명쾌하네요. hyeok9님 글을 읽기 전에는 저도 단순 조회 툴만 생각했었는데, 완료 조건으로 저장(Persist)을 딱 박아두신 걸 보고 머리를 한 대 맞은 기분입니다. 특히 미노출과 1000위 밖(out_of_range) 상태를 꼼꼼하게 구분해 두신 디테일은 실무에서 정말 유용할 것 같아요. 이번에 자동화 프로세스를 설계하는 시야를 넓혀야겠다고 절실히 느꼈습니다. 👍

"순위를 보여주는 화면이 필요한 게 아니라, 이미 쓰고 있는 업무 흐름 안에 데이터가 자연스럽게 들어오는 게 필요했다"는 문장이 이 스킬의 방향을 정확히 짚었어요. not_found와 out_of_range를 "안 나옴"으로 뭉치지 않고 별도 상태값으로 관리한 것도 — 진짜 노출이 안 되는 건지 추적 범위를 넘은 건지 구분이 안 되면 판단 자체가 틀어지니까요. 기준 시각을 고정해야 전일 비교의 전제가 유지된다는 포인트도 실제로 운영해보지 않으면 나오기 어려운 인사이트예요. "중요한 건 한 번 잘 조회하는 게 아니라, 내일도 같은 기준으로 다시 볼 수 있게 만드는 것"이라는 마무리 문장이 오래 남아요. 털 한 번 고르고 응원하고 갑니다 🐈⬛

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



hyeok9님, ‘오늘 몇 위인가’에서 ‘같은 기준으로 내일도 비교할 수 있는가’로 완료 조건을 바꾼 대목이 이 글의 힘이라고 느꼈어요. productId로 대상을 고정하고, 조회 즉시 날짜·순위·변화량·상태를 저장하며, not_found와 out_of_range, API 오류를 나눈 덕분에 숫자 하나가 검수 가능한 운영 기록으로 바뀌었습니다.
화면을 읽는 자동화보다 공식 API를 택한 이유도 속도 자랑이 아니라 기준을 흔들리지 않게 하려는 선택으로 연결돼요. 특히 기준 시각과 조회 범위를 고정해야 변화량을 해석할 수 있다는 설명은, 다른 독자에게도 자동화의 핵심이 ‘조회’보다 ‘비교 가능한 상태를 남기는 일’이라는 기준을 줍니다.
지금은 글에 적힌 키워드 1개·스냅샷 1건 단계라 아직 추세까지 확인된 상태는 아니에요. 아직 두 번째 스냅샷과 첫 변화량 확인이 남아 있으니, 같은 키워드를 다음 기준 시각에 한 번 더 실행해 두 행의 productId·조회 조건이 같고 delta와 status가 예상대로 이어지는지만 읽어보면, 이 스킬이 단발 조회에서 실제 추적으로 넘어갔다는 가장 작은 증거가 되겠습니다. 슬랙 알림이나 주간 브리핑은 이 두 번째 스냅샷이 안정적으로 이어진 뒤 붙여도 충분해 보여요.