Obsidian을 로컬 AI 지식베이스로 바꾸기: QMD로 키워드·의미 검색 자동화하기
2026.06.03
소개
저는 Obsidian 볼트에 쌓인 기술 메모, 업무 기록, 설정 가이드, 시행착오 문서를 더 잘 검색하고 싶었습니다.
Obsidian 기본 검색은 정확한 키워드를 기억하고 있을 때는 괜찮지만, “예전에 시놀로지에서 Gitea Runner 설정했던 거”, “iOS 빌드 SSH 에러 해결했던 문서”, “Hermes agent 자가 개선 관련 메모”처럼 기억이 흐릿한 경우에는 원하는 문서를 찾기 어려웠습니다.
그래서 QMD를 사용해 Obsidian 볼트를 인덱싱하고, 키워드 검색과 의미 기반 검색을 함께 활용하는 방식을 테스트했습니다.
QMD는 로컬 Markdown 문서를 인덱싱해서 빠르게 검색할 수 있게 해주는 CLI 도구입니다. 쉽게 말하면 Obsidian 같은 Markdown 기반 지식베이스를 대상으로 키워드 검색, 벡터 검색, 하이브리드 검색을 할 수 있게 해주는 검색 엔진에 가깝습니다.
처음에는 한국어 검색 품질을 더 높이기 위해 KQMD도 고려했습니다. KQMD는 QMD를 기반으로 한국어 검색을 개선하려는 시도라서 매력적이었습니다. 다만 검토해보니 현재 기준으로는 최신 QMD와 버전 차이가 있었고, QMD 자체도 최신 버전에서 한국어/영어 혼합 검색과 의미 검색 품질이 충분히 괜찮아 보였습니다. 그래서 일단 KQMD로 바로 전환하기보다, 최신 QMD에 더 좋은 임베딩 모델을 적용해서 먼저 검증하기로 했습니다.
진행 방법
사용한 도구는 다음과 같습니다.
Obsidian
QMD
2.5.3Qwen3 Embedding
0.6B Q8_0Qwen3 Reranker
Keyboard Maestro
Codex
로컬 Obsidian 볼트:
/Users/<USERNAME>/Documents/Obsidian/<VAULT_NAME>
먼저 QMD를 설치하고 Obsidian 볼트를 collection으로 등록했습니다.
npm install -g @tobilu/qmd
qmd collection add /Users/<USERNAME>/Documents/Obsidian/<VAULT_NAME> --name <COLLECTION_NAME>
qmd update
인덱싱 대상에서 불필요한 폴더와 dotfile 계열은 제외했습니다.
ignore:
  - ".*"
  - ".*/**"
  - "**/.*"
  - "**/.*/**"
  - "99 Attachments/**"
  - "20 Template/**"
처음에는 키워드 검색을 테스트했습니다.
qmd search "MCP" -c <COLLECTION_NAME> -n 10
qmd search "시놀로지 Docker" -c <COLLECTION_NAME> -n 10
qmd search "언리얼 빌드" -c <COLLECTION_NAME> -n 10
이후 의미 검색을 위해 QMD 설정의 embedding model을 Qwen3로 변경했습니다.
models:
  embed: hf:Qwen/Qwen3-Embedding-0.6B-GGUF/Qwen3-Embedding-0.6B-Q8_0.gguf
  generate: hf:tobil/qmd-query-expansion-1.7B-gguf/qmd-query-expansion-1.7B-q4_k_m.gguf
  rerank: hf:ggml-org/Qwen3-Reranker-0.6B-Q8_0-GGUF/qwen3-reranker-0.6b-q8_0.gguf
그리고 임베딩을 생성했습니다.
qmd embed -c <COLLECTION_NAME>
최종 상태는 다음과 같았습니다.
Documents: 2798 files indexed
Vectors:   14016 embedded
Collection: <COLLECTION_NAME>
QMD의 검색 방식은 크게 이렇게 이해했습니다.
qmd search키워드 기반 검색입니다.
QMD에서는 BM25 lexical search를 사용합니다.
정확한 제목, 파일명, 에러 메시지, 기술명 검색에 좋습니다.
qmd vsearch벡터 기반 의미 검색입니다.
질문이나 문장을 임베딩으로 바꾼 뒤, 의미적으로 가까운 문서 조각을 찾습니다.
qmd query하이브리드 검색입니다.
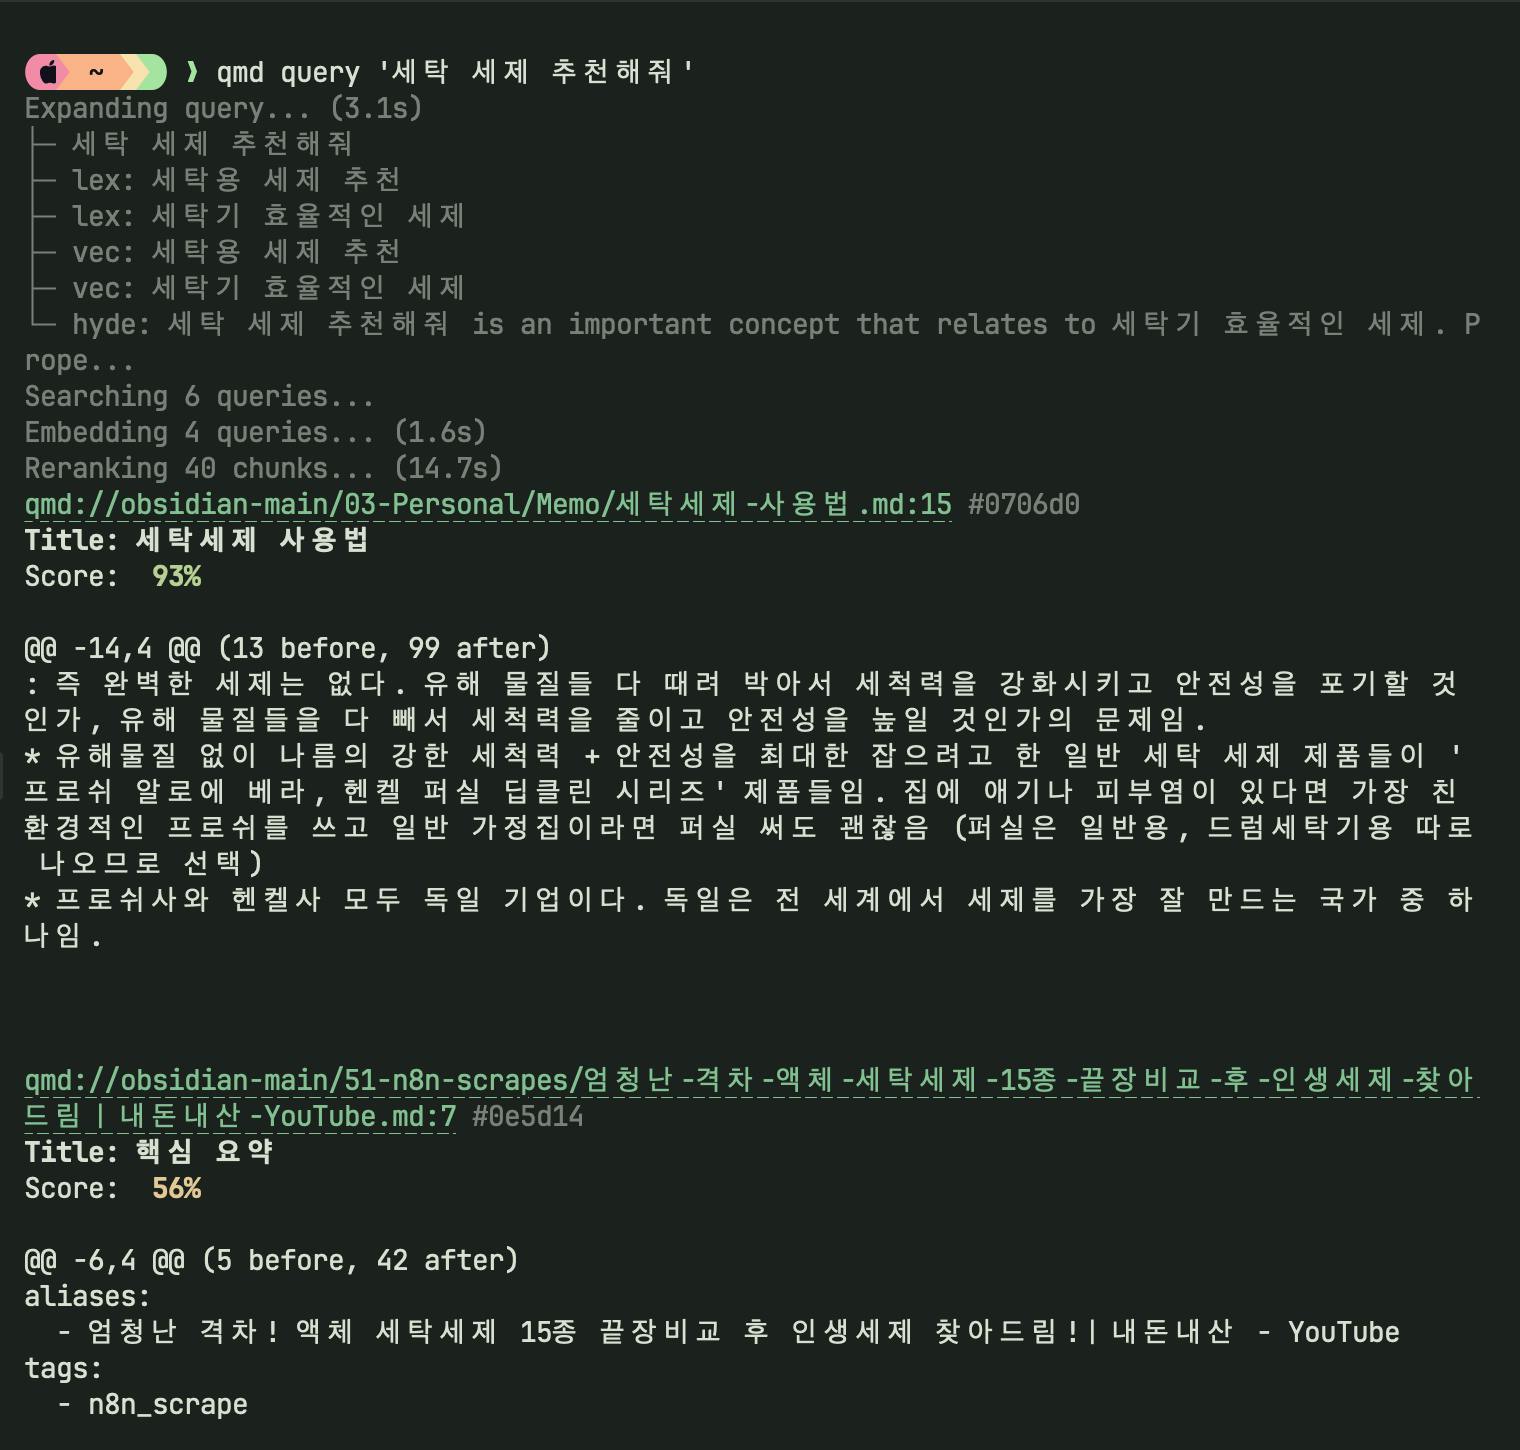
lexical search, vector search, query expansion, HyDE, reranking을 함께 사용합니다.
자연어 질문이나 “기억은 나는데 정확한 키워드는 모르는” 상황에 적합합니다.
여기서 각 용어는 간단히 이렇게 볼 수 있습니다.
lexical search
문서 안에 실제로 등장하는 단어를 기준으로 찾는 검색입니다.
예:
Gitea Actions Runner,Host key verification failed
vector search
단어가 정확히 같지 않아도 의미가 비슷한 문서를 찾는 검색입니다.
예: “시놀로지에서 깃 서버 직접 호스팅”으로 Gitea 설치 문서를 찾는 방식입니다.
query expansion
사용자의 질문을 여러 검색어로 확장하는 과정입니다.
예: “MCP 연결 문제”를 “Claude Desktop MCP 서버 연결 오류 해결 방법” 같은 표현으로 넓힙니다.
HyDE
Hypothetical Document Embeddings의 줄임말입니다.
질문에 대한 가상의 답변 문서를 만든 뒤, 그 문장으로 의미 검색을 수행합니다.
질문 자체보다 “정답 문서처럼 생긴 문장”이 실제 문서와 더 잘 맞을 때가 있어서 사용합니다.
reranking
1차로 찾은 후보 문서들을 다시 정밀하게 재정렬하는 과정입니다.
최종 결과의 품질을 높이는 데 중요합니다.
검색 테스트는 qmd search와 qmd query를 비교하는 방식으로 진행했습니다.
qmd query "시놀로지에서 Gitea Actions Runner를 설정하는 방법" -c <COLLECTION_NAME> -n 8
qmd query "iOS 빌드 중 SSH 에러가 날 때 해결 방법" -c <COLLECTION_NAME> -n 8
qmd query "n8n을 외부에서 접속하도록 Cloudflare와 Nginx Proxy Manager를 설정하는 방법" -c <COLLECTION_NAME> -n 8
qmd query "언리얼 데디케이티드 서버를 구성하거나 접속하는 방법" -c <COLLECTION_NAME> -n 8
이후에는 structured query도 사용했습니다.
structured query는 qmd query에 검색 의도와 검색 방식을 직접 나눠서 입력하는 방식입니다. 그냥 자연어 문장 하나를 던지는 것이 아니라, intent, lex, vec, hyde를 직접 작성합니다.
qmd query -c <COLLECTION_NAME> -n 10 $'intent: Find my own notes about Hermes agent self-improvement, improving the agent, memory, reflection, iterative learning, or autonomous improvement. Avoid unrelated Hermes mythology or generic agent notes unless they mention Hermes agent.
lex: Hermes agent 자가 개선 self improvement reflection memory iterative learning 에이전트 개선
vec: how to make Hermes agent improve itself over time using memory reflection evaluation feedback loops and task logs
hyde: A note explains how Hermes agent can self-improve by recording task outcomes, reflecting on failures, updating prompts or skills, using memory, evaluating performance, and iterating its workflow.'
각 줄의 역할은 다음과 같습니다.
intent무엇을 찾고 싶은지, 무엇은 피해야 하는지 적습니다.
lex실제 문서에 등장할 법한 키워드를 적습니다.
vec의미 기반 검색에 사용할 자연어 표현을 적습니다.
hyde내가 찾고 싶은 문서가 이런 내용일 것 같다는 가상의 답변 문장을 적습니다.
검색 인덱스를 최신으로 유지하기 위해 Keyboard Maestro 자동화도 만들었습니다. 1시간마다 다음 작업을 실행합니다.
#!/bin/zsh
set -euo pipefail

QMD="/Users/<USERNAME>/.nvm/versions/node/v24.12.0/bin/qmd"
export PATH="/Users/<USERNAME>/.nvm/versions/node/v24.12.0/bin:/opt/homebrew/bin:/usr/local/bin:/usr/bin:/bin:/usr/sbin:/sbin"

WORKDIR="/Users/<USERNAME>/Documents/<QMD_PROJECT_DIR>"
COLLECTION="<COLLECTION_NAME>"
LOCKDIR="/tmp/qmd-refresh-<COLLECTION_NAME>.lock"
LOGDIR="/Users/<USERNAME>/Library/Logs/qmd"
LOGFILE="${LOGDIR}/qmd-refresh-<COLLECTION_NAME>.log"

mkdir -p "$LOGDIR"

{
  echo "== $(date '+%Y-%m-%d %H:%M:%S') qmd refresh start =="

  if mkdir "$LOCKDIR" 2>/dev/null; then
    trap 'rmdir "$LOCKDIR"' EXIT INT TERM

    cd "$WORKDIR"
    "$QMD" update
    "$QMD" embed -c "$COLLECTION"

    echo "== $(date '+%Y-%m-%d %H:%M:%S') qmd refresh complete =="
  else
    echo "== $(date '+%Y-%m-%d %H:%M:%S') previous qmd refresh still running; skipped =="
  fi

  echo
} >> "$LOGFILE" 2>&1
Keyboard Maestro에서는 1시간마다 실행되도록 설정했습니다.
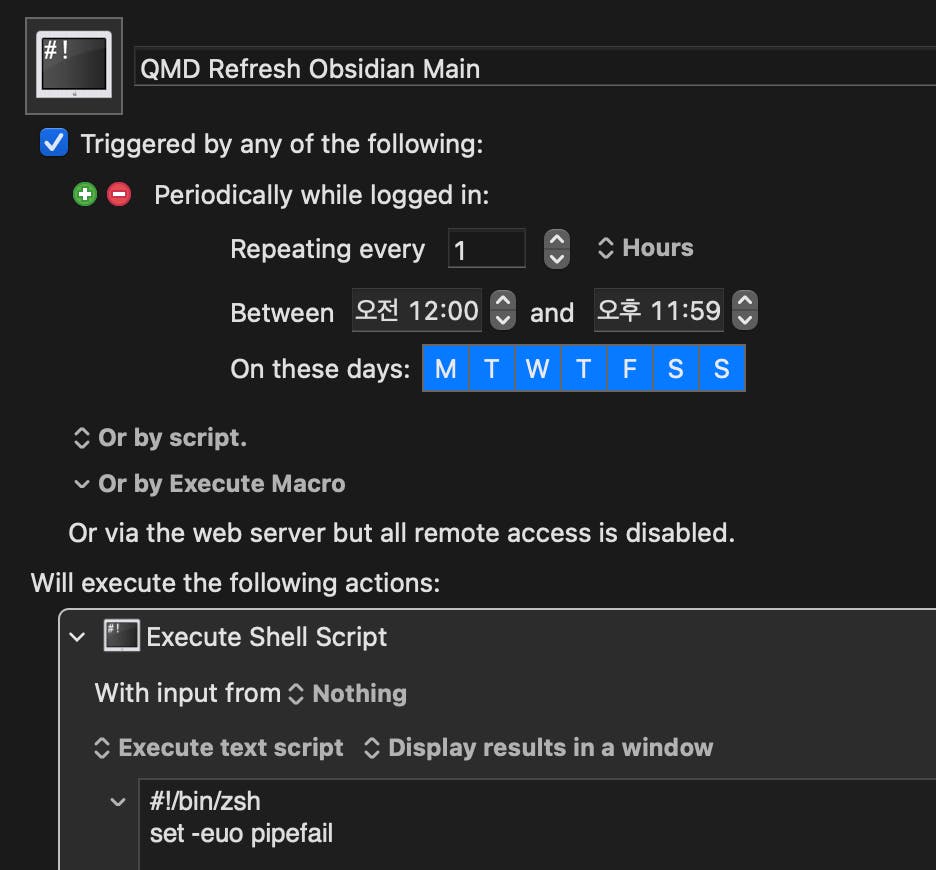
처음에는 Keyboard Maestro에서 아래 오류가 났습니다.
env: node: No such file or directory원인은 nvm으로 설치된 Node 경로가 Keyboard Maestro 환경의 PATH에 없었기 때문이었습니다. 그래서 스크립트에 export PATH=...를 추가해 해결했습니다.
마지막으로 Claude Code나 Codex 같은 에이전트가 이 검색 방식을 잘 활용할 수 있도록 obsidian-qmd 스킬도 만들었습니다.
이 스킬의 핵심 규칙은 다음과 같습니다.
1. qmd search 또는 qmd query로 후보 문서 검색
2. 검색 결과 snippet만 보고 답하지 않기
3. qmd get 또는 qmd multi-get으로 실제 문서 본문 가져오기
4. 가져온 본문과 line number를 근거로 답변 작성
스킬에는 다음 내용도 포함했습니다.
기본 collection은
<COLLECTION_NAME>정확한 명칭은
qmd search자연어 질문은 structured
qmd querymulti-get은 docid가 아니라qmd://path나 glob에 사용실제 파일 편집이 필요하면
qmd://경로를 그대로 파일 경로로 바꾸지 말 것QMD 인덱스는 Keyboard Maestro가 자동 갱신하므로 에이전트가 함부로
qmd update,qmd embed를 실행하지 말 것
추가로 QMD MCP 서버를 Claude Desktop에 연결해서, Claude Desktop에서도 Obsidian 검색 도구로 사용할 수 있는지 확인했습니다.
{
  "mcpServers": {
    "qmd": {
      "command": "qmd",
      "args": ["mcp"]
    }
  }
}
이렇게 연결하면 Claude Desktop이 QMD를 통해 Obsidian 문서를 검색하고, 필요한 문서를 가져와 답변에 활용할 수 있습니다. 다만 이 글의 핵심은 MCP 자체보다, QMD를 이용해 Obsidian 볼트를 검색 가능한 로컬 지식베이스로 만드는 과정에 두었습니다.
결과와 배운 점
QMD만으로도 Obsidian 검색 품질이 꽤 좋아졌습니다.
특히 qmd search와 qmd query의 역할을 나눠 쓰는 것이 중요했습니다.
qmd search = 정확한 키워드, 제목, 에러 메시지 검색
qmd query  = 자연어 질문, 흐릿한 기억, 의미 기반 검색
테스트 결과도 좋았습니다.
시놀로지 Gitea Actions Runner검색은 관련 문서가 1~2위에 나왔습니다.n8n Cloudflare Nginx Proxy Manager검색은 종합 가이드가 1위에 나왔습니다.언리얼 데디케이티드 서버검색도 관련 문서가 1~2위에 나왔습니다.iOS 빌드 SSH 에러는 관련 문서가 2위와 5위에 나와서 완벽하진 않았지만 충분히 찾을 수 있었습니다.
또 Hermes agent 자가 개선 방법을 물었을 때도, 제가 만든 obsidian-qmd 스킬을 통해 다음 흐름으로 답변할 수 있었습니다.
Hermes agent 검색
→ structured query로 자가 개선 관련 문서 검색
→ qmd get으로 실제 문서 본문 조회
→ SOUL, MEMORY, AGENTS, Skill, Cron 기반으로 정리
이 과정에서 “검색 결과를 잘 찾는 것”과 “검색 결과를 근거로 답하는 것”은 다르다는 점을 배웠습니다. QMD 검색 결과 snippet은 후보일 뿐이고, 실제 답변은 반드시 qmd get으로 본문을 가져와서 작성해야 합니다.
qmd get "#docid:40:80"시행착오도 있었습니다.
QMD 명령을 병렬로 실행했을 때 SQLite trigger 충돌이 발생했습니다. 그래서 자동화 스크립트에 lock 처리를 넣었습니다.
추가로 Claude Desktop에서는 QMD MCP 서버를 연결해 실제로 사용 가능한 것도 확인했습니다. 즉, CLI로 직접 검색하는 방식뿐 아니라, Claude Desktop이 QMD를 통해 Obsidian 문서를 찾아 답변에 활용하는 방식도 가능합니다.
CLI를 통한 직접검색 및 Claude Code 나 Codex 에서 활용은 테스트가 완료됐고 앞으로 옵시디언 플러그인이나 개인 지식 베이스 관련 앱을 개발해 볼 예정입니다.
도움 받은 글
QMD 공식 저장소:
https://github.com/tobi/qmdQMD Skill 문서:
https://github.com/tobi/qmd/blob/main/skills/qmd/SKILL.mdQwen3 Embedding GGUF 모델
Qwen3 Reranker GGUF 모델
☝️ 팁: Codex 앱에 펫설정해서 사용 중인데 개인적으로 마음에 드는 기능입니다. 기본 펫 이외에 다른 펫으로 설정하고 싶으신 경우 Codex Pets 사이트를 참고하세요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요