영상 자동화 프로젝트 가이드: 다중 시리즈 구현하기(step1. Codex애서 저장조 구조 생성하기)
2026.07.26
단일 테스트 저장소를 다중 시리즈 영상 자동화 프로젝트로 개편하기
(step1. Codex애서 저장조 구조 생성하기)
소개
시도하고자 했던 것과 그 이유
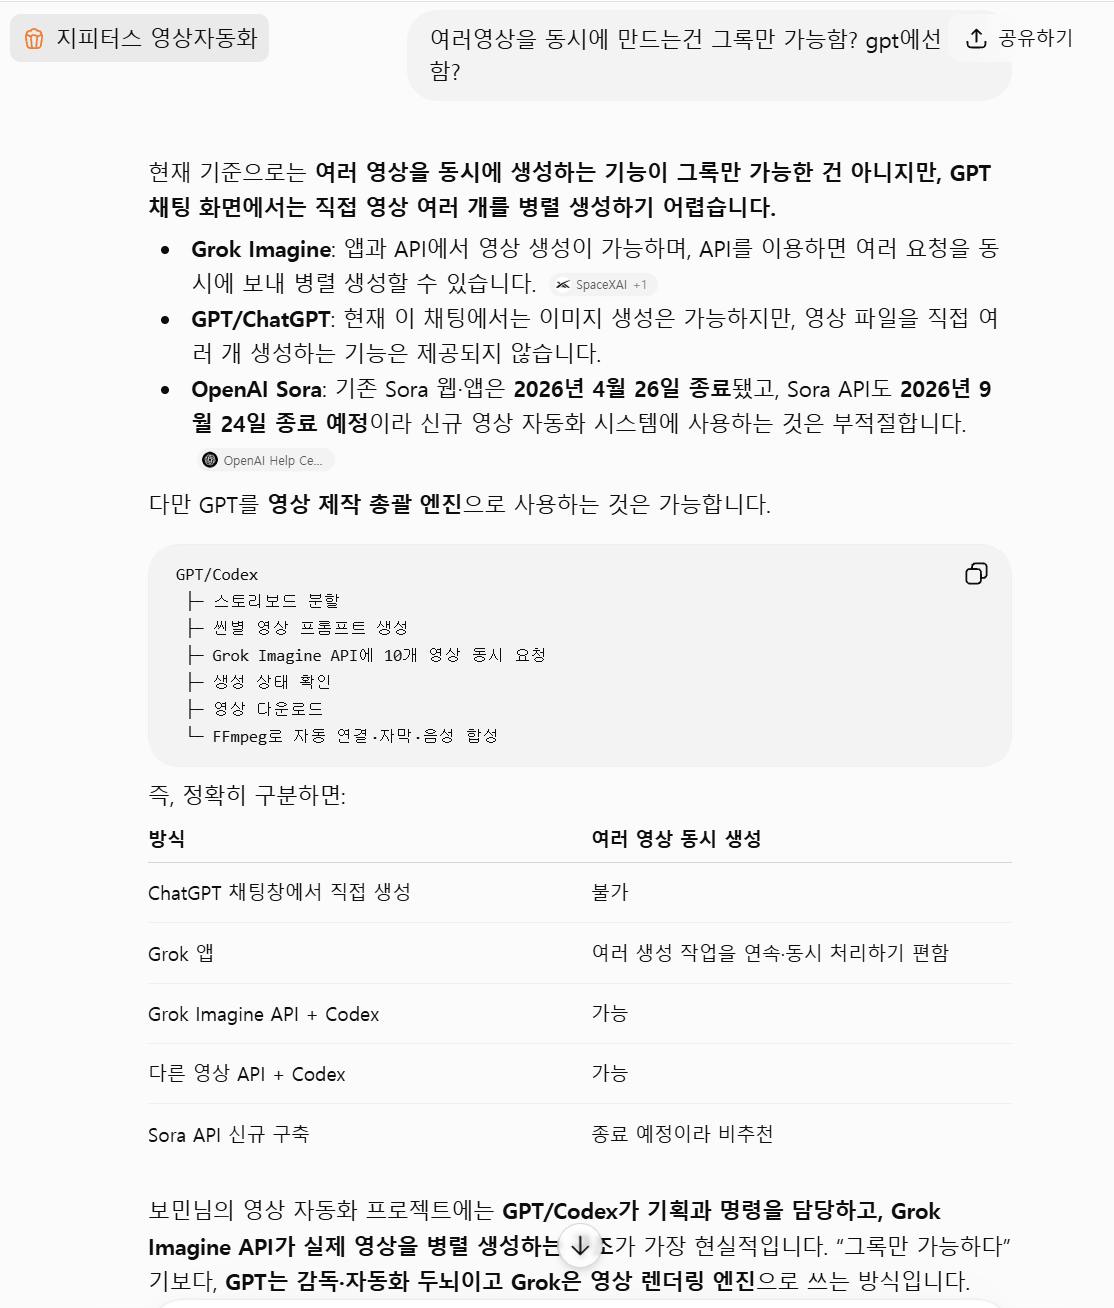
Grok엔 병렬생성기능이있어 여러개의 영상작업을 동시에 진행할 수 있는 이점이 있었다. 그러나 그 기능은 에이전트를 써야되고 lite버전 구독에는 에이전트를 사용할 수 없었다.
그래서 SuperGrok 모델을 구독하는것중 가성비를 비교해 보았다.
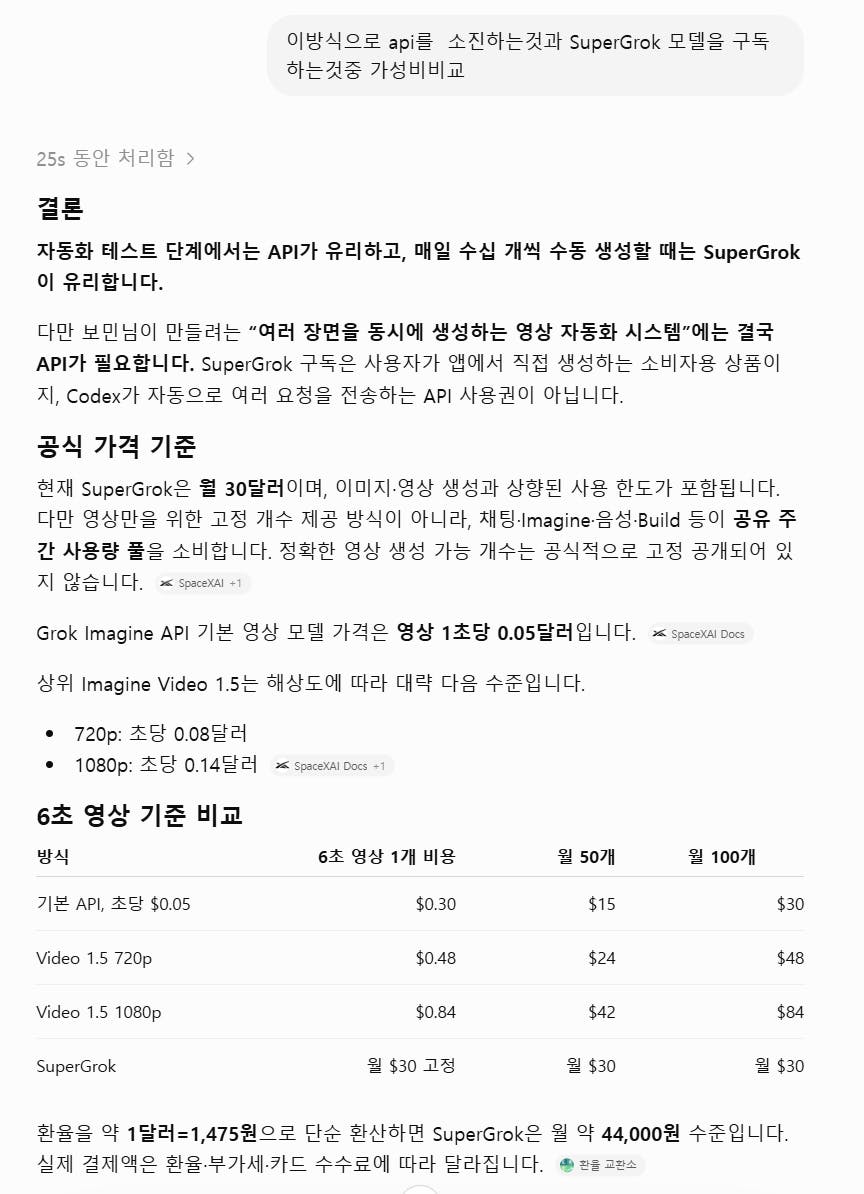
이 과정에서 역시나 영상작업은 많은 구독과 크래딧을 소모하게 된다는 점이 확 와 닿았다.
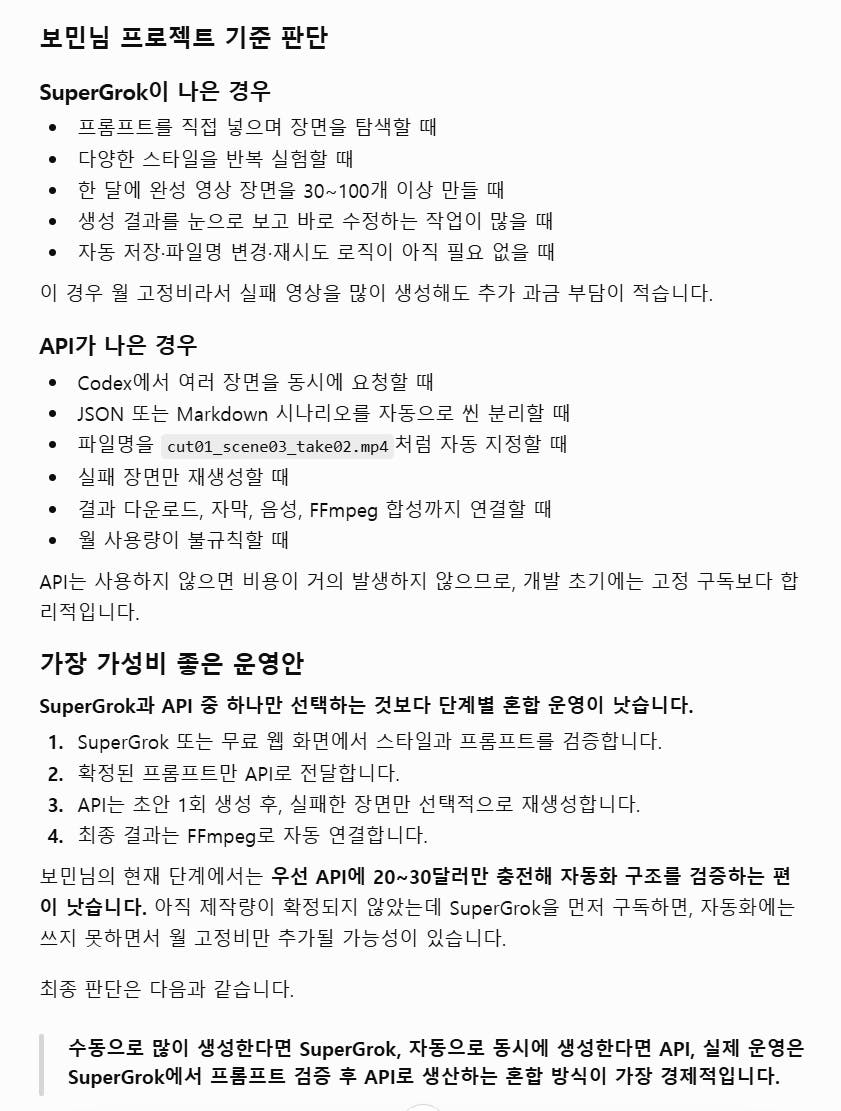
GPT가 추천한 방식으로 혼합 운영을 해보려고하는데, 결국 자동화 구축이 최종 목표이니 API로 연결해서 해보려고한다. 그래서 우선 자동화 전체 구조를 짜는 것에 집중하였다.
이미 처음 저장소에는 README와 스토리보드 이미지 4장을 중심으로 한 작업 기록이 있었다.
하지만 이 이미지는 서로 다른 테스트 결과가 아니라 leave-work-cat 시리즈의 첫 번째
에피소드인 ep001을 구성하는 연속된 네 장면이었다.
앞으로 ep002, ep003과 다른 시리즈까지 계속 제작하려면 파일을 단순히 한 폴더에
쌓는 방식으로는 다음 문제가 생긴다.
어떤 이미지가 어느 시리즈와 에피소드에 속하는지 경로만으로 알기 어렵다.
캐릭터와 세계관의 공통 설정이 에피소드별 설정과 섞인다.
원본 스토리보드, AI 생성 결과, 최종 렌더링 파일이 뒤섞인다.
완료된 장면을 다시 생성해 불필요한 API 비용이 발생할 수 있다.
특정 장면이나 실패한 장면만 골라 재실행하기 어렵다.
코드에
ep001또는 장면 4개를 직접 적으면 콘텐츠가 늘어날 때마다 코드를 수정해야 한다.
따라서 저장소를 프로젝트 → 시리즈 → 에피소드 → 씬 계층으로 바꾸고, 모든 경로를
시리즈·에피소드·씬 ID에서 계산하는 파일 기반 자동화 구조를 만드는 것이 목표였다.
실제 유료 영상 API는 연결하지 않고, 검증과 Dry Run이 가능한 안전한 골격까지만 구현했다.
진행 방법
사용한 도구와 활용 방법
Codex 데스크톱
저장소 구조와 Git 상태를 확인했다.
요구사항을 디렉터리, YAML, Markdown 템플릿과 Python CLI로 구현했다.
기존 파일을 보존하면서 이미지 경로와 문서 링크를 갱신했다.
터미널, Git
다른 작업 트리에 커밋되어 있던 원본 이미지 4개를 찾아 현재 작업 트리로 가져왔다.
이미지 이동 전후의 Git blob 해시를 비교해 파일이 변형되지 않았는지 확인했다.
브랜치 생성, 명시적 스테이징, 커밋, 푸시를 수행했다.
Python 3.12
외부 패키지 없이 동작하는 공통 경로 계산기와 YAML 부분 파서를 만들었다.
시리즈·에피소드 생성, 구조 검증, 비용 추정, 장면 선택, Dry Run, 조립 명령을 구현했다.
GitHub CLI
만료된 인증을 기기 로그인으로 갱신했다.
codex/multi-series-video-automation브랜치를 푸시하고 Draft PR #2를 만들었다.
GitHub 앱 커넥터
먼저 PR 생성을 시도했지만 저장소 접근에서 404가 발생했다.
같은 작업을 인증된 GitHub CLI로 안전하게 대체했다.
전체 작업 흐름
현재 저장소와 Git 상태 확인
→ 이미지가 있는 기존 브랜치와 원본 경로 확인
→ 장기 콘텐츠 계층 설계
→ 시리즈·에피소드·씬 디렉터리 생성
→ 스토리보드 4장을 scene_001~scene_004에 배치
→ YAML 및 Markdown 입력 템플릿 작성
→ 공통 경로·상태·검증 모듈 구현
→ 7개 자동화 CLI 구현
→ Dry Run 및 임시 에피소드 확장 테스트
→ 원본 이미지 해시와 Git 제외 규칙 확인
→ 작업 브랜치 생성·커밋·푸시
→ Draft PR 생성
사용한 프롬프트 전문
초기 요청
현재 영상자동화 저장소를 장기적으로 여러 시리즈와 여러 에피소드를 제작할 수 있는 구조로 개편해 주세요.
현재 존재하는 이미지 4개는 단일 테스트 이미지가 아니라,
leave-work-cat 시리즈의 ep001을 구성하는 scene_001~scene_004입니다.
상세 구현 요청
현재 저장소는 단일 영상 테스트용이 아니라, 앞으로 여러 시리즈와 에피소드를 계속 제작하는 영상 자동화 프로젝트로 설계해야 합니다.
현재 보유한 스토리보드 이미지 4개는 하나의 영상에 포함되는 ep001의 4개 장면입니다.
다음 기준으로 저장소 구조를 설계하고 초기 파일을 생성해 주세요.
## 핵심 계층
저장소는 다음 계층을 사용합니다.
* 프로젝트
* 시리즈
* 에피소드
* 씬
현재 시리즈 ID는 leave-work-cat이고, 현재 에피소드 ID는 ep001입니다.
현재 이미지 4개는 다음 장면에 해당합니다.
* scene_001
* scene_002
* scene_003
* scene_004
## 필수 구조
series/
  leave-work-cat/
    series.yaml
    character-bible.md
    world-bible.md
    visual-style.md
    episodes/
      ep001/
        episode.yaml
        script.md
        narration.md
        scenes/
          scene_001/
          scene_002/
          scene_003/
          scene_004/
        generated/
          images/
          videos/
          audio/
          subtitles/
        renders/
          preview/
          final/
          thumbnails/
        logs/
각 씬 폴더에는 다음 파일을 둡니다.
* scene.yaml
* storyboard.png
* image-prompt.md
* video-prompt.md
* narration.txt
## 설계 원칙
1. 시리즈 공통 캐릭터 설정과 세계관은 에피소드와 분리하세요.
2. 에피소드 공통 설정은 episode.yaml에 저장하세요.
3. 장면별 설정은 각 scene.yaml에 저장하세요.
4. 원본 입력, AI 생성 결과, 최종 렌더링 결과를 분리하세요.
5. 에피소드 ID와 씬 ID를 기반으로 파일 경로를 자동 계산하세요.
6. 코드에 ep001이나 특정 장면 수를 하드코딩하지 마세요.
7. 새 에피소드와 새 장면 수가 늘어나도 같은 코드로 처리되게 하세요.
8. 완료된 장면은 기본적으로 재생성하지 마세요.
9. 특정 에피소드, 특정 장면, 실패 장면만 선택 실행할 수 있게 하세요.
10. 생성 상태와 비용을 에피소드별 로그에 저장하세요.
11. 대용량 생성 영상은 Git에 커밋되지 않도록 .gitignore를 구성하세요.
12. API 키와 비밀정보는 환경변수로만 읽으세요.
## 생성할 자동화 스크립트
* scripts/create_series.py
* scripts/create_episode.py
* scripts/validate_episode.py
* scripts/estimate_cost.py
* scripts/generate_scene_videos.py
* scripts/generate_episode.py
* scripts/assemble_episode.py
## 실행 예시
python scripts/create_episode.py --series leave-work-cat --episode ep002 --scene-count 6
python scripts/validate_episode.py --series leave-work-cat --episode ep001
python scripts/generate_scene_videos.py --series leave-work-cat --episode ep001
python scripts/generate_scene_videos.py --series leave-work-cat --episode ep001 --scene scene_003
python scripts/generate_scene_videos.py --series leave-work-cat --episode ep001 --retry-failed
python scripts/assemble_episode.py --series leave-work-cat --episode ep001
## 현재 작업 범위
1. 먼저 저장소 구조를 생성하세요.
2. 현재 이미지 4개를 ep001의 scene_001부터 scene_004까지 배치할 경로를 마련하세요.
3. YAML 템플릿과 Markdown 프롬프트 템플릿을 작성하세요.
4. 경로 및 설정 검증 기능을 구현하세요.
5. 영상 API 호출 코드는 구조만 준비하세요.
6. 실제 유료 API 요청은 실행하지 마세요.
7. Dry Run 결과와 생성된 파일 목록을 보여 주세요.
8. 마지막에 현재 구조가 ep002, ep003 및 다른 시리즈에도 확장되는 방식을 설명하세요
중요:
- 먼저 현재 저장소 구조와 Git 상태를 확인하세요.
- 기존 파일을 삭제하거나 이동하기 전에 어떤 변경을 할지 계획을 제시하세요.
- 계획을 제시한 뒤 바로 구현하되, 실제 유료 영상 API는 호출하지 마세요.
- 작업 완료 후 변경된 파일 목록과 검증 결과를 보여주세요.
GitHub 게시 요청
깃허브에도 반영됨?
진행해
계속 진행해
생성한 구조
series/
└─ leave-work-cat/
   ├─ series.yaml
   ├─ character-bible.md
   ├─ world-bible.md
   ├─ visual-style.md
   └─ episodes/
      └─ ep001/
         ├─ episode.yaml
         ├─ script.md
         ├─ narration.md
         ├─ scenes/
         │  ├─ scene_001/
         │  │  ├─ scene.yaml
         │  │  ├─ storyboard.png
         │  │  ├─ image-prompt.md
         │  │  ├─ video-prompt.md
         │  │  └─ narration.txt
         │  ├─ scene_002/
         │  ├─ scene_003/
         │  └─ scene_004/
         ├─ generated/
         │  ├─ images/
         │  ├─ videos/
         │  ├─ audio/
         │  └─ subtitles/
         ├─ renders/
         │  ├─ preview/
         │  ├─ final/
         │  └─ thumbnails/
         └─ logs/
구현한 자동화 명령
# 새 시리즈
python scripts/create_series.py \
  --series office-dog \
  --title "Office Dog"
# 씬 6개를 가진 새 에피소드
python scripts/create_episode.py \
  --series leave-work-cat \
  --episode ep002 \
  --scene-count 6
# 구조와 경로 검증
python scripts/validate_episode.py \
  --series leave-work-cat \
  --episode ep001
# 전체 미완료 씬 Dry Run
python scripts/generate_scene_videos.py \
  --series leave-work-cat \
  --episode ep001
# 특정 씬만 선택
python scripts/generate_scene_videos.py \
  --series leave-work-cat \
  --episode ep001 \
  --scene scene_003
# 마지막 상태가 failed인 씬만 선택
python scripts/generate_scene_videos.py \
  --series leave-work-cat \
  --episode ep001 \
  --retry-failed
# 에피소드 조립 Dry Run
python scripts/assemble_episode.py \
  --series leave-work-cat \
  --episode ep001
전체 구현 코드는 다음 파일에서 확인할 수 있다.
project.py">`scripts/lib/project.py`: ID 검증, 경로 계산, YAML 읽기, 상태 로그, 씬 선택
provider.py">`scripts/lib/video_provider.py`: 환경변수 기반 영상 API 경계
episode.py">`scripts/create_episode.py`: 씬 수에 맞춘 새 에피소드 생성
episode.py">`scripts/validate_episode.py`: 설정과 파일 경로 검증
videos.py">`scripts/generate_scene_videos.py`: 완료·실패 상태 기반 씬 선택과 Dry Run
episode.py">`scripts/generate_episode.py`: 생성과 조립 오케스트레이션
episode.py">`scripts/assemble_episode.py`:
episode.yaml순서에 따른 영상 조립
활용 이미지
기존 이미지 4개를 테스트 이미지가 아닌 ep001의 입력 스토리보드로 재분류했다.
Dry Run과 검증 결과
Python 3.12.13
검증 성공: leave-work-cat/ep001
대상 씬: 4
건너뜀: 0
예상 비용: 1.0000 USD
- scene_001: 0.2500 USD
- scene_002: 0.2500 USD
- scene_003: 0.2500 USD
- scene_004: 0.2500 USD
[DRY RUN] leave-work-cat/ep001
PLAN scene_001: scenes/scene_001/video-prompt.md -> generated/videos/scene_001.mp4
PLAN scene_002: scenes/scene_002/video-prompt.md -> generated/videos/scene_002.mp4
PLAN scene_003: scenes/scene_003/video-prompt.md -> generated/videos/scene_003.mp4
PLAN scene_004: scenes/scene_004/video-prompt.md -> generated/videos/scene_004.mp4
[DRY RUN] 4개 씬 -> renders/final/ep001.mp4
- generated/videos/scene_001.mp4 MISSING
- generated/videos/scene_002.mp4 MISSING
- generated/videos/scene_003.mp4 MISSING
- generated/videos/scene_004.mp4 MISSING
MISSING은 실패가 아니라 아직 유료 영상 생성을 실행하지 않았다는 뜻이다. 조립 명령이
필요한 입력 파일을 정확히 계산했음을 보여 준다.
결과와 배운 점
결과
leave-work-cat/ep001아래에 4개 씬의 원본 입력과 설정을 배치했다.기존 네 이미지의 이동 전후 Git blob 해시가 모두 일치했다.
시리즈 공통 설정과 에피소드·씬 설정을 분리했다.
입력, 생성물, 렌더링 결과, 로그를 각기 다른 디렉터리로 분리했다.
총 7개 CLI와 공통 모듈을 외부 Python 패키지 없이 구현했다.
생성 명령은 기본 Dry Run이며
--execute없이는 유료 실행이 불가능하다.API 키는
VIDEO_API_KEY, 공급자 이름은VIDEO_API_PROVIDER환경변수에서만 읽는다.생성 영상, 렌더링 결과, 런타임 로그와
.env는 Git에 커밋되지 않는다.53개 파일, 2,146줄 추가·2줄 삭제로 첫 구조 개편 커밋을 만들었다.
커밋
dd791b7을 원격 브랜치에 푸시하고 Draft PR #2를 열었다.
배운 점과 나만의 꿀팁
파일보다 먼저 콘텐츠 계층을 정한다.
시리즈, 에피소드, 씬의 소유 관계가 명확하면 파일명 충돌과 설정 중복이 줄어든다.
경로는 한 곳에서 계산한다.
모든 스크립트가
ProjectPaths를 사용하게 하면 새 에피소드가 생겨도 로직을 고칠 필요가 없다.
씬 순서는 파일 정렬보다 manifest를 기준으로 한다.
episode.yaml의scenes목록이 영상 조립의 유일한 순서 기준이 된다.
완료 판단은 출력 파일과 상태 로그를 함께 본다.
출력이 있거나 마지막 상태가
completed라면 기본적으로 건너뛰어 비용을 보호한다.
실제 실행보다 Dry Run을 먼저 만든다.
API 연동 전에도 대상 씬, 입력 프롬프트, 출력 경로와 조립 순서를 검증할 수 있다.
대용량 파일은 시작부터 Git 정책을 정한다.
원본 스토리보드는 추적하고, 재생성 가능한 영상과 렌더링 결과는
.gitignore로 제외한다.
이미지를 이동할 때 해시를 비교한다.
눈으로만 확인하지 않고 기존 Git blob과 새 파일 해시를 비교하면 원본 보존을 증명할 수 있다.
과정 중 겪은 시행착오
현재 작업 트리는
main이 아니라 detached HEAD였고, 이미지 4개는 다른 작업 트리의agent/add-storyboard-images브랜치에 있었다. Git tree를 먼저 조사해 원본을 찾았다.처음에는 JSON manifest 초안을 만들었지만 상세 요구사항에서 YAML과 씬별 폴더가 명시되어 YAML 중심 구조로 다시 조정했다.
시스템
PATH에python이 없어 첫 검증 명령이 실행되지 않았다. Codex에 번들된 Python 3.12 실행 파일을 찾아 같은 명령을 재실행했다.GitHub CLI는 설치되어 있었지만 새 셸의
PATH에 반영되지 않았다. 절대 경로로 실행했다.기존 GitHub CLI 토큰이 만료되어 기기 로그인으로 인증을 갱신했다.
GitHub 앱 커넥터의 PR 생성이 404로 실패해 인증된
gh pr create로 대체했다.커밋 직전
git diff --cached --check에서 사례 문서의 줄 끝 공백 2건을 찾아 수정했다.대용량 출력 디렉터리를 통째로 무시하면
.gitkeep도 사라질 수 있어 예외 규칙을 함께 넣었다.
도움이 필요한 부분
실제 영상 생성 공급자를 선정하고 모델별 가격·해상도·길이 제한을
estimate_cost.py와 연결해야 한다.이미지 기반 영상 모델마다 요청 형식과 비동기 작업 조회 방식이 달라 공급자 어댑터 설계가 필요하다.
생성된 씬들의 해상도, 프레임률, 코덱이 서로 다를 때 FFmpeg 정규화 단계가 필요하다.
캐릭터 일관성과 장면 간 연속성을 자동 평가하는 검수 기준은 후속 실험이 필요하다.
앞으로의 계획
이 과정에서 익숙하지 않은 Codex로 빌드를 하려고하니 초반에 구조설계하는데 너무 오래걸렸다. 그래서 익숙한 클로드코드로 설계를 하고, Codex는 코드를 검수하는데 활용하려고한다.
1. Codex에서 저장소 구조 생성(완료)
2. Codex 결과 검토(완료)
3. 결과를 main에 반영
4. Claude Code에서 최신 main 가져오기
5. Claude Code 개발 브랜치 생성
6. EP001 이미지와 프롬프트 배치
7. 입력 검증 구현
8. 비용 계산 및 Dry Run 구현
9. xAI 영상 API 연동
10. scene_001 한 개 실제 테스트
11. 나머지 장면 병렬 생성
12. FFmpeg 영상 합성
13. Claude Code 작업을 GitHub에 push
14. Codex에서 별도 작업 트리로 검수
15. Claude Code에서 검수 결과 반영
16. 최종 테스트 후 main 병합
17. 같은 방식으로 ep002 제작
도움 받은 글
GitHub CLI
gh pr create공식 문서
로그인하고 댓글을 남겨 주세요
사례글 3개나 입력해 주시고 대답하십니다. 열정이 느껴지는데요~ 작성해주신 내용이 대단히 디테일하고, 수준이 높아서 저도 공부가 됩니다. 차근차근 읽어보도록 하겠습니다. 봄in님 역량이 대단하세요~

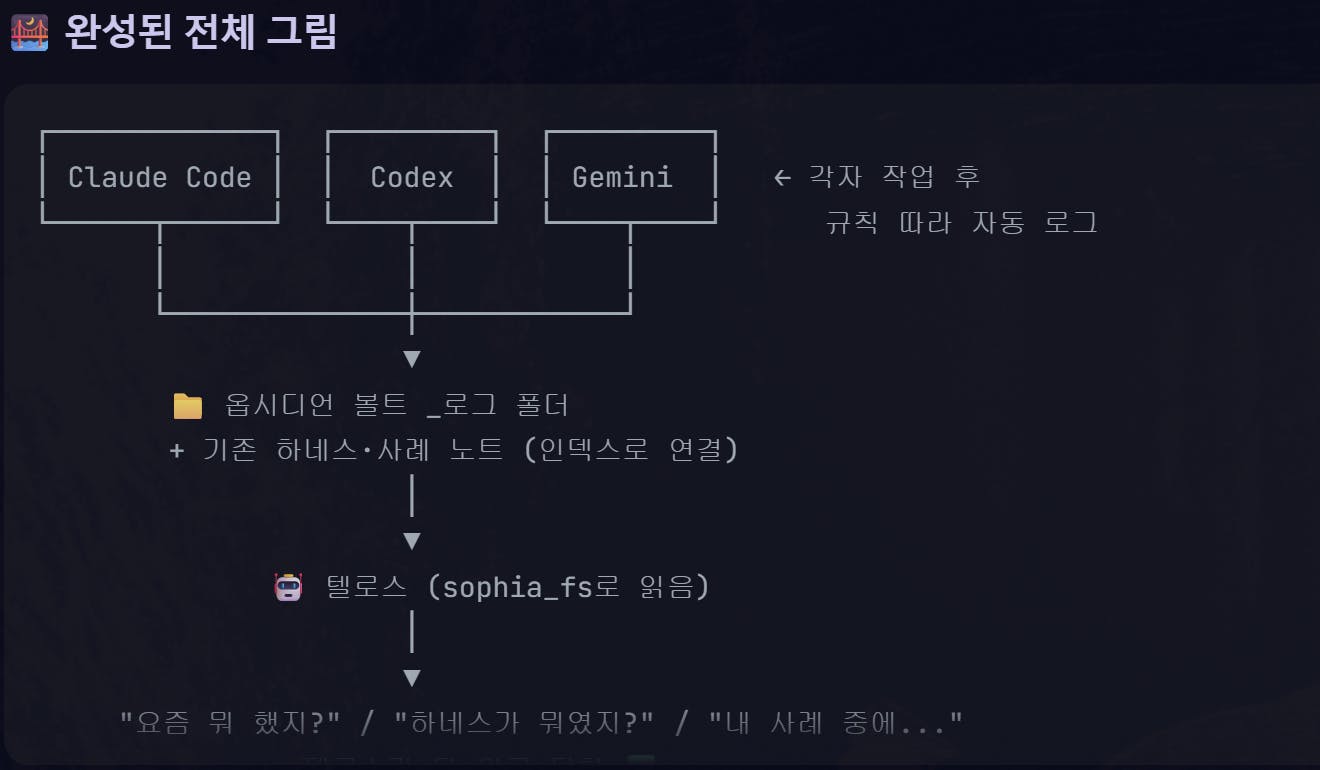
사실 사례글도 로그기록하면서 바로 사례글에 적용할수 있도록 사례글을 기록하는 폴더도 같이 깃허브에 저장해서 활용하고 있다.

단일 저장소에서 다중 시리즈 구조로 전환하면서 문제를 미리 목록으로 짚어낸 부분이 인상적이었어요. "어떤 이미지가 어느 에피소드에 속하는지 경로만으로 알기 어렵다"는 문제를 프로젝트→시리즈→에피소드→씬 4계층으로 푼 설계가 깔끔하고요.
Grok 병렬 생성이 에이전트 전용이라 API 직연결 자동화로 방향을 잡으신 맥락도 잘 이해됐어요. Python 3.12만으로 외부 패키지 없이 7개 CLI를 구현하고 Dry Run까지 넣어두신 게 실제로 쓸 수 있는 골격을 만드는 데 딱 맞는 접근인 것 같아요.
Git blob 해시로 이미지 이동 전후를 검증한 것도 꼼꼼함이 느껴졌어요. step2가 기대됩니다 🐾

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
episode.yaml의 scenes 목록을 영상 조립 순서의 단일 기준으로 삼으신 설계가 특히 인상적이었어요. 파일 정렬에 기대지 않고 상태 로그와 출력 파일을 함께 확인해 완료된 장면을 건너뛰도록 만든 덕분에, 장면이 늘어나도 순서 관리와 비용 보호를 동시에 할 수 있겠네요. 실제 API를 연결하기 전에 이런 안전한 실행 골격을 먼저 완성하신 과정이 정말 탄탄합니다.