AI 결과물 검수를 위한 평가·리뷰 하네스 만들기 2주차 (2/2): 규칙을 풀지 말고 옆에 방을 만드세요

2026.08.05
## 한 줄 요약
인사이트를 넣으려면 "모든 주장은 원문 인용을 가져야 한다"는 규칙을 풀어야 했습니다. 풀지 않고, 근거의 종류가 다른 새 계층을 옆에 만들었습니다.
그리고 그 규칙을 지키게 만드는 방법으로 문서가 아니라 조직 구조를 택했습니다.
---
## 문제 정의 — 왜 그냥 못 넣나
원래 하려던 일은 두 가지였습니다.
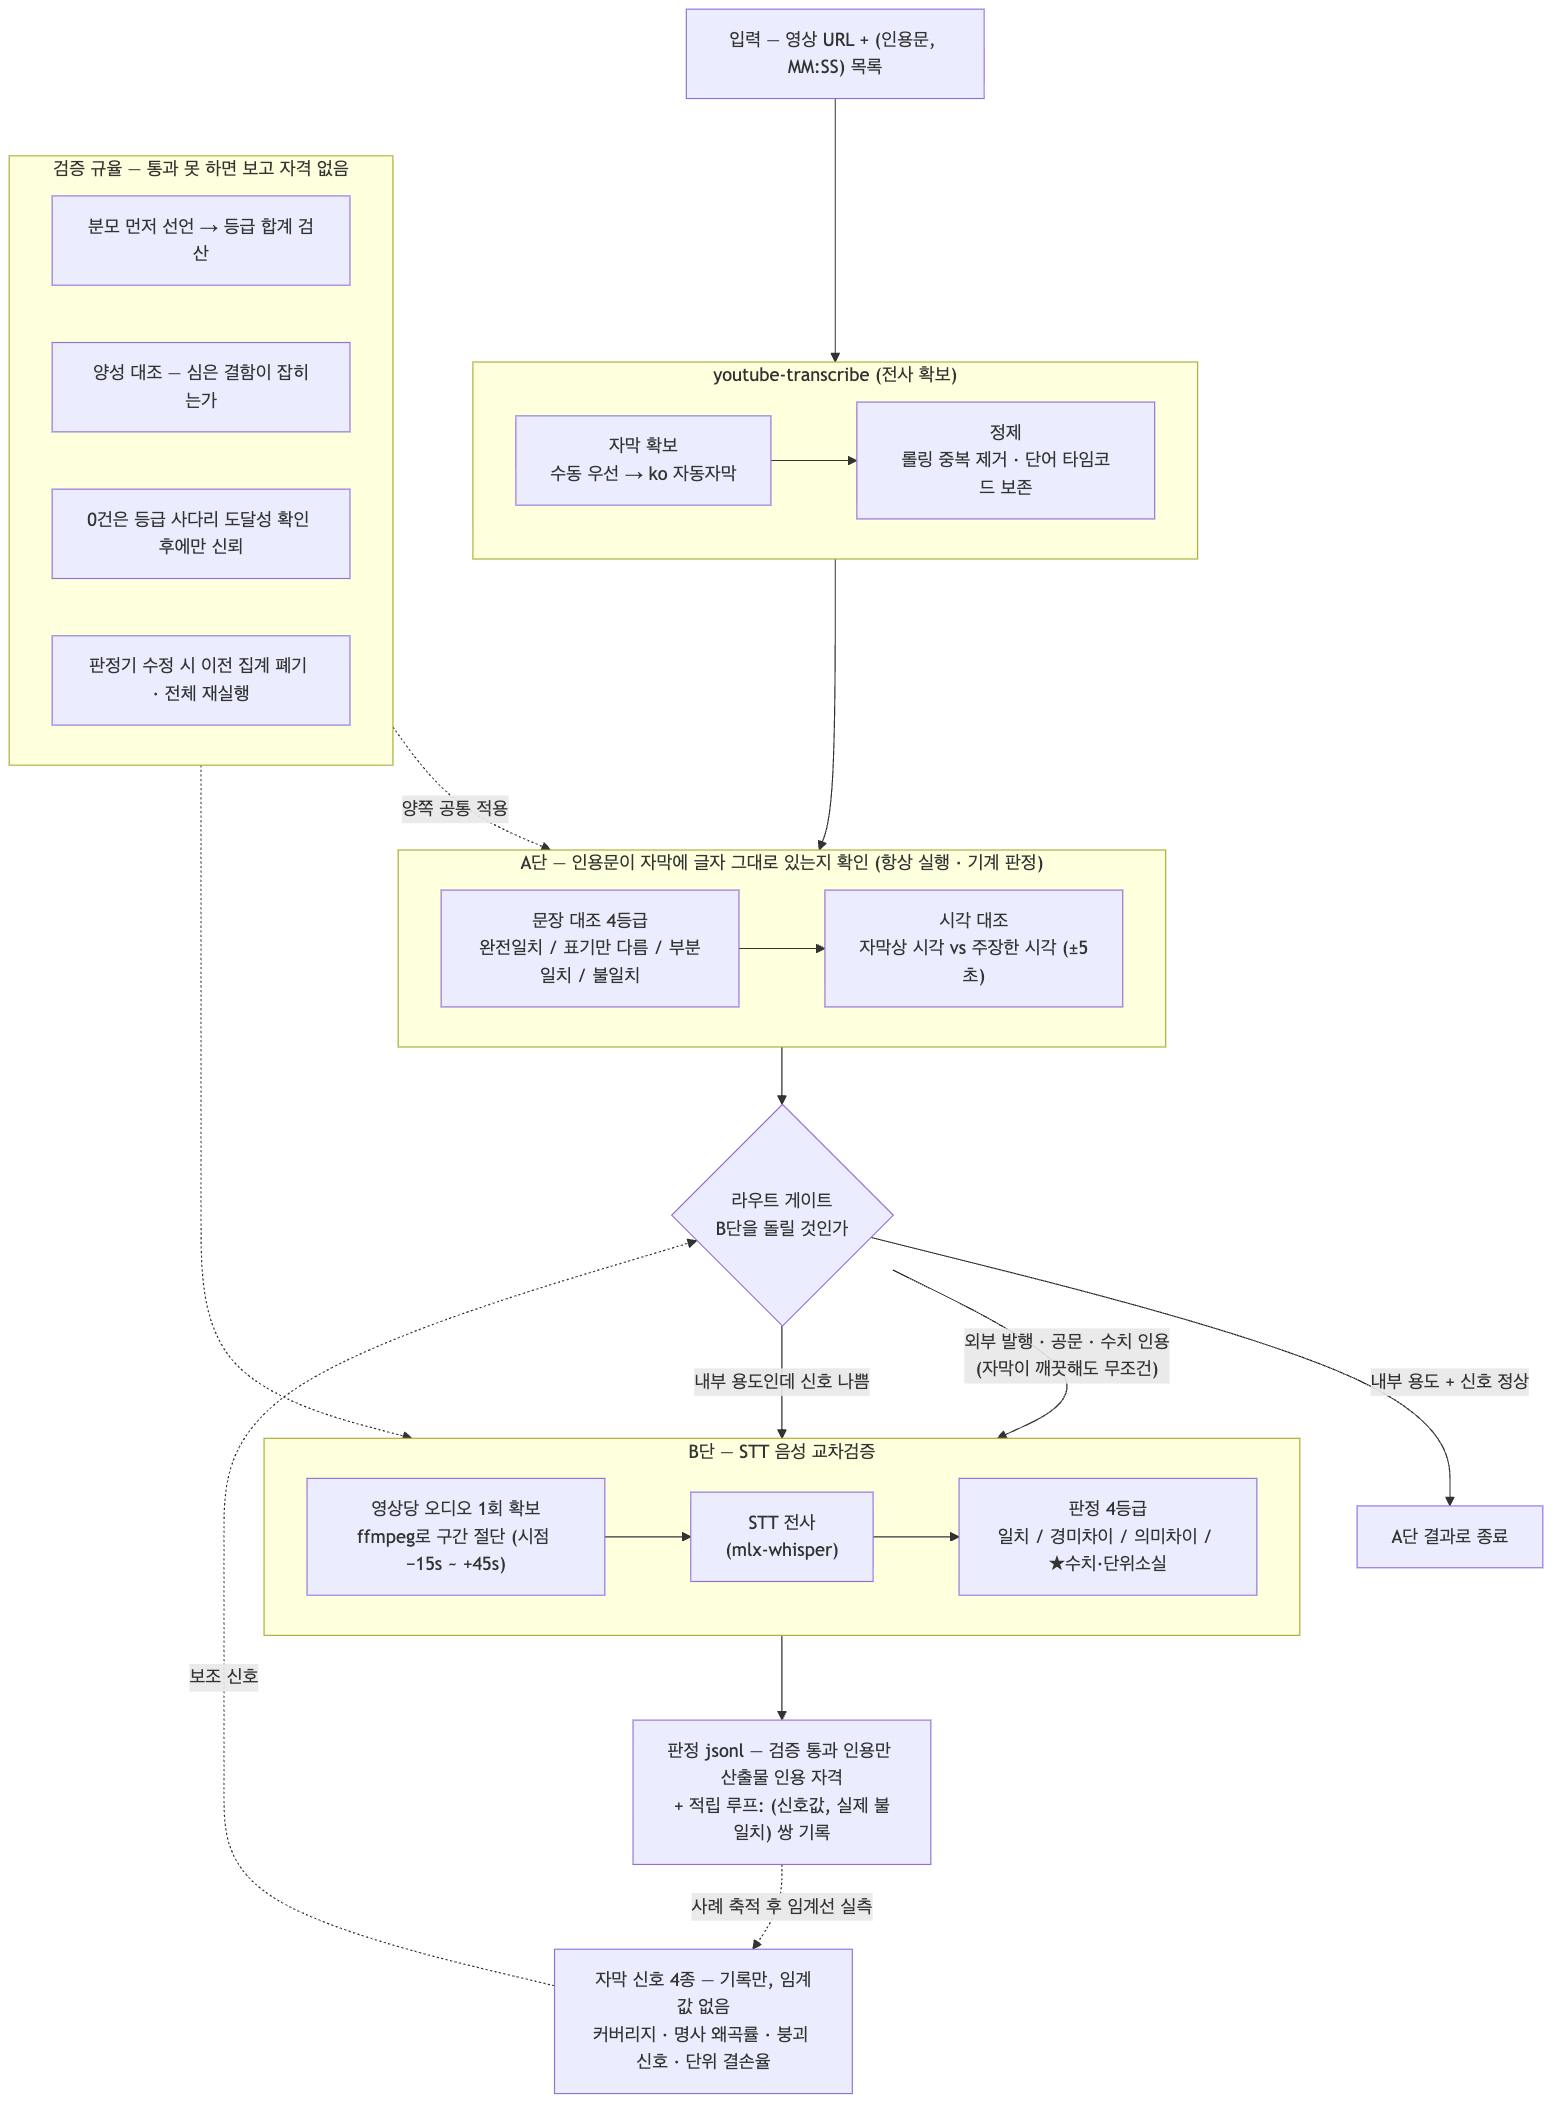
1. 유튜브 강연 → 출처추적 가능한 지식베이스에 저장 (BEFORE 편의 주제)
2. 그 위에서 인사이트 추출 · 기존 지식과의 연결 · 리서치 토픽 추론
2번이 막힙니다. 이유는 단순합니다.
이 시스템의 전역 하드 게이트 3번은 이렇습니다.
> 모든 지지 Claim은 원문의 인용 구간(Evidence) 을 하나 이상 가져야 한다.
그런데 인사이트란 무엇인가요? 원문에 그 문장이 없는 것입니다.
- "A 강연의 X와 B 강연의 Y는 같은 현상의 다른 이름이다" → 어느 영상에도 이 말은 없습니다
- "이 주제는 아직 아무도 다루지 않았다" → 없다는 걸 인용할 수는 없습니다
즉 인사이트는 정의상 게이트를 통과할 수 없습니다.
선택지는 세 개였습니다.
| 선택 | 결과 |
|---|---|
| ① 게이트를 완화한다 | 근거 없는 문장이 정본에 들어갈 수 있게 된다 → 시스템의 존재 이유가 사라진다 |
| ② 인사이트를 포기한다 | 원래 목적의 절반을 버린다 |
| ③ 근거의 종류가 다른 계층을 분리한다 | 게이트는 그대로, 새 검사 규칙을 새 계층에 붙인다 |
③을 택했습니다.
---
## 해법 — derived 계층
핵심 아이디어 한 줄:
> 파생 주장의 근거는 "원문 인용"이 아니라 "근거가 된 주장들의 ID"다.
구조로 쓰면 이렇습니다.
```
[기존] Claim ──evidence_ids──> 원문 타임스탬프 구간
[신규] Claim(derived) ──derived_from──> Claim ID 여러 개 ──evidence_ids──> 원문 구간
```
추적성이 끊기지 않습니다. 인사이트에서 출발해서
→ 근거가 된 주장들 → 그 주장들의 인용 구간 → 원문 몇 분 몇 초까지 내려갈 수 있습니다.
단계가 한 칸 늘어난 것뿐입니다.
그리고 이 계층에는 전용 검사 4종을 붙입니다.
| # | 검사 | 막는 것 |
|---|---|---|
| 1 | derived_from의 모든 대상이 존재하고 정본 상태여야 한다 | 검토 안 된 초안 위에 인사이트를 쌓는 것 |
| 2 | derived 주장은 원문 인용을 직접 가질 수 없다 | 인용 위조 — "원문에 있는 말"로 위장하는 것 |
| 3 | 근거들 중 서로 모순 관계인 것이 섞여 있으면, 본문에서 그 모순을 다뤘는지 요구 | 불리한 근거를 빼고 좋은 것만 골라 쓰는 것 |
| 4 | derived 주장은 같은 인덱스에 들어가되 표시가 구분되어야 한다 | 파생 추론을 원문 사실처럼 보이게 하는 것 |
2번이 이 설계의 안전핀입니다. 게이트 완화와 계층 분리를 구분하는 선이기도 합니다.
파생 주장에 원문 인용을 붙일 수 있게 허용하면, 그건 계층 분리가 아니라 우회입니다.
---
## 그런데 그 전에 없는 게 많았습니다
설계를 하고 나서 "그럼 연결은 지금 어떻게 되나"를 확인했습니다. 결과는 이렇습니다.
### 관계 유형 8종은 선언되어 있는데, 계산하는 코드가 0줄
스키마에 이미 있습니다.
```
supports · refines · duplicates · contradicts · supersedes · applies_to · example_of · derived_from
```
8종. 잘 만들어놨습니다. 문제는 이 값이 한 영상 안에서 추출된 것만 채워진다는 겁니다.
영상과 영상 사이의 관계를 계산하는 코드는 어디에도 없습니다.
승격 코드에 모순 검사가 있어서 되는 줄 알았는데, 열어보니
이미 선언되어 있는 모순만 확인하는 수동 체커였습니다. 모순을 찾아내지는 않습니다.
### 검색이 부분문자열 매칭
"비슷한 주장 찾기"가 되는 줄 알았습니다. 코드를 보니:
```python
if normalized in normalize_text(str(entry.get("text", ""))):
```
`in` 연산입니다. 글자가 겹쳐야 찾습니다.
"달란트"와 "재능"은 같은 뜻이지만 이 검색으로는 서로를 못 찾습니다.
의미 기반 검색이 없으면 중복 탐지·통합·공백 발견이 전부 불가능합니다.
연결하려면 먼저 "이것과 저것이 비슷하다"를 알아야 하는데, 그걸 알 수단이 없었습니다.
### 개념 허브가 없다
용어는 저장되고 있었습니다. 그런데 ID가 이렇습니다.
```
T-HXWmHuf_k68-001 ← 영상 ID가 박혀 있다
```
영상별로 따로 존재합니다. A 영상의 "달란트"와 B 영상의 "달란트"는
시스템 입장에서 완전히 남남입니다. 여러 강연을 걸쳐 흐르는 주제라는 개념 자체를 표현할 수단이 없었습니다.
지식 그래프를 만들려고 했는데 허브 노드가 없었습니다. 별만 있고 별자리가 없는 상태.
---
## 그래서 순서를 이렇게 바꿨습니다
원래는 바로 3번(인사이트)에 들어가려 했습니다. 위 세 개를 확인하고 순서를 다시 짰습니다.
```
0단계 승인 루프 뚫기 — 정본 1건 확보
↓ (이게 없으면 아래 전부 테스트할 대상이 없다)
1단계 수집 확장 — 자막 없는 영상(ASR) · 화자 근거 · 도메인 추가 · 배치
↓
2단계 전역 개념 노드 + 의미 검색 ← 연결의 전제 인프라
↓
3단계 derived 계층 + 링크 제안기 + 인사이트/토픽
```
0단계를 맨 앞에 둔 게 BEFORE 편에서 배운 것입니다.
정본이 0건이면 2·3단계의 어떤 것도 검증할 대상이 없습니다.
그리고 0단계에 중단 조건을 명시적으로 박았습니다.
> 독립 검토가 3회 연속 NEEDS_CHANGES면 루프를 끊고 사람에게 보고한다.
> "고칠 수 있는 추출 결함인가, 프로필 규칙 자체의 결함인가"는 사람이 판단한다.
BEFORE 편의 14회 반복이 이 세 줄로 바뀌었습니다. 11회분의 낭비를 규칙으로 막았습니다.
0단계에 하나 더 넣었습니다: 승격 코드 641줄을 샌드박스에서 먼저 리허설.
실전 미실행 코드를 실제 데이터에 처음 적용하지 않기로 했습니다.
---
## 규칙을 문서에 쓰는 것으로는 부족했습니다
여기가 이번에 제일 많이 바꾼 부분입니다.
BEFORE 편의 실패는 규칙을 몰라서 생긴 게 아닙니다. 규칙은 다 적혀 있었습니다.
"게이트를 완화하지 마라", "사람 승인을 대행하지 마라" — 문서에 있었습니다.
그런데 14회를 반복했습니다. 규칙을 아는 것과 규칙이 강제되는 것은 다릅니다.
그래서 이 작업을 위한 전용 에이전트 팀 부서를 편성했습니다.
(제가 쓰는 터미널은 여러 AI를 역할별로 띄워 서로 대화시키는 구조입니다.
부서 = 전용 소켓으로 격리된 팀 하나.)
### 일반 개발 부서를 그대로 쓰면 안 되는 이유
기존 개발 부서의 작업자 노드는 "완료했습니다"를 스스로 선언할 수 있습니다.
대부분의 일에는 그게 맞습니다.
이 프로젝트에서 "완료"는 사람의 명시적 승인입니다. 대행 불가입니다.
그래서 부서 고유 금지선을 만들었습니다.
| # | 금지 | 이유 |
|---|---|---|
| D1 | 정본 상태·사람 승인 표시를 직접 생성 | 승인 위조 |
| D2 | 승인 명령 실행 | 승인은 사람의 행위 |
| D3 | 하드 게이트 10종 / 검사 13종의 완화·우회 | 막히면 게이트가 아니라 입력을 고친다 |
| D4 | 원본 파일·체크섬 덮어쓰기 | 비가역 |
| D5 | 워크스페이스 환경변수를 한쪽만 설정한 상태로 쓰기 | 아래 설명 |
| D6 | 원문 없이 독립 검토 호출 | 대조 없는 검토는 검토가 아니다 |
| D7 | 실패를 "일시적 문제"로 보고 재시도만 반복 | 14회 누적이 이 실패의 증거 |
D5는 실제로 밟은 함정입니다. 이 프로젝트는 PowerShell 쪽과 Python 쪽이
서로 다른 환경변수로 작업 경로를 읽습니다. 한쪽만 설정하면
실험 명령이 실제 불변 워크스페이스에 조용히 씁니다. 에러도 안 납니다.
그래서 "쓰기 전에 두 변수를 함께 출력해 같은 경로인지 확인하고 로그에 남긴다"를 운영 규칙으로 박았습니다.
D7이 BEFORE 편의 교훈을 조직 규칙으로 만든 것입니다.
### 만든 쪽과 채점하는 쪽을 통신 규칙으로 분리
이건 문서가 아니라 통신 정책 파일로 강제했습니다.
```json
{ "from": "reviewer*", "to": "worker*", "allow": false,
"_why": "리뷰어는 워커를 직접 조향하지 않는다 — 중재는 master 경유" }
```
리뷰어가 작업자에게 직접 지시할 수 있으면, 리뷰어가 공동 저자가 됩니다.
그러면 다음 라운드에서 리뷰어는 자기가 시킨 코드를 채점하게 됩니다.
"만든 사람이 채점하면 안 된다"가 무너지는 경로입니다.
3단계(derived 계층)에는 리뷰 질문을 고정해뒀습니다.
> "이 설계가 게이트를 우회하는가, 아니면 새 계층을 분리하는가?"
> 우회로 판정되면 설계를 폐기한다.
리뷰어에게 "잘 봐주세요"라고 하면 잘 봐주지 않습니다. 무엇을 보라고 말해야 봅니다.
---
## 부서 편성 문서를 쓰다가 버그 5개를 찾았습니다
여기가 예상 못 한 수확입니다.
부서를 만들려고 CLI 사용법을 문서에 적으려는데, 제가 아는 게 아니라 추측이라는 걸 알았습니다.
그래서 초안에 이렇게 표시했습니다.
> 추정: cys init-pack --dept / cys launch-agent --dept 플래그명. 설치 전 검증한다.
그리고 실제로 검증했습니다. 추정이 틀렸습니다.
| # | 추측 | 실측 |
|---|---|---|
| 1 | --dept 플래그로 부서 지정 | 플래그가 없다. 부서는 전용 소켓으로 갈린다 |
| 2 | init-pack으로 부서 생성 | 전용 도구 cys-dept가 단일 진입점. 직접 데몬 띄우면 레지스트리·정책 미시드 |
| 3 | 아무 노드나 부서 생성 가능 | 특정 역할(cso)이 아니면 기술적으로 차단된다. 지휘 노드는 스스로 부서를 못 만든다 |
| 4 | 정책 파일을 미리 배치하면 됨 | 부서 기동이 매번 정책 파일을 덮어쓴다. 커스텀 정책은 기동 이후에, 재기동마다 재적용 |
| 5 | 기존 부서의 정책 패턴을 복사 | 그 패턴이 매칭되지 않는다 (아래) |
5번이 제일 값나갑니다.
기존 개발 부서의 통신 정책에 "from": "reviewer-*" 라고 적혀 있었습니다.
그래서 저도 복사했습니다. 그런데 실제 역할 ID는 reviewer — 하이픈이 없습니다.
reviewer-*는 reviewer와 매칭되지 않습니다. 그 규칙은 죽어 있습니다.
즉 **기존 개발 부서에서도 "리뷰어는 작업자를 직접 조향할 수 없다"는 규칙이
지금까지 작동하지 않고 있었을 가능성이 높습니다.** 제 부서는 reviewer*로 고쳤고,
기존 부서 건은 별건으로 보고 대상에 올렸습니다.
정책 파일에 규칙을 적는 것과 그 규칙이 발동하는 것은 다릅니다.
BEFORE 편의 "게이트를 만든 것과 통과한 것은 다르다"와 정확히 같은 실수를,
다른 층에서 또 하고 있었습니다.
### 이걸 어떻게 찾았나 — 방법이 재현 가능합니다
특별한 재능이 아닙니다. 순서가 이랬습니다.
1. 문서를 쓰다가 "내가 이걸 확인했나?" 를 물었다
2. 확인 안 한 것을 문서에 "추정"으로 표시했다 (지우지 않고 남겼다)
3. 그 표시를 목록으로 만들었다
4. 하나씩 실제로 실행해서 대조했다
5. 5개가 틀렸다
핵심은 2번입니다. 모르는 것을 아는 것처럼 쓰지 않고,
"모른다"를 문서에 남겨두면 나중에 그게 점검 목록이 됩니다.
그리고 남은 미검증 1건도 그대로 적어뒀습니다:
같은 소켓에 리뷰어 2개(다른 AI 두 종류)가 공존 가능한지 — 아직 모릅니다.
역할 이름을 키로 쓰는 구조면 두 번째가 첫 번째를 밀어낼 수 있습니다.
기동 후 상태 조회로 확인할 예정이고, 공존 불가면 라운드별 교체 운용으로 바꿉니다.
---
## 코드 못 읽는 분을 위한 요약
네 문장입니다.
1. 규칙과 충돌하는 걸 넣어야 할 때, 규칙을 풀지 말고 옆에 다른 방을 만드세요.
"모든 인용은 원문에서" 규칙과 "인사이트는 원문에 없다"가 충돌했습니다.
규칙을 풀면 시스템이 무의미해집니다. 대신 근거의 종류가 다른 칸을 만들고
그 칸에는 다른 검사를 붙였습니다. 추적은 한 단계 늘어난 것뿐입니다.
2. 연결하려면 먼저 "비슷하다"를 알 수단이 있어야 합니다.
저는 연결 기능부터 만들려 했는데, 검색이 글자 겹침 방식이라
"달란트"와 "재능"을 못 붙였습니다. 순서를 바꿔야 했습니다.
3. 규칙을 문서에 쓰는 것으로는 안 지켜집니다. 저는 규칙을 알고도 14번 반복했습니다.
지켜지게 하려면 구조로 만들어야 합니다 — 누가 누구에게 지시할 수 있는지,
무엇을 실행할 권한이 없는지를 설정 파일에 박는 것.
4. 모르는 것을 문서에 "모름"으로 남기세요. 나중에 그게 점검 목록이 됩니다.
추측을 "추정"으로 표시해뒀다가 하나씩 확인해서 5개가 틀린 걸 찾았습니다.
그중 하나는 다른 팀에서도 규칙이 작동하지 않고 있던 문제였습니다.
확신 있게 쓴 문장은 아무도 다시 확인하지 않습니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


"규칙을 풀면 시스템의 존재 이유가 사라진다"는 전제를 붙들고 derived 계층이라는 탈출구를 만든 설계가 인상적이에요. 특히 안전핀으로 꼽으신 "파생 주장은 원문 인용을 직접 가질 수 없다"는 제약이 핵심이라고 느꼈어요 — 이걸 허용하는 순간 계층 분리가 아니라 게이트 우회가 되는 구조를 정확히 짚으셨네요. 관계 유형 8종이 스키마에 선언돼 있었는데 영상 간 관계를 실제로 계산하는 코드는 0줄이었다는 발견, 그리고 모순 검사가 "이미 선언된 모순만 확인하는 수동 체커"였다는 부분에서 실전 검증이 뚫리는 지점을 정확히 짚으셨다고 생각했어요. 다음 편(실제 에이전트 분리로 규칙 준수를 강제하는 부분)도 기다려집니다.
꼬리 탁! 치고 응원하고 갈게요 🐈⬛