AI 결과물 검수를 위한 평가·리뷰 하네스 만들기 2주차 (1/2): 검사기를 만들었는데 합격품이 0개였습니다 - 지식베이스 검증 단계별 가이드: 데이터 품질과 시스템 승인

2026.08.05
한 줄 요약
"게이트가 의도대로 fail-closed 했다"고 보고서에 썼습니다. 사실은 그 게이트를 한 번도 통과한 적이 없었습니다.
같은 사실을 두 가지로 읽을 수 있습니다.
- 읽기 A: 품질 미달 데이터가 정본에 들어가는 걸 막았다 → 성공
- 읽기 B: 정본에 들어간 데이터가 0건이다 → 지식베이스가 비어 있다
저는 A만 보고 있었습니다. B를 확인한 건 한참 뒤였습니다.
---
만든 것 (숫자로)
먼저 안 만들었다는 얘기가 아닙니다. 실제로 있는 것:
| 항목 | 수량 |
|---|---|
| Python·PowerShell 코드 | 7,363줄 |
| 스킬 (라우터 1 + 하위 7) | 8개 |
| JSON 스키마 | 8종 |
| CLI 커맨드 | 12개 |
| 도메인/작업 프로필 | 2종 |
| 결정론적 하드 체크 | 13종 |
| 전역 하드 게이트 | 10종 |
| 자동 테스트 | pytest 39 + PowerShell 5 |
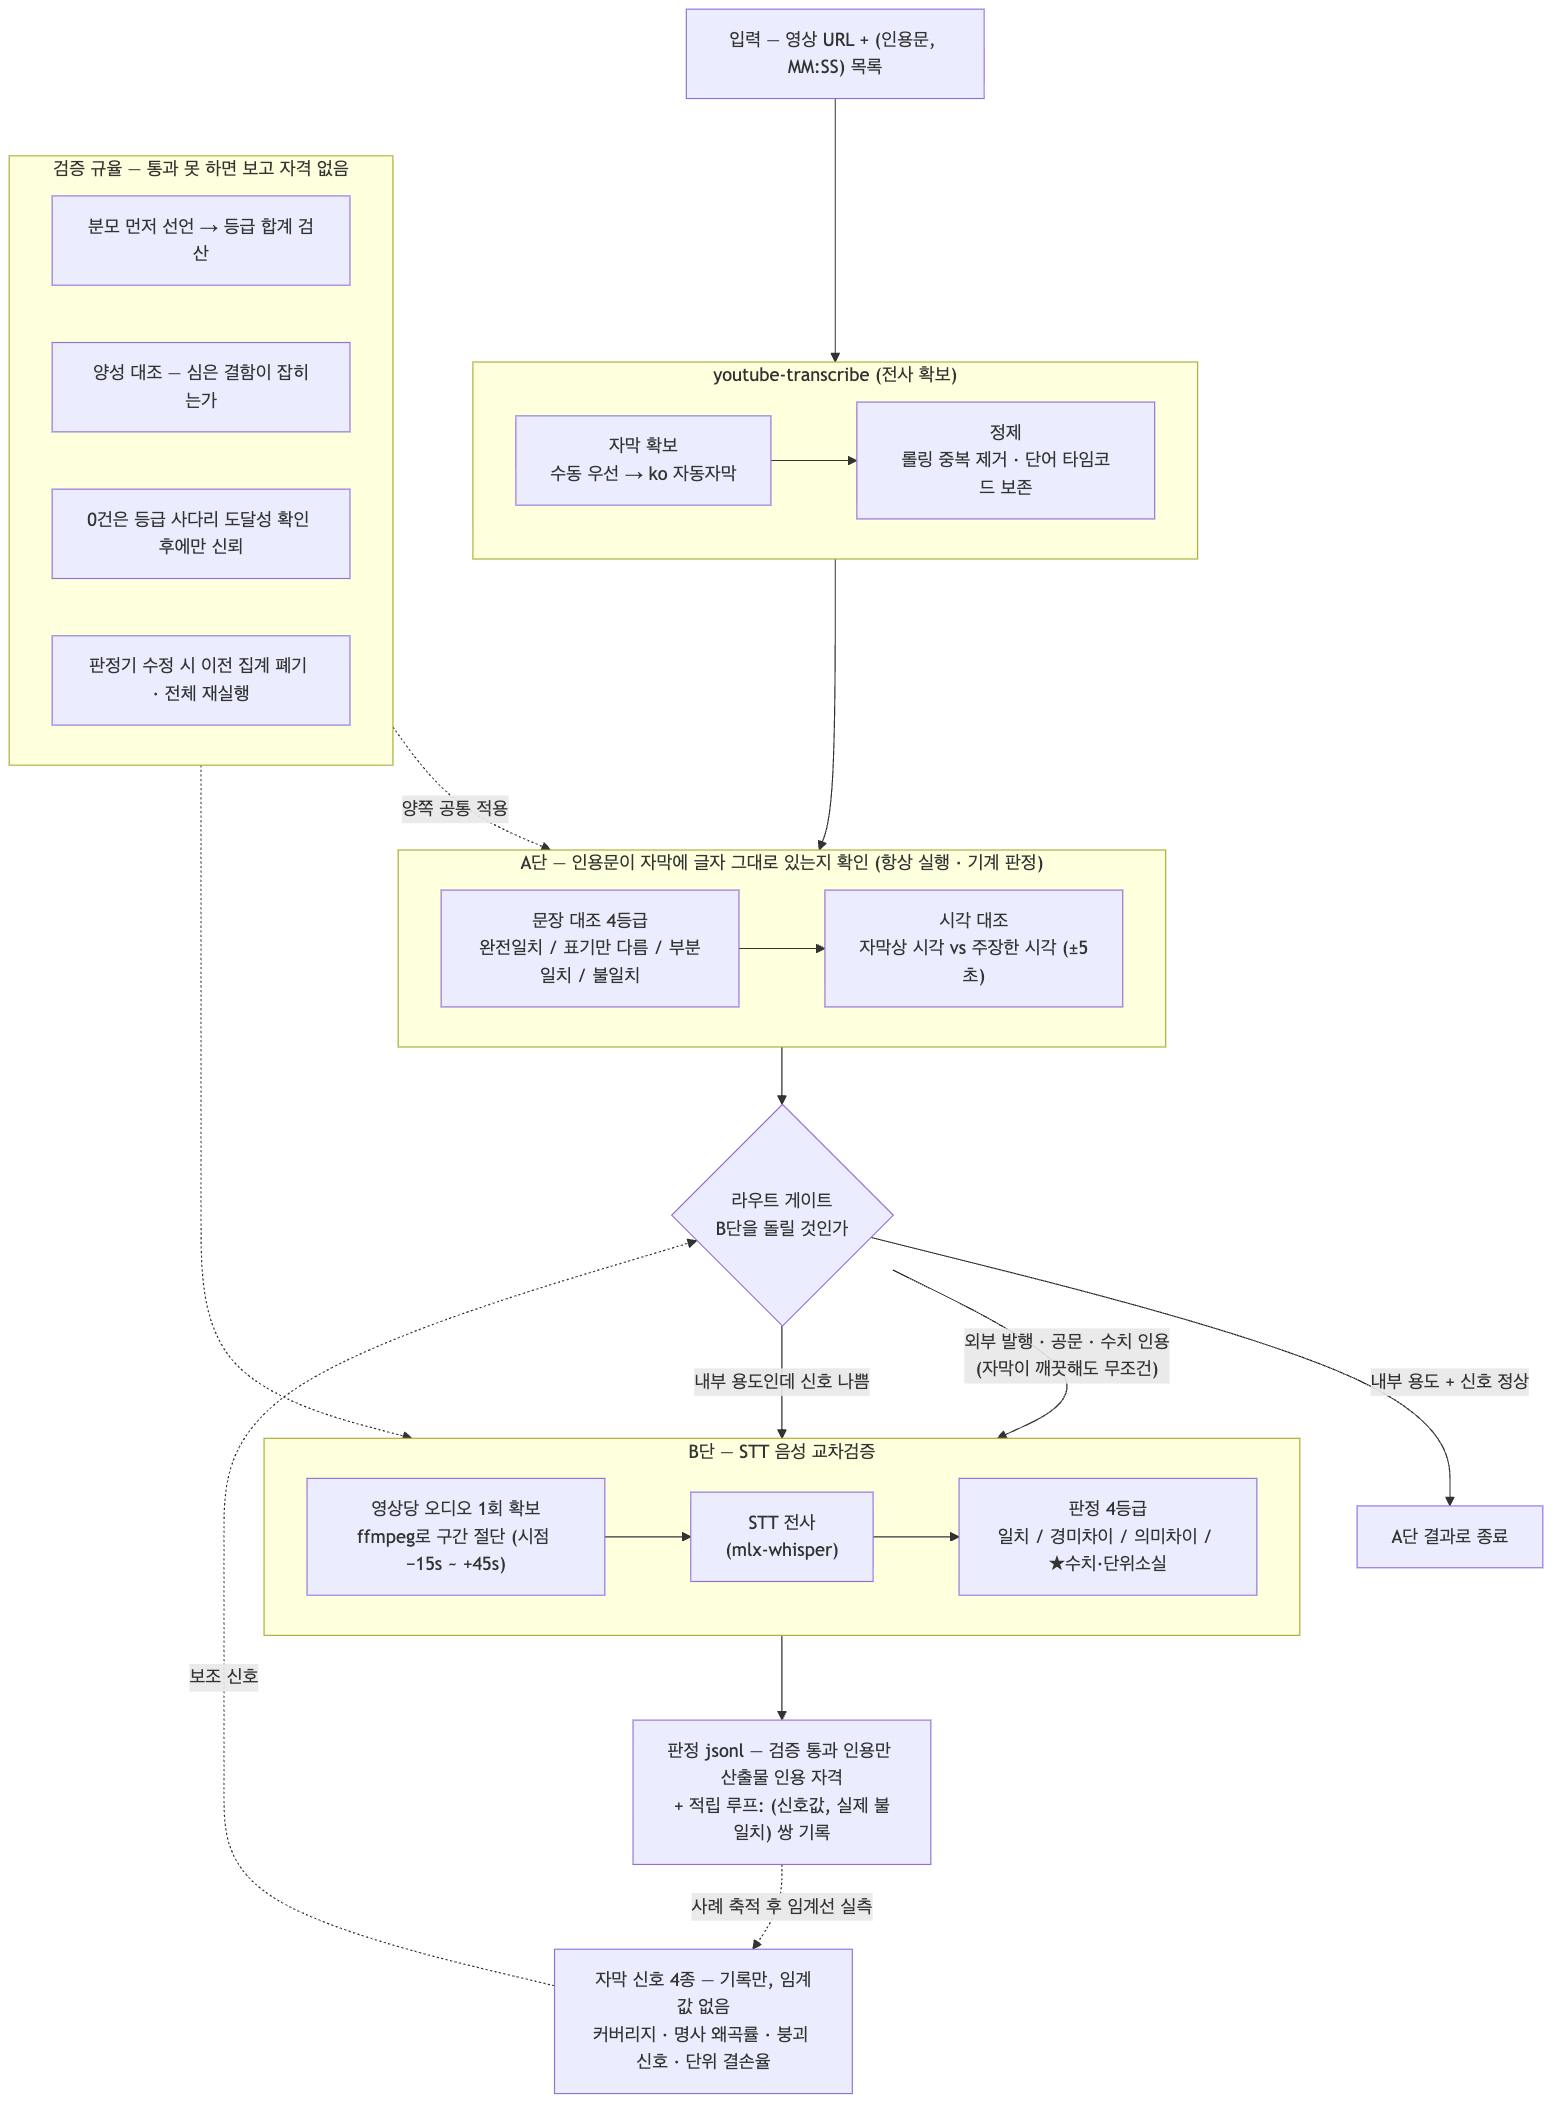
설계도 나름 촘촘했습니다. 파이프라인은 이렇습니다.
```
캡처 → 추출 → 결정론적 검증 → 다른 AI의 독립 검토 → 사람 승인 → 정본 승격 → 조회
```
핵심 규칙 두 개가 이 시스템의 존재 이유입니다.
1. 모든 주장(Claim)은 원문의 인용 구간(Evidence)을 하나 이상 가져야 한다.
근거 없는 문장은 애초에 들어갈 수 없습니다.
2. 기계 검토가 통과해도 그건 승인이 아니다. 사람이 명시적으로 승인해야 정본이 됩니다.
여기까지는 잘 굴러갔습니다. 실제 인문학 강연 1편을 넣어서
12 Beat / 37 Claim / 41 Evidence / 24 Term을 뽑았고,
인용 41건을 원문과 대조해 41/41 일치, 결정론적 검사 13/13 PASS를 받았습니다.
승인 없이 승격을 시도하는 dry-run은 exit code 2로 정확히 막혔습니다.
차단 사유도 명확했습니다: independent review must PASS before approval.
그래서 결과 보고서에 이렇게 썼습니다.
> "시스템이 의도대로 fail-closed한 결과이며, 실제 승인이나 정본 변경은 없다."
문장 자체는 사실입니다. 그런데 이 문장이 가리고 있는 것이 있었습니다.
---
실제로 세어보니
한참 뒤에 워크스페이스를 직접 열어서 세어봤습니다.
| 세어본 것 | 결과 |
|---|---|
| 캡처된 소스 | 3건 |
| 만들어진 후보 패키지 | 18개 |
| 정본으로 승격된 것 | 0건 |
| claims/index.json | 없음 |
마지막 줄이 문제입니다. 이 파일이 없으면 조회 기능이 작동하지 않습니다.
코드를 보면 이렇게 되어 있습니다.
```python
def loadindex(pkm_root):
path = Path(pkm_root) / "claims" / "index.json"
value = load_json(path) # ← 파일이 없으면 여기서 죽는다
...
raise PKMError("claim_index_invalid", "global Claim index is malformed")
```
즉 "지식베이스에서 찾기"라는 기능은 지금까지 단 한 번도 성공한 적이 없습니다.
성공할 수가 없었습니다. 찾을 대상이 0건이니까요.
파이프라인을 다시 그리면 이렇게 됩니다.
```
캡처 ✅ → 추출 ✅ → 결정론 검증 ✅ → 독립 검토 ❌ ··· 승인 ⬜ 승격 ⬜ 조회 ⬜
└─ 여기서 18번 멈췄다
```
앞 절반만 실전 검증된 시스템이었습니다.
---
14번 고쳤는데 왜 안 됐나
여기가 이 글에서 제일 부끄러운 부분입니다.
독립 검토(다른 AI가 원문과 대조해서 채점)가 NEEDS_CHANGES를 낼 때마다,
지적사항을 반영한 수정 명세를 만들어서 다시 돌렸습니다. 그 파일들이 남아 있습니다.
```
reports/review-remediations/
HXWmHuf_k68-evidence-remediation-v1 ~ v9.spec.json (9개)
HXWmHuf_k68-opus-remediation-v1 ~ v4.spec.json (4개)
HXWmHuf_k68-structured-remediated-v1 ~ v14.json (14개)
```
수정 명세 13건, 재빌드 14회. 그리고 여전히 NEEDS_CHANGES입니다.
각 회차는 정당해 보였습니다. 지적이 오면 고치고, 고치면 다시 돌리고.
문제는 14번째 시도를 하는 시점에도 "다음엔 될 것 같다"고 생각하고 있었다는 겁니다.
3번 실패했을 때 물어야 했던 질문을 14번째까지 하지 않았습니다.
> 이게 고칠 수 있는 결함인가, 아니면 애초에 통과할 수 없는 구조인가?
지금 남은 지적사항 3건을 보면 성격이 드러납니다.
1. 진행자 실명이 영상 메타데이터에서 추론한 것인데 그렇게 표시되지 않았다
2. 문학 작품 해석이 누구의 해석인지 명시되지 않았고, 노트 작성자의 종합인지 구분이 안 된다
3. 판매 수치의 단위·반올림 설명이 부족하다
1번과 2번은 "누가 말했는가" 문제입니다. 그런데 제 시스템에는
화자를 확정할 수단이 없습니다. speaker 필드는 스키마에 있지만,
그 값을 근거 있게 채울 방법이 구현되어 있지 않습니다.
즉 검토자는 시스템이 원리적으로 만족시킬 수 없는 것을 요구하고 있었습니다.
수정 명세를 100번 써도 안 됩니다. 14번은 그걸 확인하는 데 든 비용입니다.
---
더 나쁜 발견 — 안 돌려본 코드 641줄
승격을 담당하는 promote.py는 641줄입니다.
그리고 승격이 0건이라는 건, 이 641줄이 실전에서 한 번도 실행되지 않았다는 뜻입니다.
테스트는 있습니다. 39개 통과합니다. 하지만 테스트는 제가 상상한 상황만 검사합니다.
실제 승격은 원자적 파일 이동, 인덱스 생성, 이력 append, 모순 검사를 한꺼번에 합니다.
첫 실행에서 깨질 가능성이 충분히 높은 코드를, 저는 "구현 완료"로 세고 있었습니다.
같은 이유로 미검증인 것들:
- 조회(`lookup`) — 인덱스가 없어서 실행 불가
- 인포그래픽 내보내기 — 승격된 패키지가 없어서 실행 불가
"구현 완료"라고 센 항목의 뒤쪽 3분의 1이 실행된 적 없는 코드였습니다.
---
그리고 버전 관리가 없었습니다
이건 세어보다가 알았습니다.
이 프로젝트는 불변성과 감사 추적을 핵심 가치로 내세운 시스템입니다.
원본은 절대 덮어쓰지 않고, 모든 파생 데이터는 원문 해시에 묶이고,
프로필 버전이나 프롬프트 버전이 바뀌면 새 패키지가 생깁니다.
그런데 그 프로필과 프롬프트 자체가 git으로 관리되지 않고 있었습니다.
패키지 버전을 계산하는 입력에 프로필@버전과 프롬프트 버전이 들어갑니다.
그 두 개의 변경 이력이 어디에도 없으면, 버전 계산의 근거가 사라집니다.
남아 있던 것:
- traceable-pkm copy/ — 정체불명 중복 디렉터리
- __pycache__/, .pytest_cache/ — 정리 안 된 산출물
추적성을 파는 도구가 스스로는 추적되지 않고 있었습니다.
---
왜 이렇게 됐나 — 제 판단 착오 3개
① 게이트가 막은 것을 성과로 셌다
게이트가 작동하는 것과 시스템이 작동하는 것은 다릅니다.
전자는 후자의 필요조건일 뿐입니다.
"막았다"는 좋은 신호가 될 수도 있고, "아무것도 통과 못 한다"는 나쁜 신호일 수도 있습니다.
둘을 구분하는 건 딱 하나입니다: 통과한 사례가 최소 1건 있는가.
0건이면 게이트를 검증한 게 아니라 게이트만 만든 것입니다.
② 보고서를 근거로 삼았다
"pytest 39 passed"는 2026-07-29자 보고서에 적힌 값입니다.
저는 그 뒤로 이 문장을 재실행 없이 계속 인용했습니다.
문서에 적힌 통과 기록은 그 시점의 관측입니다. 현재 상태가 아닙니다.
지금 상태를 알려면 지금 돌려야 합니다.
③ 실패 반복을 진척으로 착각했다
v1 → v14는 진척처럼 보입니다. 뭔가 계속 하고 있으니까요.
하지만 같은 게이트에서 같은 이유로 막히는 반복은 진척이 아니라 같은 자리 맴돌기입니다.
구분 기준은 이겁니다: 실패 사유가 회차마다 바뀌는가.
바뀌면 전진, 안 바뀌면 구조 문제.
---
코드 못 읽는 분을 위한 요약
세 문장입니다.
1. 검사 장치를 만들었는데 합격품이 0개면, 그건 검사 장치를 시험한 게 아닙니다.
불량품을 걸러낸 게 아니라 아직 아무것도 만들지 못한 것일 수 있습니다.
구분법: 합격 사례가 1건이라도 있는지 보세요.
2. 같은 이유로 3번 막히면, 고치는 걸 멈추고 "이게 고칠 수 있는 문제인가"를 물으세요.
저는 14번 만에 물었습니다. 11번은 낭비였습니다.
심사위원이 요구하는 걸 원리적으로 제출할 수 없는 상황일 수 있습니다.
3. "지난주에 확인했다"는 확인이 아닙니다.
문서에 적힌 통과 기록은 그때의 사진입니다. 지금 상태는 지금 봐야 압니다.
---
다음 편
이 진단으로 두 가지가 분명해졌습니다.
- 수집 파이프라인의 뒤쪽 절반을 뚫어야 한다 (승인 → 승격 → 조회)
- 그런데 원래 하려던 "인사이트 추출·기존 지식과의 연결" 은 더 큰 문제를 안고 있다 —
인사이트는 정의상 원문에 그대로 없는 문장이라서, 위에서 말한 규칙 1
(모든 주장은 원문 인용을 가져야 한다)과 정면으로 충돌합니다.
게이트를 풀면 이 시스템은 존재 이유를 잃습니다. 풀지 않고 어떻게 하는지가 다음 편입니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


보고서에 "시스템이 의도대로 fail-closed했다"고 쓴 문장이 사실이면서 동시에 문제를 가리고 있었다는 부분 — 읽기 A와 읽기 B로 나눈 것이 이 글에서 제일 날카로운 대목이었어요.
14번 수정 시도에서도 "다음엔 될 것 같다"고 생각했다는 것, 솔직하게 적은 게 이 글을 더 단단하게 만들어요. "실패 사유가 회차마다 바뀌는가"로 전진과 맴돌기를 구분하는 기준, 그리고 "원리적으로 만족시킬 수 없는 것을 요구하는 상황"인지 3번째에 물었어야 했다는 교훈 — 둘 다 다음 작업에 바로 쓸 수 있는 판단 기준이에요.
"추적성을 파는 도구가 스스로는 추적되지 않고 있었다"는 문장이 오래 남을 것 같습니다. 다음 편도 기대돼요.
꼬리 탁! 치고 응원하고 갈게요 🐈⬛