대시보드보다 먼저 한 일: AI 에이전트와 11만 행의 데이터 검증

2026.07.27
1주차를 놓친 뒤, AI 에이전트와 실데이터 11만 행을 검증한 과정
한 줄 요약
1주차 라이브 세션에 참여하지 못했지만, AI 에이전트와 영상·공유 자료를 다시 살펴보며 실습을 따라잡았습니다. KB부동산 통계와 주식·ETF 실데이터 110,922행을 DuckDB에 저장하고, 기간·결측·중복·이상값까지 검증했습니다.
소개
첫 수업부터 놓쳤다
GPTers 23기 데이터대시보드 스터디를 신청했지만, 첫 라이브 세션에 참여하지 못했습니다.
뒤늦게 공유 자료를 열어보니 Python, uv, DuckDB, PublicDataReader, FinanceDataReader처럼 익숙하지 않은 이름이 한꺼번에 등장했습니다.
처음에는 막연히 이렇게 생각했습니다.
데이터를 내려받아 표로 만들면 되는 것 아닐까?
하지만 1주차 영상과 실습 자료를 다시 확인하면서, 이번 주의 핵심은 예쁜 차트를 만드는 데 있지 않다는 것을 알게 됐습니다.
중요한 것은 외부 데이터를 실제로 수집하고, 원본을 보존한 채 데이터베이스에 저장한 다음, 그 데이터를 정말 믿고 사용할 수 있는지 확인하는 과정이었습니다.
정리하면 다음과 같았습니다.
환경 구성
→ 실데이터 수집
→ DuckDB 저장
→ 저장한 데이터 다시 읽기
→ 기간·결측·중복·이상값 검증
라이브 세션을 놓친 상태에서 이 과정을 혼자 처음부터 따라가기에는 부담이 있었습니다. 그래서 제가 운영 중인 Hermes Agent ‘하나코’에게 영상과 공유 자료를 먼저 검토하게 하고, 실습 실행과 증거 화면 정리까지 함께 진행했습니다.
실제로 전달한 요청은 단순했습니다.
1주차 영상을 확인하고 공유된 환경 세팅·실습 자료를 기준으로 직접 실습해줘.

실제 데이터만 사용하고,
중간에 필요한 화면은 나중에 글에 넣을 수 있도록 남겨줘.

API가 실패하면 가짜 데이터로 성공한 것처럼 만들지 마.
이번 실습의 목표는 단순히 1주차 진도를 따라잡는 것이 아니었습니다.
다음 주 대시보드에 넣어도 되는 데이터를 어디까지 준비했는지 확인하는 것이 진짜 목표였습니다.
이런 분들께 도움이 될 것 같아요
스터디나 강의를 놓친 뒤 어디서부터 따라가야 할지 막막한 분
직접 코드를 모두 작성하기보다 AI와 대화하며 데이터 실습을 진행하고 싶은 분
데이터를 수집하는 것과 검증하는 것이 어떻게 다른지 궁금한 분
API가 막혔을 때 가짜 결과 없이 현재까지의 진행 상황을 남기고 싶은 분
진행 방법
1. 코드를 실행하기 전에 영상과 자료부터 맞춰봤다
라이브 세션을 놓쳤기 때문에 곧바로 코드를 실행하지 않았습니다.
먼저 1주차 영상 자막을 확인한 뒤, 다음 자료와 내용을 교차 검토했습니다.
00-setup.md: uv 기반 프로젝트 환경과 완료 조건02-handout.md: 부동산·KB·주식 데이터 수집 및 DuckDB 검증 절차01-visualization-guide.html: 이후 대시보드에서 사용할 시각화 검수 기준
자동 생성된 영상 자막에서는 DuckDB나 Polars 같은 기술명이 다르게 인식된 부분도 있었습니다. 따라서 전체 흐름은 영상을 통해 파악하고, 실제 명령어와 패키지 이름은 공유 문서를 기준으로 바로잡았습니다.
AI에게 영상을 요약해 달라고 요청하는 데서 끝내지 않고, 영상과 문서에서 확인한 내용을 실제로 실행할 수 있는 순서로 다시 정리한 것입니다.
2. 프로젝트 전용 환경을 만들었다
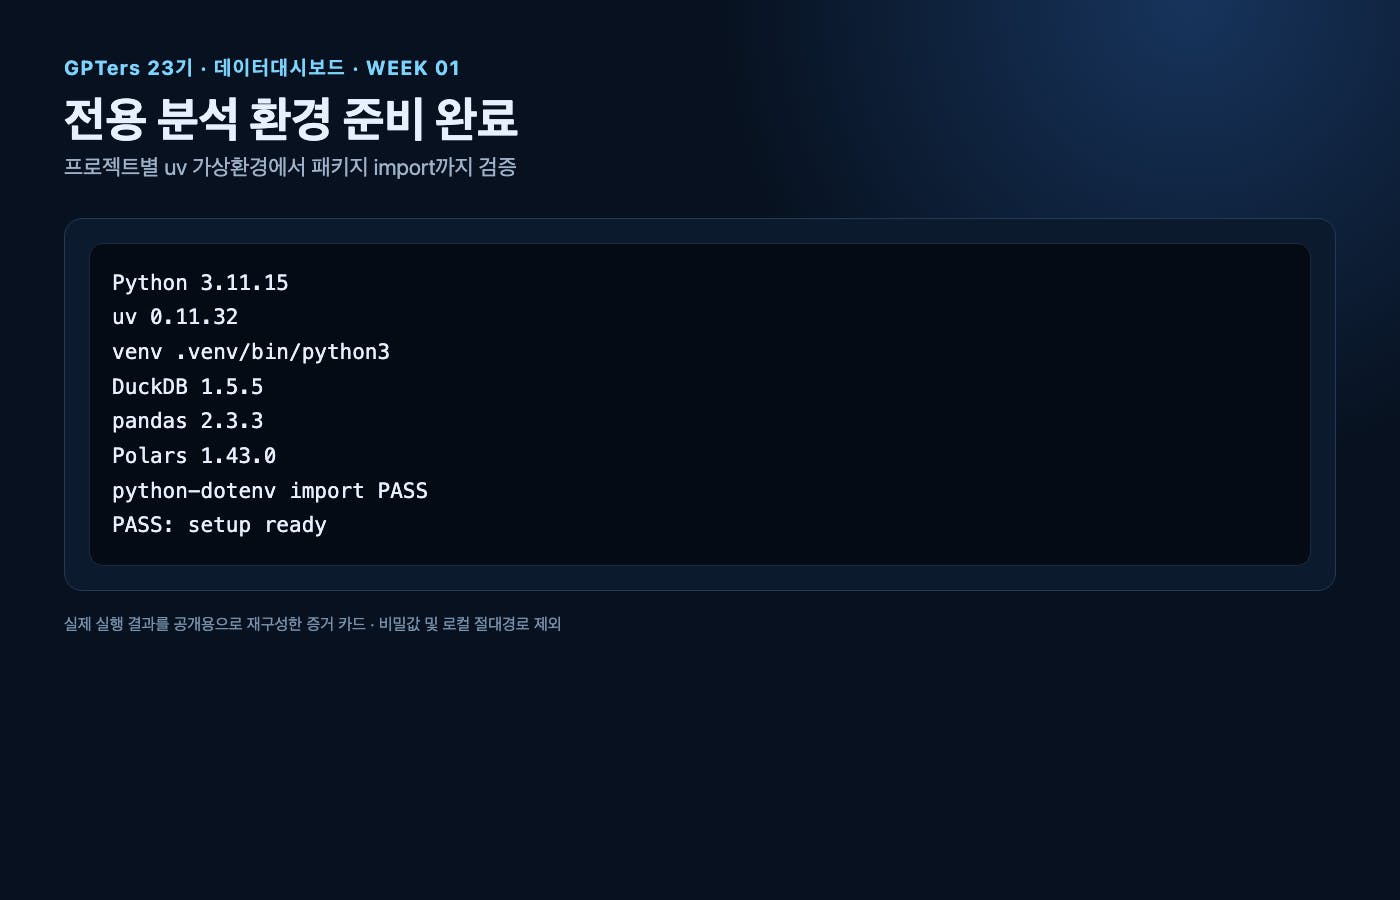
전역 Python 환경을 직접 변경하지 않고, 프로젝트별 uv 가상환경을 구성했습니다.
확인한 환경은 다음과 같습니다.
Python 3.11.15
uv 0.11.32
DuckDB 1.5.5
pandas 2.3.3
Polars 1.43.0
python-dotenvimport 성공
환경 설정이 끝난 뒤에는 공유 자료에 제시된 완료 조건과 같은 메시지를 확인했습니다.
PASS: setup ready캡션: 프로젝트 전용 가상환경에서 Python과 주요 데이터 패키지의 버전 및 import 여부를 확인했습니다.
이 단계에서 DuckDB는 단순히 데이터를 담아두는 저장소가 아니었습니다.
수집한 데이터를 테이블로 저장하고, 다시 읽어 행 수와 품질을 확인할 수 있게 해주는 검증의 기준점 역할을 했습니다.
3. KB부동산 통계와 주식·ETF 데이터를 수집했다
이번에 실제로 수집한 데이터는 크게 두 종류였습니다.
KB부동산 통계
월간 아파트 매매가격지수
월간 아파트 전세가격지수
아파트 전세가율
KB 통계는 기본 조회 결과만 저장하지 않았습니다.
시도별 지역코드로 추가 조회한 뒤, 지역코드-날짜를 기준으로 중복을 제거했습니다.
그 결과 다음 지역 수의 데이터가 저장됐습니다.
매매가격지수: 285개 지역
전세가격지수: 285개 지역
전세가율: 289개 지역
주식·ETF 가격 데이터
삼성전자:
005930KODEX 200:
069500요청 기간: 2025년 1월 1일~2026년 6월 30일
요청할 때는 종목과 기간을 숫자로 명확하게 지정했습니다.
삼성전자 005930과 KODEX 200 069500을
2025-01-01부터 2026-06-30까지 수집해줘.
두 종목은 각각 362행씩, 총 724행이 수집됐습니다.
삼성전자 종목코드 005930은 숫자가 아니라 문자열로 저장해 앞자리 0이 사라지지 않도록 했습니다.
4. DuckDB에 저장한 뒤 다시 열어 확인했다
수집 결과를 화면에 출력하는 것만으로는 데이터가 제대로 저장됐다고 판단하기 어려웠습니다.
그래서 저장과 검증을 한 번에 요청했습니다.
DuckDB에 저장한 뒤 다시 읽어서
행 수, 실제 기간, 결측값과 중복을 보여줘.
저장 작업이 끝난 뒤에는 DuckDB 파일을 읽기 전용 모드로 다시 열어 테이블별 행 수를 확인했습니다.
저장 전과 저장 후의 행 수가 같은지도 비교했습니다.
현재 하나의 DuckDB 파일에는 다음 네 개 테이블이 들어 있습니다.
테이블 | 행 수 | 실제 기간 | 중복 |
|---|---|---|---|
KB 매매가격지수 | 7,125 | 2024-06-01~2026-06-01 | 0 |
KB 전세가격지수 | 7,125 | 2024-06-01~2026-06-01 | 0 |
KB 전세가율 | 95,948 | 1998-12-01~2026-07-01 | 0 |
삼성전자·KODEX 200 가격 | 724 | 2025-01-02~2026-06-30 | 0 |
합계 | 110,922 |
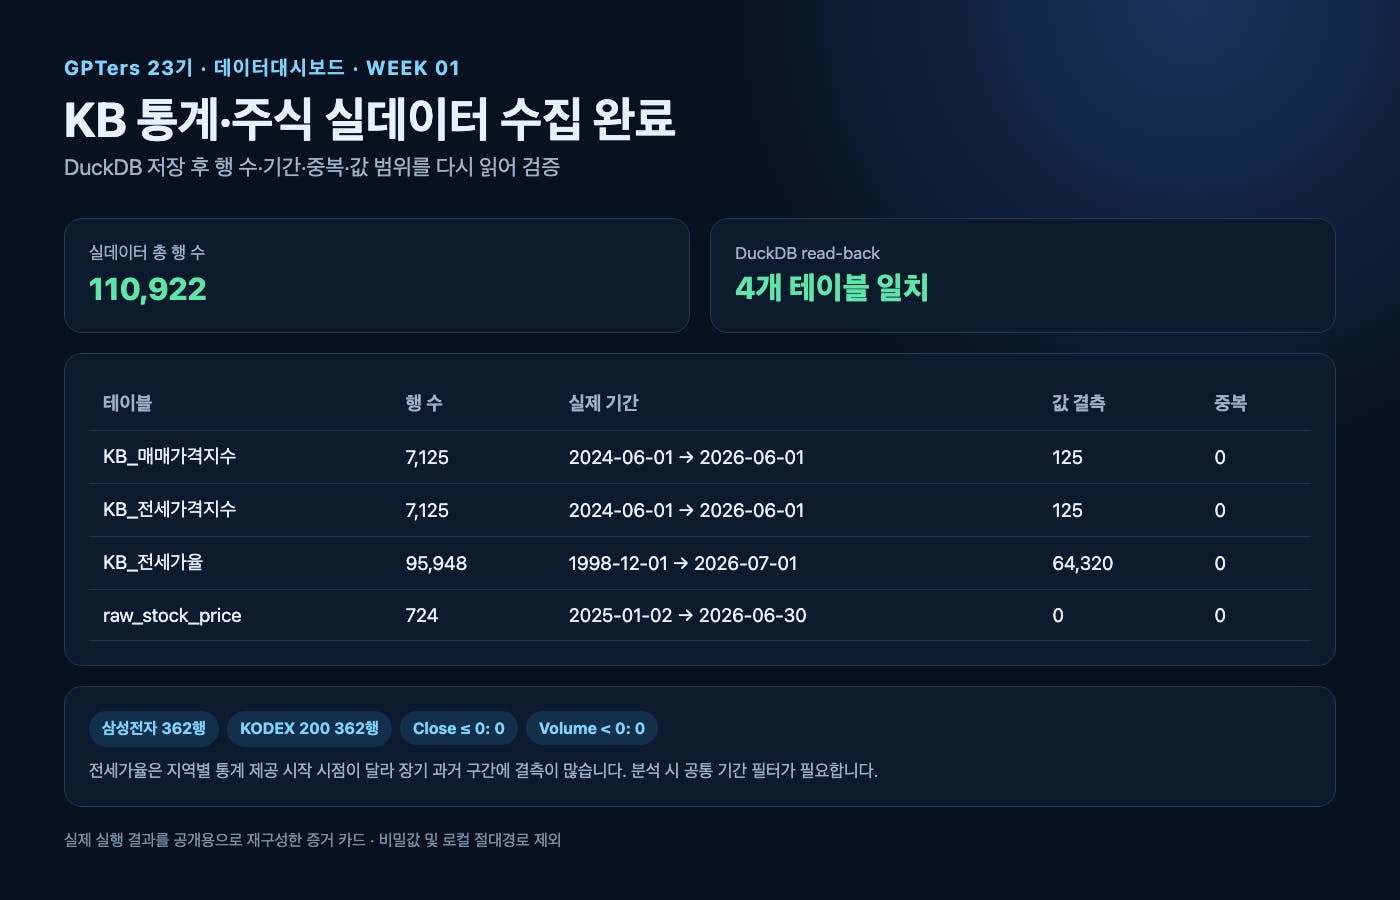
캡션: DuckDB 저장 후 테이블별 행 수, 실제 기간, 값 결측과 중복 여부를 다시 읽어 확인했습니다.
주식 데이터에서는 값의 범위도 함께 확인했습니다.
종가가 0 이하인 행: 0건
거래량이 음수인 행: 0건
삼성전자 종목코드 앞자리
0보존두 종목 모두 362행 수집
5. 많이 모은 것보다, 어디가 비어 있는지 확인했다
처음에는 110,922행이라는 숫자가 가장 눈에 들어왔습니다.
하지만 검증 결과를 살펴보니 더 중요한 숫자가 따로 있었습니다.
KB 매매가격지수 값 결측: 125건
KB 전세가격지수 값 결측: 125건
KB 전세가율 값 결측: 64,320건
특히 전세가율은 1998년부터 이어지는 긴 시계열이지만, 모든 지역이 같은 시점부터 데이터를 제공하는 것은 아니었습니다.
최근에 생긴 행정구역이나 통계 제공이 늦게 시작된 지역은 과거 구간의 값이 비어 있었습니다.
따라서 행 수가 많고 기간이 길다는 이유만으로 모든 지역을 그대로 비교해서는 안 됐습니다.
결측값을 무조건 0으로 채우거나, 값이 없는 구간까지 선으로 이어버리면 실제로 존재하지 않았던 흐름을 만들어낼 수 있기 때문입니다.
다음 주 대시보드에서는 다음 기준을 적용할 예정입니다.
지역별 실제 관측 시작점 표시
여러 지역을 비교할 때 공통으로 값이 존재하는 기간 사용
결측 구간을 임의로 연결하지 않기
데이터에서 직접 관찰한 사실과 해석을 구분해 설명하기
이번 실습에서 가장 크게 바뀐 생각은 이것이었습니다.
데이터가 많다는 것보다, 어디가 비어 있는지 알고 사용하는 것이 더 중요하다.
6. 한 번 실행한 코드가 아니라 다시 확인할 수 있는 기반을 만들었다
수집 코드를 한 번 실행하고 끝내면, 조건이나 환경이 바뀌었을 때 같은 결과가 나오는지 알기 어렵습니다.
그래서 수집과 저장 과정의 주요 동작을 자동 테스트로 확인했습니다.
삼성전자 종목코드의 앞자리
0보존기존 DuckDB 테이블을 실수로 덮어쓰지 않기
저장한 테이블의 행 수를 다시 읽어 확인하기
결측값과 중복 행 계산
원본 데이터를 수정하지 않고 파생 컬럼 만들기
아파트 매매·전월세 요청 범위 고정
최종 테스트 결과는 다음과 같았습니다.
8 passed이로써 데이터를 한 번 받아본 것에서 끝나지 않고, 다시 실행하고 검증할 수 있는 수집 기반을 마련했습니다.
7. API가 막혔을 때 가짜 데이터로 채우지 않았다
모든 작업이 계획대로 끝난 것은 아니었습니다.
아파트 매매·전월세 실거래가를 수집하려면 공공데이터포털 인증키가 필요했습니다. 두 API의 일반 인증키는 발급받았지만, 마감 시점까지 인증키를 프로젝트의 .env에 안전하게 연결하지 못했습니다.
이때 선택지는 두 가지였습니다.
임의 데이터를 만들어 여섯 개 테이블이 모두 완성된 것처럼 보이게 하기
실제로 완료한 네 개 테이블만 남기고, 나머지 두 개는 미완료로 표시하기
저는 두 번째를 선택했습니다.
AI에게도 실패했을 때 하지 말아야 할 행동을 명확하게 전달했습니다.
API가 실패하면 가짜 데이터를 만들지 말고
오류와 현재 완료 범위를 보여줘.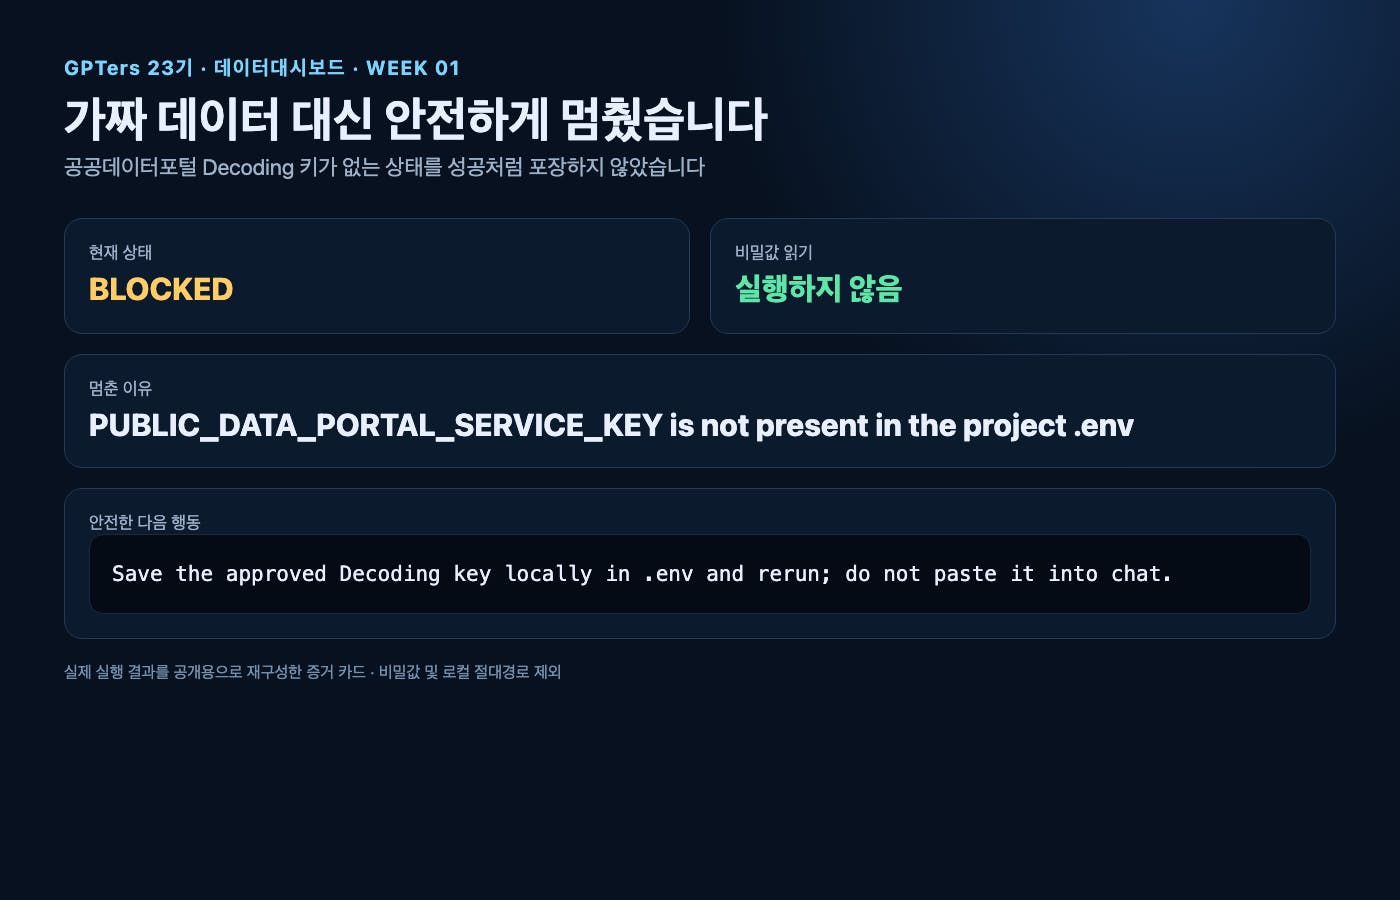
캡션: 인증키가 프로젝트에 연결되지 않은 상태에서는 가짜 데이터를 만들지 않고 명시적으로 중단하도록 했습니다.
현재 생성되지 않은 테이블은 다음 두 개입니다.
raw_apt_traderaw_apt_rent
완료하지 못한 점은 아쉽지만, 실패를 숨긴 데이터베이스보다 어디까지 실제 데이터인지 명확하게 설명할 수 있는 데이터베이스가 더 낫다고 판단했습니다.
결과와 배운 점
결과: 실데이터 110,922행을 모으고 품질까지 확인했다
이번 주의 가장 큰 성과는 단순히 많은 데이터를 수집한 것이 아닙니다.
KB부동산 통계 3종과 삼성전자·KODEX 200 실데이터 총 110,922행을 수집해 DuckDB의 네 개 테이블에 저장하고, 다음 항목을 숫자로 확인했습니다.
테이블별 행 수
실제 데이터 시작일과 종료일
주요 값의 결측 수
중복 행 수
주식 종목코드 보존 여부
종가와 거래량의 이상값
저장 전후 행 수 일치 여부
자동 테스트 8개 통과 여부
특히 전세가율 데이터에서 지역별 통계 제공 시작 시점이 달라 결측값이 많다는 사실을 발견했습니다.
이 발견을 통해 다음 대시보드에서 모든 지역을 같은 기간으로 단순 비교해서는 안 된다는 것을 알게 됐습니다.
결국 이번 주의 핵심 성과는 다음 문장으로 정리할 수 있습니다.
데이터를 많이 모은 것이 아니라, 어떤 기간과 지역을 비교해야 안전한지 확인했다.
Before vs After
구분 | Before | After |
|---|---|---|
1주차 학습 | 라이브 세션에 불참해 전체 흐름을 모름 | 영상과 자료를 실행 순서로 재구성 |
개발 환경 | 데이터 분석 프로젝트가 없음 | uv 기반 Python 3.11 전용 환경 구성 |
데이터 확인 | 각 제공처의 화면과 자료에 분산 | KB·주식 실데이터를 하나의 DuckDB에 저장 |
품질 기준 | 데이터가 존재하면 성공이라고 생각 | 기간·결측·중복·값 범위를 숫자로 확인 |
재사용 | 한 번 실행한 결과에 의존 | 다시 실행 가능한 수집·검증 코드와 테스트 확보 |
API 실패 | 어떻게든 결과를 채우고 싶었음 | 가짜 데이터를 만들지 않고 미완료로 명시 |
1. 첫 수업을 놓쳐도 실행 가능한 상태까지 복구할 수 있었다
이번 경험을 통해 수업을 한 번 놓쳤다고 해서 전체 흐름을 포기할 필요는 없다는 것을 알게 됐습니다.
AI 에이전트를 활용해 영상과 자료의 내용을 실행 순서로 정리하고, 환경 구성부터 실데이터 수집, DB 저장과 검증까지 이어갈 수 있었습니다.
다만 AI가 대신 실행했다는 이유만으로 결과를 그대로 믿어서는 안 됐습니다.
행 수, 기간, 결측, 중복과 같은 숫자와 저장 후 재확인 결과를 함께 남겨야 비로소 다음 작업에 사용할 수 있었습니다.
2. 데이터 수집과 데이터 신뢰성은 다른 문제였다
API가 10만 행을 반환했다고 해서 그 데이터를 바로 비교와 시각화에 사용할 수 있는 것은 아니었습니다.
특정 기간의 값이 비어 있거나, 지역별로 관측 시작 시점이 다르다면 동일한 조건의 비교가 아닐 수 있습니다.
이번 실습에서는 수집 행 수 자체보다 결측값의 구조를 발견한 것이 더 중요한 결과였습니다.
3. 미완료를 정확하게 표시하는 것도 하나의 결과였다
아파트 매매·전월세 실거래가 데이터까지 수집하지는 못했습니다.
하지만 가짜 데이터로 빈자리를 채우지 않았기 때문에 현재 데이터베이스에서 무엇이 실데이터이고, 무엇이 아직 준비되지 않았는지를 명확하게 구분할 수 있습니다.
AI와 작업할 때는 원하는 결과뿐 아니라 실패했을 때의 기준도 함께 전달해야 한다는 점을 배웠습니다.
4. 스터디를 따라잡는 과정 자체가 하나의 실습이었다
1주차 라이브 세션에 참여하지 못한 것은 아쉬웠지만, 오히려 영상과 자료를 다시 조합하고 직접 검증 기준을 세우면서 수업의 목표를 더 구체적으로 이해하게 됐습니다.
이번 주에는 대시보드를 만들지 않았습니다.
대신 다음 주에 차트를 만들 때 믿고 사용할 수 있는 입력 데이터가 무엇인지, 어떤 데이터는 주의해서 사용해야 하는지 확인했습니다.
다음에 할 일
발급받은 공공데이터 인증키를 로컬
.env에 안전하게 연결노원구 아파트 매매·전월세 데이터를 2025년 1월~2026년 6월 범위로 수집
raw_apt_trade,raw_apt_rent테이블 추가주소·추정평형·평형대·연식 파생 컬럼 검증
여섯 개 테이블의 최종 읽기 전용 QA
공통 기간과 결측 처리 기준을 적용한 2주차 대시보드 제작
처음에는 데이터를 많이 모으면 좋은 대시보드를 만들 수 있다고 생각했습니다.
하지만 이번 실습을 마친 뒤에는 이렇게 정리하고 싶습니다.
대시보드의 신뢰도는 차트에서 시작되지 않는다.
그 전에 어떤 데이터를 수집했고, 무엇을 검증했으며, 어디까지 믿을 수 있는지 설명하는 데서 시작된다.
도움 받은 글
1주차 공유 자료
00-setup.md1주차 공유 자료
02-handout.md시각화 검수 자료
01-visualization-guide.html

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요



라이브 세션을 놓친 상황에서도 영상과 공유 자료를 교차 검토해 실행 순서로 다시 구성하고, 11만 행이 넘는 실데이터를 DuckDB에 저장한 뒤 기간·결측·중복·이상값까지 숫자로 확인하신 과정이 정말 꼼꼼합니다. 특히 API 인증이 막혔을 때 가짜 데이터로 채우지 않고 완료 범위와 미완료 테이블을 명확히 남긴 판단이 인상적이었어요. 다음 대시보드를 믿고 만들 수 있는 기반을 제대로 마련하셨네요.