AI로 강연 슬라이드를 만들며 배운 것

2026.06.10
이번에 히브리서 강해라는 책의 내용탕으로 강연 슬라이드를 만드는 작업을 했습니다. 처음에는 단순히 "AI로 예쁜 슬라이드를 만들 수 있을까?" 정도의 문제라고 생각했는데, 실제로 해보니 생각보다 까다로운 일이었습니다.
작업 배경을 먼저 말하면
이번 작업은 히브리서 강해 내용을 바탕으로, 단순한 요약 슬라이드가 아니라 실제 강연에서 사용할 수 있는 시각 자료를 만드는 실험이었습니다.
출발점에는 세 가지 요구가 있었습니다.
강해 원문을 훼손하지 않을 것
청중이 한눈에 붙잡을 수 있는 핵심 메시지를 만들 것
참고 이미지처럼 차분하고 일관된 분위기의 슬라이드로 만들 것
처음에는 이 세 가지가 같은 방향이라고 생각했습니다.
내용을 잘 정리하고, 프롬프트를 잘 쓰고, 이미지를 여러 번 고치면 자연스럽게 좋은 결과가 나올 것 같았습니다.
그런데 실제로는 서로 긴장하는 지점이 많았습니다.
원문을 많이 남기면 화면이 빽빽해졌습니다.
화면을 깔끔하게 만들면 근거 문장이 사라졌습니다.
참고 이미지를 닮게 만들면 강의 내용보다 분위기가 앞섰습니다.
이미지 생성 도구가 좋아 보여도, 텍스트와 출처가 정확한지는 따로 검수해야 했습니다.
그래서 이번 시행착오는 "AI가 이미지를 잘 만들었나"의 문제가 아니라, 강의 내용과 원문 근거를 잃지 않으면서 어떻게 이미지 생성 워크플로우를 설계할 것인가의 문제였습니다.
아래는 그 과정에서 겪은 시행착오를 정리한 것입니다.
1. 원문과 출처를 먼저 계약하지 않으면, 뒤 단계에서 내용이 흔들린다
처음에는 기획서를 "슬라이드 만들기 전의 구성안" 정도로 생각했습니다.
그런데 실제로 해보니 기획서는 단순한 개요가 아니었습니다.
기획서가 원문 근거와 출처를 제대로 붙잡고 있지 않으면, 뒤 단계의 AI는 보기 좋은 문장을 만들면서 원문을 조금씩 바꿉니다. 어떤 문장이 직접 인용이고, 어떤 문장이 강연 메시지를 풀어쓴 것인지도 흐려집니다.
그래서 기획서의 역할을 다시 정의했습니다. 기획서와 제작 명세에는 최소한 이런 것이 남아야 했습니다.
원문 근거
성경 인용 또는 강의/책 출처
핵심 메시지와 직접 인용의 구분
원문 변형 여부를 검수할 수 있는 기준
이미지 생성 단계가 임의로 요약하거나 바꾸면 안 되는 문장
여기서 중요한 구분도 생겼습니다.
visible citation:
  화면에 보이는 출처 chip

internal provenance:
  기획서와 manifest에 반드시 남기는 원천 추적 정보
화면에 출처를 얼마나 크게 보일지는 디자인 문제일 수 있습니다.
하지만 기획서와 manifest 안에서 출처를 추적하는 것은 선택사항이 아니었습니다.
원문을 다룰 때도 같은 원칙이 필요했습니다. 핵심 메시지는 강연용 문장으로 다듬을 수 있지만, 근거 원문은 다릅니다.
핵심 메시지:
  강연 메시지형 문장으로 다듬을 수 있음

근거 원문:
  요약하지 않음
  변형하지 않음
  필요한 부분만 정확히 절취

출처:
  작더라도 추적 가능하게 남김
제가 처음에 놓친 것은 "짧게 만드는 것"보다 "어떤 문장은 절대 요약하면 안 되는지 구분하는 것"이었습니다.
2. 텍스트를 줄이는 문제가 아니라, 무엇을 반드시 남길지 정하는 문제였다
초기 슬라이드는 텍스트가 너무 많았습니다. 인용문도 많고, 강의 메모도 많고, 제작용 라벨까지 화면에 섞여 있어서 연구 노트처럼 보였습니다.
그래서 자연스럽게 이렇게 생각했습니다.
텍스트를 줄이면 좋아지겠구나.
그런데 텍스트를 줄이자 다른 문제가 생겼습니다.
디자인은 좋아졌는데, 강해의 근거와 밀도가 사라졌습니다.
결국 문제는 텍스트의 양이 아니었습니다. 텍스트의 역할이 섞여 있었던 것이 문제였습니다.
그래서 텍스트를 이렇게 나눴습니다.
1. 핵심 메시지
   - 가장 크게 보여줄 문장
   - 청중이 한눈에 붙잡아야 하는 문장

2. 근거 원문
   - 요약하지 않고 필요한 부분만 정확히 절취
   - 핵심 메시지를 뒷받침하는 문장

3. 출처/맥락 chip
   - 작아도 반드시 남겨야 하는 출처 정보

4. 내부 provenance
   - 화면에는 보이지 않지만 제작자가 추적해야 하는 원천 정보
그래서 지금의 원칙은 이렇습니다.
최종 화면의 텍스트 양은 다소 늘어도 허용한다.
하지만 모든 인용문을 빽빽하게 넣지는 않는다.

핵심 메시지는 강조한다.
근거 문장은 누락하지 않는다.
원문은 요약하지 않고 필요한 부분만 절취한다.
출처는 작지만 남긴다.
이게 제가 찾은 중도였습니다. 텍스트를 무조건 많이 넣는 것도 아니고, 디자인을 위해 과감히 지우는 것도 아닙니다. 역할을 나누고, 반드시 남아야 할 문장을 계약으로 고정하는 방식입니다.
이후 기획 단계와 이미지 생성 단계의 책임도 다시 정했습니다.
기획 단계:
  의미와 텍스트 책임을 결정한다.

이미지 생성 단계:
  승인된 의미와 텍스트를 시각화한다.

이미지 생성 단계는 승인된 텍스트를 삭제, 요약, 변형할 권한이 없다.
이미지 생성 프롬프트에 TEXT_SLOT_LOCK이나 DO NOT SACRIFICE TEXT 같은 지시를 넣는 것만으로는 부족했습니다. 프롬프트를 세게 쓰는 문제가 아니라, 프롬프트 이전에 무엇을 지켜야 하는지 정하는 문제였습니다.
반복 개선 과정에서도 같은 문제가 다시 나왔습니다. 처음 결과가 빽빽하니까 프롬프트에 이런 방향이 들어갔습니다.
더 크게, 더 읽기 쉽게, 더 sparse하게, 더 정돈되게
그랬더니 결과는 실제로 더 정돈됐습니다. 하지만 그 정돈의 대가로 텍스트가 사라졌습니다.
특히 required text slot이 명확하지 않으면, AI는 여러 텍스트를 optional처럼 다룹니다.
citation chip은 없어도 되는 장식처럼 보임
보조 근거 문장은 줄여도 되는 설명처럼 보임
source/context 정보는 디자인 압력에 밀림
그래서 텍스트 슬롯에 보존 등급을 붙였습니다.
must_render:
  반드시 화면에 보임

small_but_visible:
  작아도 보여야 함

internal_only:
  화면에는 보이지 않지만 기록에는 남아야 함

optional:
  없어도 됨, 단 명시된 경우만
이번에 배운 표현으로 말하면 이렇습니다.
AI에게 "더 깔끔하게"라고 반복했더니, AI는 내용을 지우는 방식으로 깔끔하게 만들었다.
디자인은 중요합니다. 하지만 강의 슬라이드에서는 디자인이 의미를 이기면 안 됐습니다.
3. AI 웹앱의 이전 맥락이 다음 슬라이드를 오염시킬 수 있다
웹앱에서 여러 슬라이드를 이어서 생성하다 보면 이전 대화나 이전 출력의 분위기가 남습니다.
실제로 한 슬라이드에서는 이전 roadmap 구조의 흔적이 다음 결과에 섞이는 문제가 있었습니다. 현재 프롬프트보다 이전 출력의 구조가 더 강하게 작동한 셈입니다.
그래서 슬라이드별 독립성을 더 강하게 관리해야 했습니다.
슬라이드별 source baseline 분리
슬라이드별 prompt 분리
필요하면 새 대화/탭 또는 context reset 사용
각 output에 prompt, source, contract, run id 기록
AI 웹앱은 이전 대화의 분위기를 기억합니다.
슬라이드 제작에서는 그 기억이 도움이 아니라 오염원이 될 때가 있습니다.
4. 기준 폴더가 없으면 실패한 과거가 다시 현재가 된다
프로젝트 폴더도 문제가 됐습니다.
기존에는 planning/source 계열 폴더와 design/harness 계열 폴더가 나뉘어 있었습니다. 어느 쪽이 현재 기준인지 헷갈리기 쉬웠습니다.
그래서 새 기준 프로젝트를 만들었습니다.
E:\AI\Mind-lecture\book-lecture-slide-agent-system
그리고 역할을 나눴습니다.
book-lecture-slide-agent-system: 현재 기준 프로젝트
hebrews-detail-plan-slides: 예전 planning/source 계열
reference-lock-lecture-slide-harness: 예전 design/harness 계열
복잡한 AI 프로젝트에서는 파일 정리도 품질 관리였습니다.
기준 폴더가 없으면 실패한 프롬프트, 오래된 규칙, 중간 산출물이 다시 현재 기준처럼 돌아옵니다.
5. 말로 한 교훈은 사라진다. 문서와 체크리스트로 남겨야 한다
작업 중에 좋은 판단을 많이 했습니다.
하지만 그 판단이 대화 안에만 있으면 다음 세션에서 사라집니다.
새 에이전트는 이전 대화의 뉘앙스를 모릅니다.
다른 창에서 이어가면 같은 실수를 다시 할 수 있습니다.
그래서 실패와 교훈을 파일로 남겼습니다.
- anti-pattern notes
- rule files
- prompt templates
- QC checklists
- validator scripts
- handoff reports
- Obsidian notes
AI에게 한 번 설명한 것은 기억이 아니라 휘발성 대화였습니다.
시스템을 바꾸려면 문서와 체크리스트로 남겨야 했습니다.
6. 도구 실패와 품질 실패를 구분해야 한다
처음에는 Hermes의 image_generate 도구로 이미지를 생성하려고 했습니다.
그런데 현재 환경에서는 backend가 준비되어 있지 않았습니다.
에러는 이런 식이었습니다.
Image generation is unavailable in this environment.
FAL_KEY environment variable is not set.
이건 프롬프트 품질 실패가 아니었습니다.
이미지 생성 route가 준비되지 않은 문제였습니다.
이후 실제 작업 route를 분리했습니다.
Primary route: 로그인된 ChatGPT 웹앱 via CDP Chrome
Alternative route: Hermes image_generate, 단 backend 설정이 있을 때만
여기서 또 하나 배운 게 있습니다.
ChatGPT 웹앱 자동화를 하려면 일반 Chrome이 아니라 CDP Chrome이 필요했습니다.
--remote-debugging-port=9222
--user-data-dir=C:\chrome-debug-profile
일반 Chrome에서 로그인했다고 해서 자동화 가능한 창에 로그인된 것은 아니었습니다. 그래서 원클릭 launcher를 만들고, chrome://version에서 프로필 경로가 C:\chrome-debug-profile인지 확인하는 방식도 정리했습니다.
웹앱 자동화에서는 "내가 보는 창"과 "에이전트가 조작할 수 있는 창"이 같은지 확인하는 것부터 작업이었습니다.
7. 새 창에서 같은 요청을 반복하면 이미 끝난 작업을 다시 할 수 있다
새 대화창에서 이어갈 때도 시행착오가 있었습니다.
처음 요청 목록을 그대로 다시 주면, 이미 끝난 schema/rule/validator 작업을 다시 할 수 있습니다. 정작 필요한 것은 실제 이미지 생성과 QC인데, 문서 재작성만 반복될 수 있습니다.
그래서 새 창에서의 요청문을 이렇게 바꿨습니다.
이미 준비된 v0.2 harness와 calibration 파일을 기준으로,
CDP Chrome에 로그인된 ChatGPT 웹앱을 사용해
R01-S04/R01-S15/R01-S02 실제 integrated_baked_in 이미지 생성과 QC를 진행해줘.
"다음 진행해줘"도 맥락이 없으면 위험했습니다.
다음이 문서 작업인지, 실제 생성인지, QC인지 명확히 해야 했습니다.
8. 실패 경험이 있다고 바로 방식을 버리면 안 된다
텍스트 훼손이 있었기 때문에 한때는 deterministic overlay로 바로 바꿔야 하나 고민했습니다.
그런데 실제 새 route에서 다시 검증하기 전에는 성급한 판단이었습니다.
그래서 전환 기준을 정했습니다.
- pseudo-Hangul 발생
- 핵심 메시지 오탈자/변형
- 성경 인용문 변형
- citation/source chip 누락
- required slot 누락
- 디자인 개선을 이유로 required slot 삭제
이후 ChatGPT CDP route로 세 개 샘플을 실제 생성하고 QC했습니다.
R01-S04: PASS
R01-S15: PASS
R01-S02: PASS
그래서 지금은 integrated_baked_in을 당장 폐기하지 않고 baseline candidate로 유지했습니다.
hybrid나 deterministic_overlay는 fallback으로 남겨두었습니다.
실패 경험이 있다고 바로 방식을 버린 것이 아니라, 새 조건에서 다시 검증하고 증거가 있을 때만 전환하기로 한 것입니다.
9. production과 calibration을 섞으면 목표가 흐려진다
이번 작업에서 가장 중요했던 구조적 시행착오는 production과 calibration을 구분하지 못한 일이었습니다.
처음에는 단순히 "참고 이미지를 잘 따라 만들면 좋은 슬라이드가 되겠지"라고 생각했는데 작업을 진행하다 보니 과정이 복잡해지고 꼬이는 일이 발생해서 워크플로우를 2개로 분리했습니다.
production은 실제 강연 내용을 담은 최종 슬라이드를 만드는 일입니다.
calibration은 참고 이미지를 기준으로 디자인 규칙을 학습하고 고치는 일입니다.
a~g 용어 기준
a = 슬라이드 제작 명세
    실제 이미지를 만들 때 필요한 슬라이드별 설계도.
    텍스트 위치, 이미지 역할, 여백, 안전 영역, 출처 chip 위치를 포함한다.

b = 참조 이미지
    사용자가 좋아한다고 선택한 디자인 기준 이미지.
    직접 최종 프롬프트 재료라기보다, 디자인 규칙을 검증하는 비교 기준이다.

c = Image-to-Brief 규칙
    참조 이미지 b를 보고 임시 제작 명세 a'로 해석하는 규칙.
    이미 존재해야 하는 시스템 규칙이며, calibration에서만 필요하다.

d = 디자인 잠금 규칙
    여러 슬라이드에 반복 적용할 디자인 문법.
    색감, 질감, 여백, 구도, 인물 사용, 장르 guardrail을 포함한다.

e = 프롬프트 구성 규칙
    a 또는 a', d를 어떻게 조합해 실제 프롬프트 f로 만들지 정하는 규칙.

f = 이미지 생성 프롬프트
    ChatGPT 같은 이미지 생성 도구에 실제로 넣는 문장.

g = 출력 이미지
    f로 생성된 이미지.
    calibration에서는 규칙 개선용 결과이고, production에서는 QC 후 최종 후보가 된다.
흐름 A: 디자인 잠금 규칙을 만드는 흐름
흐름 A의 목적은 참조 이미지 b를 기준으로 디자인 잠금 규칙 d를 반복 개선하는 것입니다.
여기서는 실제 강의 슬라이드를 완성하는 것이 목표가 아닙니다.
핵심은 이렇습니다.
b = 참조 이미지
+
c = Image-to-Brief 규칙
  이미 존재하는 시스템 규칙
        │
        ▼
a' = 임시/가상 슬라이드 제작 명세
     b의 구도, 색감, 질감, 여백, 텍스트 영역, 분위기를
     제작 명세 형태로 해석한 것

        ┌───────────────────────────────┐
        │ a' = 임시/가상 제작 명세       │
        │ d  = 디자인 잠금 규칙 초안     │
        │ e  = 프롬프트 구성 규칙        │
        └───────────────┬───────────────┘
                        ▼
f = calibration용 이미지 생성 프롬프트
                        │
                        ▼
g = calibration 출력 이미지
                        │
                        ▼
b와 g 비교
- reference fidelity
- 텍스트 안전 영역
- 색감 / 질감 / 여백
- 카드 구조 / 구도
- 문화·장르 drift
                        │
                        ▼
차이점 도출 + 실패 원인 분류
                        │
                        ▼
d v2 = 디자인 잠금 규칙 개선
                        │
                        ▼
필요하면 f 재작성 → g 재생성 → b와 재비교
                        │
                        ▼
사용자 승인
                        │
                        ▼
최종 d = production에 사용할 디자인 잠금 규칙
여기서 조심해야 할 점이 있습니다.
c는 흐름 A에서 생성하지 않습니다. 이미 존재해야 하는 시스템 규칙입니다.
c의 역할은 b로부터 a'를 만드는 것입니다.
흐름 A의 g는 최종 슬라이드가 아니라 calibration output일 수 있습니다.
reference가 없는 경우에도 별도 흐름을 만들지 않습니다. 먼저 사용자와 티키타카하며 b를 만든 뒤 같은 흐름 A를 실행합니다.
a', d, e는 순차 관계가 아닙니다. 세 요소를 병렬적으로 사용해 f를 만듭니다.
즉, 흐름 A는 이런 질문에 답하는 과정입니다.
우리가 좋아하는 참고 이미지의 디자인 문법을 어떻게 규칙으로 만들 것인가?
흐름 B: 실제 production 이미지를 만드는 흐름
흐름 B의 목적은 이미 준비된 a와 승인된 d를 사용해서 실제 슬라이드 이미지를 생성하는 것입니다.
여기서는 앞단의 강의 내용 정리와 슬라이드 기획은 이미 끝났다고 보고, 이미지 생성 흐름만 봅니다.
┌─────────────────────────────────────┐
│ a = 슬라이드 제작 명세               │
│     앞단에서 준비된 실제 명세        │
│                                     │
│ d = 디자인 잠금 규칙                 │
│     사용자 승인된 디자인 문법        │
│                                     │
│ e = 프롬프트 구성 규칙               │
│     a와 d를 f로 조합하는 규칙        │
└──────────────────┬──────────────────┘
                   ▼
f = 이미지 생성 프롬프트
                   │
                   ▼
g = 출력 이미지
                   │
                   ▼
QC 및 보완
                   │
                   ▼
사용자 검수
                   │
                   ▼
최종 deck 편입
흐름 B에서는 c가 필요 없습니다.
c는 이미지를 해석해 a를 만드는 규칙인데, 흐름 B에서는 실제 a가 이미 준비되어 있기 때문입니다.
또 하나 중요한 점은 a, d, e가 순차 관계가 아니라는 것입니다.
먼저 a를 만들고, 그 다음 d를 만들고, 그 다음 e를 만드는 식으로 이해하면 안 됩니다. 실제로는 a, d, e를 함께 사용해서 f를 구성합니다.
도구별 화면비, 출력 크기, 파일 형식 같은 실행 세부사항은 이 흐름 변수에 넣지 않았습니다. 그런 내용은 별도 실행 규칙이나 manifest에서 관리하는 편이 낫습니다.
이 구분이 왜 중요했나
production과 calibration을 구분하지 않으면 세 가지 문제가 생깁니다.
첫째, 참고 이미지를 닮는 것이 실제 강의 슬라이드의 성공 기준처럼 됩니다.
하지만 production에서는 원문, 핵심 메시지, 출처가 살아남아야 합니다.
둘째, calibration output을 최종 슬라이드처럼 착각할 수 있습니다.
calibration output은 d를 개선하기 위한 증거이지, 바로 deck에 들어갈 결과물이 아닐 수 있습니다.
셋째, 실패한 trial prompt가 성공 템플릿처럼 승격될 수 있습니다.
이 경우 디자인은 좋아지는데 텍스트가 사라지는 문제가 반복됩니다.
그래서 지금은 이렇게 정리했습니다.
흐름 A:
  참고 이미지 b를 기준으로 디자인 잠금 규칙 d를 만든다.
  g는 calibration output이다.

흐름 B:
  실제 슬라이드 제작 명세 a와 승인된 d를 사용해 production 이미지를 만든다.
  g는 QC 통과 후 deck에 들어갈 수 있는 production output이다.
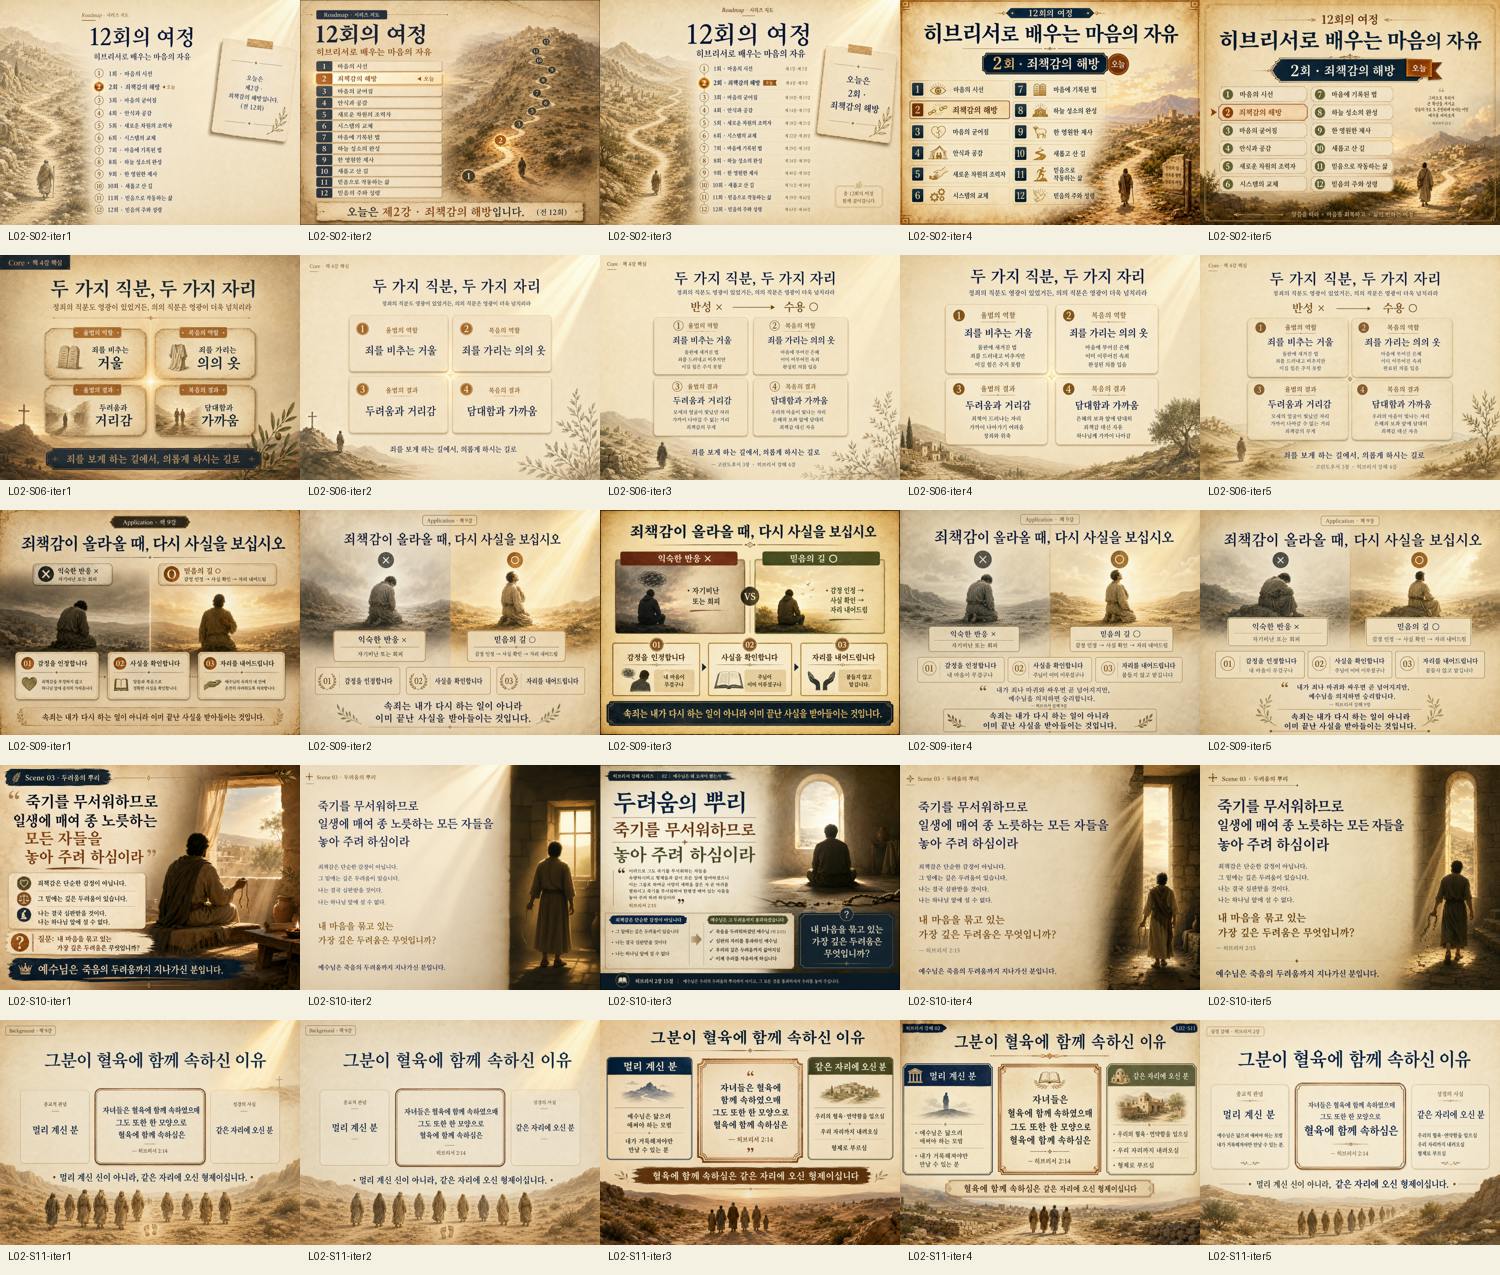
이 이미지는 여러 슬라이드를 대상으로 iter1부터 iter5까지의 변화를 한 장에 모아둔 sheet입니다. 왼쪽에서 오른쪽으로 갈수록 반복 수정이 진행되고, 각 행은 서로 다른 슬라이드 샘플을 보여줍니다.
처음 결과는 대체로 분위기나 방향은 잡혀 있지만, 여백·구도·시각 위계가 불안정했습니다.
iteration이 진행되면서 카드 구조가 정돈되고, 시선의 흐름이 안정되고, 참고 이미지의 질감과 분위기에 가까워졌습니다.
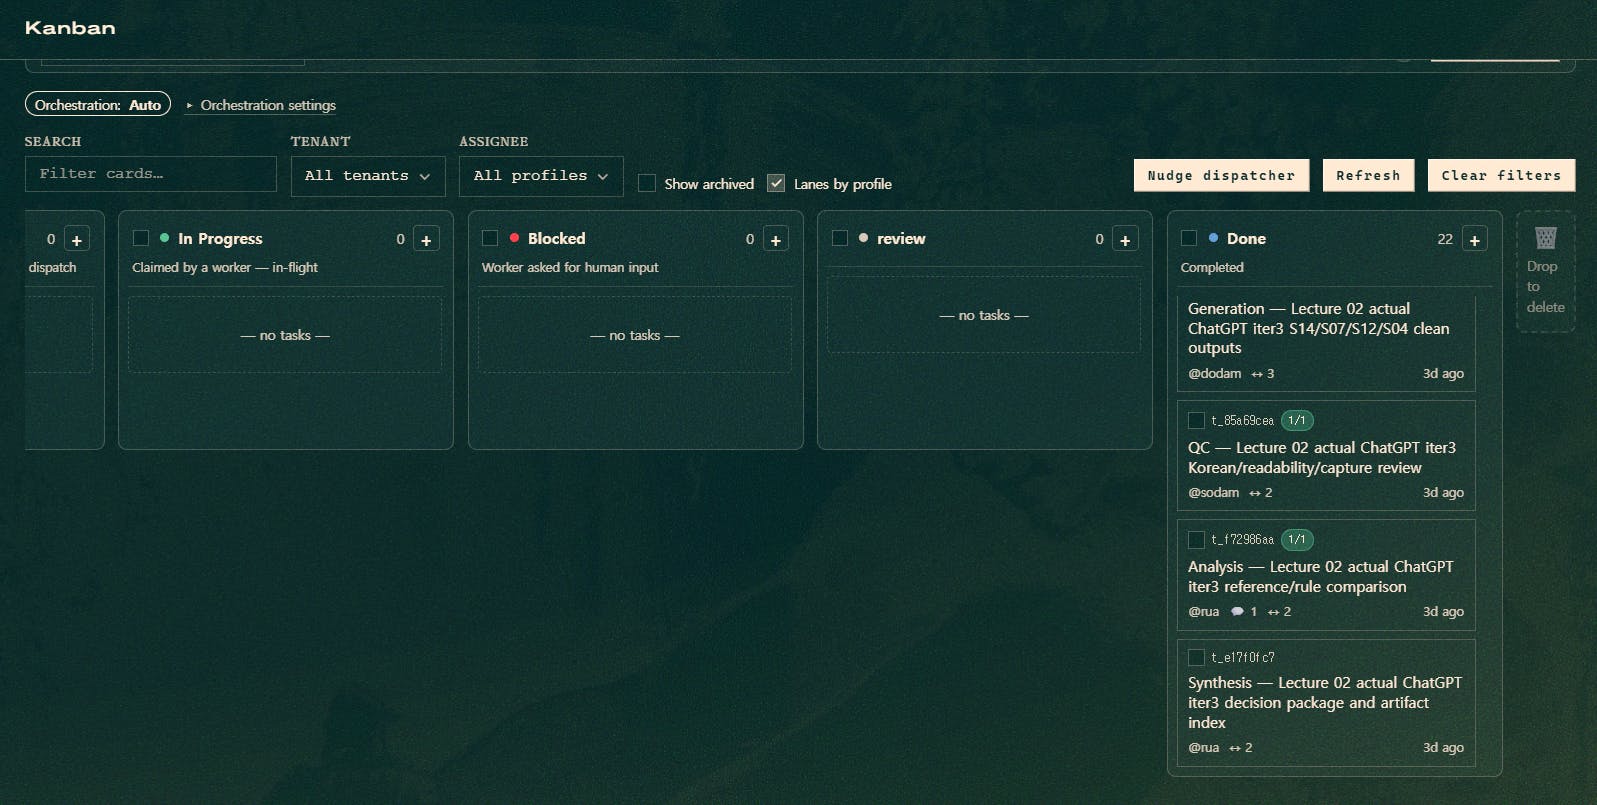
다음은 칸반 보드에서 여러 작업 카드로 나눠 진행한 내용입니다.
각 프로필의 역할과 성격
default
역할: gatekeeper / PM / 승인 관리자
성격: 전체 흐름을 멈추거나 승인하는 역할. 실제 이미지를 직접 만들기보다, 어떤 단계로 넘어가도 되는지 판단하고 카드 흐름의 기준을 잡는다.

rua
역할: reference analyst / rule architect / synthesizer
성격: 시각 reference, 규칙, 비교, decision package에 강한 분석형 프로필. "왜 좋아졌는가", "어떤 규칙을 고쳐야 하는가", "다음 gate는 무엇인가"를 정리한다.

dodam
역할: producer / operator / content refiner
성격: 실제 산출물을 만들거나 다듬는 실행형 프로필. ChatGPT 웹앱 생성, prompt/metadata/provenance 관리, 강의 내용 refinement 같은 제작 실무를 맡는다.

sodam
역할: audience QC / Korean readability reviewer
성격: 보는 사람 입장에서 결과를 검수하는 리뷰어형 프로필. 한글 가독성, 청중 이해도, 시각적 산만함, capture 문제를 잡아낸다.
생성은 도담, 청중/QC 관점은 소담, reference/rule 분석과 종합은 루아가 맡았습니다.
t_c5e7e9cf
Audit S14/S07/S12/S04 reference locks for Lecture 02
담당: rua
작업: Lecture 02 안에서 어떤 reference lock을 갖는지 점검했다. 어떤 것은 고정 문구인지, 어떤 것은 개념/구도/출처 관계인지 구분했다.

        ↓

t_9334be4e
Refine Lecture 02 using approved reference-lock map
담당: dodam
작업: rua가 정리한 reference-lock map을 바탕으로 Lecture 02 내용을 다듬었다. 강의 흐름과 문장 정리를 담당하되, 잠긴 reference 관계를 훼손하지 않는 것이 핵심이었다.

        ↓

t_77501c51
APPROVED — Lecture 02 actual ChatGPT iteration 2 for S14/S07/S12/S04 reference-lock refinement
담당: default
작업: iteration 2 실행을 승인하고, 어떤 범위에서 실제 ChatGPT 생성으로 넘어갈지 gate 역할을 했다.

        ↓

t_48f1c0f2
Generate — Lecture 02 actual ChatGPT iteration 2 for S14/S07/S12/S04
담당: dodam
작업: 승인된 4개 슬라이드에 대해 실제 ChatGPT 웹앱 route로 이미지를 생성했다. 생성 결과, prompt, metadata, provenance를 남겼다.

        ↓

        ┌────────────────────────────────────────────┐
        │                                            │
        ▼                                            ▼

t_80ea144d                              t_b2aa41f9
QC — Lecture 02 actual iter2             Analyze — Lecture 02 actual iter2
담당: sodam                              담당: rua
작업: 한글 가독성, 청중 관점,              작업: reference와 비교해 디자인 규칙,
텍스트 오류, 시각적 산만함을 검수했다.      구도, 분위기, rule patch 필요성을 분석했다.

        └──────────────────────┬─────────────────────┘
                               ▼

t_7ee33e55
Synthesize — Lecture 02 actual iter2 calibration decision package
담당: rua
작업: 생성 결과, QC, reference 분석을 종합해 iteration 2 decision package를 만들었다. 어떤 슬라이드를 keep/retry/rebuild로 볼지 정리했다.
마무리
이번 작업은 "AI가 슬라이드를 만들어줬다"는 식으로 말하기에는 너무 많은 시행착오와 수정이 들어간 작업이었습니다. 작업 환경 세팅이 안정화되기 전까지는 워크플로우 중간 산출물들을 지속적으로 관찰하며 개입이 필요하였습니다. AI의 결과물을 무조건 믿고 맡기는 것이 아니라 내가 그 과정을 얼마나 잘 이해하고 적절한 개입을 하느냐가 결과물의 품질을 좌우한다고 생각됩니다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요


와 슬라이드 완성하신거보니까 엄청나신데요? 이거 만드시기까지 얼마나 노력하셨을지 감도 안오네요 ㅎㅎ 다음 칸반보드 사례글도 기대하겠습니다