[다중 LLM 비교] 삼성 브랜드 의인화 - 6개 AI의 관점과 평가

2026.03.21
[다중 LLM 비교] 삼성 브랜드 의인화 - 6개 AI의 관점과 평가
아래 사례내용은 AI를 통해 사례작성 해달라고 요청하여 작성한 글입니다.
한줄 요약
지피터스 21기 스타트업실험실 과제로 6개 LLM(ChatGPT, Claude, 젠스파크, 퍼플렉시티, 제미니, Grok)을 활용해 삼성을 의인화하고, 그 결과를 객관적으로 비교 평가해 보았습니다.
이런 분들께 도움돼요
다중 LLM을 활용한 기획 작업의 퍼포먼스 차이가 궁금하신 분
AI를 활용해 브랜드 아이덴티티나 페르소나를 체계적으로 도출하고 싶으신 분
여러 AI의 톤앤매너와 결과물을 비판적으로 평가하고 프롬프트를 고도화하고 싶으신 분
소개: 시도하고자 했던 것과 그 이유
문제 상황 (Before)
지피터스 21기 스타트업실험실 1주차 스터디에서 브랜드, 브랜딩, 마케팅 개념에 대해 배웠고, 과제로 '브랜드를 객관화/의인화해보라(예: 다이소가 사람이라면 누구일까?)'는 미션을 받았습니다. 기존 방식이라면 머리를 맞대고 포스트잇을 붙여가며 오랜 시간 브레인스토밍을 해야 했고, 개인의 편견이나 얕은 묘사에 갇힐 우려가 있었습니다.
시작하게 된 계기
단순한 상상으로 끝내기보다, "AI가 가진 객관적이고 다층적인 시각을 활용해 페르소나 데이터셋을 도출하자"고 마음먹었습니다. 나아가 단일 LLM에 의존하지 않고, 무려 6개의 대표 LLM들에게 삼성을 의인화하게 한 뒤, 그 결과들을 다시 종합해 냉정하게 비교 평가하여 각 모델의 장단점을 파악해보기로 했습니다.
진행 방법: 어떤 도구를 사용했고, 어떻게 활용했나요?
사용한 도구
도구명: 6대 멀티 LLM (ChatGPT, Claude, Genspark, Perplexity, Gemini, Grok)
특이사항: 동일한 프롬프트를 각기 다른 LLM에 입력 후 결과 도출, 최종적으로 결과물들을 취합해 상호 비판 및 비교 평가 실시
AI와 협업한 과정
1. 첫 번째 작업 (프레임워크 도출)
상황: 무작정 특정 브랜드를 사람으로 묘사해달라고 하기보다는, 체계적인 분석 틀이 필요했습니다.
이렇게 요청했어요:
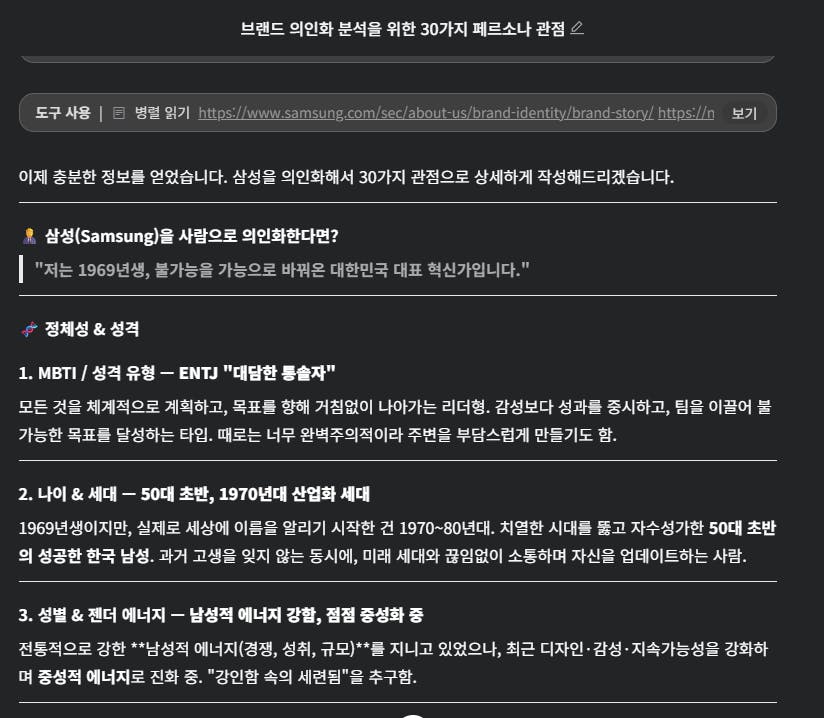
브랜드를 의인화 해보려고해 의인화 관점 30개 적어줘
결과: 각 LLM은 나이, 성별, MBTI, 말투, 패션부터 두려워하는 것, 인생 서사까지 체계적인 분류법 30가지를 제시했습니다.
느낀 점: AI가 제시한 관점 30개를 보니, 단순한 감성 작업이 아니라 실제 마케팅과 AI 프롬프트 설계에 쓸 수 있는 "행동 모델 설계"의 구조가 잡혔습니다.
2. 두 번째 작업 (삼성 브랜드 적용)
상황: 앞서 세운 30개의 관점 프레임을 바탕으로 대상 브랜드 '삼성'을 대입하여 의인화했습니다.
이렇게 요청했어요:
삼성을 위 관점을 가지고 의인화해줘
결과:
ChatGPT: 질서를 만드는 산업 설계자. ENTJ 성향의 신뢰 가능한 공급자
Claude: 55세의 완숙한 중장년, 철저한 실행력의 에니어그램 3번
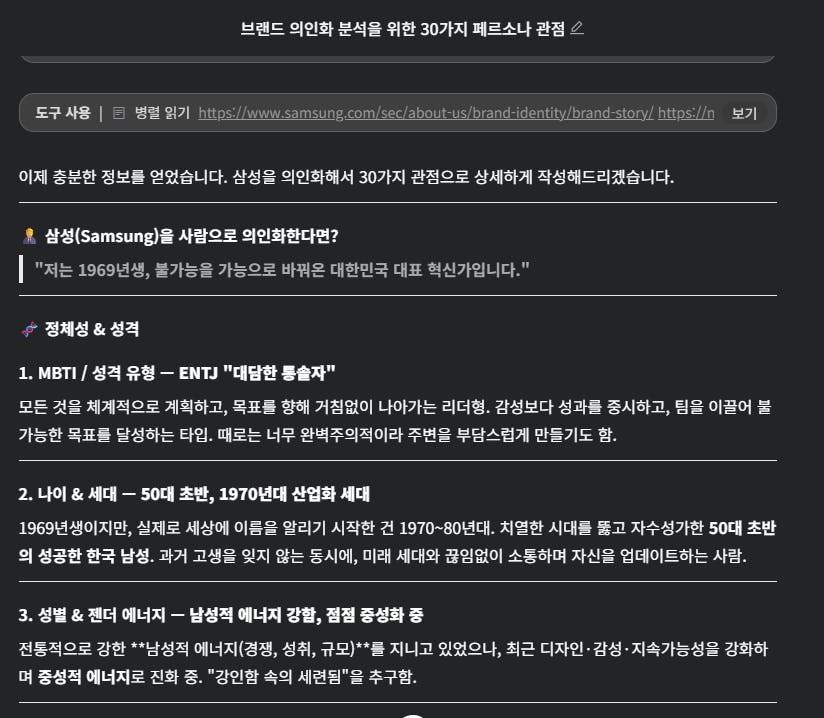
젠스파크: 1969년생 글로벌 테크 CEO. 대규모 운영과 시스템을 지향
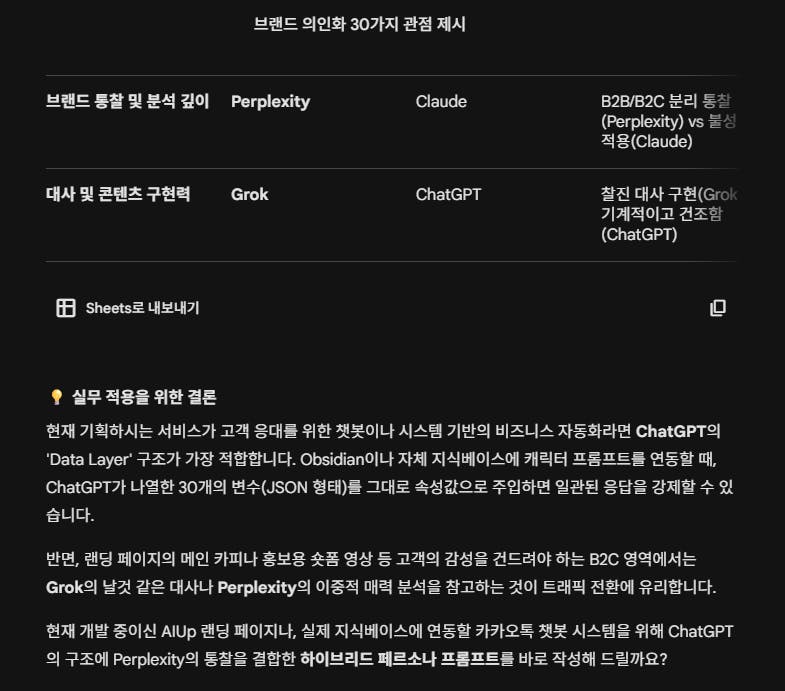
제미니: 라이벌 '캘리포니아 천재 디자이너'를 의식하는 워커홀릭 엘리트
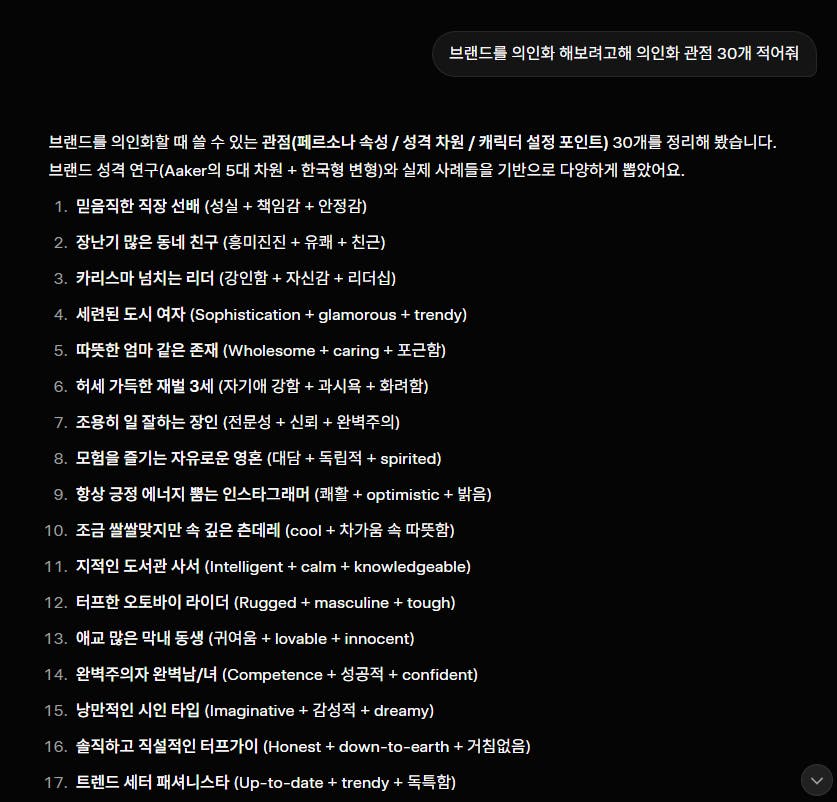
Grok: "내가 뚫어줄게." 모험을 즐기고 규칙을 깨는 패기 넘치는 20~30대 삼이 형 (가장 과감한 해석)
3. 세 번째 작업 (비교 평가)
상황: 6개 LLM이 도출한 6가지 각기 다른 삼성이라는 페르소나 결과물들의 퀄리티/특징을 객관적으로 분석하기 원했습니다.
이렇게 요청했어요:
각 LLM의 결과를 객관성있게 냉정하게 신랄하게 비판하고 비교 평가하라
결과:
1위 ChatGPT: 구조적 설계 압도적
2위 젠스파크: 실제 기업 서사와 위기 극복 스토리텔링 면에서 우수
공통 지적사항: "삼성의 불편한 진실"은 모두가 회피하고 빛나는 부분만 모범적으로 묘사하는 한계 발견
인상적이었던 순간
"오!" 했던 순간:
ChatGPT가 브랜드를 "사람처럼 보이지만 실제로는 운영체제(OS)에 가깝다"라고 꿰뚫어 본 통찰력에 놀랐습니다.
제미니가 삼성의 치명적 라이벌로 애플을 "캘리포니아 출신 예술병 걸린 디자이너"로 비유한 대목이 너무나 재치 있고 생생했습니다.
막혔던 순간과 해결
문제: Grok은 진지한 분석보다는 캐릭터 놀이에 치중하는 등 LLM마다 장단점의 편차가 컸습니다. 전체적으로 그림자가 없는 너무 완벽한 모습만 그려냈습니다. 해결: 평가 프롬프트를 통해 각 LLM 결과의 맹점을 분석하게 했고 결론적으로 "프레임은 ChatGPT, 내면 동기 질문은 Claude, 서사 확장은 젠스파크"를 조합하는 것이 베스트라는 실무적 지침을 얻었습니다.
=>위의 내용은 AI가 분석한 결과이고
저는 개인적으로 Grok의 독특한 사고와 평가기준에서 자화자찬이 심함을 볼수 있어 매우 흥미로웠습니다. 맨아래 제미니의 분석 결과 캡쳐한 내용도 흥미로웠습니다.
💡 Tip: 처음부터 브랜드 이름을 넣고 묘사해달라고 하기보다, 1단계로 '평가/의인화 관점 리스트'를 먼저 짜달라고 한 후 2단계로 묘사를 요청하면 훨씬 입체적인 결과를 얻을 수 있습니다.
결과와 배운 점
Before vs After
항목 | Before | After |
|---|---|---|
소요 시간 | 브랜드 서사/기획 리서치에 수일 소요 | 6개 LLM 교차 검증까지 불과 한두 시간 이내 완료 |
통찰력/품질 | 주관적/직관적인 단편적 묘사 | 30개의 구조화된 프레임과 객관적인 비교 인사이트 확보 |
기타 | 단일 모델 의존에 따른 편향 위험 | 6개 모델 간 교차 평가로 모델별 강단점 및 회피 성향까지 파악 |
배운 점과 나만의 꿀팁
효과적이었던 것
관점 도출 후 대상 대입: 의인화 축 30개를 먼저 확보한 것이 퀄리티를 폭발적으로 높였습니다.
다중 모델 비교 분석: 한계점을 스스로 성찰하게 하여, 단일 LLM 사용 시 빠질 수 있는 '착각'에서 벗어날 수 있었습니다.
결과물들의 믹스매치: 각 LLM의 장점(ChatGPT의 구조, 젠스파크의 서사 등)만 차용하여 혼합하는 것이 가장 좋은 브랜드 아웃풋을 만듭니다.
이렇게 하면 안 돼요 (주의사항)
특정 LLM이 내놓은 "놀이"나 과장에 휩쓸리지 마세요(예: Grok). 타겟과 맞지 않는 오버 해석이 포함될 수 있습니다.
AI는 대기업의 그림자와 치부를 교묘하게 회피하는 '착한 답변 병'이 있습니다. 입체적 사람을 만들려면 인간의 비판적 프롬프트가 필수적입니다.
재사용 가능한 프롬프트
프롬프트 1: 의인화 관점 설계
[타겟 브랜드, 예: 토스]를(을) 의인화 해보려고 해.
이 브랜드를 살아 숨쉬는 사람으로 설정하기 위해 필요한 구체적인 의인화 관점(질문 축) 30개를 카테고리별로 적어줘.
프롬프트 2: 페르소나 도출 및 교차 평가
앞서 도출한 30가지 관점을 바탕으로 [대상 브랜드]를 의인화해서 구체적으로 묘사해줘.

(각각의 LLM에 요청 후 결과물 확보)

각 LLM들의 의인화 결과물들을 아래에 제공합니다. 결과를 객관성 있고 냉정하게, 그리고 신랄하게 비판 및 체계적으로 비교 평가해줘.
[결과물 복사 붙여넣기]
LLM 결과
1. 젠스파크 내용 일부
2. Grok 내용 일부(개인적으로 저는 Grok의 독특한 사고가 눈에 들어왔습니다.
제미니의 분석 결과
참고한 자료
외부 자료: 브랜드 퍼스널리티 이론(Aaker), 브랜드 아키타입 12종 등
작성일: 2026-03-21 작성자: 황금호랑이
로그인하고 댓글을 남겨 주세요
와, 읽으면서 감탄이 절로 나왔습니다! 🙌
단순히 '삼성을 의인화해줘' 한 방에 끝낼 수도 있었는데, 1단계에서 관점 30개 프레임을 먼저 뽑고 2단계에서 대입하는 방식이 정말 탁월합니다. 저도 앞으로 꼭 써먹겠습니다!
개인적으로 Grok의 '자화자찬' 성향을 짚어내신 부분이 가장 인상 깊었어요. AI 결과물을 그냥 수용하지 않고 비판적으로 바라보셨다는 게 이 작업의 진짜 핵심인 것 같아서요. 👀
"프레임은 ChatGPT, 내면 동기 질문은 Claude, 서사 확장은 젠스파크"라는 실무 조합 팁은 그야말로 꿀팁 중의 꿀팁입니다. 바로 저장해뒀습니다! 🔖
같은 반에서 이런 고퀄리티 사례를 공유해주셔서 덕분에 저도 많이 배웁니다. 앞으로도 잘 부탁드려요! 😄

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
여러 LLM을 단순 비교하는 데서 끝나지 않고, 각 모델의 강점과 회피 성향까지 비판적으로 짚어낸 점이 참 좋았습니다.
특히 먼저 의인화 관점 30개를 설계한 뒤 삼성에 적용한 흐름은 생각의 틀을 세우는 힘이 느껴져서 인상적이었어요.
다만 읽으면서 한편으로는 “그래서 황금호랑이님 본인은 삼성을 어떤 사람으로 느끼는가?” 그 부분이 조금 더 드러났다면 더 재미있고 더 살아있는 글이 되었을 것 같다는 생각도 들었습니다.
AI들의 답을 비교하는 작업이 워낙 탄탄해서, 오히려 그 사이에 성욱님의 시선이 조금 가려진 느낌도 있었거든요. 그래서 다음엔 AI들의 평가를 종합한 뒤 다시한번 성욱님의 생각을 정리해보시면 좋을 것 같아요 ^^