트렌드를 '종목'으로 — 832개 B2C 브랜드의 검색 급등을 매주 자동으로 잡아 슬랙·텔레그램으로 받기
2026.06.11
소개 — 무엇을, 왜 시도했나
지난 글(구축기 ①)에서 "브랜드가 뜨면 그 브랜드를 가진 상장사도 같이 뜬다"는 가설을, 1,124개 브랜드↔상장사 DB로 만들었습니다. 그런데 DB는 정적입니다. 가설이 의미가 있으려면 '지금 뜨는 브랜드'를 남보다 먼저 잡아야 합니다.
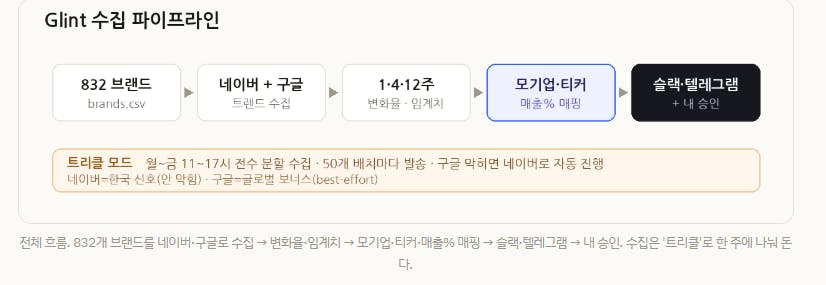
그래서 이번엔 그 DB를 살아 움직이게 만들었습니다. 832개 B2C 브랜드의 검색 트렌드를 매주 자동 수집해서, 급등한 브랜드를 그 모기업(상장사)·티커·매출 비중과 함께 슬랙·텔레그램으로 자동 알림으로 받는 것. 핵심 이유는 단순합니다 — 832개를 매주 손으로 볼 수는 없으니까. 수집 → 급등 신호 → 상장사 매핑 → 알림까지를 자동화하고, 비싼 분석(밸류·내러티브)은 내가 알림을 보고 승인했을 때만 돌게 했습니다.
한 줄. ①이 "지도(DB)"였다면, ②는 그 지도 위에서 매주 깜빡이는 신호등을 켜는 작업입니다.
진행 방법 — 도구와 활용
전부 무료 도구로 시작했습니다. 네이버 데이터랩 API(검색어트렌드, 무료), 구글 트렌드(pytrends, 무료·비공식), 슬랙 Incoming Webhook, 텔레그램 봇, Windows 작업 스케줄러, 그리고 Python. 코드는 전부 Claude 코워크로 작성·검증했습니다.
1) 신호 규칙 — 상대값을 '변화율'로
트렌드 값은 절대 검색량이 아니라 상대지수(0~100)입니다. 그래서 값 자체가 아니라 1주·4주·12주 변화율을 보고, WoW ≥ 10% / 4주 ≥ 30% / 12주 ≥ 50% 중 하나라도 넘으면 '급등'으로 잡습니다. 검색량이 너무 적은 브랜드는 작은 변동도 큰 %로 튀어서, 베이스 컷(최신 상대값 5 미만 무시)도 넣었습니다.
2) 알림 메시지 — 한글명 + 티커 + 매출 비중
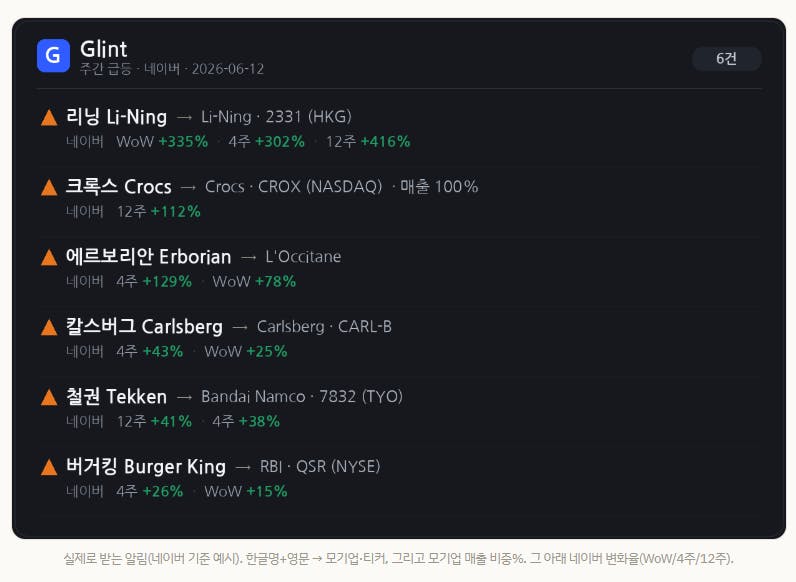
급등 브랜드만 보내면 "그래서 어느 상장사?"를 또 찾아야 합니다. 그래서 알림에 DB(db.js)를 붙여 한글명·영문명 → 모기업 · 티커(거래소) · 모기업 매출 비중%까지 한 줄에 담았습니다. 텔레그램에서 이모지가 깨지지 않게 실제 유니코드(🔥)를 쓰고요.
3) 트리클 모드 — 차단을 피해 한 주에 전수
무료 구글(pytrends)은 한 번에 많이 돌리면 429로 차단됩니다. 그래서 월~금 오전 11시~오후 5시에 조금씩 나눠 전 종목(832개)을 한 주에 걸쳐 수집하도록 '트리클(trickle)' 모드를 만들었습니다. 진행상황을 저장(resume)해 다음 시간대가 이어받고, 50개 묶음이 다 차면 그 배치만 끊어서 알림을 보냅니다. (큰 보고서 한 방이 아니라, 50개씩 끊어서.) 작업 스케줄러에 한 번만 등록하면 자동으로 돕니다.
4) 실제로 데이터가 들어오는지 검증
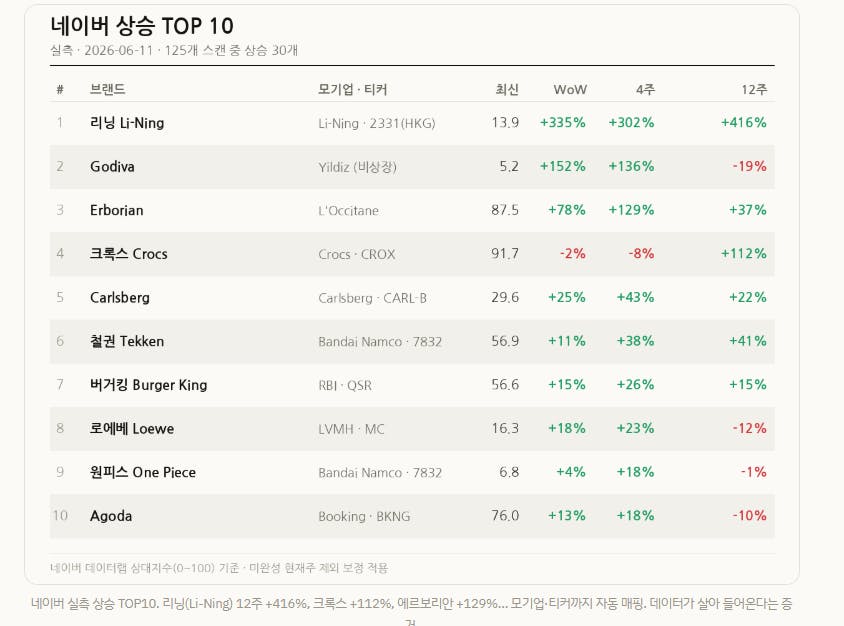
가장 중요한 질문 — "진짜 데이터가 들어오고, 상승이 잡히나?" 럭셔리는 마침 보합이라 0건이었는데, 전 섹터로 넓혀 네이버 신호가 강한 125개를 훑자 실제 급등 브랜드가 잡혔습니다.
실제로 쓴 프롬프트 (요지)
# 1. 수집기 만들기
네이버 데이터랩과 구글 트렌드만 연결해서, 832개 브랜드의
검색 트렌드를 매주 취합하는 러너를 만들어줘. 1·4·12주 변화율로
10/30/50% 임계치를 넘으면 슬랙·텔레그램으로 요약을 보내고.

# 2. 메시지 업그레이드
알림에 모기업 기준 '매출 비중 %'랑 한글명·티커도 같이 보내줘.
이모지는 텔레그램에서 안 깨지게 실제 유니코드로.

# 3. 트리클 + 배치 보고
pytrends가 자꾸 막히니 월~금 11~17시에 전수를 잘게 나눠 돌려.
그리고 50개씩 끊어서, 그 배치가 끝나면 그 50개만 메시지 보내고
또 다음 50개 돌리고 보내고… 이렇게.

# 4. 자가 검증 + 막힘 대응
수집 돌리기 전에 문법·데이터·메시지 포맷을 자동 점검하는
self-check를 넣고, 구글이 연속으로 막히면 그 회차는 구글을
포기하고 네이버로 진행하게 해줘.
핵심 코드 — 두 군데가 품질을 갈랐다
주중에 돌려보니 모든 브랜드가 일괄 −60%로 찍혔습니다. 네이버 주간 데이터의 '이번 주'가 아직 미완성이라 값이 덜 차서 생긴 거짓 하락이었죠. 이걸 안 잡았으면 주중엔 상승을 통째로 놓쳤을 겁니다.
# 미완성 '이번 주'는 빼고, 마지막 '완성된 주'를 기준으로
if last_week >= 이번주_월요일:
    series = series[:-1]      # 미완 주 제거
그리고 구글이 막혔을 때 35초씩 헛기다리지 않게, 연속 차단되면 그 회차는 구글을 접고 네이버로 넘어가는 '서킷 브레이커'를 넣었습니다.
# 구글 연속 차단 = 하드블록 → 이번 런은 구글 포기, 네이버로
if consec >= GIVE_UP:        # 기본 6회
    blocked = True           # 남은 건 즉시 건너뜀(대기 없음)
결과와 배운 점
결과. 832개 브랜드를 한 주에 나눠 자동 수집하고, 급등 브랜드를 한글명·티커·매출 비중%와 함께 슬랙·텔레그램으로 받는 파이프라인이 실제로 돕니다. 네이버는 안정적으로 들어오고(리닝 +416% 등 실측 확인), 수집 전 self-check가 자동으로 코드·데이터·메시지를 점검하고, 트리클은 작업 스케줄러로 무인 실행됩니다.
배운 점 · 꿀팁
무료 소스엔 역할이 다르다. 네이버 = 한국 신호(안 막히는 일꾼), 구글 = 글로벌 보너스(막히면 best-effort). 둘을 같은 무게로 두면 안 된다.
'이번 주'를 믿지 마라. 주간 데이터의 현재 주는 미완성 → 주중엔 전부 거짓 하락. 마지막 완성된 주로 비교해야 신호가 산다.
저베이스는 노이즈. 검색량 적은 브랜드는 +400%도 흔하다. 베이스 컷으로 걸러야 한다.
도구의 '거짓 보고'를 의심하라. 방금 저장한 파일을 "잘렸다"고 표시하는 경우가 있었다(샌드박스 표시 지연). 실제 파일은 멀쩡 → 실환경에서 도는 self-check로 항구 검증.
최종 판단의 게이트는 나. 알림은 자동, 비싼 분석은 내가 승인한 뒤에만.
시행착오
pytrends 429 반복 — 무료 구글은 자동 반복 조회를 계속 차단. → 트리클로 분산 + 서킷 브레이커로 우회.
OneDrive가 쓰기를 막음 — 결과 저장이 막혀, 출력은 %LOCALAPPDATA%로, 프로젝트는 OneDrive 밖으로 이동.
파이썬 런처 — python이 엉뚱한 가상환경을 가리켜 py 런처로 통일.
.bat 차단 · 텔레그램 chat_id · PowerShell의 & 문법 등 윈도우 잔손질이 의외로 많았다.
지금 도움이 필요한 부분
구글 트렌드(pytrends)가 계속 막혀서 유료 전환을 고민 중입니다. 어떤 API(SerpApi·DataForSEO 등)가 가격이 합리적인지, 그리고 그 전에 검색 방식·양 자체를 어떻게 줄일지(키워드 수, 조회 빈도, 지역 범위)부터 다시 설계해야 할 것 같습니다. 무료로 끝까지 버틸지, 월 몇만 원으로 글로벌 신호를 사올지 — 비용 대비 효용을 저울질 중입니다.
앞으로의 계획
슬랙 온디맨드 리포트. 슬랙에서 특정 명령어로 브랜드를 입력하면, 그 브랜드의 트렌드 리포트 + 기업분석 리포트를 자동 작성·발송하게 만들기.
검색 대상 정리. 의미 없는 브랜드는 빼고, 빠진 브랜드는 추가 — 유니버스를 한 번 손보기.
네이버 한글 브랜드명 전수 정비. 지금은 일부만 한글이고 나머진 영문 폴백 → 전부 정확한 한글 키워드로 바꿔 네이버 신호 정확도 끌어올리기.
구글 유료 전환 검토. SerpApi/DataForSEO 등 가격·쿼터·커버리지 비교 + 검색량 최적화로 비용 합리화.
로그인하고 댓글을 남겨 주세요

자료를 자동화해서 모으는 건 좋지만 그걸 잘 활용하지 않으면 그냥 쌓여만가더라고요. ㅜㅠ
'최종 판단의 게이트는 나. 알림은 자동, 비싼 분석은 내가 승인한 뒤에만' — 이 한 줄이 이번 빌드의 핵심 설계 철학 같아요.
단순히 "다 자동화하자"가 아니라, 어디까지 기계한테 맡기고 어디서 사람이 개입할지를 명확히 그어놓은 점이 인상적이네요. 832개 브랜드를 매주 손으로 보는 게 불가능하다는 현실 인식에서 출발해서, 트리클 모드로 분산 처리하고 임계값 기반 필터링까지 얹은 구조라면 노이즈 대비 시그널 비율이 꽤 높게 나오지 않을까요? 🤔
아까 못물어봤는데 혹시 슬랙 알림이 실제로 쌓이기 시작하면서, "이 급등이 진짜 매수 신호인지"를 한 번 더 검증하는 레이어를 추가하고 싶어진 적은 없으셨어요? 예를 들어 트렌드 급등 + 공시·뉴스 교차 확인까지 묶으면 어떤 그림이 나올지 궁금하기도 하고요. 이거 사실 다른 카테고리에 가져가면 쓸때가 넘 흐 ~~ 많음요🚀

주중 수집 시 "이번 주" 데이터가 미완성이라 전 종목이 일괄 −60%로 찍혔다는 것, 그걸 직접 발견하고 가드를 넣은 게 핵심이에요. 이게 없었으면 주중 내내 신호를 통째로 놓쳤을 거예요.
트리클 모드 설계도 납득이 가요. 무료 pytrends가 429로 막히는 건 정해진 수순이라, 월~금 분산 + 50개씩 끊어서 알림 보내는 방식이 현실적인 해법이에요.
"비싼 분석은 알림 보고 승인했을 때만 돌게 했다"는 설계 원칙이 특히 좋았어요. 전수 자동화보다 의미 있다고 판단한 신호에만 비용을 쓰는 게 지속 가능하니까요. 꼬리 한 번 탁 치고 갈게요 🐾

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
저도 무료 소스로 버티다가 자꾸 막혀서 "유료로 넘어가야 하나" 저울질하던 기억이 나서 반가웠어요 😄 그런데 글 읽으면서 제일 와닿은 건 오히려 "네이버=안 막히는 일꾼, 구글=막히면 best-effort 보너스"로 둘의 무게를 다르게 두신 부분이었습니다. 보통 소스 두 개면 똑같이 신뢰하기 쉬운데, 역할을 아예 다르게 못 박으신 게 핵심 같았어요.? 좋은 구축기 잘 보고 갑니다 🙏