애니메이션 속 장면 10초 재현해보기

2025.03.23
소개
이전에 작성했던 사례글의 실패 사례를 반영하여 만들어봅니다.
이전 실패 사례 중에 2명의 등장인물이 상호작용을 하는 장면을 구현하고자 했으나 AI툴의 해석이 반영되어 원하는 장면이 나오지 않았습니다.
이번 사례글에서는 개선된 영상과 2가지 영상을 조합하여 하나의 애니메이션 같은 연출을 해보자합니다. 내용은 영상의 주인공이 그린 캐릭터가 화면 속에서 나와 주인공과 악수를 하는 첫만남에 대한 것 입니다.
진행 방법
이미지는 Chat gpt를, 영상은 Kling ai를 이용하여 제작되었습니다.
먼저, 컨셉 아트를 보겠습니다.
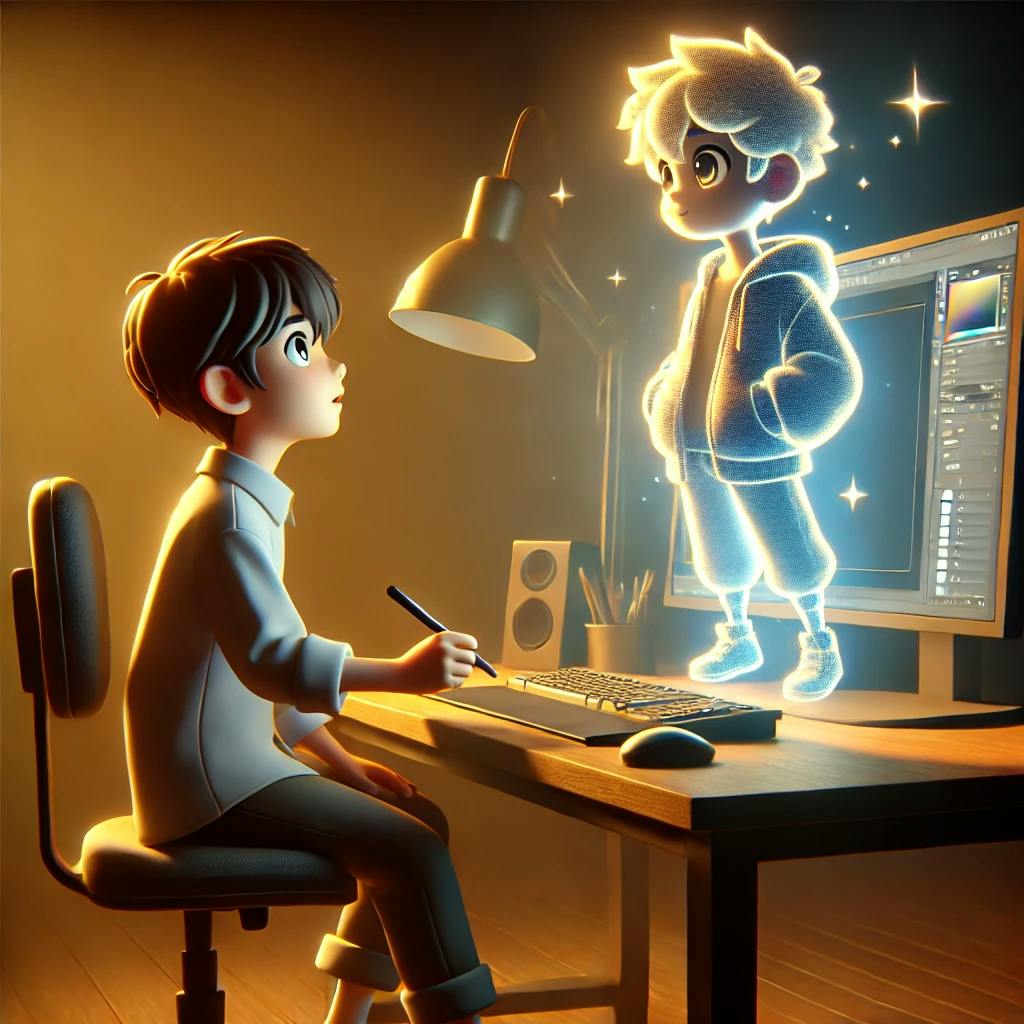
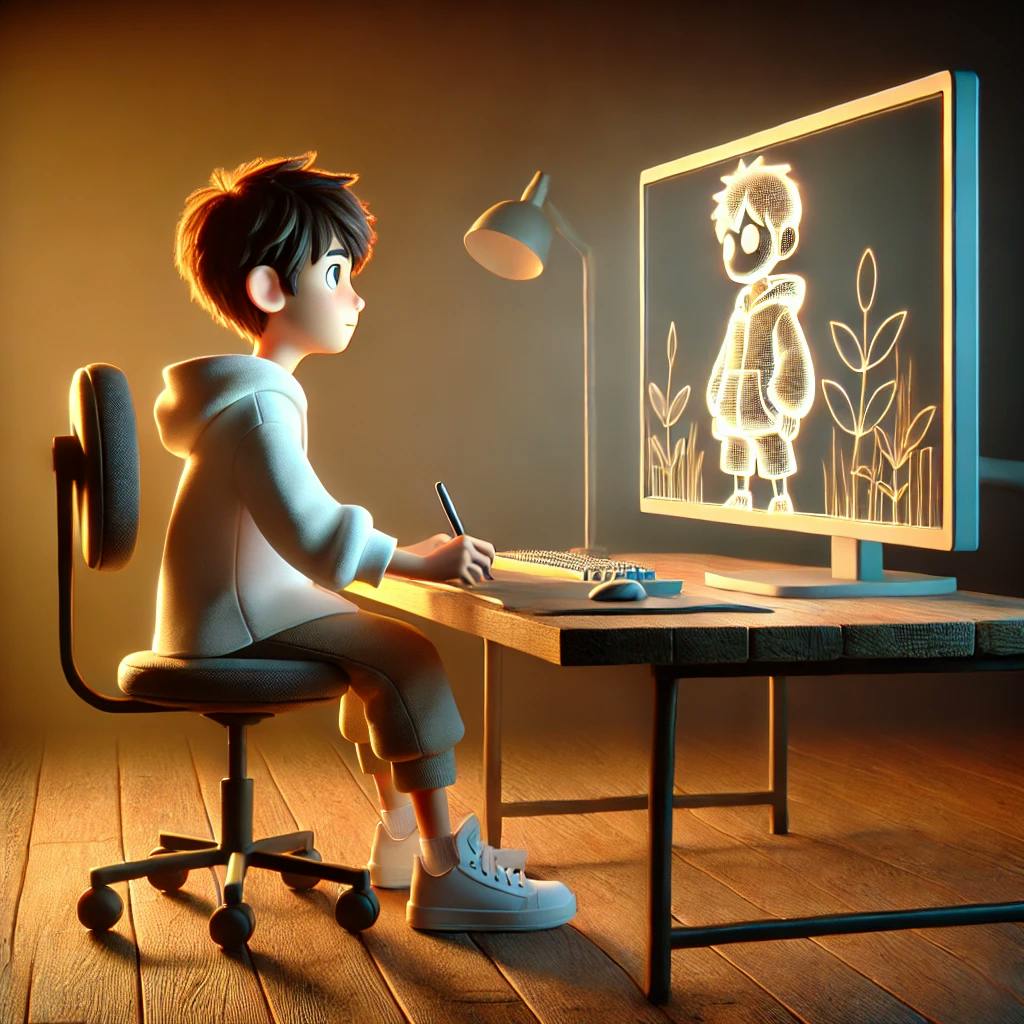
컨셉 아트에 대한 프롬프트는 이전 사례글에 명시해두었습니다. 영상의 썸네일이자 중간 장면으로 생각하여 영상 앞과 뒤를 나누어 만들어보겠습니다.
영상 앞에는 모니터 속에서 그림이 살아나는 장면을, 영상 뒤에는 인사하는 장면으로 구성했습니다.
이미지는 아래와 같습니다.
이용한 툴
Chat gpt: 이미지 비율 1:1, 해상도 480p프롬프트
A 3D Pixar-style digital art scene with warm cinematic lighting.The camera angle must exactly match the reference image: a left-side profile view of a boy sitting at a desk, with a single monitor placed slightly angled on the right.
The boy has short dark hair and is wearing a white button-up shirt — absolutely no hoodie, no hood, and no t-shirt.
He is seated in a swivel chair with no armrests and a single oval-shaped backrest pad attached to a central support bar.
A keyboard and mouse must be clearly visible on the wooden desk, along with a pen tablet placed beside the keyboard.
The boy is holding a stylus above the pen tablet.
Inside the single monitor, a glowing character is fully visible from head to toe in a 2D or holographic art style.
The character has short fluffy hair, visible pupils, an open zip-up hoodie, loose pants, and sneakers.
The full body of the character — including legs and feet — must be completely inside the monitor.
No part of the character may exit or break the screen boundary.
Only one monitor should exist in the scene. No windows in the background.
번역픽사 스타일의 3D 디지털 아트 장면이며, 따뜻하고 시네마틱한 조명이 사용됩니다.
카메라 시점은 반드시 참고 이미지와 동일해야 하며, 소년을 왼쪽 측면에서 본 프로파일 시점이고, 모니터는 책상 위 오른쪽에 약간 각도를 두고 배치되어 있어야 합니다.
소년은 짧은 검은 머리를 하고 있으며, 흰색 버튼업 셔츠를 입고 있어야 합니다 — 후드티, 후드, 티셔츠는 절대 사용하지 않습니다.
소년은 팔걸이가 없는 회전의자에 앉아 있고, 타원형 등받이 시트가 중앙 지지대에 연결된 형태의 의자여야 합니다.
책상 위에는 키보드와 마우스가 명확히 보이도록 놓여 있어야 하며, 키보드 옆에는 펜 타블렛이 배치되어 있어야 합니다.
소년은 스타일러스를 들고 펜 타블렛 위에 손을 올린 상태여야 합니다.
모니터 속에는 빛나는 캐릭터가 2D 또는 홀로그램 스타일로 전신이 보이도록 서 있어야 합니다.
이 캐릭터는 짧고 부스스한 머리, 눈동자가 있으며, 앞지퍼가 열린 후드티와 헐렁한 바지, 운동화를 착용하고 있어야 합니다.
캐릭터의 전신 — 머리부터 발끝까지 — 반드시 모니터 화면 안에 완전히 포함되어야 하며, 화면 밖으로 나와서는 안 됩니다.
장면 안에는 오직 하나의 모니터만 존재해야 하며, 배경에는 창문이 절대 포함되어서는 안 됩니다.
이미지가 완성됬으니 Kling ai를 통해 2개의 이미지를 이어보았습니다.
이용한 툴
Kling ai: 이미지 비율 1:1, 해상도 480p, 영상길이 5초프롬프트
The only characters in the image are the character on the monitor screen and the boy sitting in the chair.They do not do anything other than the following
- The character in the monitor steps forward from the monitor.
Make sure to keep the drawing style exactly the same as the image.
The camera perspective remains the same as the camera view in the image and does not dynamically switch perspectives.
번역이미지의 유일한 캐릭터는 모니터 화면의 캐릭터와 의자에 앉아있는 소년뿐입니다.
이들은 다음 이외의 다른 동작을 하지 않습니다.
- 모니터의 캐릭터가 모니터에서 앞으로 나아갑니다.
그리기 스타일을 이미지와 정확히 동일하게 유지해야 합니다.
카메라 시점은 이미지의 카메라 시점과 동일하게 유지하며 동적으로 시점을 전환하지 않습니다.
이용한 툴
Kling ai: 이미지 비율 1:1, 해상도 480p, 영상길이 5초프롬프트
The only characters in the image are the character in front of the monitor and the boy in the chair.They do not do anything other than
- The character in front of the monitor floats in the air and looks at the boy in the chair, and then the boy in the chair and the character in front of the monitor shake hands.
Make sure to keep the drawing style exactly the same as the image.
The camera perspective remains the same as the camera view in the image and does not dynamically switch perspectives.
번역이미지에 등장하는 유일한 인물은 모니터 앞에 있는 캐릭터와 의자에 앉아있는 소년입니다.
그 외에는 아무것도 하지 않습니다.
- 모니터 앞의 캐릭터가 공중에 떠서 의자에 앉은 소년을 바라보고 의자에 앉은 소년과 모니터 앞의 캐릭터가 악수를 합니다.
그리기 스타일을 이미지와 정확히 동일하게 유지해야 합니다.
카메라 시점은 이미지의 카메라 시점과 동일하게 유지하며 동적으로 시점을 전환하지 않습니다.
결과는 Capcut을 통한 편집영상으로 보여드리겠습니다.
결과와 배운 점
첫 5초는 이미지가 미묘하게 달라 굉장히 엉성한 느낌이 듭니다.
이 이미지는 시드를 활용한 것이 아니라 Chat gpt에게 반복적으로 컨셉 아트를 보여주며, 이미지가 다른 부분을 하나씩 지적했습니다. 예) 이미지의 분위기, 책상 위의 배치, 등장인물의 복장, 앉아있는 의자의 특징, 캐릭터의 데포르메 정도 등
Chat gpt에게 30번 정도 필터링을 걸친 끝에 하나가 완성되는군요.
나름 가깝게 만들어냈지만 막상 영상으로 만들어보니 두 사진의 차이를 보안하려는 움직임이 노골적으로 보이네요. 다음 과제는 일관성을 가지고 영상을 이어보고자합니다.
이전 실패 사례인 서로 악수하는 장면은 Sora가 아닌 Kling ai로 진행하여 더 짧은 프롬프트로, 더 적은 실패 후에 원하는 영상을 얻어냈습니다.
Sora의 경우, 정확한 등장인물의 행동들을 지정해주어도 AI의 재해석이 과하게 들어가는 경향이 있는 것 같습니다.
반면, Kling ai의 경우, 등장인물의 수, 등장인물의 행동, 카메라 뷰의 위치 정도만 지정해주는 것으로 그대로 재현해내는 것 같습니다
결과적으로 아쉬운 영상이지만, 상황에 따라 필요한 영상과 툴을 활용해본 경험과 이미지 일관성의 필요성, 재현해보고자 했던 경험 등 정말 보람찬 것들을 얻었습니다. 상술했듯이 다음 목표는 일관된 이미지를 통해 더 자연스런 영상을 만들고자 합니다.
감사합니다.
로그인하고 댓글을 남겨 주세요

와 영상을 만드시는 능력이 엄청 나세요. 저는 전혀 생각하지 못한 뭔가 전달하려는 메세지를 고민하고 만드신게 작품에서도 전달되는 느낌이네요~!
잘 봤습니다~
원택님 정말 수고 많으셨어요! 원하는 영상을 만들기까지 많은 시행착오를 겪으면서 좋은 결과물을 얻으셨네요. 따뜻하고 잘 만들어진 영상이네요~!
원택님, 완성하셨군요! 👍 👍 👍 짧은 영상이지만 만드는 과정에 얼마나 많은 노력과 시간이 들었는지 충분히 예상이 됩니다. 깔끔하게 너무 잘 제작하셨어요. 좋은 인사이트까지 남겨주셔서 큰 도움이 되었습니다. 오프모임에서 말씀드렸던 Midjourney도 사용해보시길 권해드려요~ 이미지 퀄리티를 업그레이드 할 수 있어요!

Wow, 더 앞으로 나아가고자 하는 실험 정신과 도전 정신 respect합니다! 저도 잘 못하는 실험과 도전을 현상에 만족하지 않고 거침없이 하시는 모습 최고입니다. 👍 지난(그래봐야 바로 얼마 전인 것 같은데요...ㅎㅎ)번 보다 훨씬 더 뛰어난 영상미를 보여주셨네요. 멋지세요~🥰

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요

퀄리티가 너무 너무 대단합니다!