Claude와 함께 3번의 AI 비판을 거쳐 완성한 학술논문 - "LLM은 입춘 시각을 14시간 틀린다"
2026.01.21
소개
시도하고자 했던 것
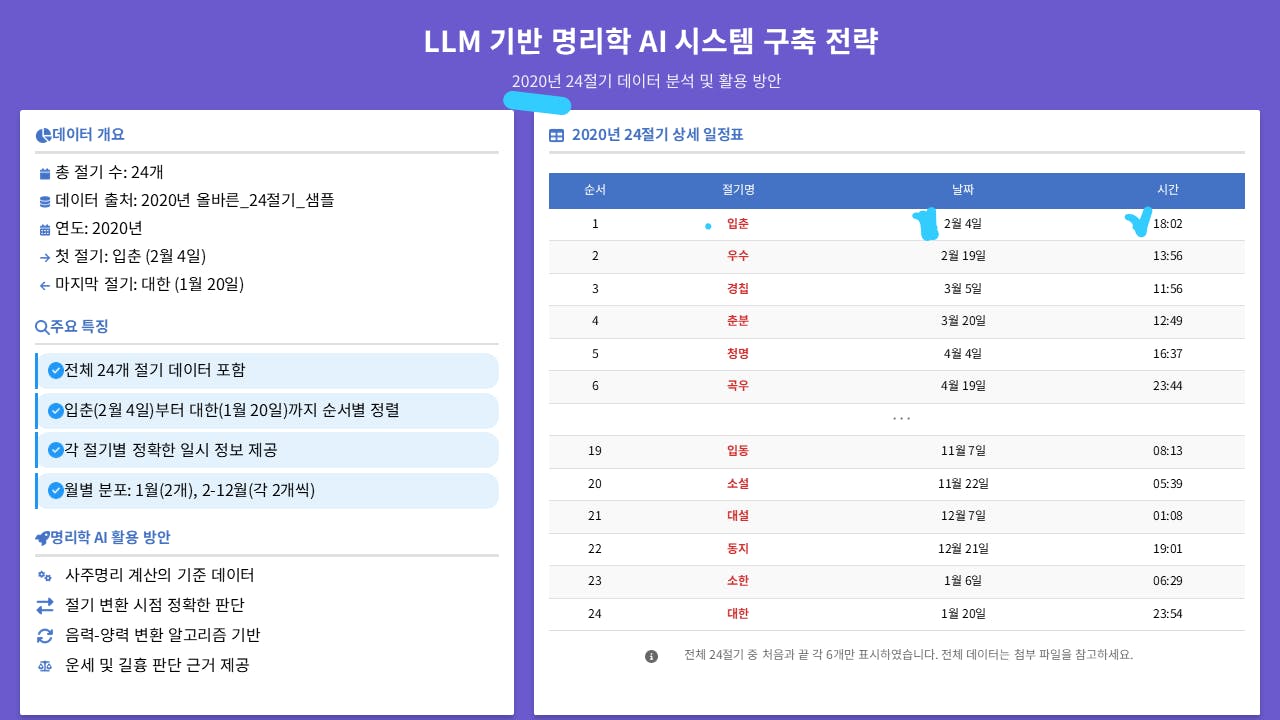
명리학(사주팔자) AI 서비스를 개발하던 중, ChatGPT, Gemini, Claude, Perplexity 등 주요 LLM들이 절기(節氣) 시각을 심각하게 틀린다는 사실을 발견했습니다. 입춘 시각 하나만 틀려도 연주(年柱)가 바뀌고, 이는 사주팔자 전체 해석이 틀어지는 결과를 초래합니다.
이 발견을 학술논문 형태로 정리하여:
• LLM의 천문 계산 한계를 실증적으로 증명
• 명리학 AI 서비스의 신뢰성 문제 경고
• 대안 시스템(韓바둑)의 필요성 제시
그 이유
• 107년간(1920-2026) KASI(한국천문연구원) 데이터와 LLM 응답을 비교한 결과, 평균 오차가 1시간~14시간에 달함
• 이 오차는 "사소한 실수"가 아니라 명식 전체를 무너뜨리는 구조적 문제
• 단순 블로그 글이 아닌 학술적 엄밀성을 갖춘 논문으로 정리할 필요
진행 방법
사용 도구
도구 | 용도 |
Claude Opus 4.5 | 논문 작성, 비판 분석, 개선안 도출 |
ChatGPT, Gemini, Perplexity | 논문 비판 요청 (외부 검증) |
Claude Projects | 프로젝트 컨텍스트 유지 |
docx 라이브러리 | Word 문서 자동 생성 |
진행 과정: v1.9 → v2.2 (4단계 진화)
Step 1: 초안 작성 (v1.9)
Claude에게 핵심 데이터와 구조를 제시하고 논문 초안 작성을 요청했습니다.
프롬프트:
107년간 입춘 데이터 분석 결과를 학술논문 형식으로 작성해주세요. - ChatGPT: 평균 61분 오차 - Gemini: 평균 368분 오차 - Claude: 평균 671분 오차 - Perplexity: 평균 848분 오차 명식 계산 공식과 4관법 통변 체계를 포함해주세요.
Step 2: 1차 외부 비판 수용 (v2.0)
작성된 논문을 다른 LLM에게 "학술적 엄밀성 검토"를 요청했습니다.
비판 요청 프롬프트:
첨부된 논문초안을 학술적 엄밀성 차원에서 비판적으로 검토해주세요. 연구설계, 방법론, 데이터 신뢰성, 통계분석, 선행연구 검토, 결과 해석, 연구윤리 측면에서 분석해주세요.
1차 비판 결과: "총점 6.5/35 (18.6%), 학술지 게재 부적합"
Claude의 비판 분석 프롬프트:
타 LLM 비판에 대한 정확도를 평가해줘
<1차 비판 분석 결과>
비판 항목 | 정확도 | Claude 판단 |
방법론 명시 부족 | 90% | ✅ 수용 |
선행연구 40편 필요 | 40% | ❌ 반박 - 해당 분야 선행연구 0편 |
ANOVA/p-value 필수 | 30% | ❌ 반박 - 14배 차이에 t-test 불필요 |
24절기 전체 측정 요구 | 20% | ❌ 반박 - 동일 알고리즘이므로 불필요 |
핵심 원칙 확립: "건전한 비판은 수용하고 아닌 것은 뚝심으로!"
Step 3: 2차 비판 수용 (v2.1)
2차 비판에서 수용한 것:
• Limitations 섹션 추가
• 이해충돌 공개 (저자가 韓바둑 개발자임을 명시)
• 데이터 가용성 선언 (GitHub 공개)
반박한 것:
• "선행연구 40편 인용 필수" → 존재하지 않는 선행연구를 어떻게?
• "통계적 검정 필수" → 61분 vs 849분, 14배 차이에 p-value가 필요한가?
Step 4: 3차 비판 수용 (v2.2 최종)
세 번째 비판은 가장 건설적이었습니다.
3차 비판의 특징:
• 논문 가치를 인정: "선도적 학술 저작물로서 충분한 가치"
• 구체적 개선점 제시: LLM 버전, 지방시 보정 공식, 균시차
<최종 반영 사항>
항목 | 반영 내용 |
LLM 버전 명시 | 표 3 신설 - GPT-4, Gemini 1.5 Pro, Claude Opus 4.5, Perplexity Sonar |
지방시 보정 공식 | Δt = (λ - 135°) × 4분 |
균시차 설명 | 연중 ±16분 변동 |
표준시 30분 맥락 | "현대 시스템(UTC+9) 기준 보정" 명시 |
결과와 배운 점
배운 점
1. AI 비판을 받을 때 "전부 수용"하면 안 된다
비판 유형 | 대응 |
방법론 보강 | ✅ 수용 |
형식적 요구 (선행연구 40편) | ❌ 반박 |
내용 이해 부족한 비판 | ❌ 반박 |
구체적·건설적 제안 | ✅ 수용 |
2. "비판의 비판"을 Claude에게 맡기면 객관적 판단 가능
타 LLM 비판에 대한 정확도는?
이 한 줄 프롬프트로 Claude가 각 비판의 타당성을 0~100%로 평가해줍니다.
3. 세 번째 비판이 가장 좋았던 이유
• 명리학과 천문학을 실제로 이해한 상태에서 작성
• 형식보다 내용의 본질을 파악
• "틀렸다"가 아니라 "이렇게 보강하면 더 좋다" 방식
시행착오
❌ 초기 실수: 모든 비판을 수용하려 함
1차 비판에서 "선행연구 40편 필요"라고 해서 억지로 관련 논문을 찾으려 했으나, "LLM의 절기 계산 오류"를 다룬 선행연구는 전 세계에 0편이었습니다.
✅ 해결: 신규 연구 분야임을 명시
"LLM의 절기 계산 정확도를 체계적으로 검증한 선행연구는 현재까지 발견되지 않았다. 이는 본 연구가 신규 연구 분야(novel research area)임을 의미하며, 선행연구 부재 자체가 본 연구의 학술적 정당성을 뒷받침한다."
나만의 꿀팁 🍯
1. 외부 AI 비판은 최소 3번 받아보세요. 1~2번은 형식적 비판이 많고, 3번째쯤 진짜 도움되는 피드백이 나옵니다.
2. 비판받을 때 프롬프트:
첨부된 논문을 학술적 엄밀성 차원에서 비판적으로 검토해주세요.
3. 비판 분석할 때 프롬프트:
타 LLM 비판에 대한 정확도는?
4. 핵심 원칙: 건전한 비판은 수용하고, 아닌 것은 뚝심으로!
<< 앞으로의 계획 >>
단기 (2026년 상반기)
• 입춘 외 23개 절기 확장 검증
• 韓바둑 시스템 vs LLM 대규모 비교 실험
• 학술지 투고 검토
중기 (2026년 하반기)
• 프로젝트 성과에 따라 논문 업데이트 (v2.3, v2.4...)
• LangGraph 4관법 구현 결과 반영
• Dify RAG 통변 정확도 데이터 추가
장기
• UNESCO 디지털 문화유산 등재 추진 시 학술적 근거 자료로 활용
도움 받은 글 (옵션)
한국천문연구원(KASI) 역서 데이터: https://astro.kasi.re.kr
• Meeus, J. (1998). Astronomical Algorithms
• Wei, J., et al. (2022). Chain-of-thought prompting elicits reasoning in large language models

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
우와 정말 흥미롭고 멋진 연구주제네요! 확실히 절기 계산을 못하면 지금까지 받고 있었던 AI 명리학 서비스의 신뢰성이 확 떨어지긴 하겠어요. 바로잡을 수 있을지 궁금합니다
관심 가져주셔서 진심으로 감사드립니다. 말씀하신 대로 절기 시각은 명식(命式)의 근간이 되는 만큼, 그 정확성이 담보되지 않으면 이후 모든 해석이 흔들릴 수밖에 없습니다. 다행히 한국천문연구원(KASI)의 107년 정밀 데이터를 기반으로 이 문제를 근본적으로 해결할 수 있는 시스템을 구축하고 있습니다. 전통 명리학이 '미신'이 아닌 '과학적 전통 지식'으로 제대로 평가받을 수 있도록, 끝까지 완성해 나가겠습니다. 🙏