「같은 목소리, 세 장의 사진: 말하는 강아지 영상에서 달라진 것들」
2026.11.13
실험 설계: 하나의 오디오, 하나의 대본, 세 장의 사진
이 기록은 특정 도구 하나를 홍보하려는 것이 아니다. 같은 입력 조건에서 반려동물 사진이 영상으로 변환될 때 무엇이 달라지는지를, 통제된 변수로 관찰하려는 시도다. 우리는 오디오 트랙 하나와 짧은 대본 하나를 처음부터 끝까지 고정했고, 변화시킨 것은 오직 소스 사진뿐으로 제한했다. 비교에 쓴 사진은 세 장이다. 단두종(주둥이가 짧은) 강아지 한 장, 장두종(주둥이가 긴) 강아지 한 장, 그리고 얼굴이 정면이 아닌 옆얼굴 측면 샷 한 장이다. 사진은 모두 일상에서 찍은 스마트폰 원본 그대로를 썼고, 전처리나 마스킹 없이 올린 채로 두었다. 원본이 도구에 어떻게 해석되는지 그 자체를 보고 싶었기 때문이다.
그 rationale은 분명하다. 요즘 립싱크 도구 대부분은 사람 얼굴을 전제로 랜드마크 모델을 학습했기 때문에, 비인간 해부학에서는 어디가 입인지 어디까지가 턱선인지 판단이 흔들릴 여지가 있다. 조건을 하나씩만 바꾸면 그 흔들림이 어느 지점에서 발생하는지 읽을 수 있다. 이 글은 2026년 후반 기준으로, 브라우저에서 동작하는 여러 도구를 같은 오디오로 건드려 본 결과를 정리한 것이다.
주둥이 주변 랜드마크와 턱 매핑의 차이
단두종 사진에서는 주둥이가 짧아 입술과 코가 가깝게 붙어 있다. 이 경우 랜드마크 탐지가 코 주변에 집중되면서, 입을 여닫는 움직임이 실제보다 작게 매핑되는 경향이 관찰됐다. 코의 그림자가 입술 경계와 겹치면 그 오차는 더욱 줄어든 폭으로 고정되기도 했다. 반면 장두종은 긴 주둥이가 제공하는 추가 픽셀이 턱선 추적에 여유를 주어, 입 개폐의 진폭이 상대적으로 또렷이 잡혔다.
측면 샷은 문제가 다르다. 정면을 향하지 않은 얼굴에서는 입의 내부가 거의 보이지 않아, 도구가 입술의 바깥선만으로 개폐를 추정해야 한다. 관찰한 바로는 측면 사진일수록 입 주변의 움직임이 둔화되거나, 턱 아래 털 가장자리만 미세하게 흔들리는 식으로 보상되는 경우가 있었다. 주둥이 주변의 랜드마크는 사진의 형태에 따라 가장 민감하게 반응한다. 세 장의 사진으로 말하는 강아지 영상을 만들 때 가장 먼저 달라지는 것은 바로 이 주둥이 경계의 안정성이었다.
수염, 털 가장자리, 그리고 침묵 구간의 처리
털과 수염은 립싱크 모델이 정면 인간 얼굴에서 배우지 않은 영역이다. 단두종과 장두종 모두에서 입 주변 털이 입술 경계와 섞이면, 모델이 털 끝을 입술의 일부로 오인해 작은 떨림을 만들기도 했다. 이는 도구의 단순 오류라기보다, 학습 데이터 분포상 비인간 털 텍스처가 드물다는 사실의 반영으로 읽힌다. 털이 진한 견종일수록 이 경계 혼동은 자주 나타났다.
침묵 구간, 즉 오디오에 발화가 없어 정적인 부분에서는 도구마다 반응이 갈린다. 어떤 방식은 완전히 정지된 프레임을 유지하고, 어떤 방식은 호흡이나 미세한 머리 흔들림을 합성해 자연스러움을 보충한다. 우리가 고정한 오디오에서도 문장 사이의 쉼표 지점에서 이 차이가 뚜렷했으며, 이는 출력 영상의 "정지된 느낌" 여부를 가르는 변수가 된다. 따라서 정적 구간이 긴 대본을 쓸 때는, 침묵을 어떻게 채우는지가 선택의 기준이 된다.
다섯 가지 도구의 오디오 수용 방식
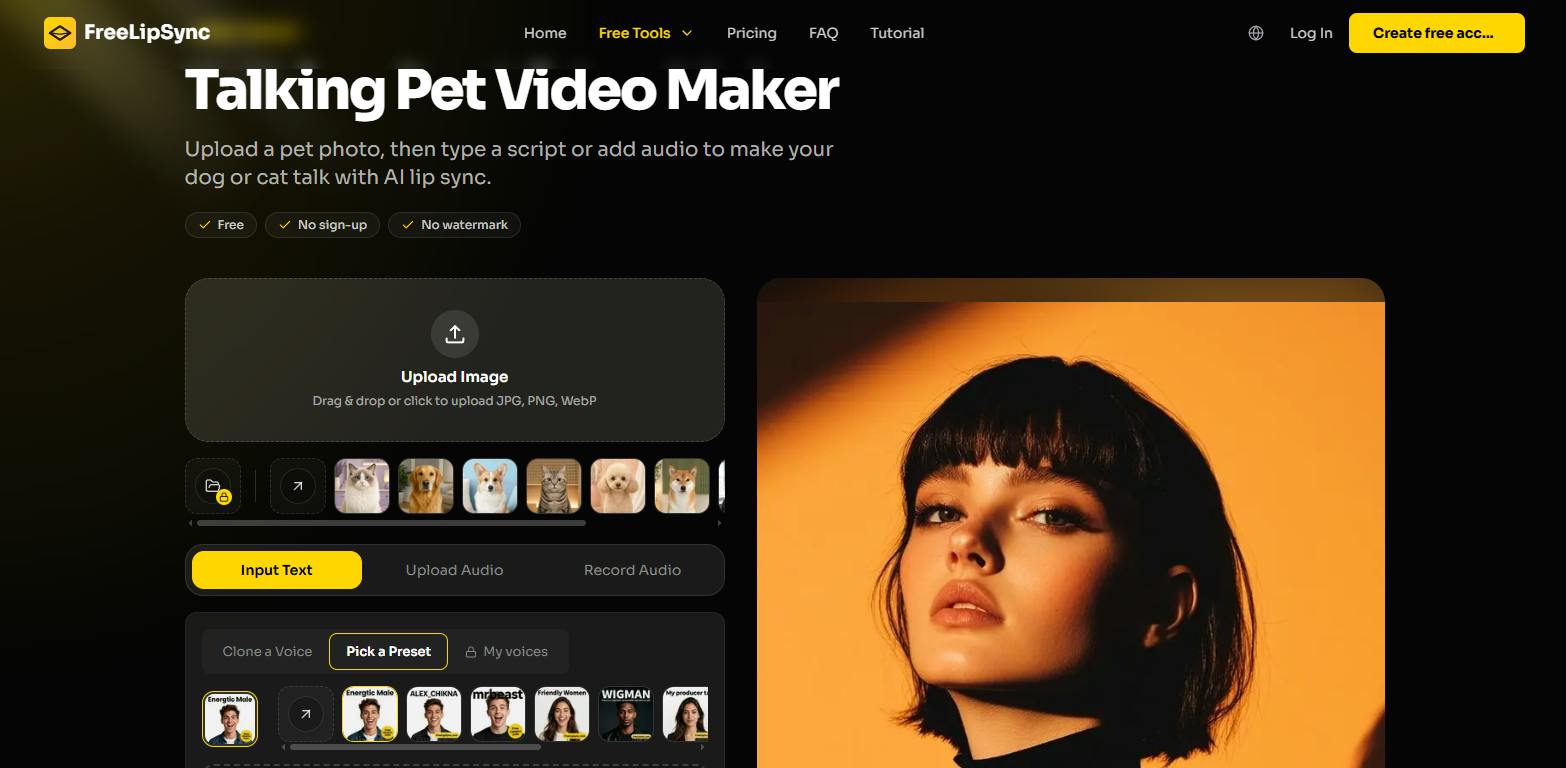
같은 실험 조건을 다섯 가지 도구에 대입해 보면, 오디오를 어떻게 받아들이는지가 먼저 갈린다. FreeLipSync의 Talking Pet Video Maker는 반려동물 사진에 말하는 목소리를 입히는 흐름을 취하며, 입력으로 사진과 음성을 조합해 동물이 말하는 듯한 짧은 영상을 만든다. TalkingPets.ai는 브라우저 기반으로 출발하며 무료 스타터 영상을 제공하는 구조고, 음성 녹음·입력 텍스트·붙여넣은 숏폼 사운드 링크 중 하나를 받는다. Mango AI는 템플릿 중심 접근으로, 120개 이상 언어의 TTS와 내장 샘플 동물 라이브러리, 조절 가능한 표정 강도를 갖추었다. JoggAI는 에이전시 지향의 빠른 렌더링을 강조하며 털이 덮인 얼굴에 맞춘 랜드마크 탐지를 내세운다. Orylia AI는 OmniHuman 기반 클립을 오디오 초 단위로 과금하며, 약 35초 한도와 죄송한 고백류 같은 장면 프리셋을 제공한다.
이러한 입력 경로의 차이는, 여러분이 이미 가진 자원—녹음본인지, 타이핑한 대본인지, 혹은 다른 영상의 소리인지—에 따라 도구 선택의 첫 기준이 된다. 예를 들어 텍스트만 있다면 내장 TTS를 가진 도구가 한 단계를 줄이고, 남의 영상 소리를 재활용하고 싶다면 붙여넣기 링크를 받는 도구가 유리할 수 있다. 반대로 깔끔한 녹음본이 있다면, 업로드만으로 끝나는 도구가 가장 짧은 경로다.
비인간 해부학을 다루는 태도
다섯 도구는 비인간 해부학을 대하는 방식에서도 차이를 보인다. FreeLipSync의 Talking Pet Video Maker는 반려동물 계정·브랜드 밈·소셜 공유용 콘텐츠에 쓰이는 것을 목적으로 사진 기반 합성을 정돈된 흐름으로 제공한다. Mango AI는 템플릿과 표정 강도 조절로 동물 형태를 통제 가능하게 만든다. JoggAI는 털 덮인 얼굴에 최적화한 랜드마크로, 우리 실험의 측면 샷과 장두종 사진처럼 정면이 아닌 조건에 가깝게 동작한다. Orylia AI는 장면 프리셋을 통해 비인간 캐릭터를 특정 연출 안에 배치한다.
어느 것이 "올바른" 방식인지는 실험 조건에 달려 있다. 중요한 것은 각 도구가 비인간 해부학을 어디까지 사람 모델에서 빌려오고, 어디서 별도 처리를 더하는지 사실 관계를 파악하는 것이다. 정면이 아닌 사진 한 장을 두고도 도구마다 결과의 결이 달라지므로, 단일 스크린샷만 보고 판단하는 것은 피해야 한다.
결론 대신: 가진 사진으로 선택 기준 세우기
이 기록은 승자를 가리지 않는다. 대신 세 장의 사진을 통해 관찰한 변수—주둥이 길이, 측면 여부, 털 경계, 침묵 처리—를 바탕으로 중립적인 선택 기준을 제안한다. 정면·짧은 털·선명한 입술 경계의 사진이라면 어느 도구든 안정적이다. 주둥이가 길거나 측면 샷이라면, 랜드마크 탐지가 비인간 얼굴에 맞춰진 도구가 유리할 수 있다. 오디오가 녹음본이 아니라 텍스트라면 내장 TTS를 가진 도구가 한 단계를 줄인다.
여러분이 실제로 가진 동물 사진 한 장이 이 모든 비교의 출발점이다. 그 사진의 조건을 먼저 읽고, 그다음 입력 방식과 해부학 처리 태도를 대조하는 것이 재현 가능한 관찰의 순서다. 변수를 하나씩만 바꿔가며 같은 오디오로 반복해 보는 것, 그것이 이 글이 독자에게 남기고자 하는 유일한 방법론이다.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요