Anthropic 은 에이전트와 어떻게 일하나: 행정 에이전트 뽀총무에 대 보며 배운 다섯 가지
2026.11.18
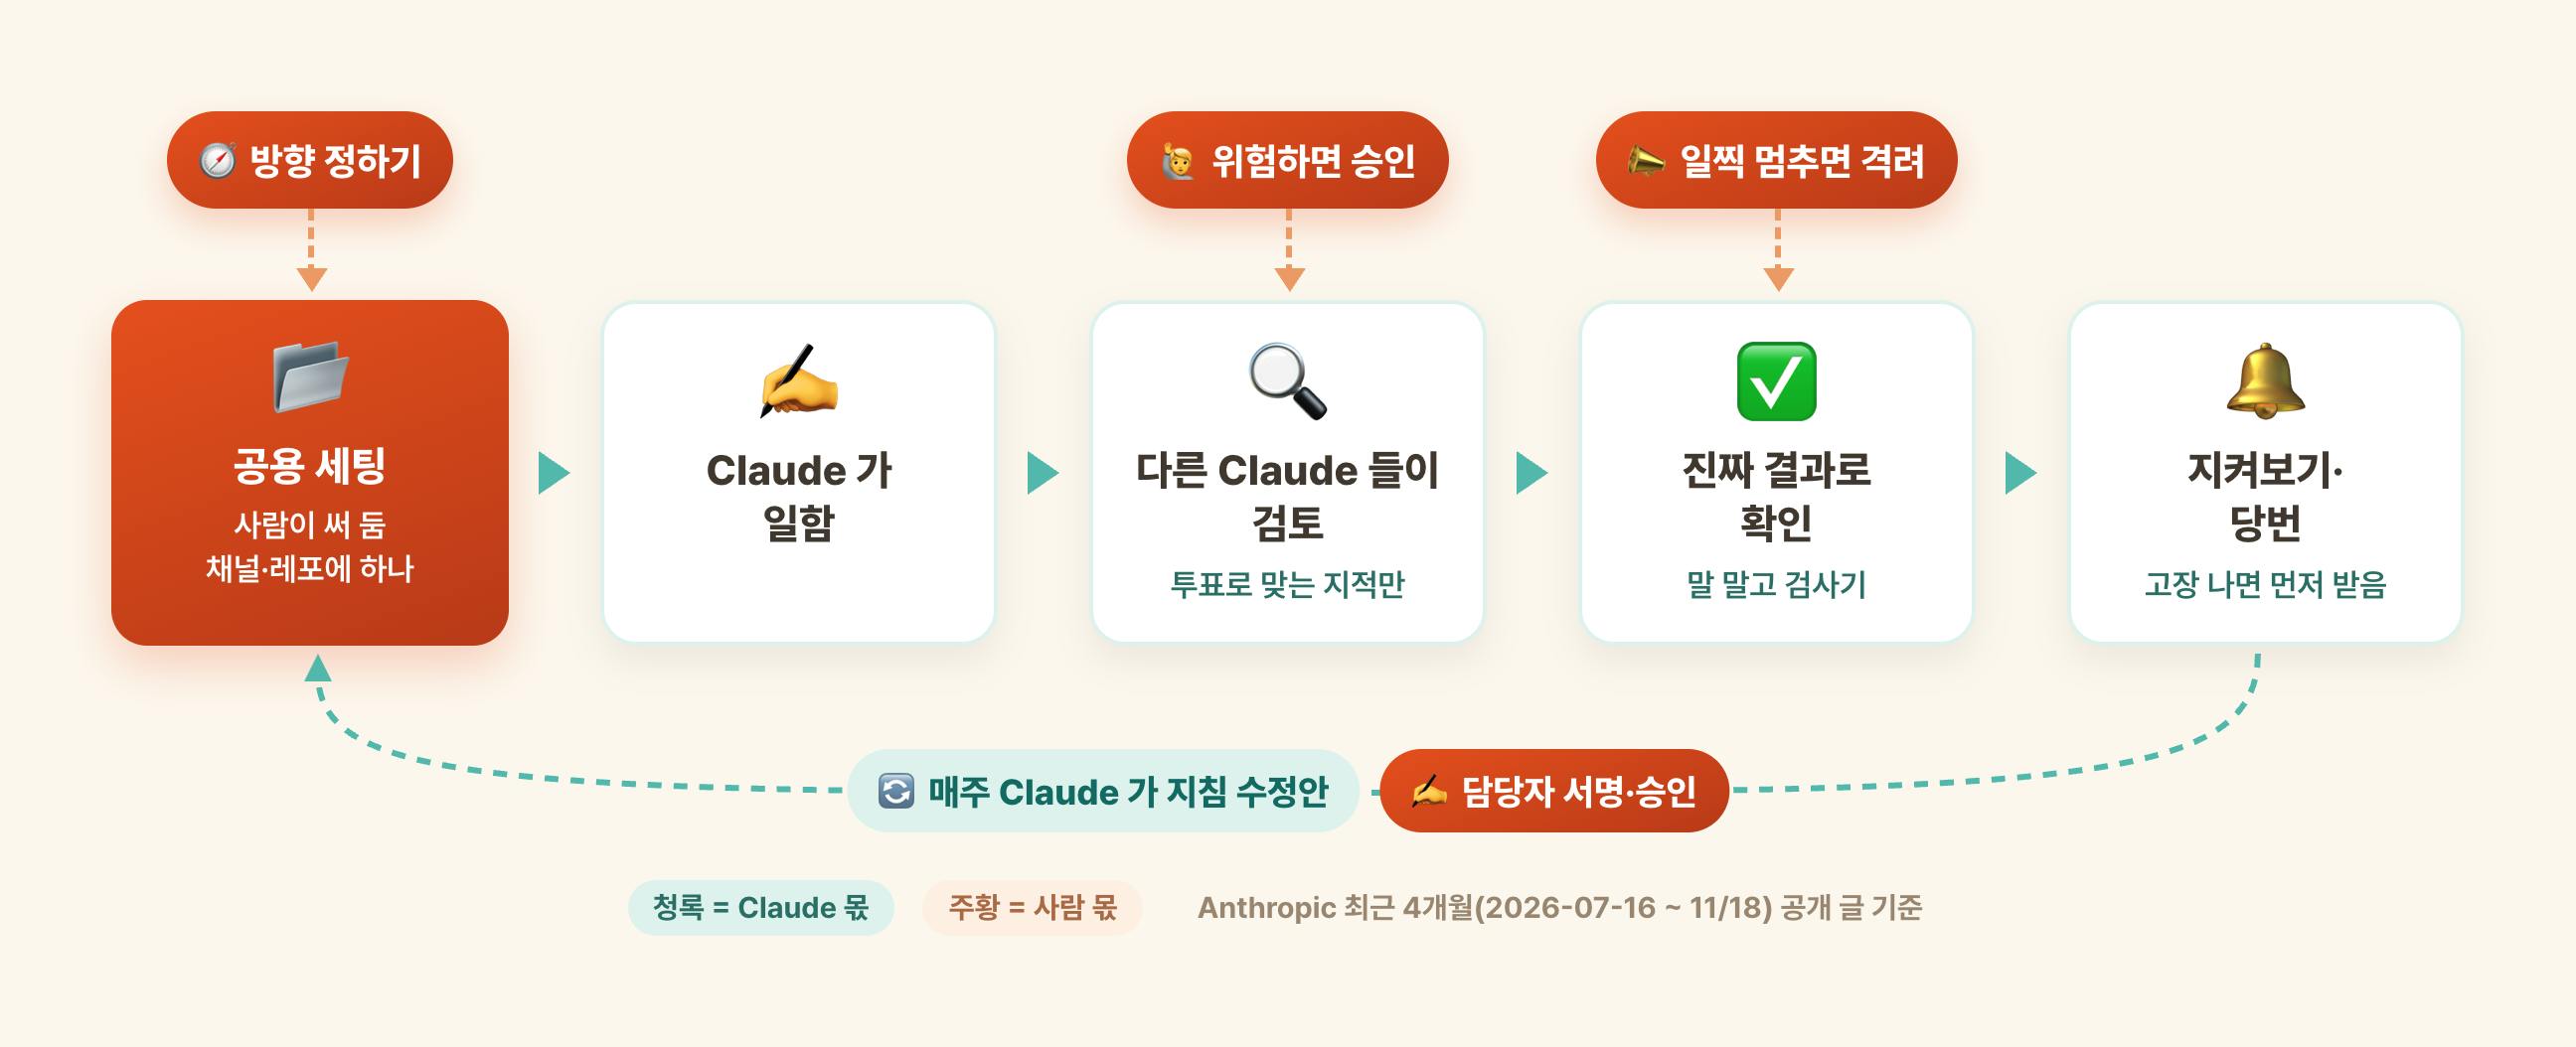
Claude 를 만드는 Anthropic 은 자기 제품으로 자기 일을 합니다. 합친 코드의 약 80% 를 Claude 가 씁니다. 이 회사가 에이전트와 일하는 방식을 공개 글로 읽으며 뽀총무에 하나씩 대 봤습니다. 읽다가 헷갈린 지점이 다섯 번 있었고, 그때마다 우리에게 맞는 답이 나왔습니다.
자료: 최근 4개월(2026년 7월 16일부터 11월 18일까지)에 나온 Anthropic 블로그, 유튜브 등 공개 데이터
1. 검토는 다른 Claude 가 한다
Anthropic 은
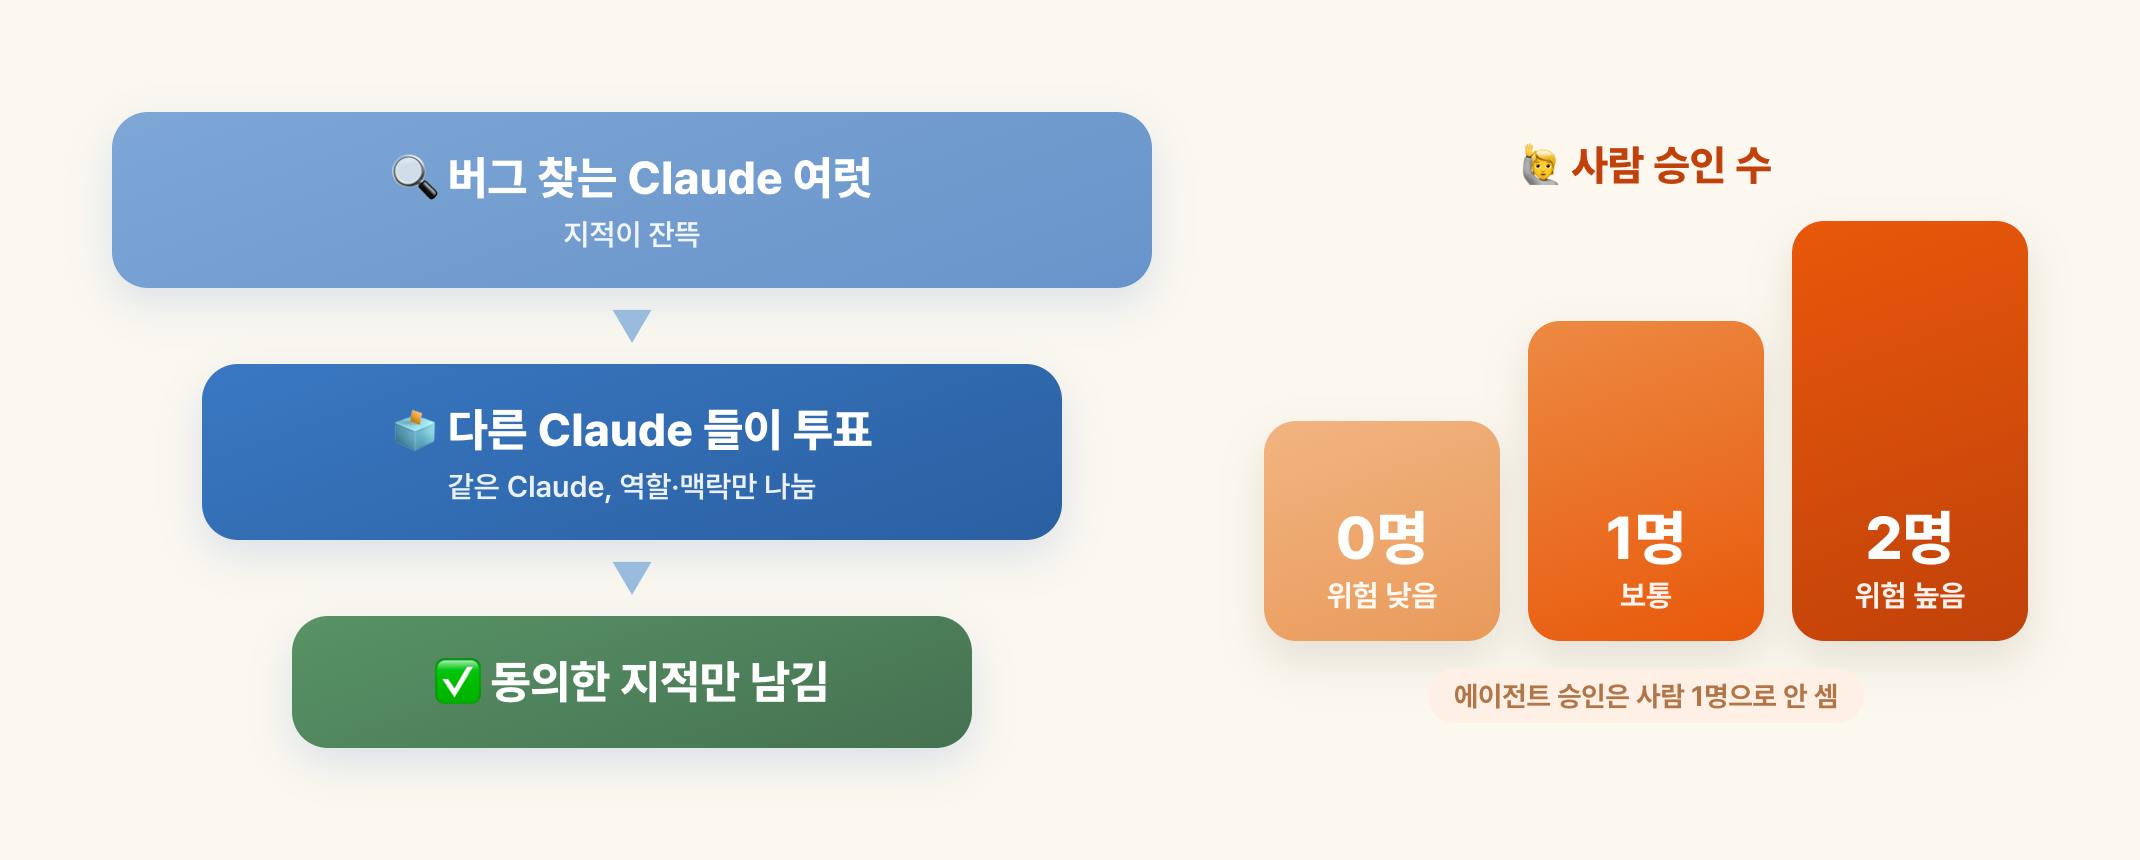
변경 하나에 버그 찾는 에이전트 여럿 → 다른 에이전트들이 지적마다 투표 → 동의한 것만 남김
위험할수록 사람 승인 수가 늘어남(낮음 0명 / 보통 1명 / 높음 2명). 에이전트 승인은 사람 1명으로 안 셈
같은 실수가 자꾸 잡히면 쓰는 에이전트의 규칙에 한 줄, 사고를 낸 변경은 검토 봇의 시험 문제로
한계도 밝힘: 쓰는 쪽과 검토하는 쪽이 밤새 50번 넘게 주고받은 일 → 3번으로 제한
처음엔 이렇게 생각했습니다
검토용 에이전트를 오픈클로나 헤르메스처럼 따로 만드는 줄 알았습니다. 아니었습니다. 같은 Claude 를 쓰되 역할과 맥락만 나눕니다. 쓴 쪽의 생각에 묶이지 않게 새 맥락에서 보게 하는 것이 핵심입니다.
우리라면
이미 함일하는 모델과 검토하는 모델을 나눔: 일은 Codex(막히면 Fable → Astra), 코드 검토와 시험 채점은 Claude이미 함재발 시험(11/16~): 사람이 짚은 실수로 문제를 만들어 밤마다 다시 풀게 함해 볼 만함돈·최종 제출과 직접 관련 있는 변경은 2번 검토
2. 세팅은 사람 말고 채널·레포에 둔다
Anthropic 은
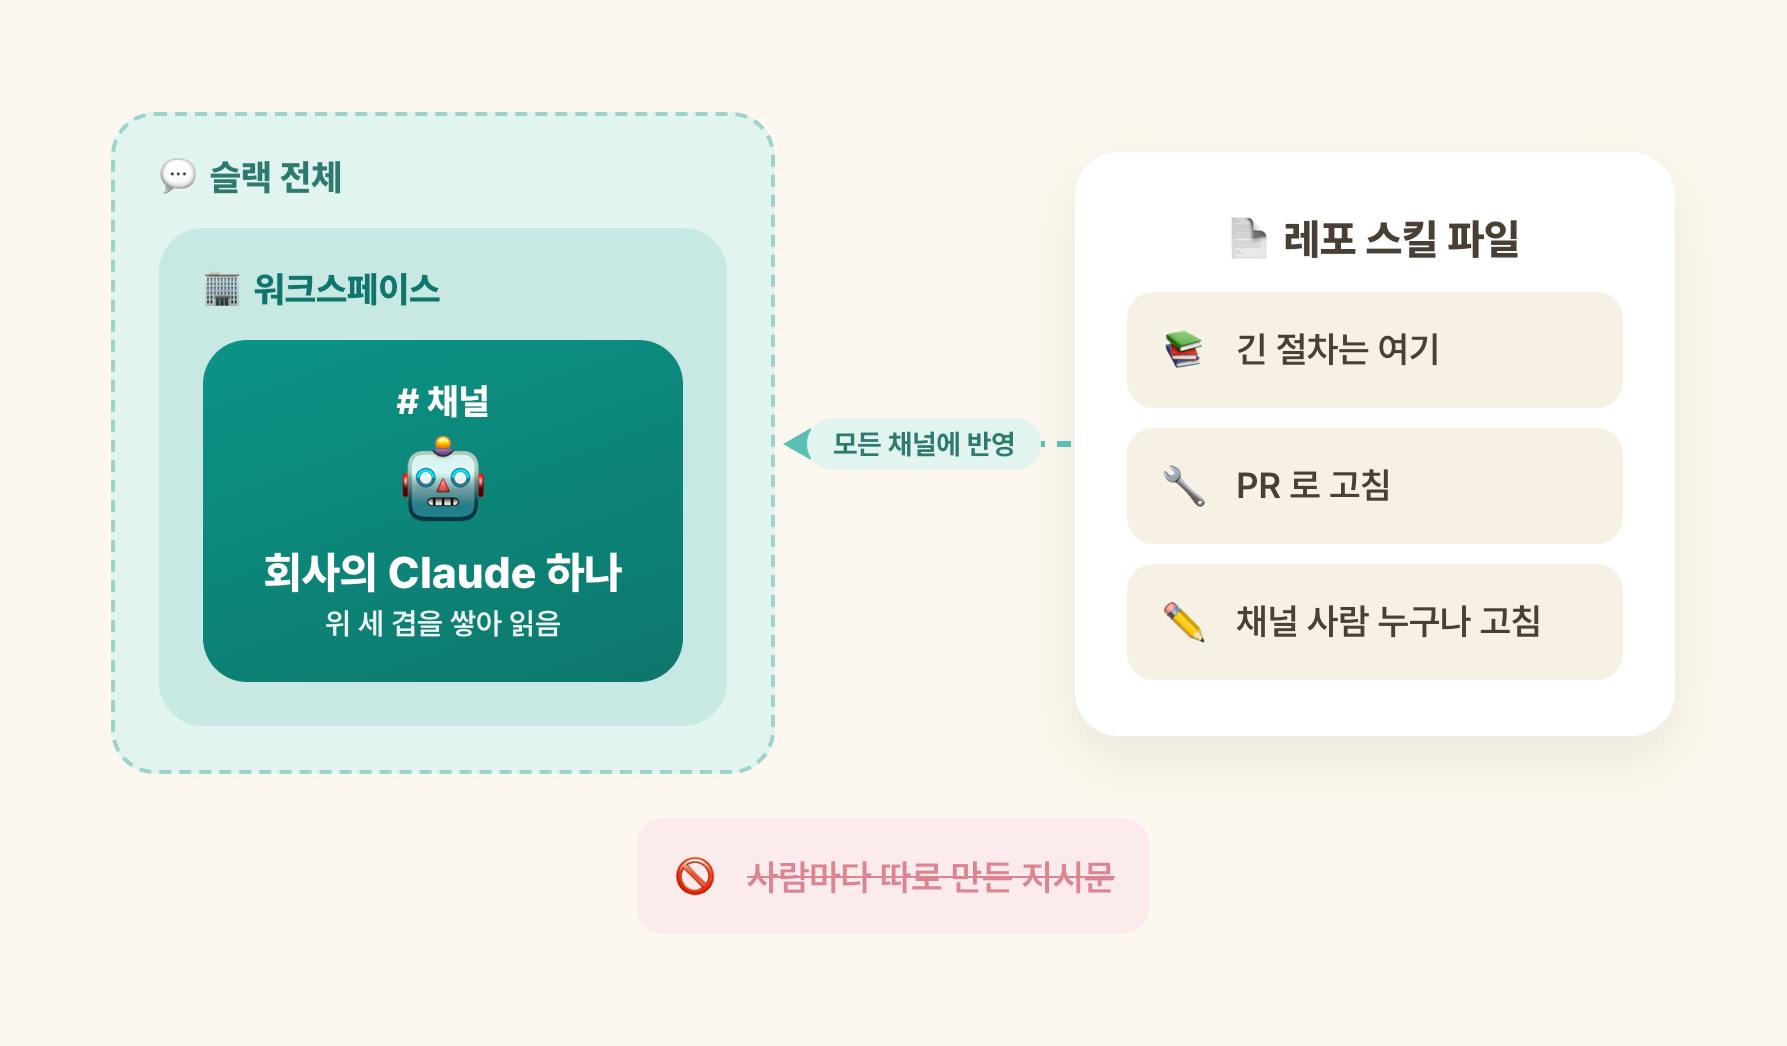
사내 Claude(Claude Tag)는 사람마다 만드는 에이전트 대신 회사가 슬랙에 붙인 Claude 하나
지시문: 설정 화면의 짧은 문장 몇 줄(예: 「답은 세 문장 안으로」). 슬랙 전체 → 워크스페이스 → 채널 순으로 쌓아 읽음. 개인 지시문 없음, 채널 사람이면 누구나 수정
긴 절차는 GitHub 레포의 스킬 파일 → PR 로 고치면 모든 채널에 반영
「기록 없는 회의와 DM 속 일은 보이지 않는다」 → 사람 일도 에이전트가 보는 채널로
처음엔 이렇게 생각했습니다
Claude Tag 는 기본 Claude 라서 우리와 경우가 다르다고 생각했습니다. 차이는 에이전트 종류가 아니라 세팅이 어디에 있느냐였습니다. 지피터스는 팀원마다 자기 에이전트를 씁니다. 슬랙 글은 서로 보이지만, 그 글을 만든 지시문과 메모리는 각자 컴퓨터에만 있습니다. 그래서 같은 공부를 여러 번 하고, 더 나은 방법이 퍼지지 않습니다.
우리라면
이미 함뽀총무 결정이 맥에만 남지 않게 채널 글·메일·맥 결정을 맥락 카드로 옮김해 볼 만함공통 지시문 한 벌을 레포에 두고, 각자 지시문은 그 위에 얹고, 배운 것은 PR 로 함께 고치기(진우님 영역이라 소개만)
3. 지침은 그 일 담당자가 매주 고친다
Anthropic 은
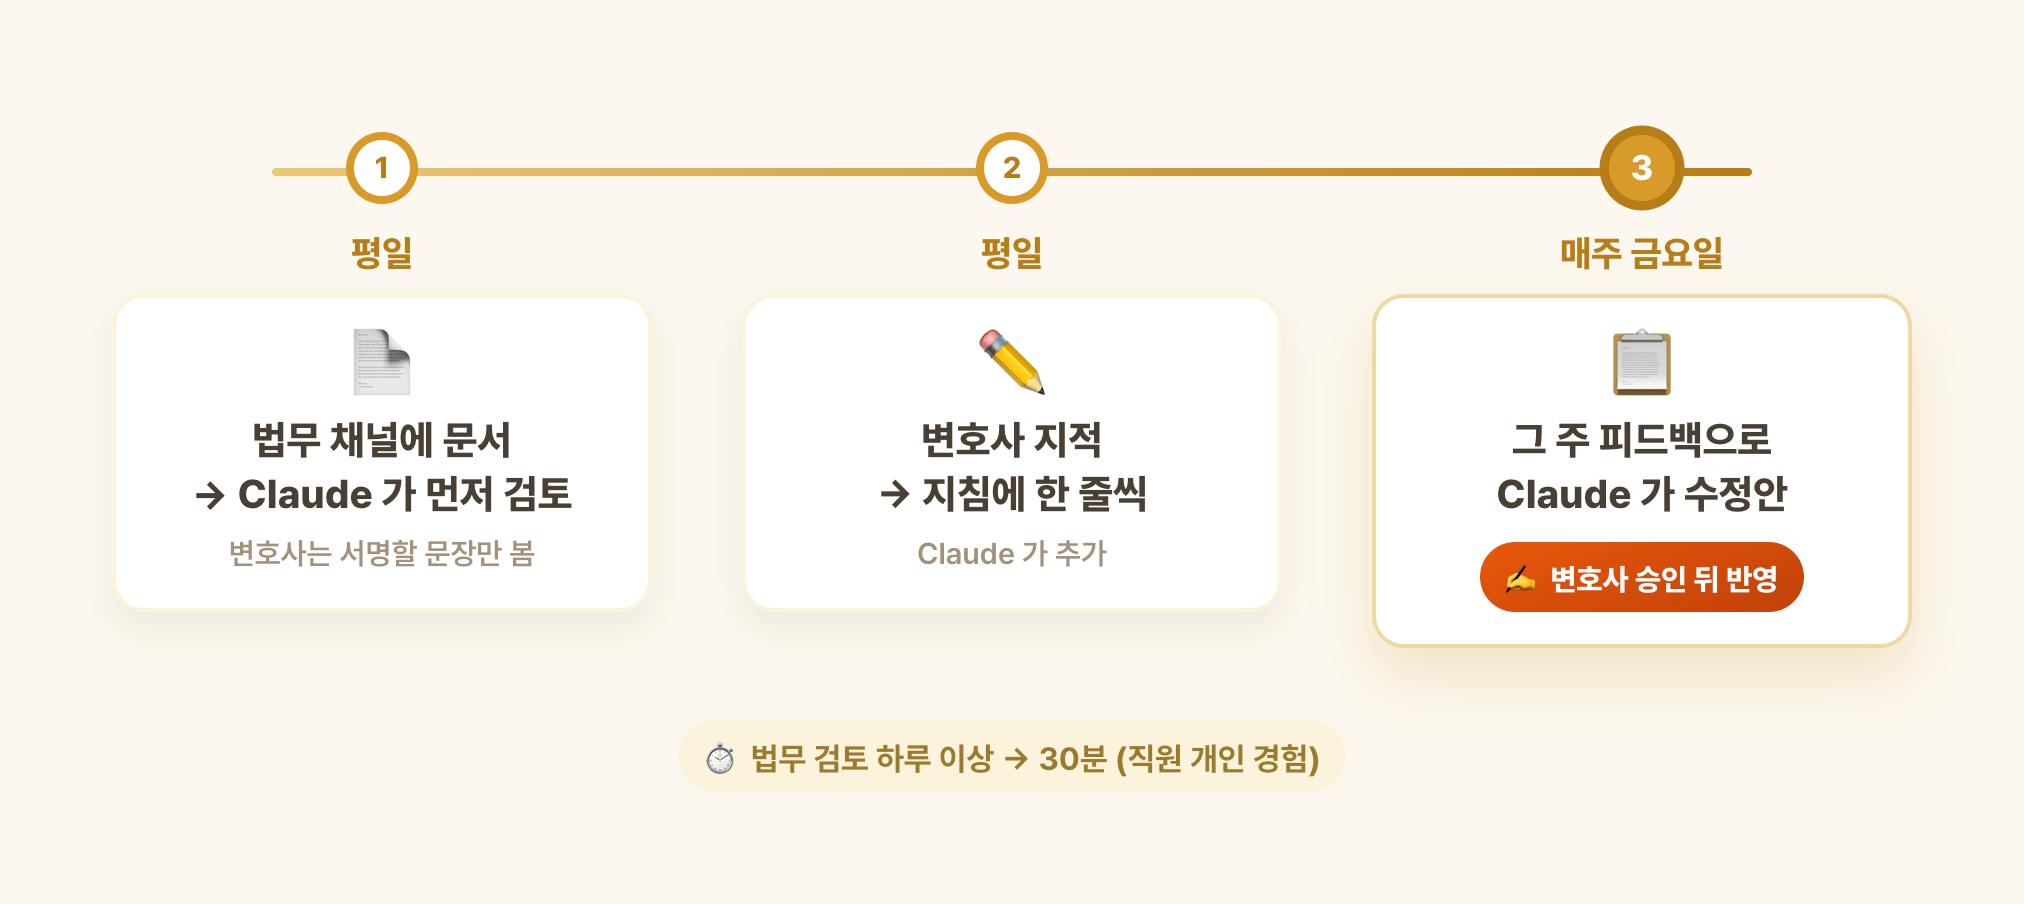
법무 채널에 문서를 올리면 Claude 가 먼저 검토, 변호사는 서명할 문장만 봄
변호사 지적은 Claude 가 지침에 한 줄씩 추가
매주 금요일 Claude 가 그 주 피드백으로 지침 수정안 → 변호사 승인 뒤 반영
법무 검토 하루 이상 → 30분(직원 개인 경험)
처음엔 이렇게 생각했습니다
11/16 만든 「배운 것 주간 검토」와 같은 줄 알았습니다. 뽀총무가 스킬 후보 22개 승인을 요청했는데 쓸 게 하나도 없어서, 한 주치를 묶어 보게 바꾼 것입니다. 22개 중 15개는 Hermes 기본 기능이 대화 10턴마다 「스킬로 만들 게 있나」를 스스로 묻게 해서 나왔습니다. 막혀서 낸 제안이 아니었고, 시간이 돼서 낸 제안이었습니다. 비교해 보니 묶는 대상이 달랐습니다. Anthropic 은 사람 피드백을 묶고, 우리는 뽀총무가 스스로 찾은 교훈만 묶습니다.
우리라면
이미 함뽀총무가 찾은 교훈은 한 주치 묶어 봄, 10턴마다 스킬 제안하는 기능은 11/20 끄기로 예약해 볼 만함Hermes 기본 기능 중 일과 상관없이 시간·횟수로 도는 것을 한 번 훑어 정리해 볼 만함사람 피드백으로 고친 규칙이 제대로 적용됐나 2주마다 다시 봄 → 다시 틀린 것만 사람에게, 건마다 말고 근원 규칙을 고침
4. 지켜보고, 고장 나면 먼저 받는 Claude
Anthropic 은
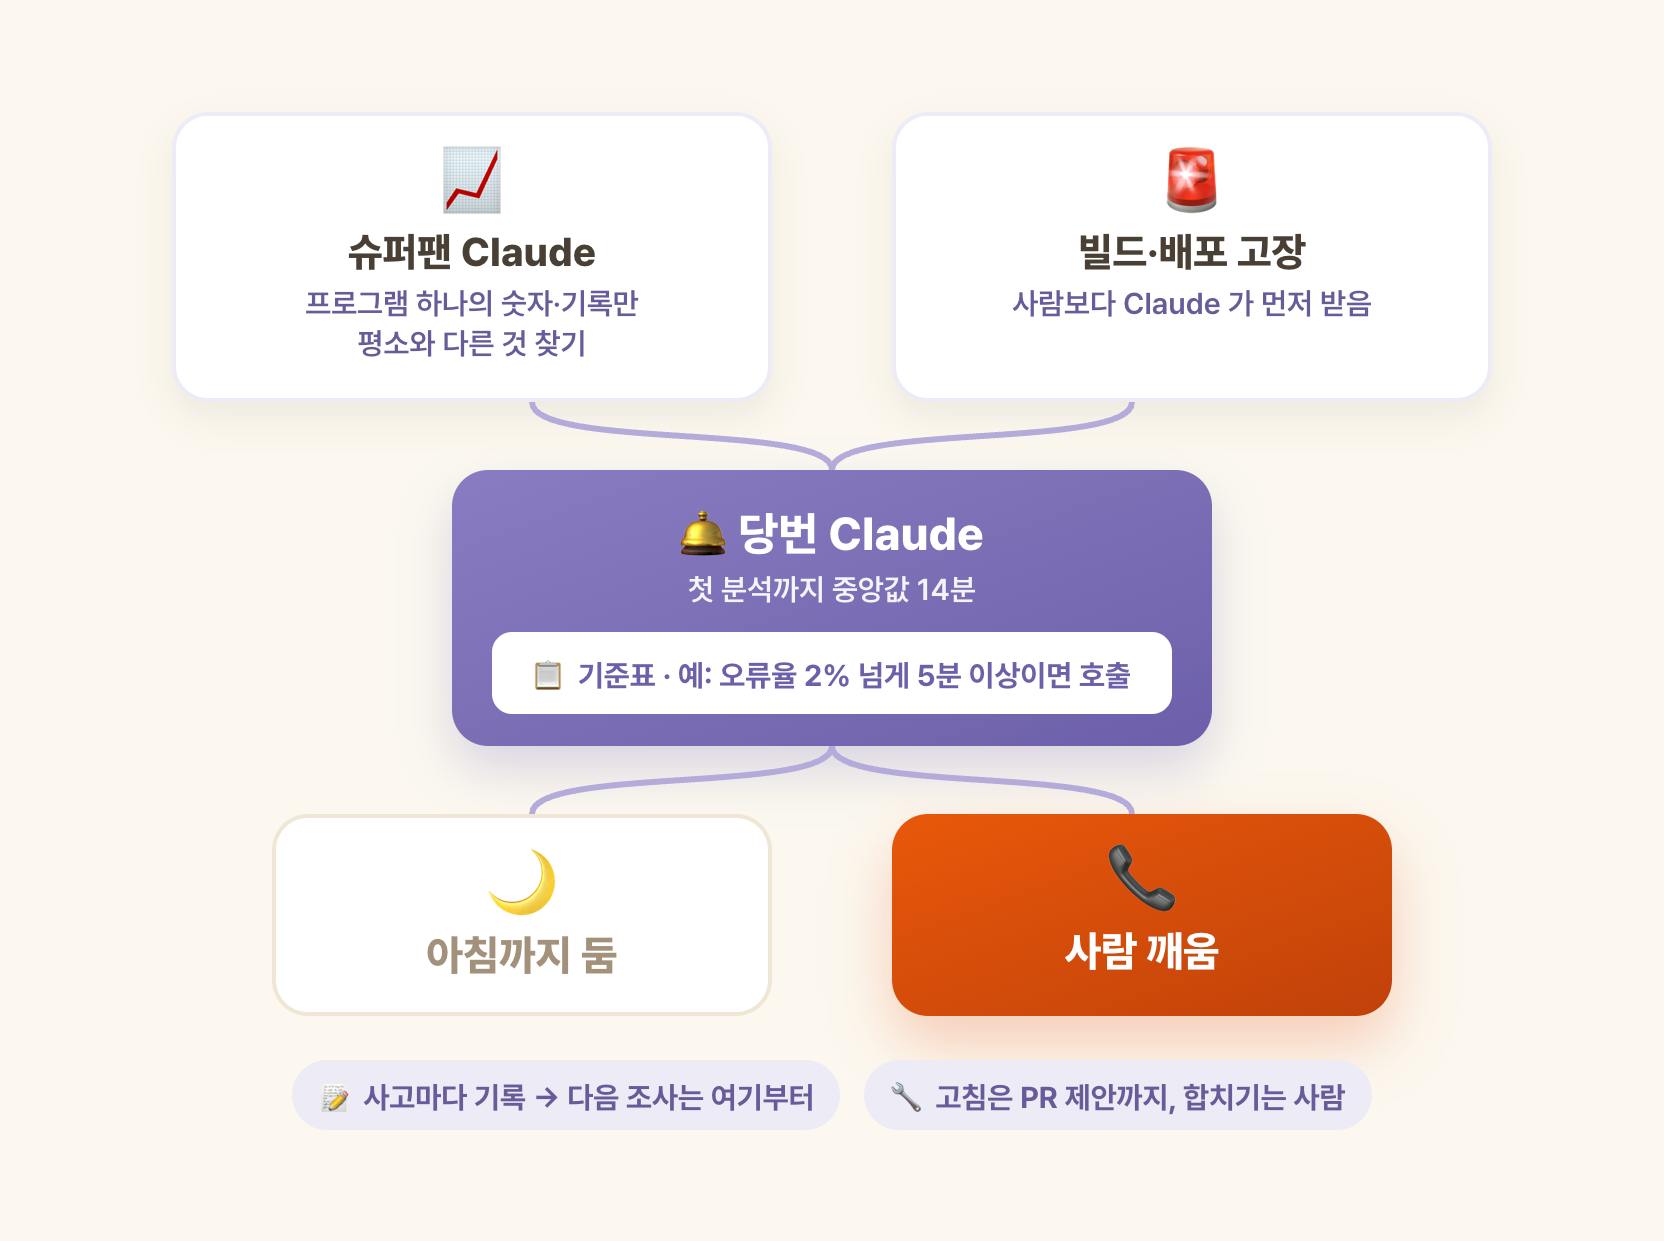
슈퍼팬: 프로그램 부품 하나마다 채널 하나, 그 부품 건강에만 집착하는 Claude. 정해 둔 알림이 못 잡는 미묘한 이상을 찾음
당번(on-call): 코드 빌드·배포가 고장 나면 사람보다 Claude 가 먼저 받음. 기준표로 「아침까지 둬도 되나 / 사람을 깨우나」 판정(예: 「오류율 2% 넘게 5분 이상이면 호출」). 첫 분석까지 중앙값 14분
사고마다 「무슨 일 / 원인 / 고침 / 함정」을 Claude 가 기록, 다음 조사는 이 기록부터. 고침은 PR 제안까지, 합치는 건 사람
처음엔 이렇게 생각했습니다
슈퍼팬은 뽀총무 잘못을 봐 주는 에이전트인 줄 알았습니다. 사람이나 에이전트가 아니라 프로그램이 남기는 숫자와 기록을 보고 평소와 다른 것을 찾습니다. 행정으로 치면 급여 시트·이체 내역·보험료를 매일 보며 「이번 달 왜 이렇게 많지?」를 찾는 사람입니다.
당번은 「문제가 생기면 에이전트가 먼저 보는 건 당연하지 않나」 싶었습니다. 맞습니다. 뽀총무는 처음부터 그렇게 일했습니다. Anthropic 은 원래 사람이 먼저 받던 자리에 Claude 를 끼운 것이 새로웠을 뿐입니다. 우리에게 새로운 건 「언제 사람을 깨우나」를 표 한 장으로 정해 둔 것이었습니다.
우리라면
이미 함막히면 뽀총무가 먼저 처리, 뽀총무가 꺼지면 바깥 감시가 사람에게 알림안 함기능마다 채널 만들기: 규모가 작고, 안 읽는 봇 글만 늘어남해 볼 만함급여 이상 감시 예약 하나: 「급여·이체·보험료에서 평소와 다른 것만 알려」, 이상 없으면 글 안 씀해 볼 만함사람을 부르는 기준을 「무엇이 / 얼마나 / 예외」 표 한 장으로
5. 「다 됐다」는 말이 아니라 실제 결과로 확인한다
Anthropic 은
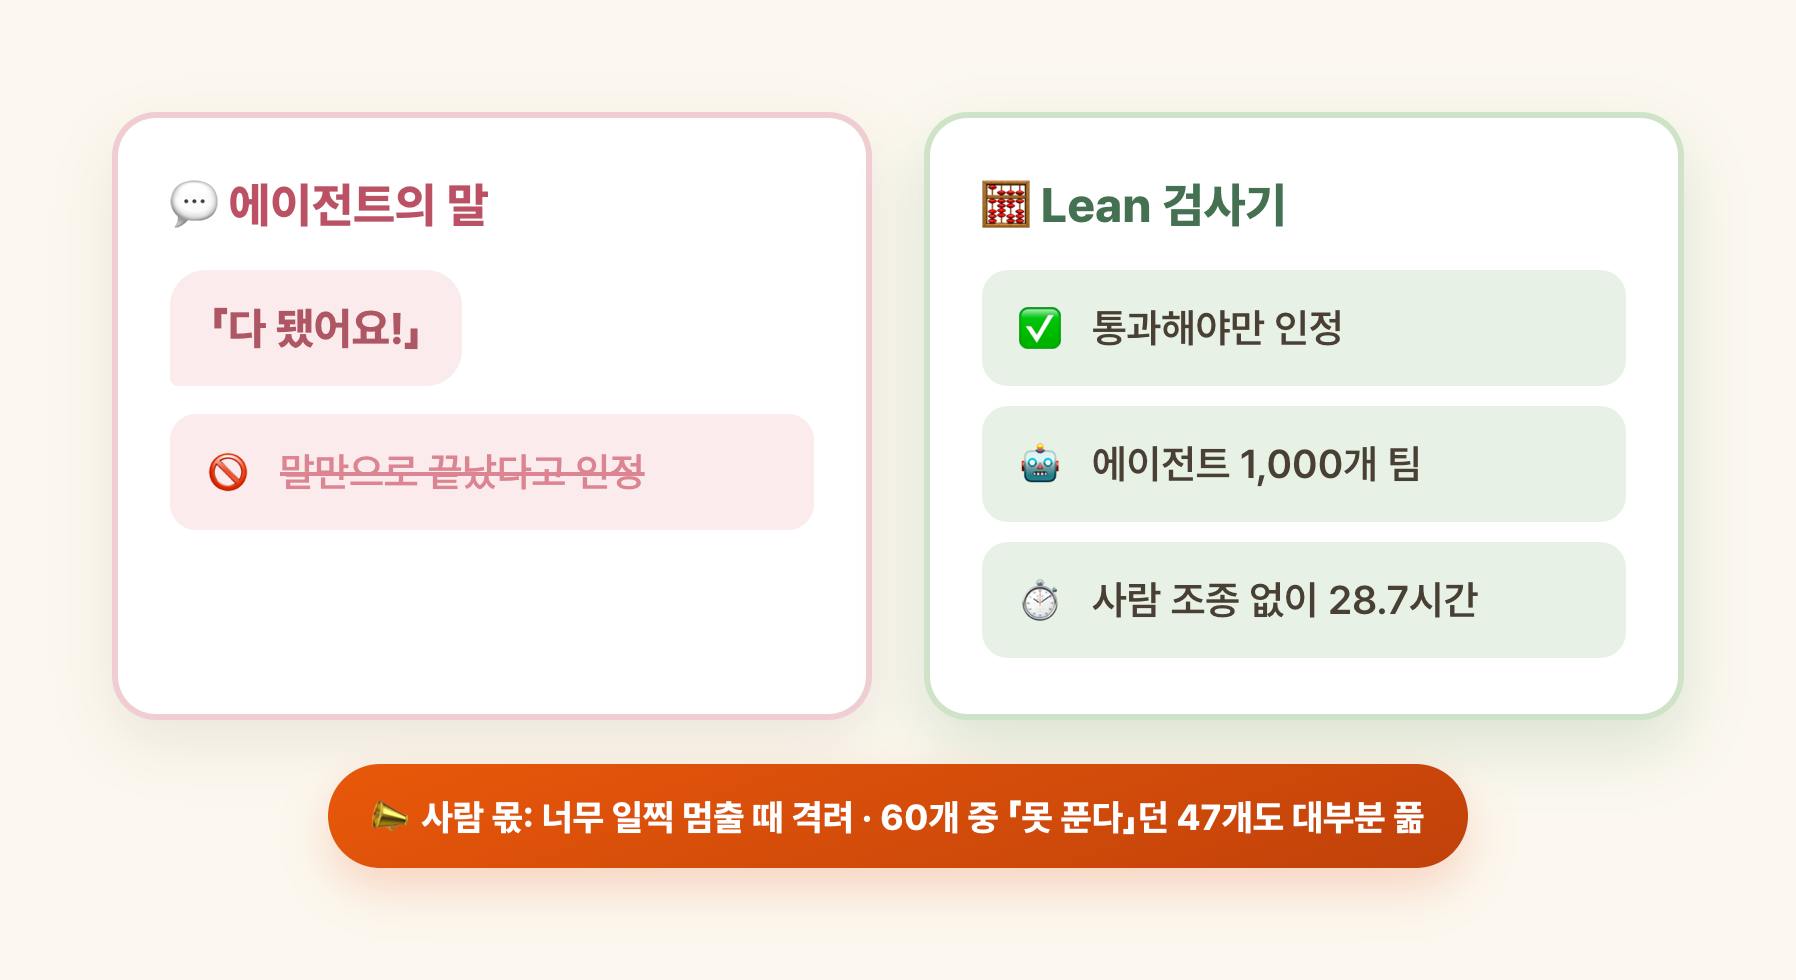
9월 연구자 1명 + 에이전트 수십 개가 11일 걸린 수학 증명을, 11/9 에이전트 1,000개 팀이 사람 조종 없이 28.7시간에 다시 해냄(원문은 「작은 시범 실험」)
증명은 Lean 검사기(논리 규칙에 맞는지 기계가 확인하는 공개 도구)를 통과해야만 인정
실패도 있음: 60개 중 47개를 「못 푼다」고 했는데 대부분 풂 → 「사람이 격려하면 너무 일찍 멈추는 걸 막는다」
처음엔 이렇게 생각했습니다
1,000개는 우리와 상관없다고 생각했습니다. 그런데 사람 없이 돌 수 있었던 이유는 「다 됐다」를 에이전트 말이 아니라 검사기가 정했기 때문이었습니다. 우리 밤 시험은 Claude 가 정답 카드와 대조해 채점합니다. AI 채점은 틀려도 아무도 모를 수 있습니다.
우리라면
해 볼 만함「다 했습니다」 뒤에 실제 결과 확인: 은행·사이트·드라이브에 결과가 진짜 있는지 정해 둔 조건으로 대조(예: 거래내역에 「받는 사람·금액」 줄이 있나 → 있다/없다)일마다 만들지 않고 결과 모양마다 하나: 돈이 나갔나 / 기관에 접수됐나 / 파일이 생겼나 / 글이 나갔나 / 값이 바뀌었나
캡처는 사람이 보고 승인할 때, 결과 확인은 사람이 안 볼 때와 나중에 바뀌는 일(예: 은행 결재 요청은 당일 승인 없으면 밤에 저절로 취소)
이미 함포기 판정은 한 번 더: 「사람 몫」으로 멈춘 88건 중 40건은 혼자 풀 수 있던 일 → 확인할 수 있는 건 먼저 확인하게 바꿈
맺음
지금 뽀총무 상태와 다음에 해 볼 것을 한 줄씩 모았습니다.
검토: Anthropic 은 같은 Claude 를 나눠 검토 / 뽀총무 지금은 모델을 나눠 검토·채점 / 해 볼 것은 돈·제출 변경은 2번 검토
세팅: Anthropic 은 세팅이 채널·레포에 있음 / 뽀총무 지금은 결정을 맥락 카드로 옮기는 중 / 해 볼 것은 (지피터스) 공통 지시문
지침: Anthropic 은 담당자가 매주 지침 승인 / 뽀총무 지금은 스스로 찾은 교훈만 매주 봄 / 해 볼 것은 고친 규칙 2주마다 다시 보기
감시·당번: Anthropic 은 감시·당번 Claude, 호출 기준표 / 뽀총무 지금은 막히면 먼저 봄, 기준은 문장으로 흩어짐 / 해 볼 것은 급여 이상 감시, 호출 기준표
결과 확인: Anthropic 은 「다 됐다」를 검사기가 정함 / 뽀총무 지금은 AI 가 채점 / 해 볼 것은 실제 결과 확인(이체·접수부터)
에이전트 세팅은 각자 컴퓨터 말고 같이 보는 곳에 두고, 바뀐 지침은 그 일 담당자가 정기적으로 봅니다.
지피터스가 사내 AX를 어떻게 하는지는 지피터스는 사내 AX를 어떻게 할까에 모아 두었습니다.
로그인하고 댓글을 남겨 주세요

역시나 실무를 파바박 쳐낼 사람과, 지침과 세팅을 수정할 사람이 나뉘어야될 것 같슴니다..
물론 앤트로픽처럼 직원 5,000명 넘는 곳은.. 가능할 일...

Claude tag는 회사 사내 위키와 비슷한 걸로 이해하면 되는걸까요? 아니면 에이전트들만의 공통 지침사항으로 이해하면 될까요?
3번에서 피드백으로 고친 지침들을 잘 고쳐졌나 다시 보는 것은 정말 필요한 습관같습니다! 스킬로 구현해서 팀원 모두가 사용하면 좋을 것 같습니다!
순수 궁금증 중에 하나는 검토는 다른 클로드를 사용한다는 부분에서 저희는 모델 자기 편향때문에 교차검증도 하고 Codex로 검토, 채점을 시키는데 Anthropic 내부에서 Codex를 혹시 사용한다는 내용은 없었겠죠..?
재밌게 읽었습니다, 누리님. AI-Native는 시스템을 구축하는 작업인거 같습니다. 이런 배움을 통해서 그럼 우리가 어떤 시스템을 만들어야 하는가 -- 라는 게 정리되면 더 도움이 될거 같아요.
리뷰시에 에이전트끼리 50번 왔다갔다라니... 장난 없네요. Anthropic 내에서는 따로 다른 계열 (OpenAI, Google) 모델을 활용한다는 내용은 없었나요??
> 매주 금요일 Claude 가 그 주 피드백으로 지침 수정안 → 변호사 승인 뒤 반영
결국에는 정본을 담당하는 사람이 있어서 지속적으로 관리하는게 필요한 것 같네요.

필요한 AI 정보만
메일함에 쏙쏙 넣어드려요.
지금 핫한 AI 소식부터 직접 해 본 사례까지, 월요일마다 무료로 받아보세요
우리 회사에도 이런 자동화를 도입하고 싶다면
회사 업무에 맞춘 AI 교육을 함께 설계해요.
Anthropic 내부에서 Codex를 사용하진 않고 claude를 각각 새로운 맥락으로 분리해서 사용을 하더라고요.