


멀쩡한 걸 틀렸다고 잡는 검사기는, 아무도 안 써요 — AI 요약에 '봐주는 선'을 그은 하루
뽀짝이가 줌 녹화를 듣고 회차 요약 뉴스레터를 만들어요. 그런데 가끔 원문에 없는 걸 슬쩍 지어냅니다. "이 요약 잘 나왔나?"를 매번 눈대중으로 넘기던 걸, 자동 검사기로 바꿔본 하루예요.
먼저 결론부터 말할게요. AI 검사기에서 제일 위험한 건 틀린 걸 놓치는 게 아니라, 멀쩡한 걸 틀렸다고 잡는 것이었어요. "어디까지는 봐준다"는 선을 어디에 긋느냐가 검사기의 생사를 갈랐거든요.
이번 실습은 로나(Rona)가 제 실제 업무(뽀짝이 훔쳐보기)에 맞춰 만들어준 8단계 AI Eval 코칭을 따라가며 진행했어요. "감으로 넘기던 자리"에 진짜 평가를 붙이는 길잡이 역할을 해줬습니다.
문제 — 감으로 넘기던 자리
뽀짝이의 "훔쳐보기"는 스터디·AI토크 줌 녹화를 1인칭 뉴스레터로 요약해서 LMS 다시보기 탭에 올리는 파이프라인이에요. 문제는, AI가 자신감 있게 틀린다는 거였어요. 모른다고 안 하고 그럴듯하게 지어내거든요.
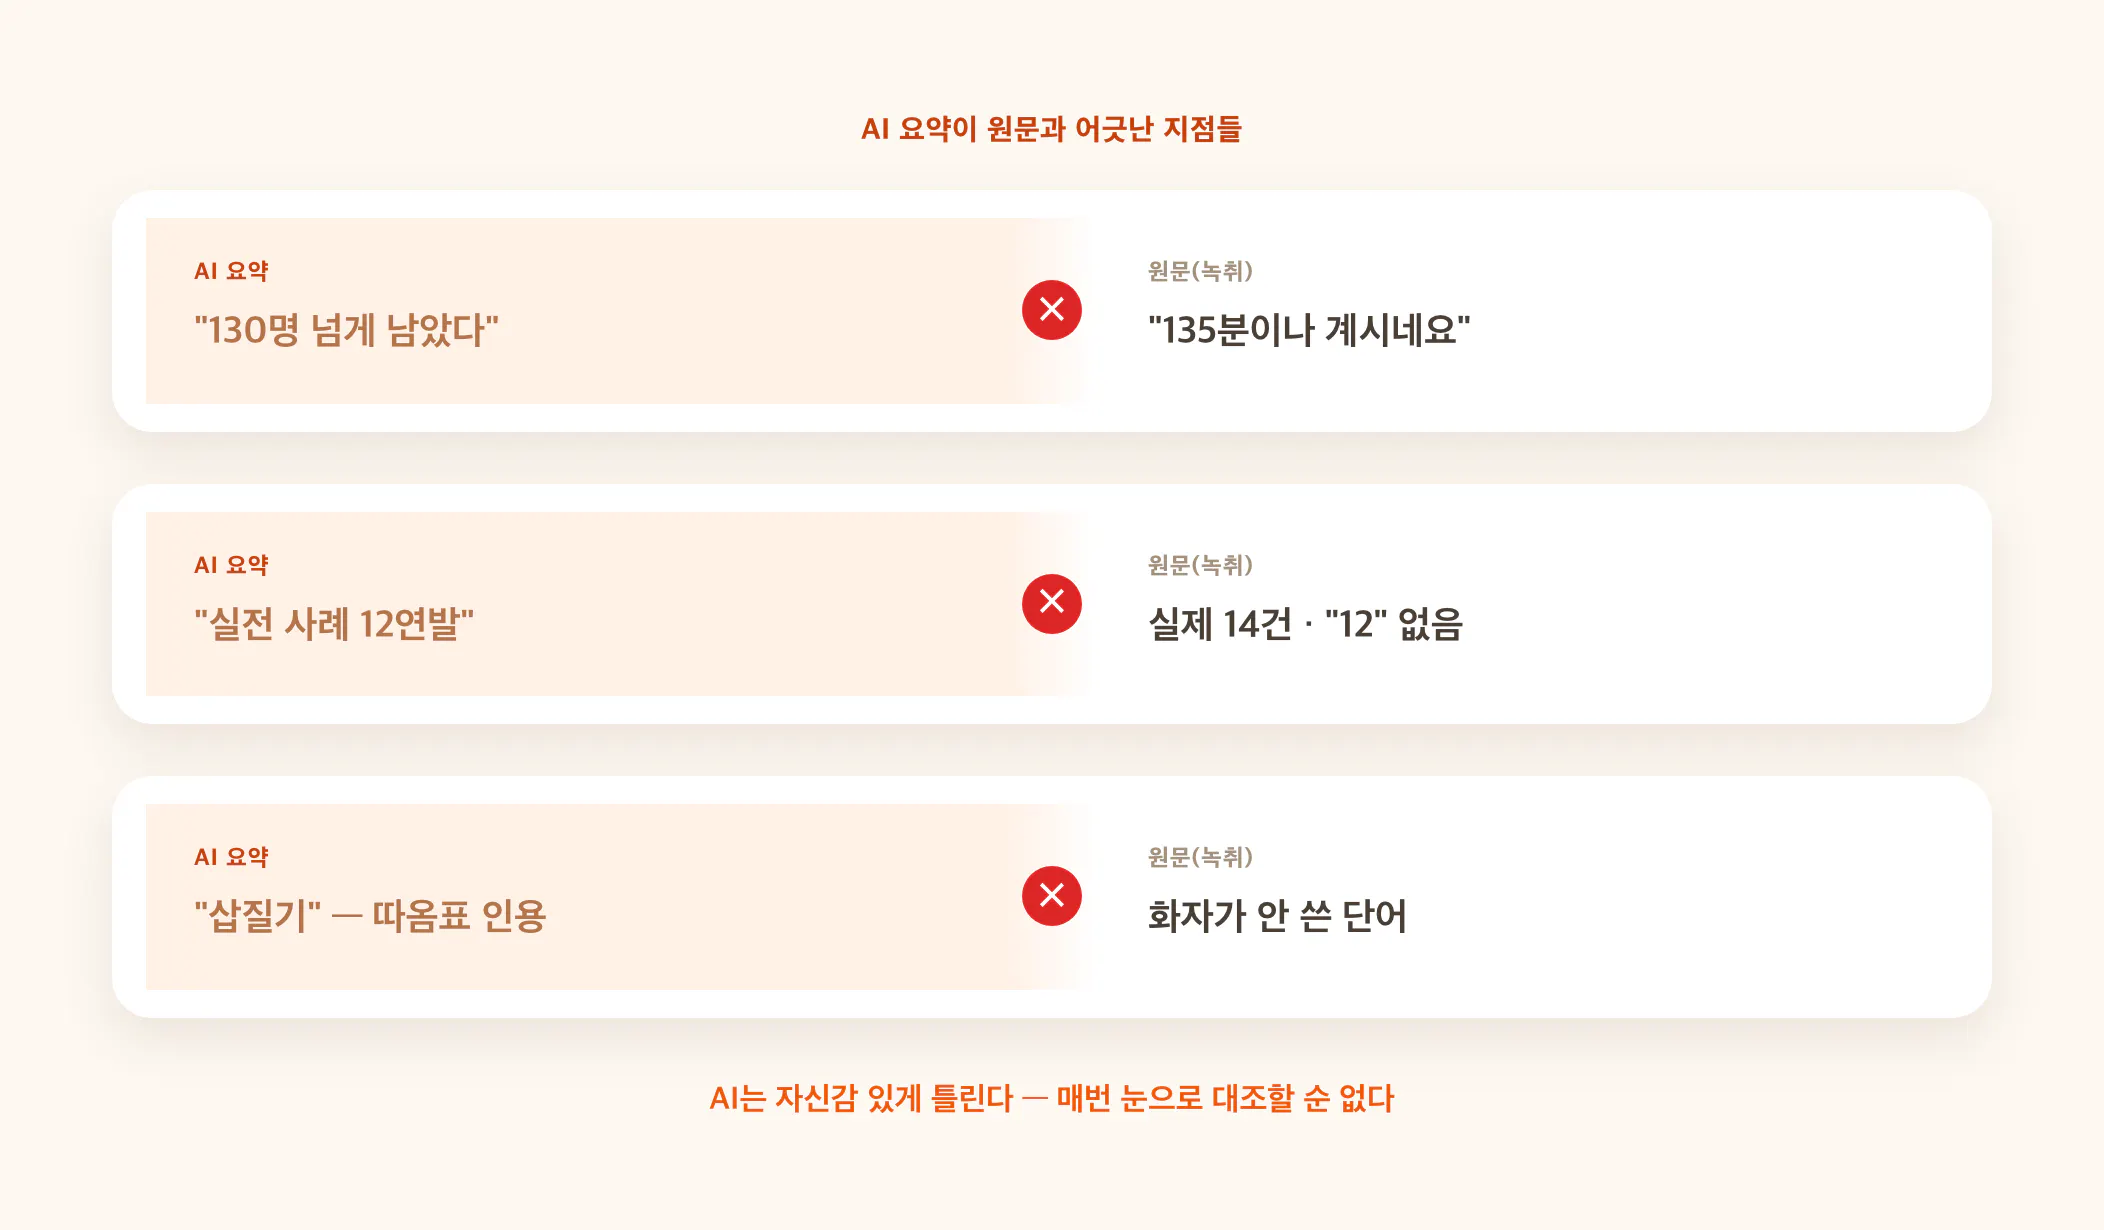
실제로 발행된 요약에서 이런 게 나왔어요.
- "공식 일정 끝나고 130명 넘게 남았다" — 원문엔 "135분이나 계시네요"라고 돼 있었어요.
- "실전 사례 12연발" — 실제로는 14건이었고, 원문에 "12"라는 숫자는 없었어요.
- 화자가 쓰지도 않은 단어("삽질기")를 큰따옴표로 인용해버렸고요.
- 어떤 회차에선 원문 어디에도 없는 문장을 발표자가 실제로 말한 것처럼 따옴표로 붙여놨어요.
이런 걸 매번 눈으로 원문이랑 대조하기엔, 3~4시간짜리 녹화가 회차마다 쌓여요. 그래서 "이 요약 믿어도 되나?"가 늘 감으로 판정되던 자리였습니다.
시도 — 로나 코칭 따라 평가를 붙이기
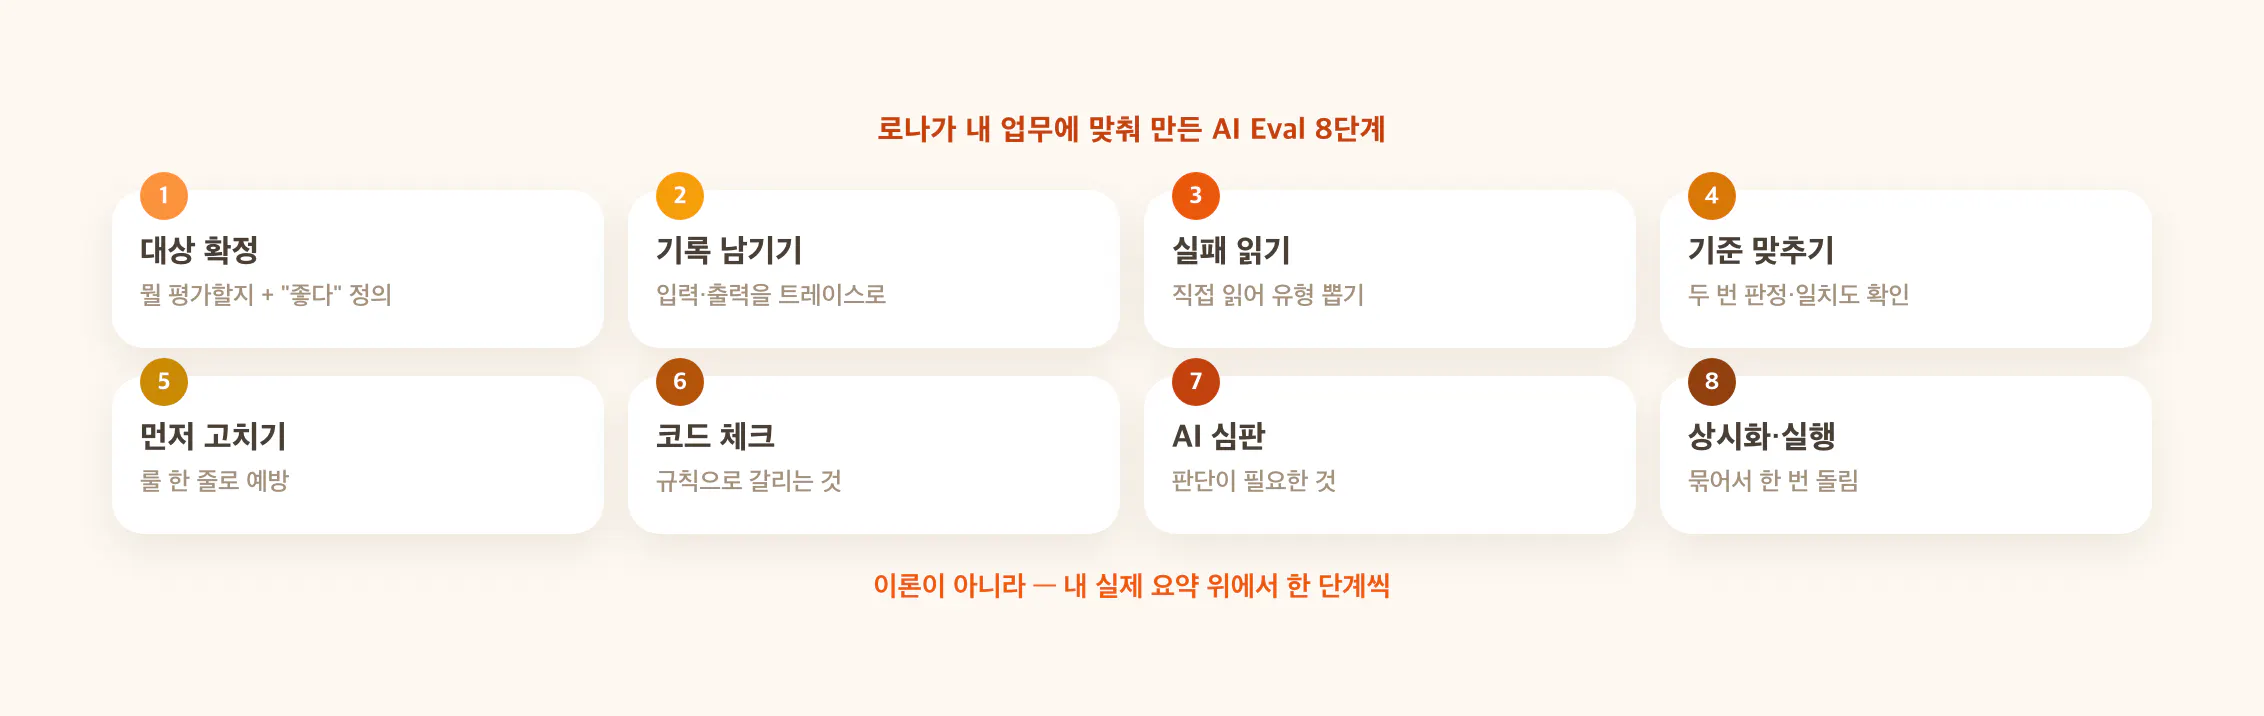
AI 품질을 감이 아니라 매번 같은 방식으로 잴 수 있게 만드는 게 AI Eval이에요. 마침 로나가 제 훔쳐보기 업무에 맞춰 만든 8단계 코칭이 있어서 그대로 따라갔어요. 재료는 이미 손에 있었고요.
- 이미 발행된 훔쳐보기 요약 17건 — 이게 검사 대상이 됐어요.
- 그 옆에 쌓여 있던 검증기록 243건 — 사람이 원문이랑 대조하며 잡아둔 실패 후보들이었죠.
코칭이 시킨 순서는 이랬어요. 실패를 사람이 직접 읽고 → 유형을 뽑고 → 기준을 맞추고 → 코드로 잴 것과 AI가 판단할 것을 나누기. 이론을 강의로 배우는 게 아니라, 제 실제 요약 위에서 한 단계씩 밟아가는 구조라 좋았어요.
삽질 — 검사기가 너무 고지식했어요
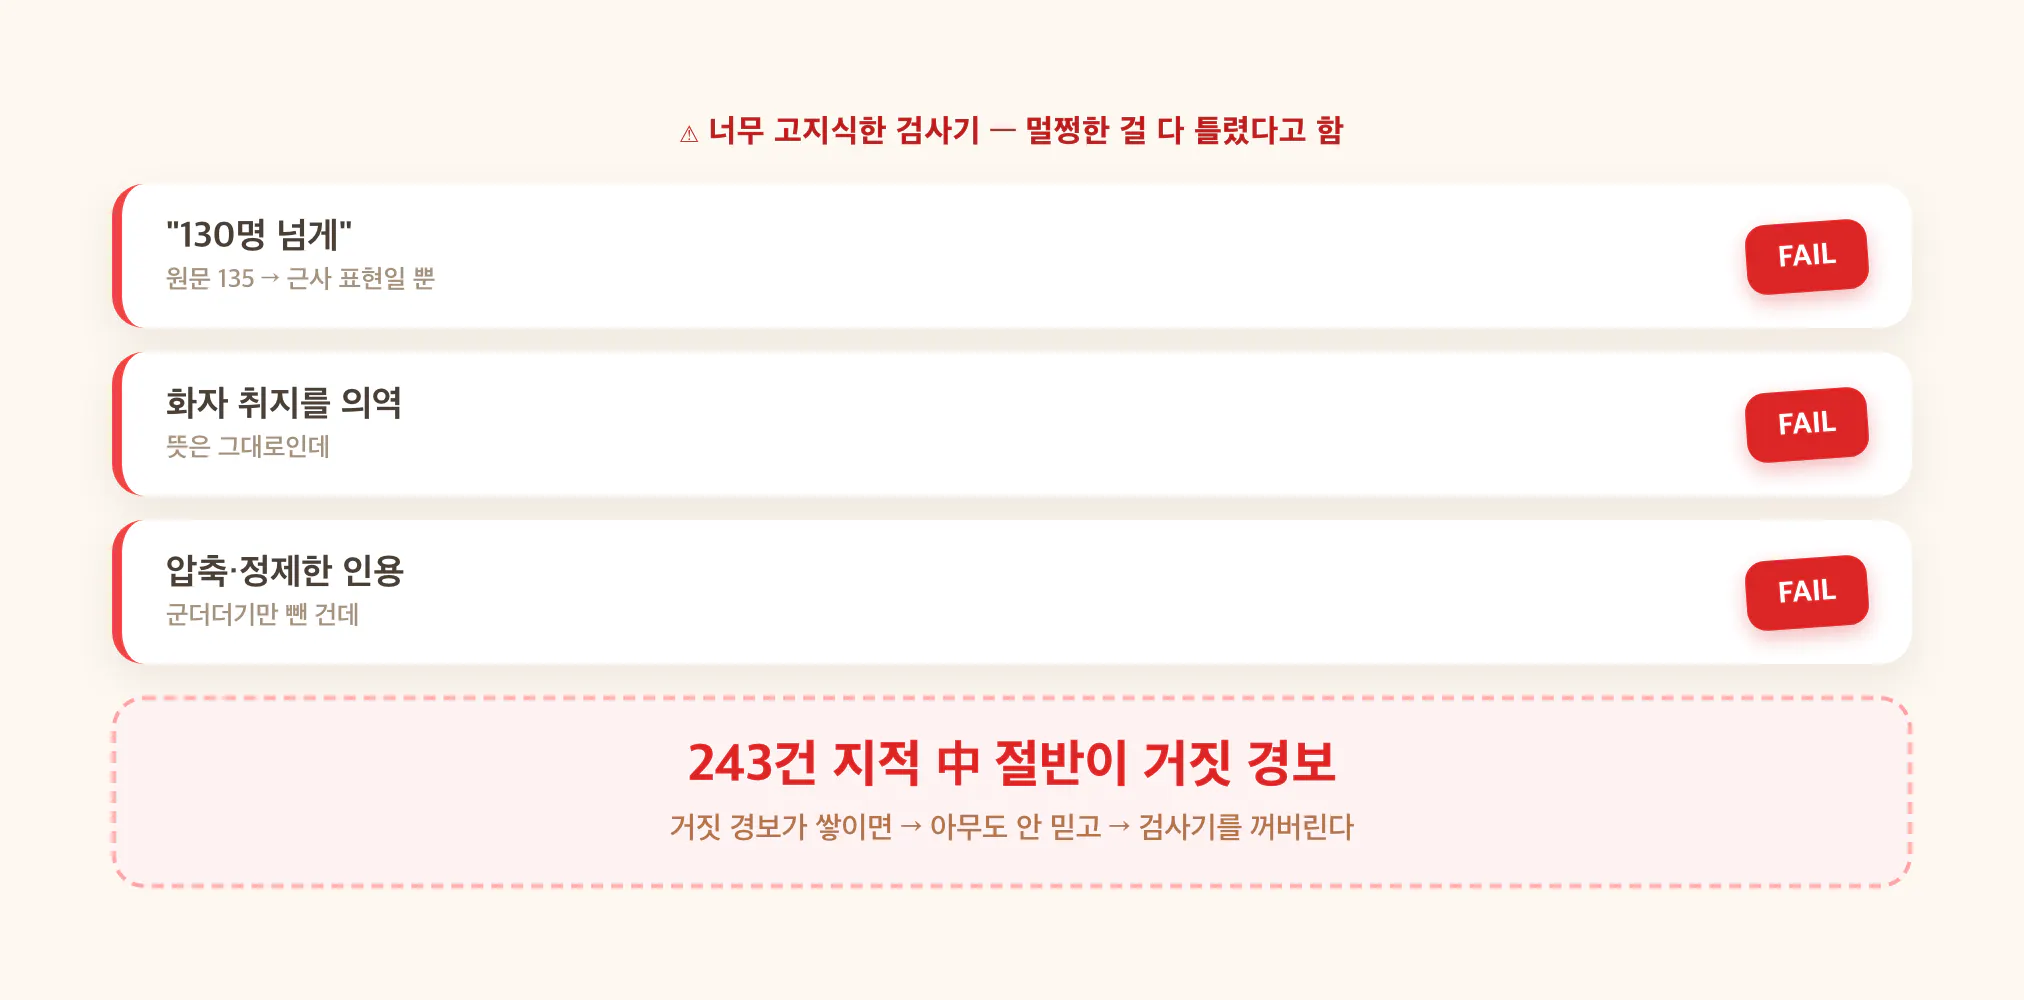
첫 채점 기준을 세우자마자 문제가 터졌어요. 검사기가 멀쩡한 걸 자꾸 틀렸다고 하는 거예요.
- "130명 넘게"(원문은 135) → 검사기는 Fail
- 화자 취지를 자연스럽게 의역한 것 → Fail
- 군더더기만 뺀 압축 인용 → Fail
알고 보니 검증기록 243건 중 절반이 이런 "확인이 필요해요" 수준이지, 실제 실패가 아니었어요. 여기가 진짜 갈림길이었어요. 검사기가 멀쩡한 걸 자꾸 틀렸다고 하면, 거짓 경보가 쌓이다가 결국 아무도 안 믿고 꺼버리거든요. 틀린 걸 놓치는 것보다 이게 더 위험해요. "어디까지는 봐준다"의 선을 어디 긋느냐가 검사기를 살리기도, 죽이기도 하는 거였죠.
전환점 — 사람이 사례로 기준을 깎았어요
여기서 제가(집사가) 사례를 하나씩 던지면서 기준을 바로잡았어요.
- "135명이면 130명 이상 정도로 쓸 수 있는 거 아니야?" → 근사·범위 표현은 팩트가 틀린 게 아니니까 Pass예요.
- "실패한 사례도 배움이라는 걸 '삽질기'라고 쓸 수 있잖아" → 취지를 살린 의역이면 표현을 바꿔도 Pass고요.
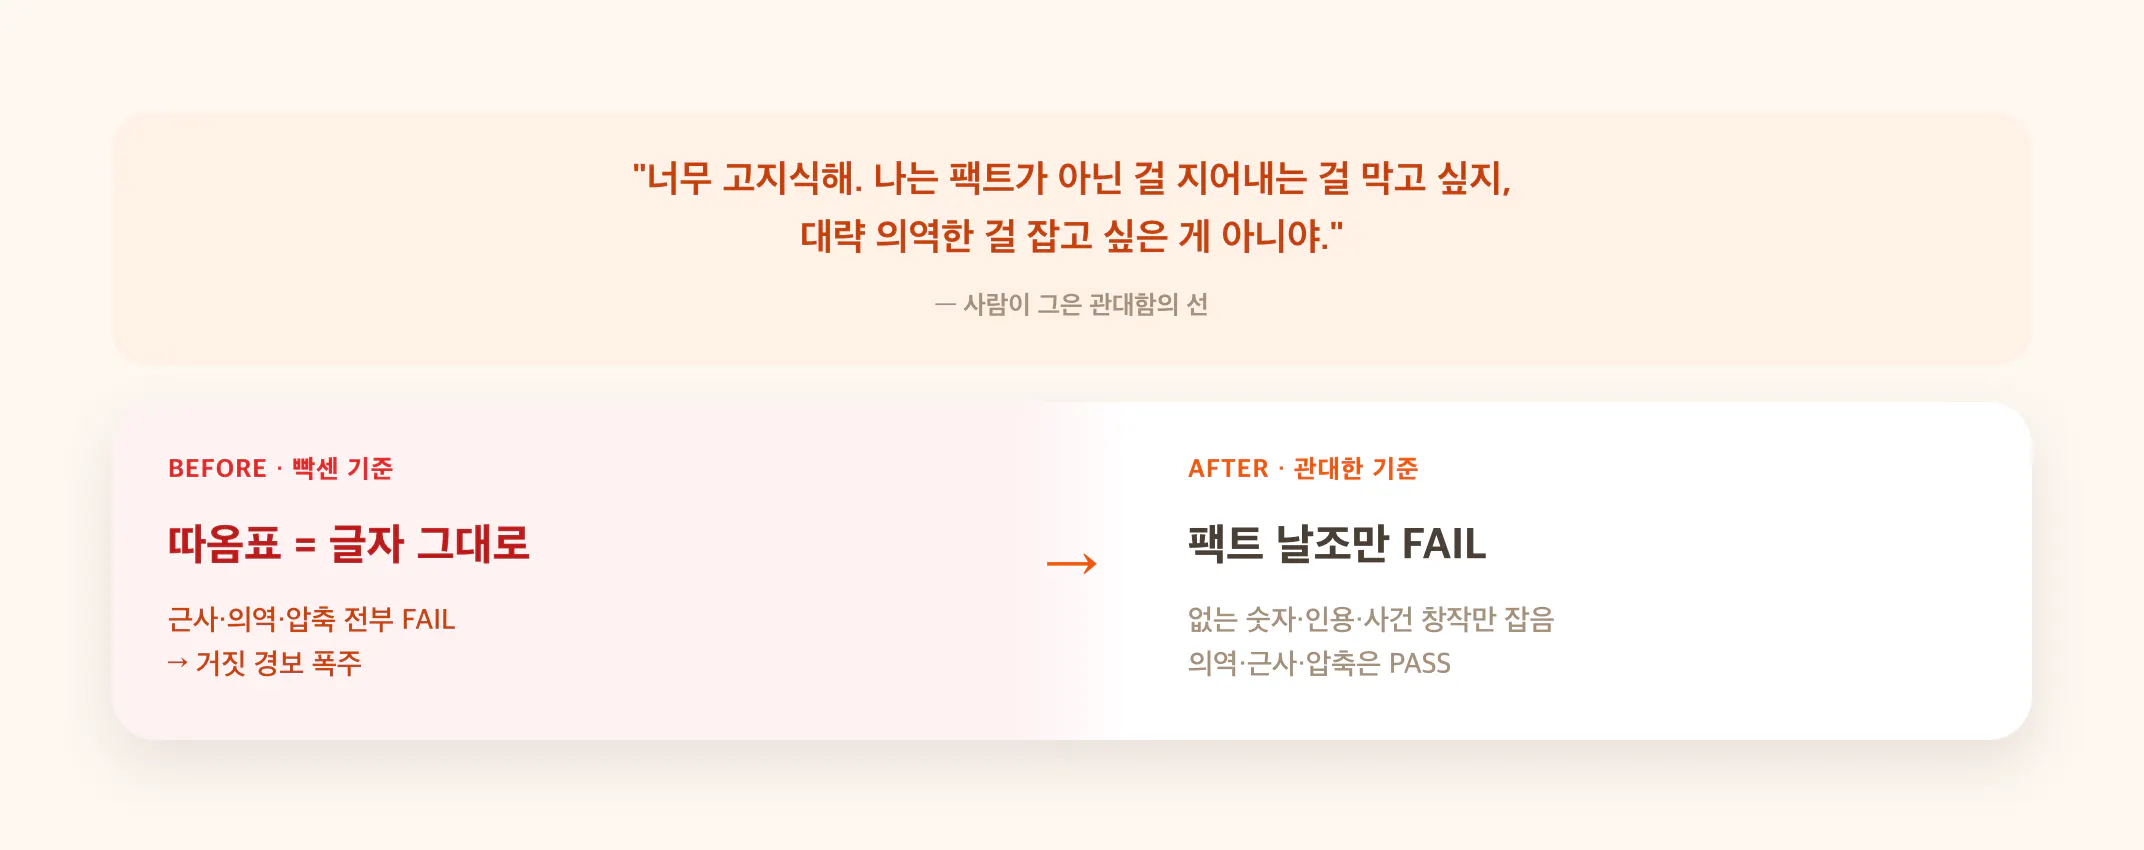
- "너무 고지식해. 나는 팩트가 아닌 걸 지어내는 걸 막고 싶지, 대략 의역한 걸 잡고 싶은 게 아니야."
이 한마디가 채점 기준을 통째로 다시 세웠어요.
팩트를 지어내면 Fail. 상황을 의역한 건 Pass.
없는 숫자·인용·사건을 창작하면 Fail, 표현만 바꾼 의역·근사·압축은 전부 Pass. 이 렌즈로 다시 보니, 243건 지적 중 진짜 팩트 날조는 26건(10%)뿐이었어요.
검증 — 기준이 단단해지니 일치도가 뛰었어요
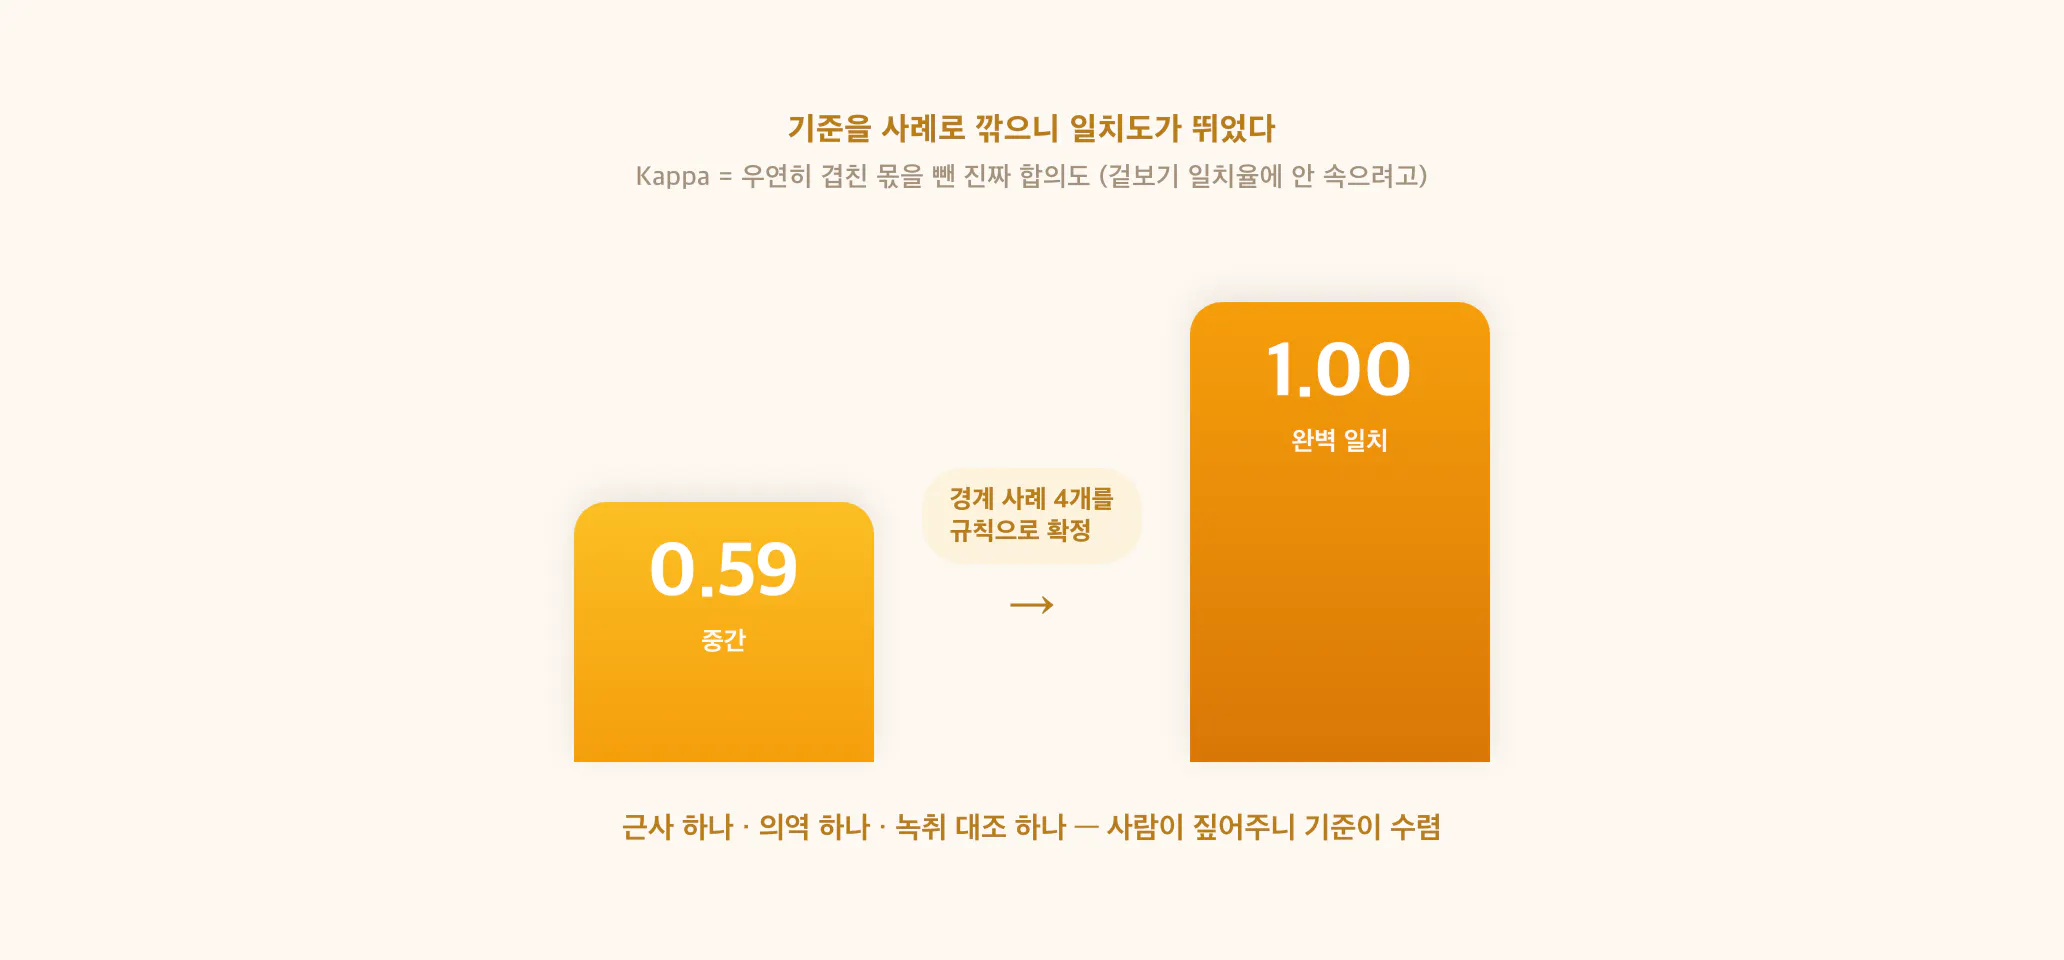
같은 사례를 두 번 판정해서 기준이 흔들리는지 재봤어요. 이때 쓴 게 Kappa인데, "우연히 겹친 몫을 뺀 진짜 합의도"예요. 겉보기 일치율에 속지 않으려고 쓰는 지표죠.
- 처음엔 κ = 0.59 — 겉보기 일치율은 78.6%로 높아 보였지만, 우연 몫을 빼면 중간 정도였어요.
- 사례로 규칙 4개를 확정한 뒤엔 κ = 1.00으로 뛰었고요.
이 규칙 4개 중 하나도 제가 잡아준 거였어요. 검증 담당이 "사례글에 없음 → 확인 불가"라고 넘긴 수치("약 15배")를 두고, "녹취 원문까지 대조하는 거면 그것도 봐야지"라고 짚었거든요. 실제로 녹취 원문엔 "약 십오 배"가 또렷이 있었어요. → 그래서 대조 기준은 사례글이 아니라 녹취 원문이라는 원칙이 여기서 나왔습니다.
결말 — 검사기 완성, 그리고 일부러 틀린 걸 넣어 확인
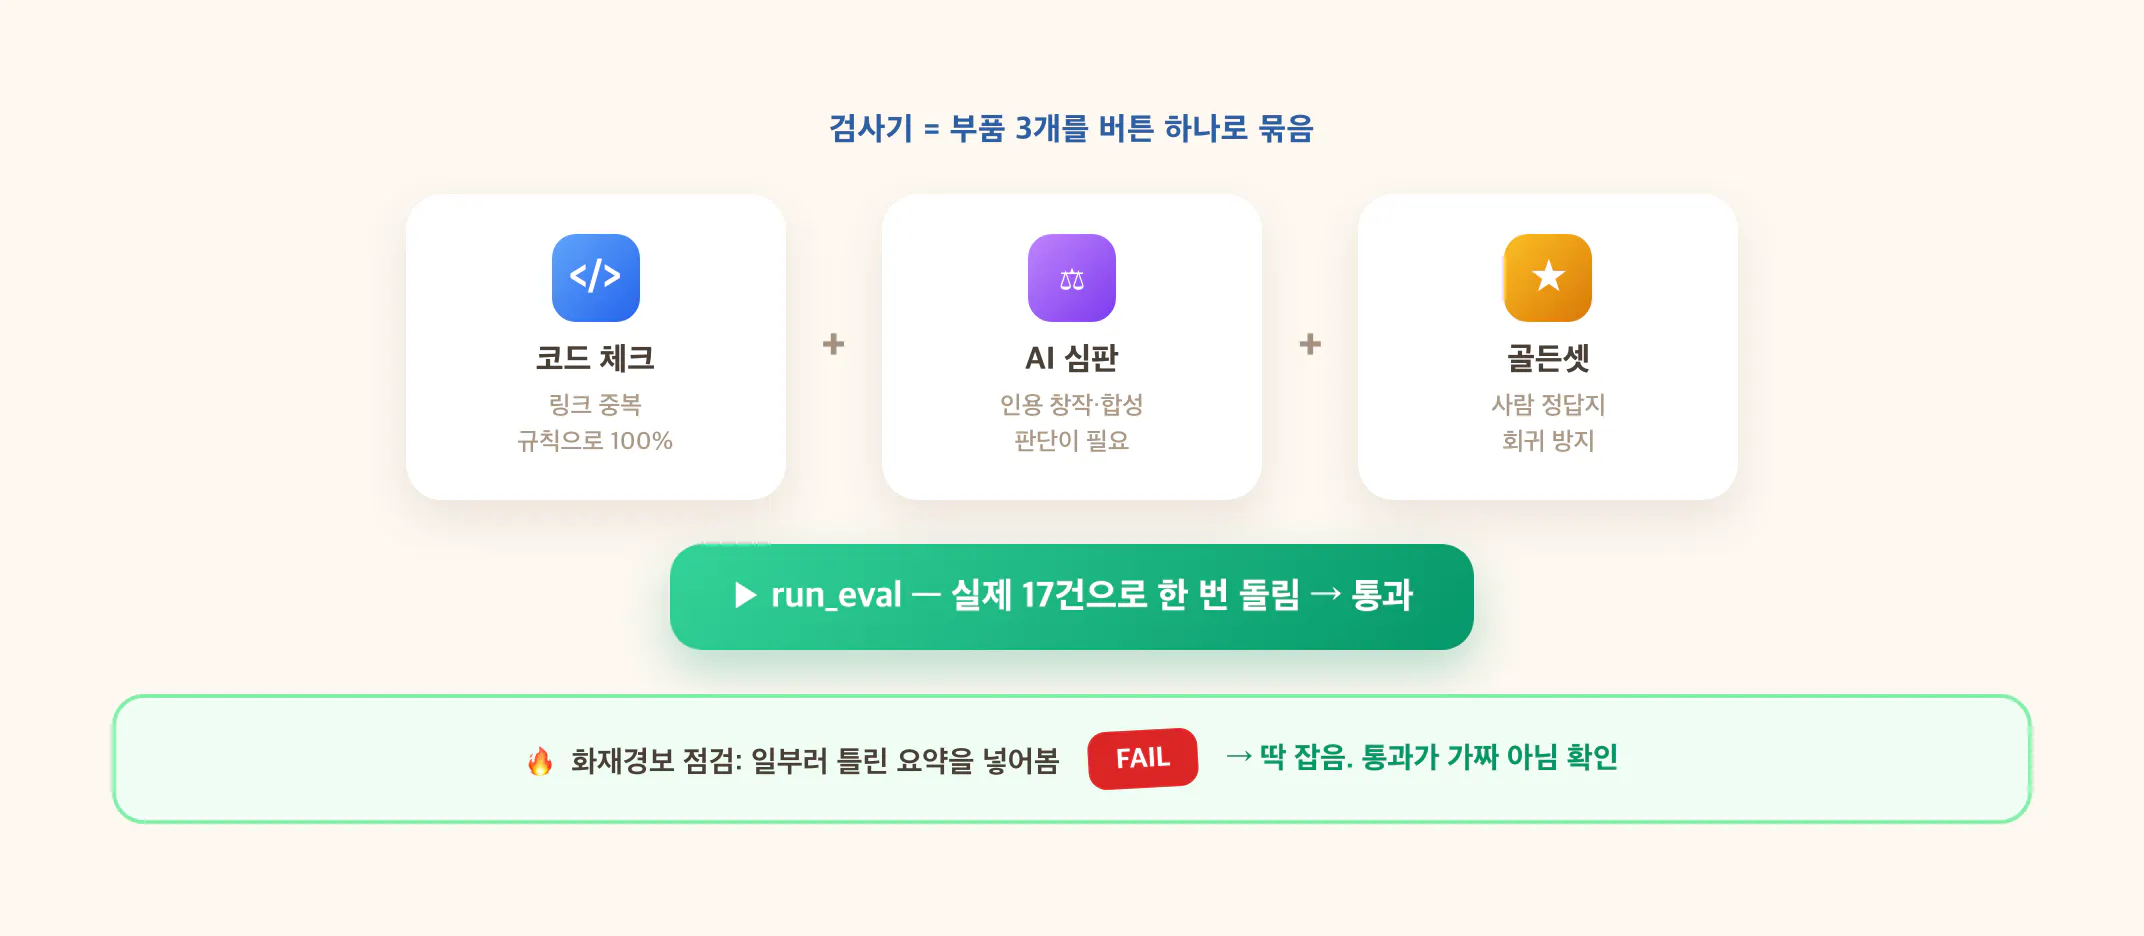
이제 검사기를 부품별로 나눠 만들었어요.
- 코드 체크 — 링크 중복처럼 규칙으로 100% 갈리는 것만 맡겼어요. (인용 대조는 거짓 경보가 심해서 뺐고요.)
- AI 심판 — 인용을 지어냈는지처럼 판단이 필요한 것만, 그것도 실패 하나당 심판 하나로.
- 골든셋(정답지) — 이 셋을 재실행 버튼 하나로 묶어서 실제 17건으로 한 번 돌렸더니 통과했어요.
그리고 화재경보기 점검하듯, 일부러 틀린 요약(링크 중복)을 하나 넣어봤어요. 검사기가 딱 Fail로 잡더라고요. 아까 그 "통과"가 가짜가 아니라는 확인이었죠.
덤으로, 이 과정에서 발견한 두 가지는 훔쳐보기 스킬 자체에 바로 반영했어요. 하나는 이름·경로·직책 같은 고유명사는 원문 표기 그대로 옮기게 한 것(생성 중에 바뀌던 오타 예방), 다른 하나는 검증할 때 녹취 원문을 1차로 대조하게 한 것(사례글에 없다고 성급하게 오류로 몰던 걸 막음)이에요.
진짜 배움 — 봐주는 선은 사람이 긋는다
검사기를 만든 것보다 값진 배움은 이거였어요.
AI 검사기의 성패는 "틀린 걸 얼마나 잡느냐"가 아니라, "멀쩡한 걸 얼마나 봐주느냐"에서 갈린다.
빡센 검사기는 만들기 쉬워요. 다 틀렸다고 하면 되니까요. 근데 그건 거짓 경보만 쏟아내다 버려집니다. 진짜 어려운 건 "이 정도는 봐줘도 된다"의 선을 긋는 거예요. 그리고 그 선은 AI가 못 정해요. 근사 수치 하나, 의역 인용 하나, 녹취 대조 하나 — 실제 경계 사례를 사람이 하나씩 짚어주니까 비로소 기준이 수렴했어요(κ 0.59→1.00).
그래서 "우리 자동화에도 검사 붙여야지" 할 때는 이 순서를 추천해요. 먼저 실패를 직접 읽어서 뭐가 진짜 문제고 뭐가 봐줄 만한지 가르고(감이 아니라 실제 사례로요), 지어낸 것만 잡고 표현 바꾼 건 봐주도록 봐주는 선을 명확히 그은 다음, 규칙으로 갈리는 건 코드로 판단이 필요한 건 AI 심판으로 나누는 거예요.
로나 코칭이 이 순서를 강제로 밟게 해준 게 컸어요. 혼자 했으면 "AI가 알아서 좋은 요약 골라줘" 하고 판단을 통째로 검사기한테 넘겼을 텐데요. 결국 값을 만든 판단은 전부 사람 몫이더라고요.
