


한 줄 요약
한글 문서인 .hwp, .hwpx를 Markdown으로 변환할 때 픽셀 단위 화면 재현이 아니라 제목, 문단, 표, 이미지, 수식, 각주, 메타데이터 같은 의미 구조를 보존하는 방향으로 CLI/라이브러리 설계를 정리하고, 실제 변환 품질을 높이기 위한 회귀 테스트와 보완 작업까지 진행했습니다.
이런 분들께 도움돼요
한글 문서를 Markdown, Obsidian, Git 기반 문서로 옮기고 싶은 분
HWP/HWPX 변환을 단순 텍스트 추출이 아니라 편집 가능한 문서 구조로 다루고 싶은 분
AI와 함께 복잡한 문서 변환 도구의 설계 기준, 테스트 전략, 단계별 개발 계획을 잡고 싶은 분
"일단 변환은 되는데 표, 이미지, 수식, 각주가 망가지는" 문제를 겪어본 분
시작점: HWP를 Markdown으로 바꾸는 일은 생각보다 복잡했다
처음 목표는 단순했습니다.
.hwp 또는 .hwpx 문서를 넣으면 사람이 다시 읽고 편집하기 좋은 Markdown 문서와 첨부 자산 폴더가 나오는 도구를 만들고 싶었습니다.
하지만 실제로 들여다보니 이건 단순한 "파일 포맷 변환" 문제가 아니었습니다.
한글 문서에는 표, 병합 셀, 보도자료 상단 장식 표, 각주, 수식, 이미지, 캡션, 머리말/꼬리말, 도형 텍스트, HWP 고유 control 문자 같은 요소가 섞여 있습니다. 이것을 Markdown으로 옮길 때 화면 모양만 따라가면 결과물이 너무 지저분해지고, 반대로 텍스트만 뽑으면 문서의 의미가 많이 사라집니다.
그래서 기준을 먼저 정했습니다.
Markdown 변환의 목표는 한컴 화면을 픽셀 단위로 재현하는 것이 아니라, 사람이 다시 읽고 고칠 수 있는 의미 구조를 보존하는 것입니다.
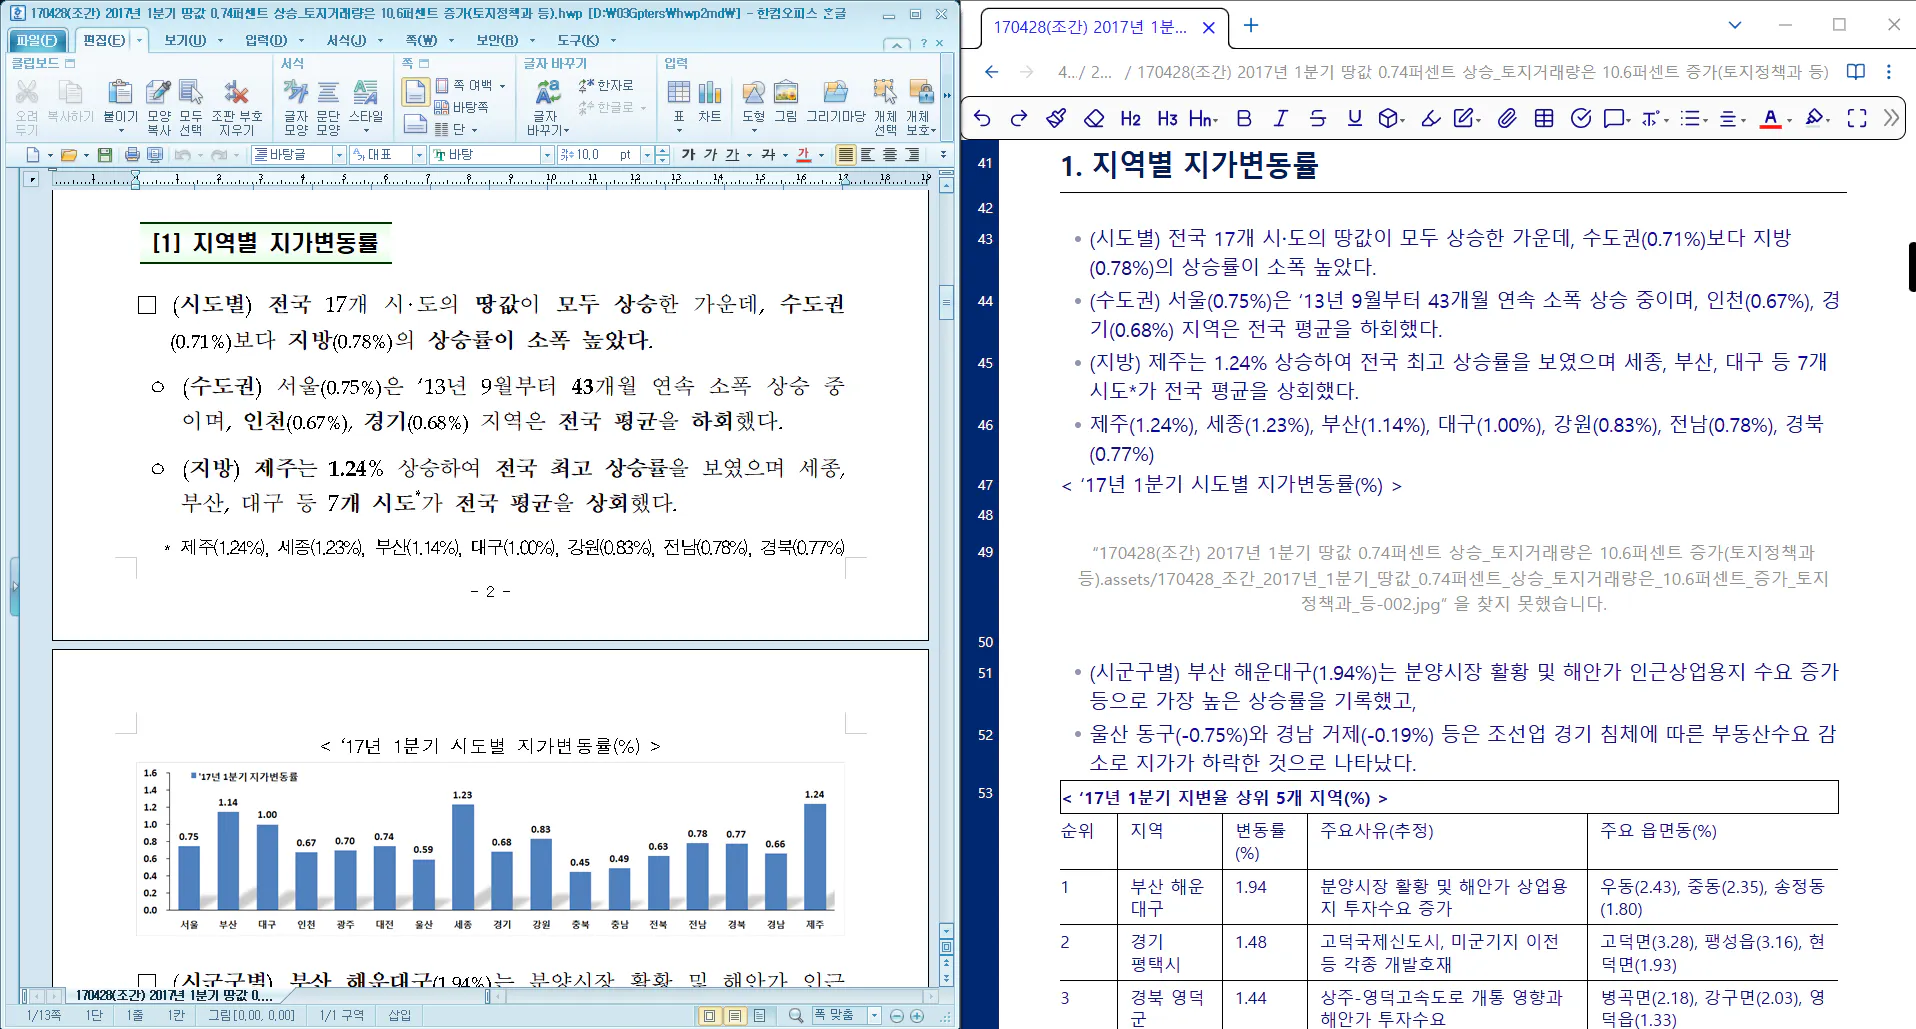
한국어와 영어 텍스트가 포함된 컴퓨터 화면의 스크린샷
"목표는 화면 복제가 아니라 다시 편집할 수 있는 Markdown 구조입니다."
만든 것
이 작업에서 정리한 산출물은 HWP/HWPX to Markdown 변환기 개발계획서와 초기 구현 보완 방향입니다.
대상 산출물은 다음과 같습니다.
.hwp,.hwpx입력을 받는 CLIMarkdown
.md출력 파일이미지와 첨부 파일을 담는 assets 폴더
변환 중 손실과 경고를 기록하는
report.jsonCLI, GUI, Obsidian 플러그인 등에서 재사용할 수 있는 변환 라이브러리
예상 사용 방식은 이런 형태입니다.
hwp2md input.hwp -o output.md
hwp2md input.hwpx -o docs/output.md --assets-dir docs/output.assets
hwp2md input.hwp --format obsidian --image-mode extract --table-mode gfm
초기 버전의 목표는 완벽한 변환기가 아닙니다.
실제 문서를 Markdown 초안으로 안정적으로 바꾸고, Markdown으로 표현하기 어려운 정보는 조용히 버리지 않고 리포트에 남기는 도구입니다.
사용한 도구와 참고한 구조
이 프로젝트에서 AI에게 맡긴 핵심 역할은 "복잡한 변환 문제를 제품 설계와 테스트 가능한 작업 단위로 쪼개는 것"이었습니다. 단순히 코드를 바로 만들기보다, 어떤 정보를 보존하고 어떤 정보는 fallback으로 남길지 먼저 정리했습니다.
주요 참고 구조는 다음과 같습니다.
HOP: HWP/HWPX를 여는 데스크톱 앱 구조와 제품 계층 참고
rhwp: HWP/HWPX 파서와 문서 모델을 다루는 핵심 엔진 후보
obsidian-hwp-writer: Markdown과 HWPX 스타일이 연결되는 반대 방향 흐름 참고
Rust workspace: CLI와 core library, rhwp adapter, Markdown renderer를 분리하는 구조
회귀 테스트: 실제 변환 중 깨졌던 케이스를 다시 검증하는 안전장치
중요한 판단은 rhwp 같은 파서/엔진 계층과 Markdown 변환 계층을 분리하는 것이었습니다.
HWP/HWPX를 읽는 일과 Markdown으로 의미 있게 바꾸는 일은 서로 다른 책임입니다. 파서는 원본 구조를 최대한 정확히 읽고, 변환기는 그 구조를 사람이 편집할 수 있는 Markdown 표현으로 바꿔야 합니다.
진행 과정
1. 변환 기준을 "화면"이 아니라 "의미 구조"로 잡았다
처음부터 모든 레이아웃을 Markdown으로 재현하려고 하면 금방 막힙니다.
Markdown은 문서 편집과 공유에는 좋지만, 한글 문서의 복잡한 지면 배치와 장식 요소를 모두 담기에는 맞지 않습니다. 그래서 변환 기준을 이렇게 정했습니다.
제목은 Markdown heading으로 옮긴다.
일반 문단은 읽기 좋은 문단으로 나눈다.
단순 표는 GFM table로 옮긴다.
병합 셀이나 복잡한 표는 HTML table fallback을 쓴다.
이미지는 assets 폴더로 추출하고 Markdown 링크로 연결한다.
수식과 각주는 가능한 Markdown으로 보존하고, 어려운 것은 리포트에 남긴다.
머리말, 꼬리말, 바탕쪽은 기본 본문에 섞지 않는다.
이 기준 덕분에 "어디까지 변환할 것인가"를 매번 새로 고민하지 않고, 기능별 정책으로 나눌 수 있었습니다.
2. 중간 IR을 두는 구조로 설계했다
HWP/HWPX를 읽자마자 Markdown 문자열을 만들면 테스트와 디버깅이 어려워집니다.
그래서 중간에 Markdown Semantic IR을 두는 구조로 설계했습니다.
Document
  metadata
  blocks[]

Block
  Heading(level, inlines, source)
  Paragraph(inlines)
  List(kind, items, nesting)
  Table(rows, caption, fallback)
  Image(asset_id, alt, caption)
  Equation(source, fallback_image)
  Footnote(id, blocks)
  HtmlBlock(reason, html)
  UnknownBlock(source_ref, diagnostic)
이 구조의 장점은 분명했습니다.
원본 파싱 결과가 이상한지, 의미 구조 변환이 이상한지, Markdown 렌더링이 이상한지를 따로 볼 수 있습니다. 나중에 GFM, CommonMark, Obsidian 친화 출력처럼 Markdown 방언을 나누기도 쉬워집니다.
3. 실제로 깨지는 변환 케이스를 하나씩 보완했다
개발계획서에는 이미 구현 보완 내역도 같이 정리되어 있습니다.
예를 들어 HWP 표는 단순히 텍스트를 줄 단위로 뽑으면 구조가 쉽게 깨집니다. 그래서 표 control과 cell record를 묶어 행, 열, 병합 정보를 복원하고, 단순 표는 GFM으로, 병합 표는 HTML fallback으로 출력하도록 방향을 잡았습니다.
보도자료 문서에서 자주 나오는 상단 장식 표도 별도 처리 대상이었습니다. 겉으로는 표지만 본문 표라기보다 배포일시, 보도일시, 담당부서, 담당자를 담은 메타데이터에 가깝습니다. 그래서 본문에서는 제거하되 frontmatter와 report.json metadata에 남기는 방식으로 정리했습니다.
실제 보완한 문제들은 꽤 구체적입니다.
HWP inline 제어문자 때문에
('12)→)→)처럼 깨지던 연도별 수치 문자열 보정HWP BMP 이미지를 PNG로 변환
공백과 괄호가 있는 자산 경로를 Markdown
<...>destination으로 출력재변환 시 이전 generated assets가 새 결과와 섞이지 않도록 정리
캡션 직후 그림 control을 감지해 해당 위치에 이미지 우선 배치
단순 분수 수식은 Markdown 수식 fallback으로 보존
각주 control은 placeholder로 남겨 후속 복원 대상으로 추적
HWPX inline style 태그를 bold, italic, underline, sub, sup 표현으로 보존
[1],붙임1, 짧은1. 제목,가. 제목같은 문단을 목록이 아니라 heading 후보로 승격구조화하지 못한 HWP control id를
report.jsonwarning/loss에 남김
여기서 좋았던 점은 "못 바꾸는 것"을 숨기지 않는 방향으로 설계했다는 점입니다.
변환기가 완벽하지 않아도, 무엇이 손실됐고 무엇이 fallback 처리됐는지 알 수 있으면 사람이 검수할 수 있습니다.
4. 변환 리포트를 기본 산출물로 넣었다
Markdown 파일만 나오면 사용자는 무엇이 누락됐는지 알기 어렵습니다.
그래서 output.report.json을 기본 산출물로 두는 설계를 넣었습니다.
{
  "source": "input.hwp",
  "format": "hwp",
  "pages": 12,
  "blocks": 180,
  "assets": 8,
  "warnings": [
    {
      "code": "TABLE_HTML_FALLBACK",
      "message": "Merged cells require HTML table fallback",
      "sourceRef": "section=0 paragraph=34"
    }
  ],
  "losses": [
    {
      "code": "TEXT_COLOR_DROPPED",
      "count": 12
    }
  ]
}
이 리포트는 단순 로그가 아니라 변환 품질을 개선하는 기준표가 됩니다.
예를 들어 수식이 fallback 처리됐는지, 병합 표가 HTML로 나갔는지, 색상 정보가 빠졌는지, 알 수 없는 control id가 있었는지를 나중에 다시 추적할 수 있습니다.
5. 회귀 테스트를 변환 품질의 중심에 뒀다
문서 변환기는 한번 고친 문제가 다시 깨지기 쉽습니다.
특히 HWP/HWPX는 실제 문서마다 구조가 다르고, 표와 이미지가 섞이면 엣지 케이스가 계속 나옵니다. 그래서 tests/test_hwp2md.py 회귀 테스트로 보완 내역을 검증하도록 정리했습니다.
검증 대상으로 잡은 항목은 다음과 같습니다.
파일명 보존
metadata 추출
heading 추론
inline 수치 복원
자산 링크
BMP 변환
수식 fallback
assets 정리
170508 샘플 변환
Before vs After
Before는 이런 상태였습니다.
HWP/HWPX를 Markdown으로 바꿀 때 무엇을 보존해야 하는지 기준이 흐릿했다.
표, 이미지, 수식, 각주 같은 요소가 케이스마다 다르게 깨질 수 있었다.
실패한 변환이 조용히 누락되면 사용자가 나중에 알아차리기 어려웠다.
기능을 어디서부터 구현해야 할지 범위가 커 보였다.
After는 이렇게 바뀌었습니다.
변환 목표를 "의미 구조 보존"으로 정의했다.
파서, 중간 IR, Markdown renderer, asset extractor, report를 분리했다.
단순 표와 복잡한 표의 출력 정책을 나눴다.
변환 손실과 경고를
report.json에 남기는 기준을 만들었다.MVP와 v0.1.0 성공 기준을 분리했다.
실제 깨졌던 변환 케이스를 회귀 테스트로 묶었다.
단계별 개발 계획
이번 계획에서 가장 현실적이었던 부분은 "완벽한 변환기"를 바로 만들겠다고 하지 않은 점입니다.
단계는 이렇게 쪼갰습니다.
기술 검증:
rhwp소스와 라이선스 검토, 샘플 문서 파싱 확인프로젝트 골격: Rust workspace, CLI 인자, 입력 감지,
dump-ir명령기본 Markdown 변환: 문단, heading, 인라인 서식, 목록, frontmatter
표, 이미지, 각주: GFM table, HTML fallback, assets 추출
수식과 복잡 객체: 수식 원문, 이미지 fallback, 도형 텍스트, 머리말/꼬리말
품질 개선과 배포: OS별 빌드, 대용량 문서, batch 변환, README 작성
v0.1.0의 기준도 작게 잡았습니다.
HWP/HWPX 입력 자동 감지
텍스트, 제목, 문단, 목록 출력
단순 표를 GFM table로 출력
이미지를 assets 폴더로 추출
변환 리포트 생성
실패 시 panic 없이 진단 메시지 출력
이렇게 나누니 당장 할 일과 나중에 할 일이 분리됐습니다.
결과와 배운 점
이 작업에서 가장 크게 배운 점은, AI와 함께 개발할 때도 "무엇을 만들지"보다 "무엇을 보존할지"를 먼저 정해야 한다는 것입니다.
HWP/HWPX 변환은 표면적으로는 파일 변환이지만, 실제로는 문서의 의미를 재구성하는 작업에 가깝습니다. 제목인지 목록인지, 장식 표인지 메타데이터인지, 본문 이미지인지 캡션 뒤에 붙은 그림인지 판단해야 합니다.
또 하나의 교훈은 손실을 없애는 것만큼 손실을 기록하는 것도 중요하다는 점입니다.
Markdown으로 표현하기 어려운 요소를 억지로 예쁜 출력으로 숨기면 나중에 검수하기 어렵습니다. 반대로 report.json에 warning과 loss를 남기면, 도구가 아직 못 하는 일을 다음 개선 작업으로 연결할 수 있습니다.
현재 이 프로젝트는 "한 번에 모든 문서를 완벽하게 변환하는 도구"가 아니라, 실제 한글 문서를 Markdown 초안으로 안정적으로 옮기기 위한 구조와 검증 기반을 잡은 상태입니다.
다른 사람이 비슷하게 해보려면
바로 코드를 만들기 전에 이 순서로 접근하는 것이 좋았습니다.
변환 결과의 목적을 정한다. 화면 재현인지, 편집 가능한 Markdown인지 먼저 결정한다.
원본 문서에서 반드시 보존할 요소를 목록화한다.
Markdown으로 표현이 어려운 요소는 HTML fallback 또는 report로 남긴다.
파서와 renderer 사이에 중간 IR을 둔다.
실제로 깨진 문서를 fixture로 만들고 회귀 테스트에 넣는다.
v0.1.0 기준을 작게 잡고, 실패 시 진단 메시지를 잘 내는 쪽을 우선한다.
다음에 해볼 것
rhwp연동 방식 확정공개 샘플과 private fixture 분리
dump-ir명령으로 실제 문서 구조 확인문단, 제목, 목록부터 snapshot 테스트 구축
표와 이미지 변환 케이스 확장
Obsidian 친화 출력 옵션 정리
장기적으로
hwp2md serve,hwp2md watch, Obsidian 플러그인 검토
