CREATE TABLE IF NOT EXISTS kb_market_index (
    base_month DATE,
    region_name VARCHAR,
    sale_price_index DOUBLE,
    jeonse_price_index DOUBLE,
    jeonse_ratio DOUBLE
);
이렇게 원본, 정제 데이터, 시장지표를 분리하니 데이터 수정과 검증이 쉬워졌습니다.
4. 같은 데이터를 다시 수집해도 안전하게 만들기
자동화 파이프라인에서는 같은 기간을 여러 번 실행할 수 있습니다.
예를 들어 API 오류로 일부 페이지만 저장됐거나, 이전 데이터가 정정되어 다시 제공될 수도 있습니다.
따라서 수집 프로그램은 재실행해도 결과가 달라지지 않는 구조가 필요했습니다.
INSERT INTO apt_trade
SELECT *
FROM apt_trade_staging
WHERE NOT EXISTS (
    SELECT 1
    FROM apt_trade AS saved
    WHERE saved.contract_date = apt_trade_staging.contract_date
      AND saved.legal_dong = apt_trade_staging.legal_dong
      AND saved.apartment_name = apt_trade_staging.apartment_name
      AND saved.exclusive_area = apt_trade_staging.exclusive_area
      AND saved.floor = apt_trade_staging.floor
      AND saved.deal_amount = apt_trade_staging.deal_amount
);
실제 데이터에서는 하나의 컬럼만으로 거래를 식별하기 어렵기 때문에 계약일, 지역, 아파트명, 면적, 층, 거래금액 등을 조합해 중복 여부를 확인했습니다.
취소 거래나 정정 거래가 포함된 경우에는 별도 상태값을 두거나 최신 수집 데이터를 기준으로 갱신하는 방식도 고려했습니다.
5. 저장된 데이터가 정상인지 검증하기
이번 작업에서 가장 신경 쓴 부분은 데이터 수집보다 수집 결과 검증이었습니다.
데이터가 DuckDB에 저장됐다는 사실만으로는 정상적으로 수집됐다고 볼 수 없기 때문입니다.
월별 수집 건수 확인
SELECT
    DATE_TRUNC('month', contract_date) AS contract_month,
    trade_type,
    COUNT(*) AS trade_count
FROM apt_trade
WHERE district_name = '노원구'
GROUP BY contract_month, trade_type
ORDER BY contract_month, trade_type;
특정 월의 거래량이 갑자기 0건이거나 지나치게 적다면 API 호출 누락이나 페이지 처리 오류를 의심할 수 있습니다.
중복 데이터 확인
SELECT
    contract_date,
    legal_dong,
    apartment_name,
    exclusive_area,
    floor,
    deal_amount,
    COUNT(*) AS duplicate_count
FROM apt_trade
GROUP BY
    contract_date,
    legal_dong,
    apartment_name,
    exclusive_area,
    floor,
    deal_amount
HAVING COUNT(*) > 1;
필수값 누락 확인
SELECT *
FROM apt_trade
WHERE contract_date IS NULL
   OR apartment_name IS NULL
   OR exclusive_area IS NULL
   OR trade_type IS NULL;
비정상 값 확인
SELECT *
FROM apt_trade
WHERE exclusive_area <= 0
   OR deal_amount < 0
   OR deposit_amount < 0
   OR monthly_rent < 0;
검증 결과는 별도의 로그 테이블에 남겼습니다.
CREATE TABLE IF NOT EXISTS collection_log (
    data_type VARCHAR,
    target_month DATE,
    collected_count BIGINT,
    stored_count BIGINT,
    duplicate_count BIGINT,
    invalid_count BIGINT,
    status VARCHAR,
    checked_at TIMESTAMP
);
덕분에 어떤 월의 데이터가 정상 처리됐고, 어느 시점에 오류가 발생했는지 쉽게 확인할 수 있었습니다.
6. 평균 대신 중앙값을 활용하기
부동산 실거래 데이터에는 다양한 면적과 가격대의 아파트가 함께 포함됩니다.
고가 아파트 몇 건이나 비정상적으로 낮은 거래가 포함되면 평균 가격이 크게 달라질 수 있습니다.
그래서 이번 대시보드에서는 평균보다 중앙값을 주요 지표로 사용했습니다.
SELECT
    MEDIAN(deal_amount) / 10000.0 AS median_price_100m
FROM apt_trade
WHERE district_name = '노원구'
  AND trade_type = '매매';
다만 전체 매매가 중앙값에는 서로 다른 전용면적의 거래가 모두 포함되어 있습니다.
따라서 대시보드에서도 전체 중앙값뿐 아니라 다음 기준을 함께 확인할 수 있도록 구성했습니다.
월별
평형대별
읍면동별
건축 연식별
7. DuckDB 조회 결과를 대시보드로 시각화하기
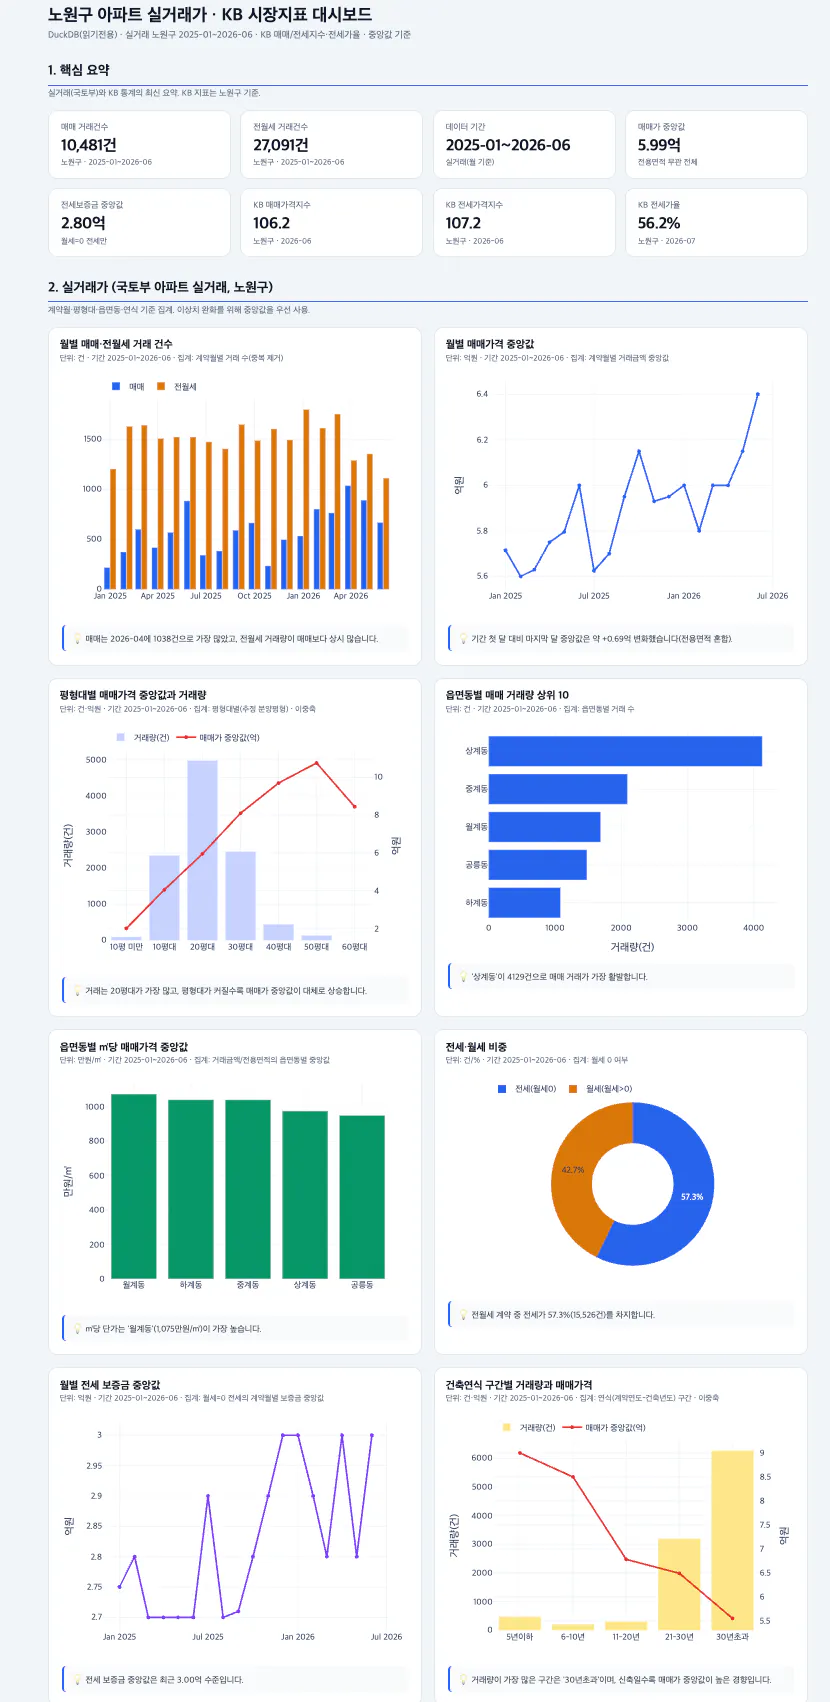
최종 결과물은 별도의 서버 없이 열어볼 수 있는 HTML 대시보드로 만들었습니다.
대시보드는 크게 세 부분으로 나눴습니다.
핵심 요약
매매 거래 건수
전월세 거래 건수
데이터 수집 기간
매매가격 중앙값
전세보증금 중앙값
KB 매매가격지수
KB 전세가격지수
KB 전세가율
실거래 분석
월별 매매·전월세 거래 건수
월별 매매가격 중앙값
평형대별 가격과 거래량
읍면동별 거래량
건축 연식별 거래량과 가격
KB 시장지표 분석
서울과 노원구 매매가격지수 비교
서울과 노원구 전세가격지수 비교
서울과 노원구 전세가율 비교
실거래 중앙값과 KB 지수 흐름 비교
지역별 최신 가격지수 비교
import duckdb
import plotly.express as px

with duckdb.connect("apt_data.duckdb", read_only=True) as conn:
    monthly_trade = conn.execute("""
        SELECT
            DATE_TRUNC('month', contract_date) AS month,
            trade_type,
            COUNT(*) AS trade_count
        FROM apt_trade
        WHERE district_name = '노원구'
        GROUP BY month, trade_type
        ORDER BY month
    """).df()

fig = px.bar(
    monthly_trade,
    x="month",
    y="trade_count",
    color="trade_type",
    barmode="group",
    title="월별 매매·전월세 거래 건수"
)

fig.write_html("apt_kb_dashboard.html")
대시보드 조회 단계에서는 DuckDB를 읽기 전용으로 연결했습니다.
수집과 적재 작업이 끝난 데이터베이스를 시각화 과정에서 실수로 수정하지 않도록 하기 위해서였습니다.
🖼️ [노원구 아파트 실거래가·KB 시장지표 대시보드 전체 화면 ]
구글애널리틱스 대시보드 스크린샷
결과와 배운 점
1. 총 3만 7천 건 이상의 거래 데이터를 하나의 화면에서 확인할 수 있게 됐다
최종 대시보드에는 2025년 1월부터 2026년 6월까지 노원구의 실거래 데이터가 반영됐습니다.
매매 거래: 10,481건
전월세 거래: 27,091건
전체 거래: 37,572건
전체 매매가격 중앙값: 5.99억 원
순수 전세보증금 중앙값: 2.80억 원
전세보증금 중앙값은 월세가 0인 순수 전세 거래만을 대상으로 계산했습니다.
처음에는 데이터를 빠짐없이 저장하는 것이 목표였지만, 최종적으로는 수만 건의 데이터를 월별·평형별·지역별로 바로 탐색할 수 있게 됐습니다.
2. 전월세 거래량이 매매보다 지속적으로 많았다
월별 거래 건수를 비교해보니 분석 기간 내내 전월세 거래량이 매매 거래량보다 많았습니다.
매매 거래는 2026년 4월 1,038건으로 가장 많았습니다.
단순 누적 건수만 봤을 때도 전월세 거래가 매매 거래의 두 배를 크게 넘었습니다.
이 결과를 통해 가격만 보는 것보다 거래량을 함께 봐야 시장의 움직임을 더 입체적으로 이해할 수 있다는 점을 확인했습니다.
3. 분석 기간 동안 매매가격 중앙값이 약 0.69억 원 상승했다
분석 기간 첫 달과 마지막 달의 매매가격 중앙값을 비교했을 때 약 0.69억 원 증가했습니다.
다만 이 결과에는 서로 다른 전용면적의 거래가 함께 포함되어 있습니다.
특정 월에 대형 평형 거래가 많아지면 전체 중앙값도 상승할 수 있기 때문에, 이것을 곧바로 동일 아파트의 가격 상승으로 해석해서는 안 됩니다.
그래서 전체 중앙값 추이와 평형대별 가격을 함께 제공했습니다.
4. 20평대의 거래가 가장 활발했다
평형대별로 거래량과 매매가격 중앙값을 함께 확인해보니 20평대의 거래량이 가장 많았습니다.
또한 평형대가 커질수록 매매가격 중앙값도 대체로 상승하는 모습을 보였습니다.
거래량만 표시하면 어느 평형이 활발한지는 알 수 있지만 가격 수준은 알기 어렵습니다.
반대로 가격만 표시하면 소수 거래의 결과가 대표값처럼 보일 수 있습니다.
그래서 막대그래프로 거래량을, 선그래프로 가격 중앙값을 함께 표현했습니다.
5. 노원구에서는 오래된 아파트의 거래 비중이 높았다
건축 연식별로 데이터를 구분했을 때 거래량이 가장 많은 구간은 30년 초과 아파트였습니다.
반면 매매가격 중앙값은 신축에 가까울수록 높아지는 경향을 보였습니다.
이는 노원구의 아파트 재고 구성과도 관련이 있을 수 있지만, 이번 대시보드만으로 원인을 단정하지는 않았습니다.
대시보드는 다음 질문을 발견하기 위한 출발점으로 활용했습니다.
오래된 아파트 거래가 많은 동은 어디인가?
재건축 기대 지역이 거래량에 영향을 주는가?
신축 가격 프리미엄은 평형대별로 얼마나 다른가?
같은 동에서도 건축 연도에 따라 가격 차이가 얼마나 발생하는가?
6. 노원구 전세지수는 서울 전체보다 높게 나타났다
2026년 6월 기준 KB 지표는 다음과 같습니다.
노원구 매매가격지수: 106.2
노원구 전세가격지수: 107.2
서울 전세가격지수: 104.5
노원구 전세가율: 56.2%
노원구의 최신 전세가격지수는 서울 전체 지수보다 높게 나타났습니다. 전세가율은 2026년 7월 기준입니다. 실거래 데이터만으로는 최근 거래된 아파트의 가격 변화는 알 수 있지만, 장기간의 시장 흐름과 서울 전체 대비 상대적인 움직임을 보기 어렵습니다.
KB 시장지표를 함께 사용하니 실거래 분석의 시간적 범위를 보완할 수 있었습니다.
7. 서로 다른 지표를 비교할 때는 기준을 통일해야 했다
실거래 가격은 억 원 단위이고, KB 가격지수는 기준시점이 100인 지수입니다.
두 값을 그대로 한 그래프에 표시하면 단위가 다르기 때문에 흐름을 비교하기 어렵습니다.
그래서 실거래 중앙값과 KB 지수를 각각 2025년 1월을 100으로 재지수화했습니다.
SELECT
    base_month,
    median_price
        / FIRST_VALUE(median_price) OVER (ORDER BY base_month)
        * 100 AS actual_price_index,
    kb_price_index
        / FIRST_VALUE(kb_price_index) OVER (ORDER BY base_month)
        * 100 AS kb_rebased_index
FROM monthly_price_comparison;
이를 통해 절대적인 가격 차이가 아니라 두 시계열의 변화 방향을 비교할 수 있었습니다.
다만 두 데이터는 표본과 산정 방식이 다르기 때문에, 하나의 지표가 다른 지표를 움직였다고 인과관계로 해석하지 않았습니다.
8. 수집 자동화의 완성은 시각화가 아니라 검증이었다
처음에는 데이터를 자동으로 내려받고 DuckDB에 넣으면 작업이 끝날 것이라고 생각했습니다.
하지만 진행하면서 자동화에서 가장 중요한 것은 정상적으로 수집됐다는 사실을 증명할 수 있는가라는 점을 알게 됐습니다.
다음 질문에 답할 수 있어야 대시보드를 신뢰할 수 있었습니다.
모든 조회 페이지를 가져왔는가?
같은 거래가 중복 저장되지 않았는가?
일부 월의 데이터가 누락되지는 않았는가?
매매와 전월세가 올바르게 구분됐는가?
금액 단위가 잘못 변환되지는 않았는가?
빈 문자열이 숫자 0으로 바뀌지는 않았는가?
정정되거나 취소된 거래는 어떻게 처리됐는가?
KB 지표의 기준월과 실거래 계약월이 일치하는가?
자동화 프로그램에 검증 SQL과 수집 로그를 포함하자 오류를 훨씬 빠르게 찾을 수 있었습니다.
수집 성공 메시지보다 검증 결과가 더 중요했습니다.
9. DuckDB는 수집과 분석 사이를 연결하기에 적합했다
이번 작업에서 DuckDB는 단순한 저장소 이상의 역할을 했습니다.
API 수집
  → DuckDB 저장
  → SQL 검증
  → 월별·지역별 집계
  → Pandas DataFrame 변환
  → Plotly 시각화
  → HTML 대시보드 생성
서버형 데이터베이스를 먼저 구성하지 않아도 파일 하나로 데이터 수집과 분석을 시작할 수 있었습니다.
또한 Python에서 복잡한 반복문으로 집계하기보다 SQL을 이용해 다음 작업을 간단히 처리할 수 있었습니다.
중앙값 계산
월별 집계
평형 구간 분류
건축 연식 구간 분류
지역별 순위
시계열 재지수화
중복 및 이상값 검사
작은 규모의 개인 프로젝트나 데이터 분석 프로토타입에서는 매우 효율적인 선택이었습니다.
앞으로 개선하고 싶은 부분
이번에는 노원구를 기준으로 대시보드를 만들었지만, 다음 단계에서는 자동화 범위를 더 확장해보려고 합니다.
서울 전체 자치구 자동 수집
거래 취소와 정정 데이터 반영
아파트 단지별 가격 추이
동일 면적 기준 반복매매 분석
전용면적을 통제한 가격 변화 분석
지하철역과의 거리 데이터 결합
재건축 연한과 거래량 비교
매일 또는 매월 스케줄 자동 실행
수집 실패 시 메신저 알림
검증 실패 데이터를 별도 테이블로 격리
대시보드 지역 필터 추가
DuckDB 파일과 Parquet 파티션 병행 관리
최종적으로는 다음 명령 하나로 수집부터 대시보드 생성까지 실행되는 구조를 목표로 하고 있습니다.