


Antigravity 캐릭터 일관성 소개
거진 2년여만에 지피터스 글을 쓰는듯 하네요.
Antigravity 초보이기 때문에, 우여곡절과 시행착오가 정말 많이 겪고 있습니다.
Antigravity로 본업관련 영상 자동화를 만들어보고 싶었습니다. 처음이니 가벼운 마음으로 두 명의 2D 캐릭터를 바탕으로, 새로운 장면에서도 같은 캐릭터처럼 보이게 만드는 것이 목표로 삼았습니다.
쉽게 말하면, 한 번 만든 캐릭터가 다른 그림에서도 계속 같은 인물처럼 보여야 했어요.
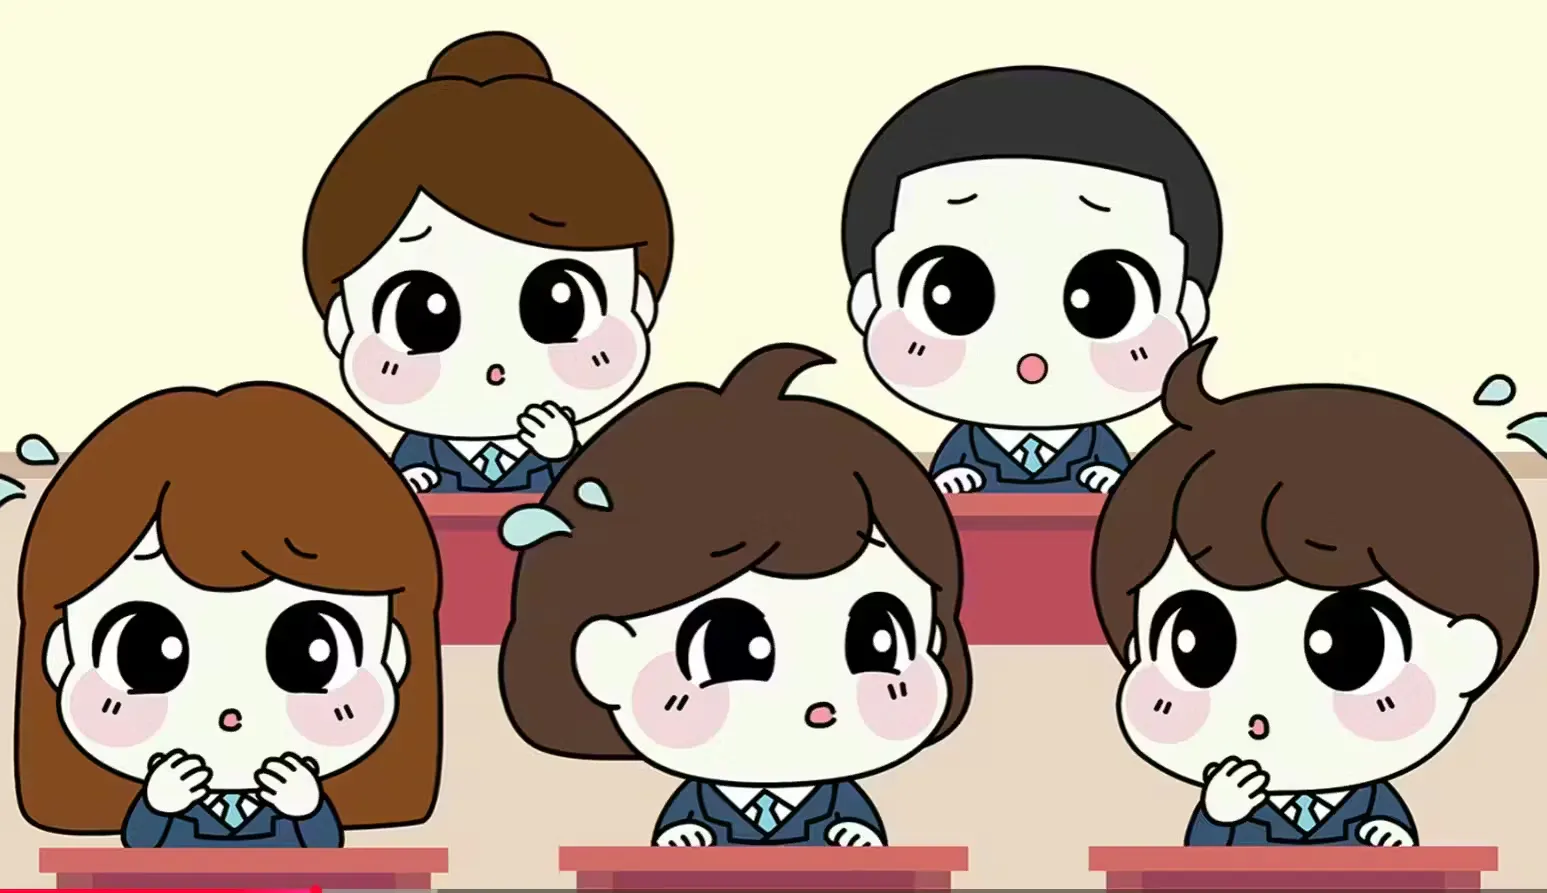
한 무리의 한국 학생들이 책상에 앉아 있다
처음에는 “설명을 잘 쓰면 되겠지”라고 생각했습니다.
그래서 텍스트 프롬프트를 중심으로 이미지를 생성해봤는데, 막상 결과를 보니 생각보다 쉽지 않았습니다. 특히 남아 캐릭터 쪽은 머리 모양이 자꾸 원본과 다르게 해석되면서, 전혀 다른 인물처럼 보이는 결과가 반복됐습니다.
이번 작업은 두 명의 2D 캐릭터를 바탕으로, 새로운 장면에서도 같은 캐릭터처럼 보이게 만드는 것이 목표였습니다.
쉽게 말하면, 한 번 만든 캐릭터가 다른 그림에서도 계속 같은 인물처럼 보여야 했어요.
처음에는 “설명을 잘 쓰면 되겠지”라고 생각했습니다.
그래서 텍스트 프롬프트를 중심으로 이미지를 생성해봤는데, 막상 결과를 보니 생각보다 쉽지 않았습니다. 특히 남아 캐릭터 쪽은 머리 모양이 자꾸 원본과 다르게 해석되면서, 전혀 다른 인물처럼 보이는 결과가 반복됐습니다.
문제 해결 과정
문제 원인 분석
가장 먼저 확인한 건, 왜 캐릭터가 자꾸 다르게 나오는지였습니다.
남아 캐릭터의 경우 원본은 비교적 단정한 느낌이었는데, 생성 결과에서는 머리카락이 과하게 뻗치거나 지저분하게 표현되는 문제가 있었습니다.
결국 AI가 캐릭터의 특징을 잘못 이해하고 있었던 거죠.
이 단계에서 중요했던 건 “비슷하게 안 나온다”라고 뭉뚱그려 보는 게 아니라,
어떤 부분이 다르게 나오는지
어떤 특징이 과하게 강조되는지
원본에서 실제로 중요한 요소가 뭔지
를 하나씩 다시 정리하였습니다.
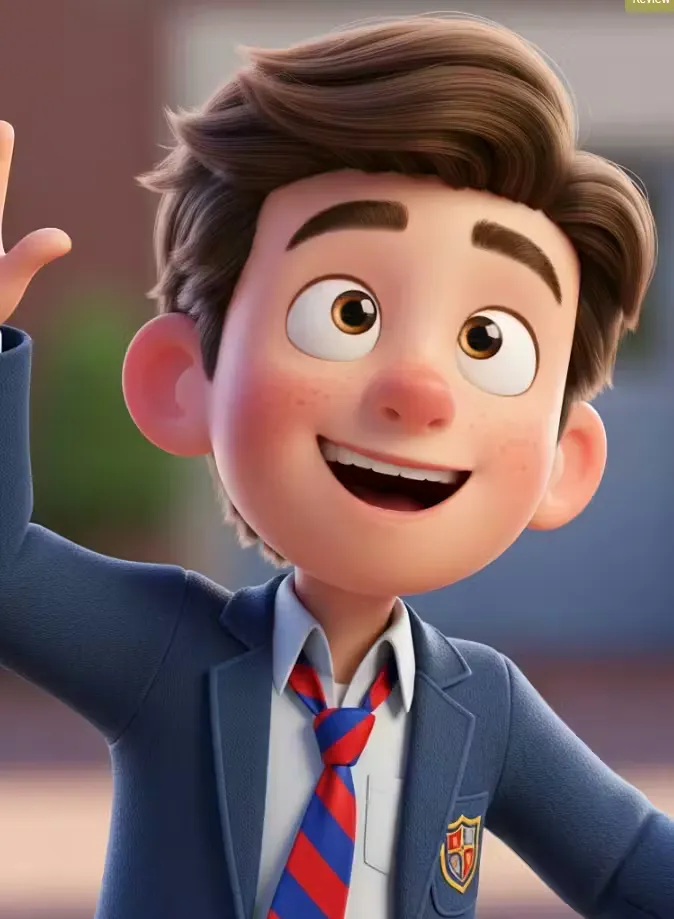
양복과 넥타이를 입고 손을 흔드는 만화 소년
원본 남아 캐릭터 / 여아 캐릭터 이미지
머리 모양이 다르게 생성된 예시
피드백 주고받은 화면 캡처
프롬프트 수정
그다음에는 텍스트 프롬프트를 손봤습니다.
문제를 일으킬 수 있는 표현은 빼고, 꼭 필요한 특징만 남기는 방식으로 정리했습니다.
AI 에이전트는 힘찬이의 단정한 숏컷 위쪽에 있는 미세한 곡선을 "prominent tuft sticking up(눈에 띄게 솟아오른 삐친 머리)" 혹은 "messy(지저분한)" 머리로 심각하게 확대 해석해버렸습니다. 그 결과 사방으로 뻗친 머리를 가진 엉뚱한 캐릭터가 생성되었습니다.
오해를 만드는 단어를 삭제하고, 보다 단정하고 둥근 형태로 이해되도록 다시 표현했습니다.
프롬프트 수정 예시
Open optionsauto
제거한 표현
- tuft
- messy

다시 정리한 표현
- neat
- rounded bowl-cut
- 잔머리 없이 단정하고 매끄러운 머리
이렇게 바꾸자 결과는 전보다 훨씬 안정됐습니다.
적어도 엉뚱한 방향으로 특징이 튀는 문제는 줄어들었어요.
다만 여기서도 한계는 있었습니다.
텍스트만으로는 “비슷한 느낌”까지는 만들 수 있었지만,
원본의 분위기와 인상을 계속 유지하는 데에는 부족함이 있었습니다.
Image-to-Image 방식 전환
그래서 방향을 바꿨습니다.
텍스트로 설명만 하는 대신, 원본 이미지를 직접 참고시키는 방식을 쓰기로 했습니다.
이 방식의 장점은 분명했습니다.
말로 길게 설명하지 않아도 되고
원본 캐릭터의 인상과 형태를 더 잘 유지할 수 있고
캐릭터 일관성을 맞추는 데 훨씬 유리했습니다
특히 여아 캐릭터나 남아 캐릭터처럼
이미 기준 이미지가 분명한 경우에는,
텍스트 생성보다 Image-to-Image 방식이 훨씬 안정적이었습니다.
개념 예시 코드
Open optionsauto
payload = {
    "prompt": prompt,
    "image_urls": [reference_image_url],
}
Google API 시도
AI STUDIO에 크레딧이 꽤 남아있었기에, 처음에는 Google api를 이용해서 Image-to-Image 방식을 시도했습니다. 당연히 될 줄 알았어요.
그런데 에이전트가 안된다고 드러눕습니다.
구글 api는 Text-to-Image 방식만 지원된다네요? 진짜인지 아닌지 알 수는 없으나 일단 믿고 노선을 바꿉니다.
fal-ai 시도
fal-ai 는 reference 기능을 제공하여 api로도 I2I 방식이 가능하다는 에이전트의 말을 듣습니다.
이중지출이 마음아팠지만, 그래도 진행해보니, 시간은 조금 오래걸려도 괜찮은 수준으로 일관성을 유지하는 것이 관찰됩니다. 다만, 무료 api로는 작동이 안되어 눈물을 머금고 크레딧을 충전하여 해결했습니다.
파이프라인 정리 후 결과
결제 이슈와 권한 문제를 정리하고,
입력 형식도 현재 구조에 맞게 다시 손보면서 흐름이 안정됐습니다.
그 뒤에는 원본 캐릭터 이미지를 직접 참고한 생성 결과에서
확실히 더 자연스럽고 일관된 결과를 얻을 수 있었습니다.
특히 캐릭터의
얼굴 인상
머리 형태
전체적인 분위기
가 이전보다 훨씬 잘 유지됐습니다.
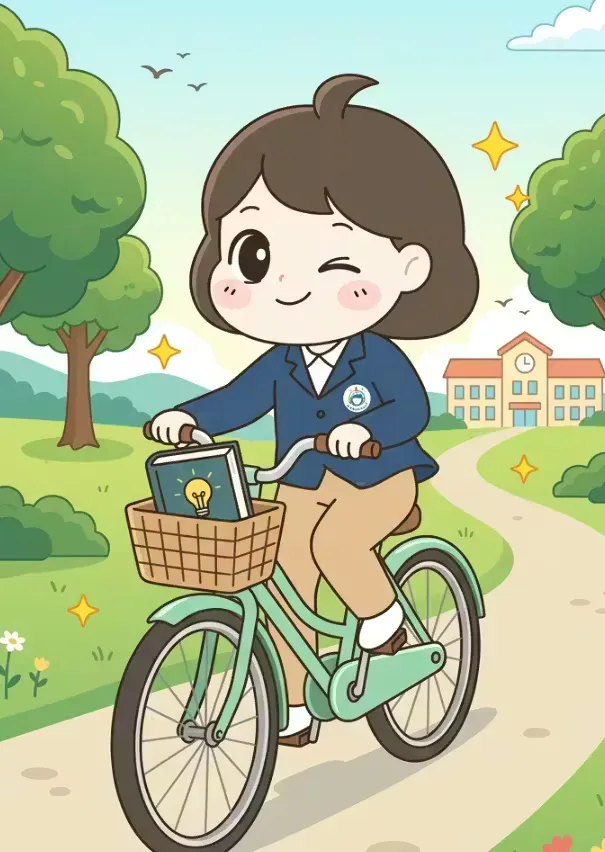
바구니에 책을 넣고 자전거를 타는 만화 소녀
결과와 배운 점
정리하면 이번 경험에서 얻은 핵심은 이렇습니다.
비슷하게 보이게 하는 것과 같은 캐릭터처럼 보이게 하는 것은 다르다
확정된 캐릭터가 필요하다면 텍스트 프롬프트는 출발점이 될 수 있지만, 일관성 유지에는 한계가 있다
원본 레퍼런스를 직접 사용하는 방식이 훨씬 안정적이다
실전에서는 모델보다도 입력 구조와 연결 방식이 결과를 크게 좌우한다
도움 받은 글
작업 일지 원문
Google Imagen 관련 문서
fal 관련 문서 및 image-to-image 참고 자료
