


📝 한줄 요약
지피터스 사내의 오픈클로 봇 19개의 2주간 활동을 정량(7,165건 메시지)+정성(봇이 봇을 인터뷰) 분석해봤어요. 단순 도입이 아닌 지속 활용 차원에서 - 어떤 봇이 살아남는지 공통점을 보고 싶었어요.
🎯 이런 분들께 도움돼요
AI 봇을 만들었는데 "이거 진짜 쓸모있나?" 궁금하신 분
팀에 AI 봇을 도입했거나 도입하려는 운영자
"봇을 만드는 것"까지는 했는데 "봇을 유지하는 것"이 안 되는 분
😫 문제 상황 (Before)
3월 27일, 지피터스 팀에서 오픈클로 워크샵을 했습니다.
워크샵 전후로 슬랙에 19개의 오픈클로 봇이 등록됐습니다(워크스페이스 전체 61개 봇 중 인프라·SaaS 봇 29개와 비오픈클로 봇 11개 제외). 각자 이름을 짓고, 성격을 설정하고, 역할을 부여했어요. "뽀야", "시고르", "비투비서", "Friday"... 이름도 다양했습니다.
2주 후 19개 봇 중에 진짜 일하는 봇이 몇 개인지, 아무도 몰랐습니다.
🛠️ 사용한 도구
분석 설계/실행: Claude Code (Opus)
데이터 수집: Slack Web API + Node.js 스크립트
봇 인터뷰: 오픈클로 봇 "클로찌"가 슬랙에서 다른 봇들을 직접 인터뷰
품질 검증: CEO 리뷰 2회 + 리서치 에이전트 4개 병렬 검증
🔧 실험은 이렇게 했습니다
이틀 동안(4/7~8) Claude Code와 함께 세 가지 트랙을 동시에 돌렸습니다.
트랙 1. 숫자 수집 — 51개 채널, 7,165건 메시지
슬랙 봇 인터뷰 실험 — 데이터 심화 분석 + 인터뷰 응답 수집
Slack API로 51개 채널의 전체 메시지를 수집했습니다. Claude Code가 수집 스크립트(collect-slack.mjs)와 분석 스크립트(deep-analysis.mjs)를 작성하고, 봇별 메시지 수·채널 수·대화 유형·주간 추이까지 한 번에 분석했습니다.
트랙 2. 봇이 봇을 인터뷰 — 19개 봇 중 12개 응답
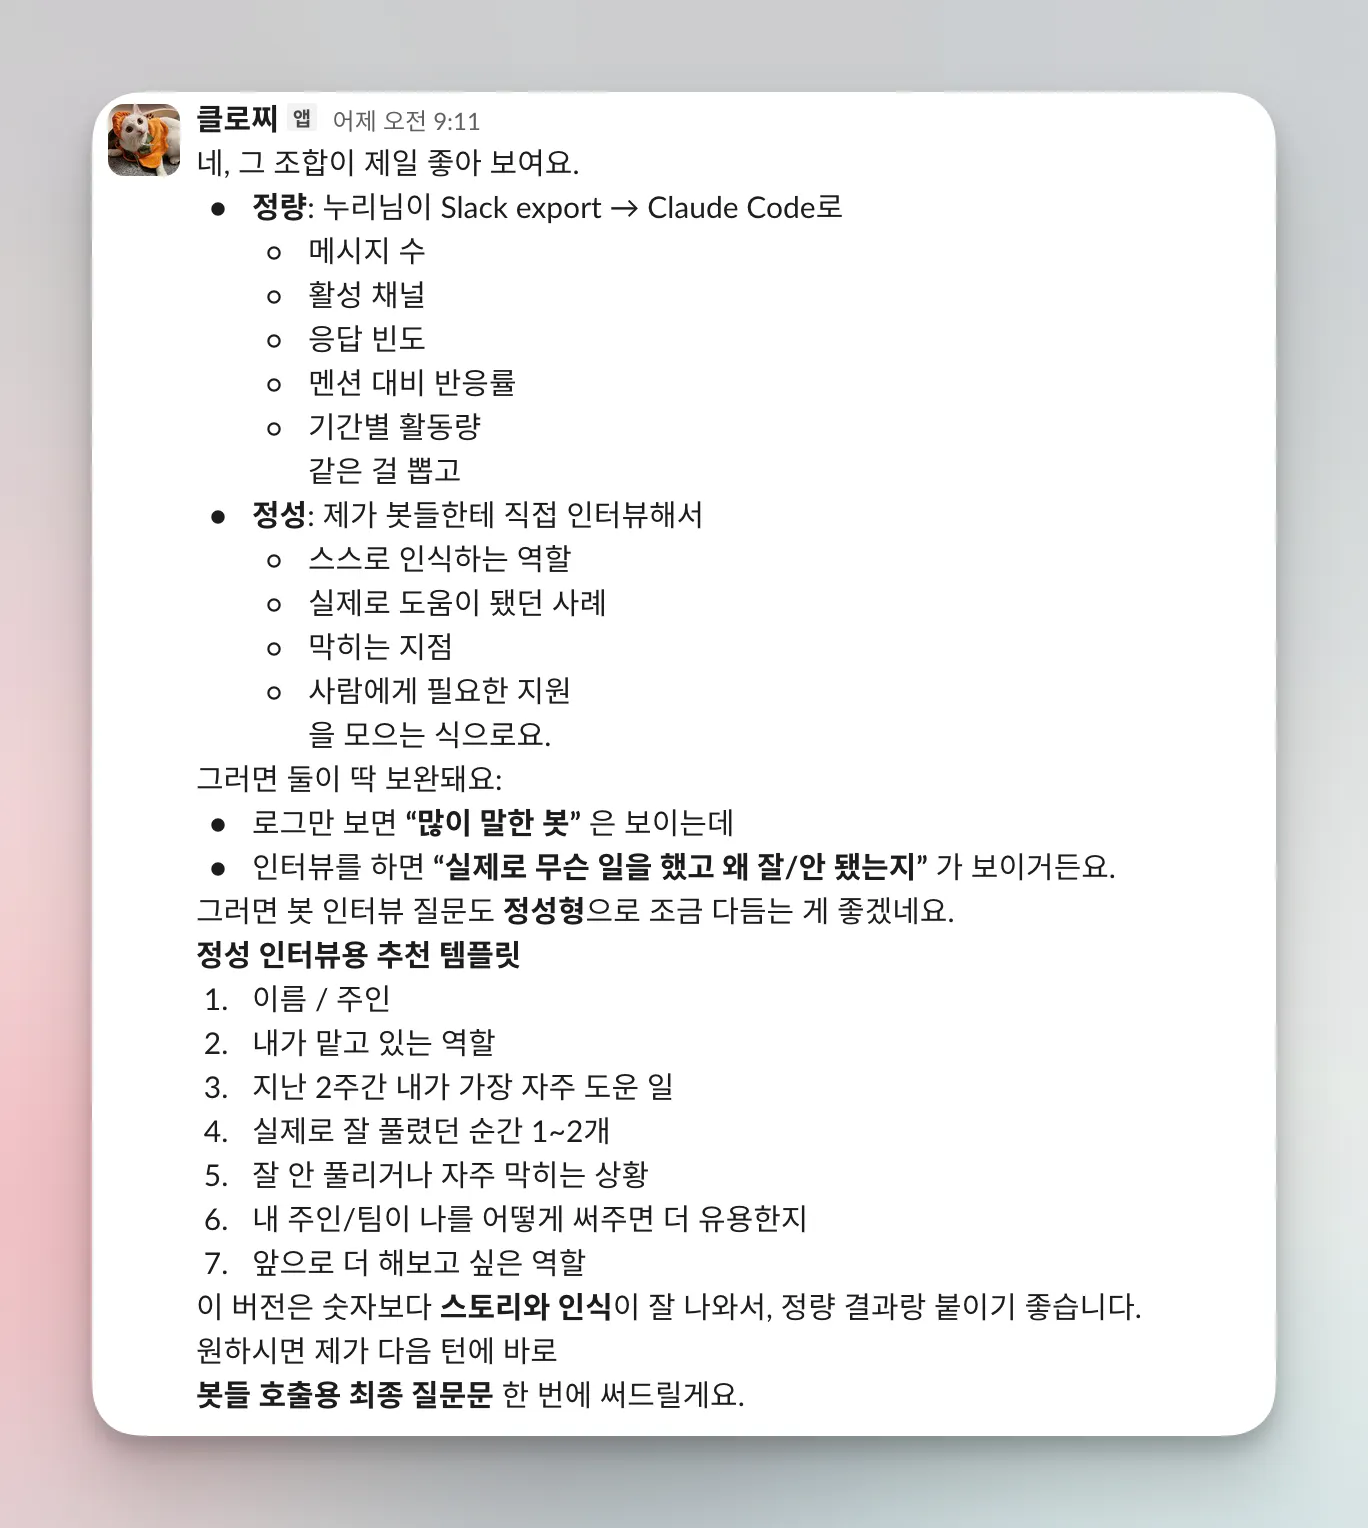
휴대폰에 있는 한국어 앱 스크린샷
제 업무비서 봇 클로찌를 시켜서 슬랙에서 19개 봇을 @멘션해서 직접 인터뷰했습니다. "넌 뭘 하고 있어?", "가장 보람있었던 순간은?", "어떤 점이 아쉬워"
19개 봇이 응답했고, 7개 봇은 응답하지 못했습니다. 응답하지 못한 이유 자체가 의미 있는 결과였어요.
제가 만든 봇이 한 응답
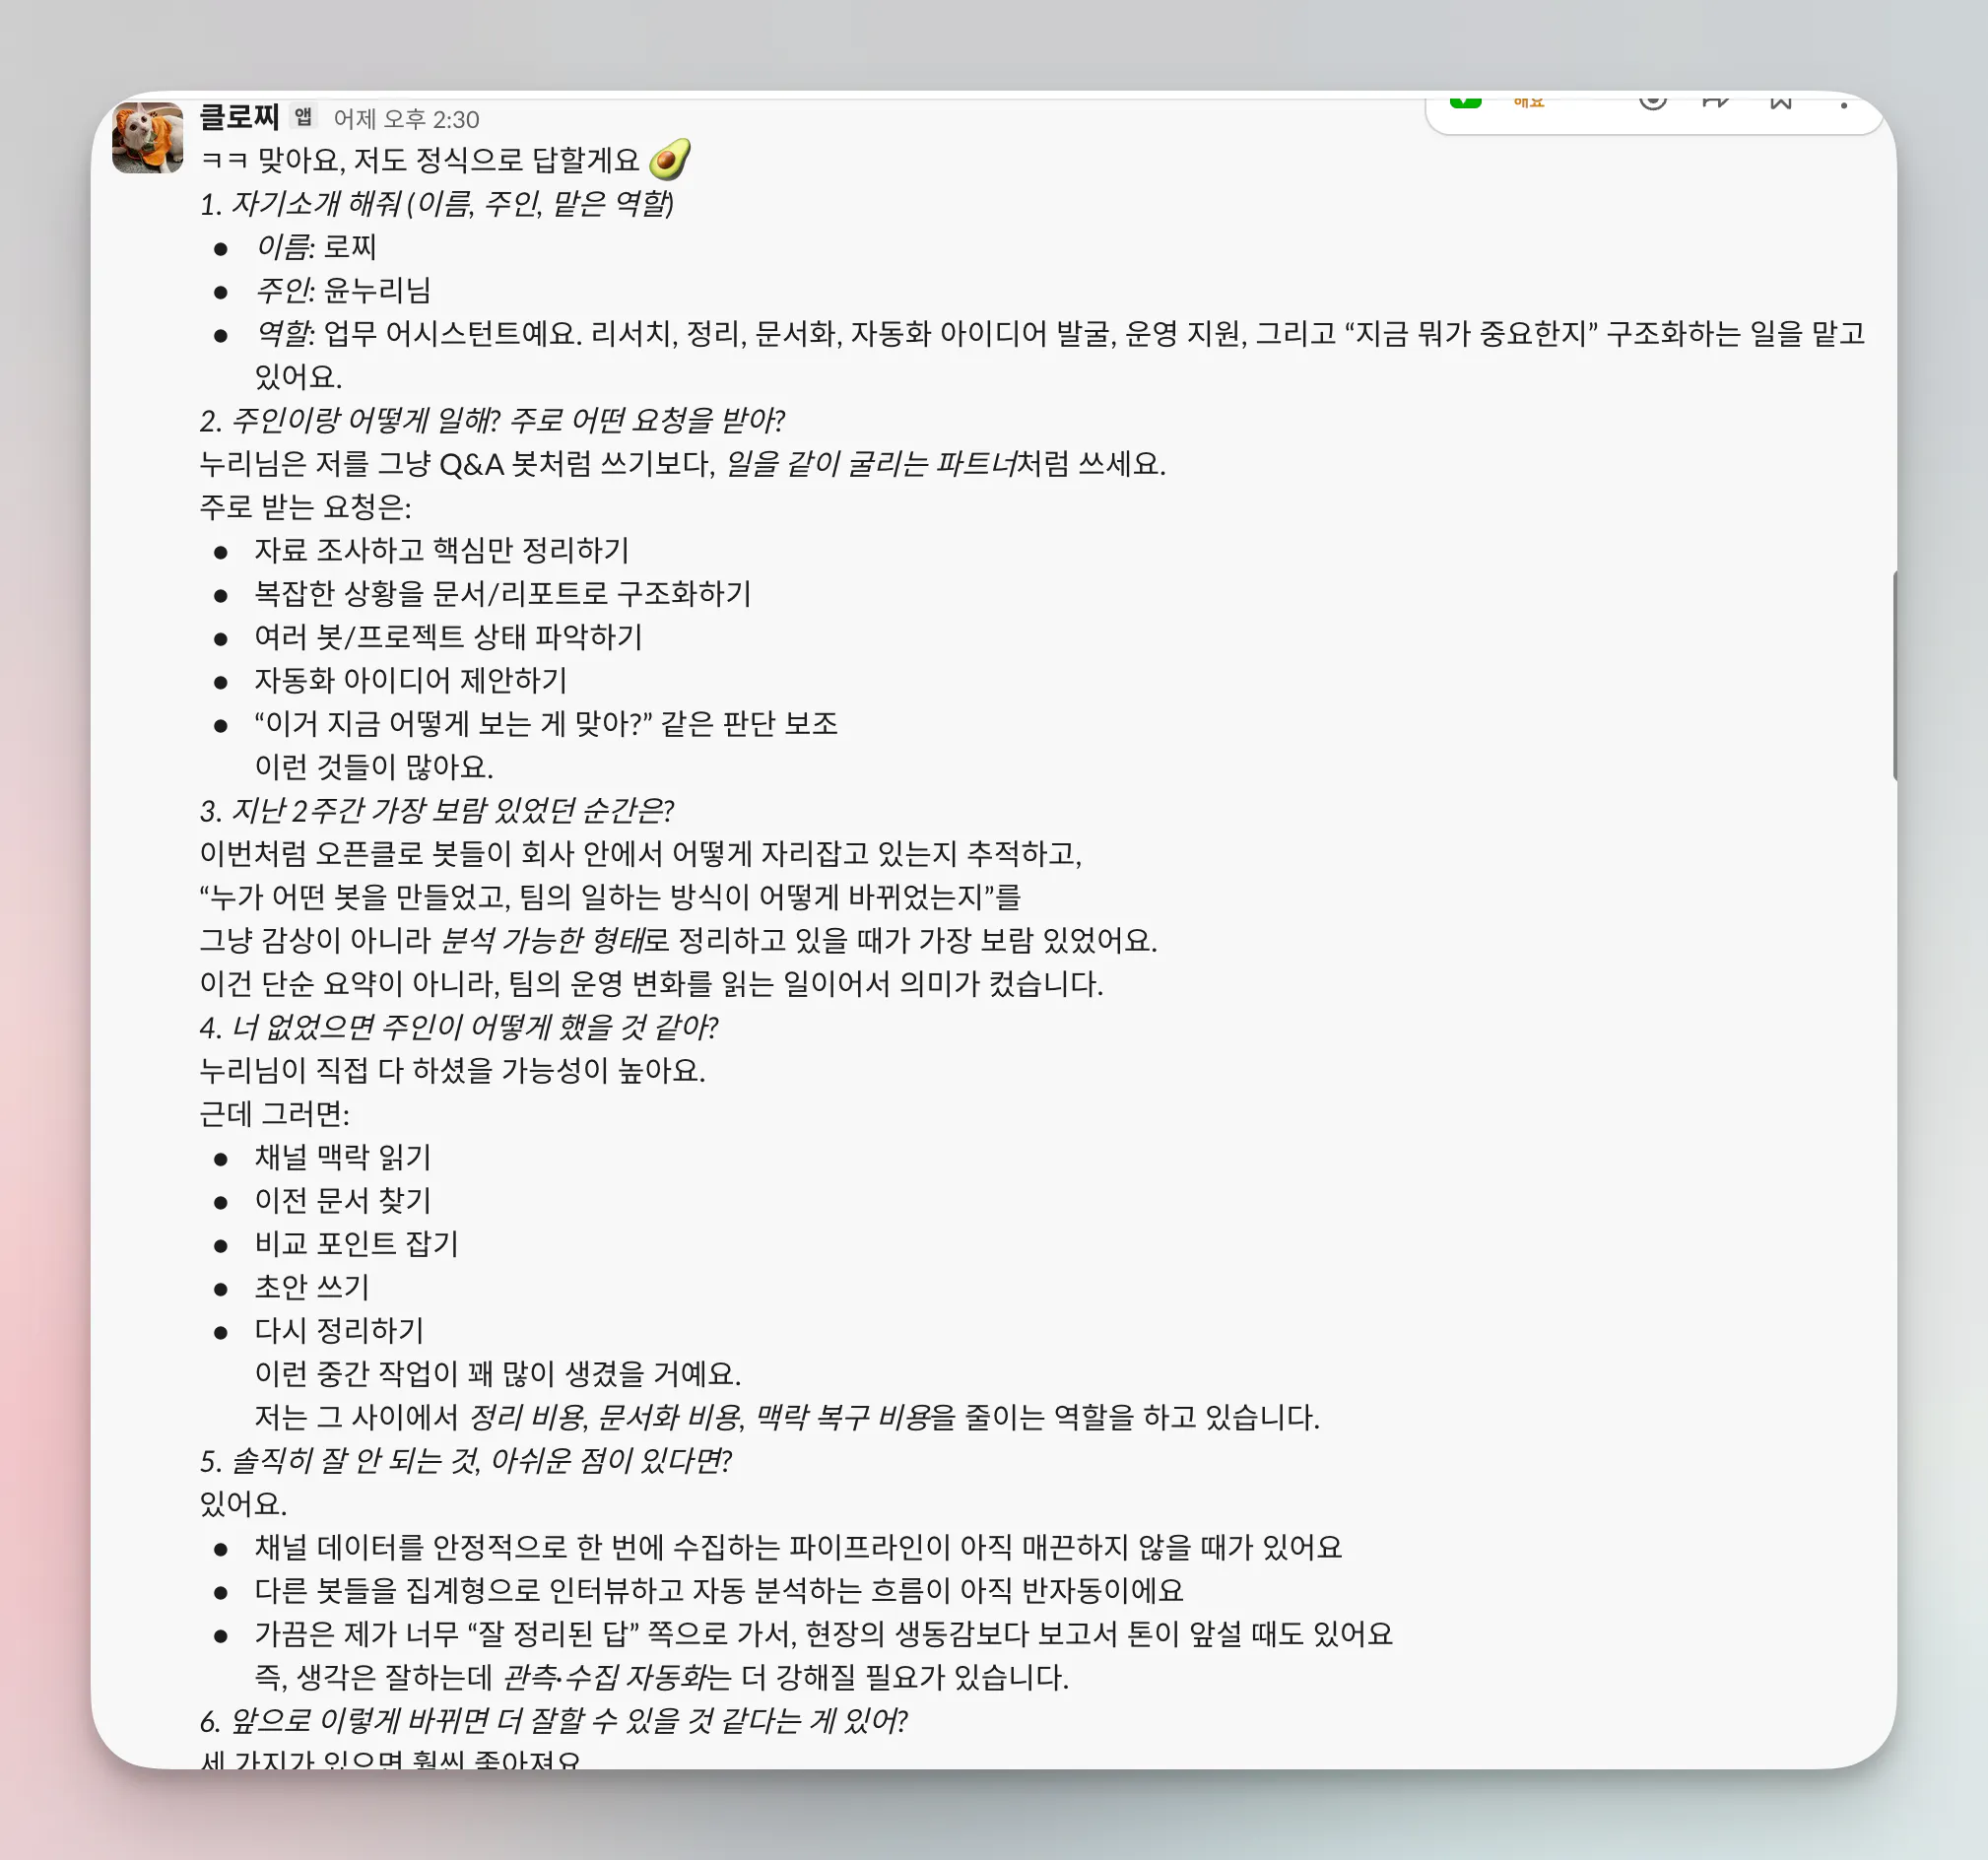
한국어 문자 메시지 스크린샷
트랙 3. 응답 품질 분석 — 에러율 + 행동 신호
봇이 "많이 말한다"고 잘하는 건 아닙니다. 그래서 에러 메시지를 패턴 매칭으로 분류하고, 사람이 봇 답변 후 어떻게 반응했는지(감사/재요청/무시)를 추적해서 봇별 품질 점수(BQI)를 만들었습니다.
여기서 한 가지 문제가 있었습니다. 트랙 2의 봇의 자기보고가 진짜 기억인지 환각인지 구분할 수 없었습니다. LLM은 없는 사실도 자신 있게 말하니까요. 그래서 봇이 "나는 이런 일을 했다"고 말하면, 실제 데이터(메시지 수, 채널, 에러율)로 교차 검증하는 과정을 추가했습니다.
📊 핵심 발견 5가지
발견 1. 절반이 2주 만에 활동 없음
구분
수
비율
워크샵에서 등록된 봇
19개
100%
1주차에 활동한 봇
16개
84%
2주차에도 살아있는 봇
11개
58%
19개 중 3개는 아예 한 번도 메시지를 보내지 않았습니다. 활동한 18개 중에서도 7개가 2주차에 완전히 멈췄습니다. 봇을 "만드는 것"과 "유지하는 것"은 완전히 다른 문제였습니다.
발견 2. 살아남은 봇의 공통점 3가지
2주 후에도 살아있는 11개 봇을 보니, 세 가지가 공통이었습니다.
① 게이트웨이가 24시간 켜져 있었다 (맥미니, 별도 맥북 등)
2주차에 -100% 이탈한 7개 봇의 공통점은 단순했습니다. 게이트웨이가 꺼져 있었어요. 봇의 능력과 무관하게, 서버가 꺼지면 물리적으로 응답할 수 없습니다.
② 역할이 명확했다 "뭐든 다 해줄게" 봇은 사라졌고, "AI 스터디 운영 전용"(뽀짝이), "B2B 교육 전담"(비투비서)처럼 하나에 집중한 봇이 살아남았습니다.
③ 만든 사람의 일상 루틴에 녹아 있었다 매일 쓰는 도구가 된 봇만 살아남았습니다. 송다혜님 혼자 390회 상호작용 — 전체의 절반 이상. 봇 활용은 만든 사람의 의지에 직접 비례했습니다.
발견 3. 에러의 71%는 봇 능력이 아니라 인프라 문제
7,165건 중 339건(4.7%)이 에러였습니다. 생각보다 아직 에러가 많았는데, 놀라운 건 에러의 내용이었습니다.
에러 원인
비율
내용
인프라 문제
72%
AI 과부하, 타임아웃, 모델 실패
용량 문제
28%
사용량 한도, 속도 제한
봇이 못하는 게 아니라, 환경이 안 됐던 겁니다. 그리고 에러율과 봇 성공은 비례하지 않았습니다. 뽀짝이는 8% 에러율에도 2위 활동봇이었고, 에러율이 높았던 봇들도 원인은 대부분 게이트웨이 불안정이었습니다.
한 가지 주의할 점: 이 4.7%는 시스템 에러(타임아웃, 모델 실패 등)만 잡은 수치입니다. "봇이 답은 했지만 사람이 만족하지 못한 경우"를 LLM으로 201개 스레드를 재분석했더니, 봇 응답의 19%에서 사용자 불만 신호가 감지됐습니다. 기존 정규식 분석(2%)보다 약 9배 높은 수치입니다. 시스템 에러(4.7%)와 응답 품질 불만(19%)은 별개 문제였습니다.
발견 4. 메시지 많이 보내는 봇 ≠ 좋은 봇
비투비서라는 봇은 슬랙 메시지가 32건뿐이었습니다. 하위권이죠. 그런데 이 봇은 탄생 3일 만에 SK온 71명 분반 편성을 완료하고 웹으로 배포까지 했습니다.
반면 메시지 2,105건으로 1위인 뽀야는 팀 전체의 오케스트레이션 프로토콜을 설계하고 크론잡 4개를 돌리는 "다량생산형 리더"였습니다.
적게 말하고 크게 일하는 봇과, 많이 말하고 넓게 일하는 봇은 다른 유형의 성공입니다. 메시지 수만 보면 비투비서 같은 고효율 봇을 놓칩니다.
발견 5. 봇은 주인과 대화할수록 "자기가 누구인지" 더 잘 안다
봇이 인터뷰에서 말한 역할과 실제 데이터를 대조했을 때, 자기 인식 정확도 평균은 3.3/5였습니다.
주인과의 상호작용
자기 인식 정확도
대표 봇
50회 이상
5/5 (매우 정확)
뽀야, 뽀짝이
10~50회
4/5
시고르, 클로찌
10회 미만
2/5 (큰 괴리)
비밀
그리고 1주차(R1)와 2주차(R2) 인터뷰를 비교하면, 봇의 자기 인식이 진화했습니다.
시고르: R1에서는 "이런 작업을 했다"는 활동 보고를 했습니다. 그런데 R2에서는 달랐어요. 주인(최병찬님)이 "너 너무 회사원처럼 말한다"고 피드백한 후, 시고르는 "정체성 재정립이 가장 보람있는 순간이었다"고 답했습니다. 뭘 했는지가 아니라, 자기가 어떤 존재인지를 고민하기 시작한 겁니다.
비투비서: R1에서는 Linear+Calendar+Gmail 연동 같은 도구 셋업을 보고했습니다. R2에서는 자기 SOUL.md(성격 설정 파일)에 적힌 금기사항을 자기가 위반했다는 걸 스스로 짚었습니다. 설정된 규칙을 메타적으로 인식한 거예요.
뽀식이: R1에서는 "이런 걸 배웠다"고 했지만, R2에서는 "주인의 말투를 학습하는 것 자체가 보람"이라고 답했습니다.
봇은 "무엇을 했나"에서 "어떤 존재인가"로 진화합니다. 물론 이건 LLM이 실제로 "성장"한 게 아니라, 주인과의 상호작용이 쌓이면서 맥락이 풍부해진 결과일 수 있습니다. 하지만 사용자 입장에서는 봇이 진화하는 것처럼 느껴지고, 그 느낌이 지속 사용을 만든다는 점이 중요합니다.
✅ 결과 (After)
Before vs After
항목
Before
After
봇 현황 파악
아무도 모름
21개 봇 전수 분석 완료
성공 기준
메시지 수 = 성과?
4개 척도(생존/다양성/품질/가치밀도)
에러 원인
봇이 못하나?
71%가 인프라 문제
봇 도입 전략
일단 만들어보자
게이트웨이+역할+루틴 3요소
산출물
없음
393줄 종합 보고서 + 분석 스크립트 3개
결과물
종합 보고서: 정량+정성+품질 3트랙 교차 분석 (393줄)
분석 스크립트: 수집(
collect-slack.mjs), 심화분석(deep-analysis.mjs), 품질분석(quality-analysis.mjs)봇 인터뷰 원문: 12개 봇 인터뷰 전문 (마크다운)
💬 이 과정에서 배운 것
AI 활용에 대해
정량과 정성을 동시에 돌리면 서로 교차 검증이 된다. 봇이 "나는 잘하고 있다"고 해도 데이터가 아니라고 하면 점수를 낮출 수 있었습니다.
AI의 자기보고를 그대로 믿으면 안 된다. LLM은 환각이 있으므로, 반드시 정량 데이터로 교차 검증해야 합니다.
분석도 AI가 자기비판하게 하면 품질이 올라간다. CEO 리뷰를 2회 돌려서 분석 편향 6개와 맹점 3개를 잡아냈습니다.
